このブログの /blog スキルには、記事を書いてから PR を出すまでの手順が一通り書いてある。その中に「ファクトチェックは必須」という節もある。ところが .claude/agents/ に置いてある fact-checker エージェントは、どのスキルからも一度も呼ばれていなかった。
Claude Code のカスタムエージェントを自分で定義している人向けの話だ。きっかけは「/blog はグラフエンジニアリングの実装と言えるか?」という自己診断だった。答えは「言えない」だったのだが、その過程で本題より重い穴が 3 つ出てきた。順に塞いだので、見つけ方と塞ぎ方を書いておく。
TL;DR
- 穴 1: エージェントは定義しただけでは存在しない — 呼び出し側が無ければ孤立ノードで、あるつもりになるぶん無いより悪い
- 穴 2: 検証者を分けただけでは足りない — 「自明だから検証不要」の逃げ道があると素通りする
- 穴 3: サブエージェントは親モデルを継承する — 文脈は分離できても、重み(事実に関する事前分布)は共有されたまま
最終的な検証トポロジーは次のようになった。3 つを塞いだ結果を先に置いておく。
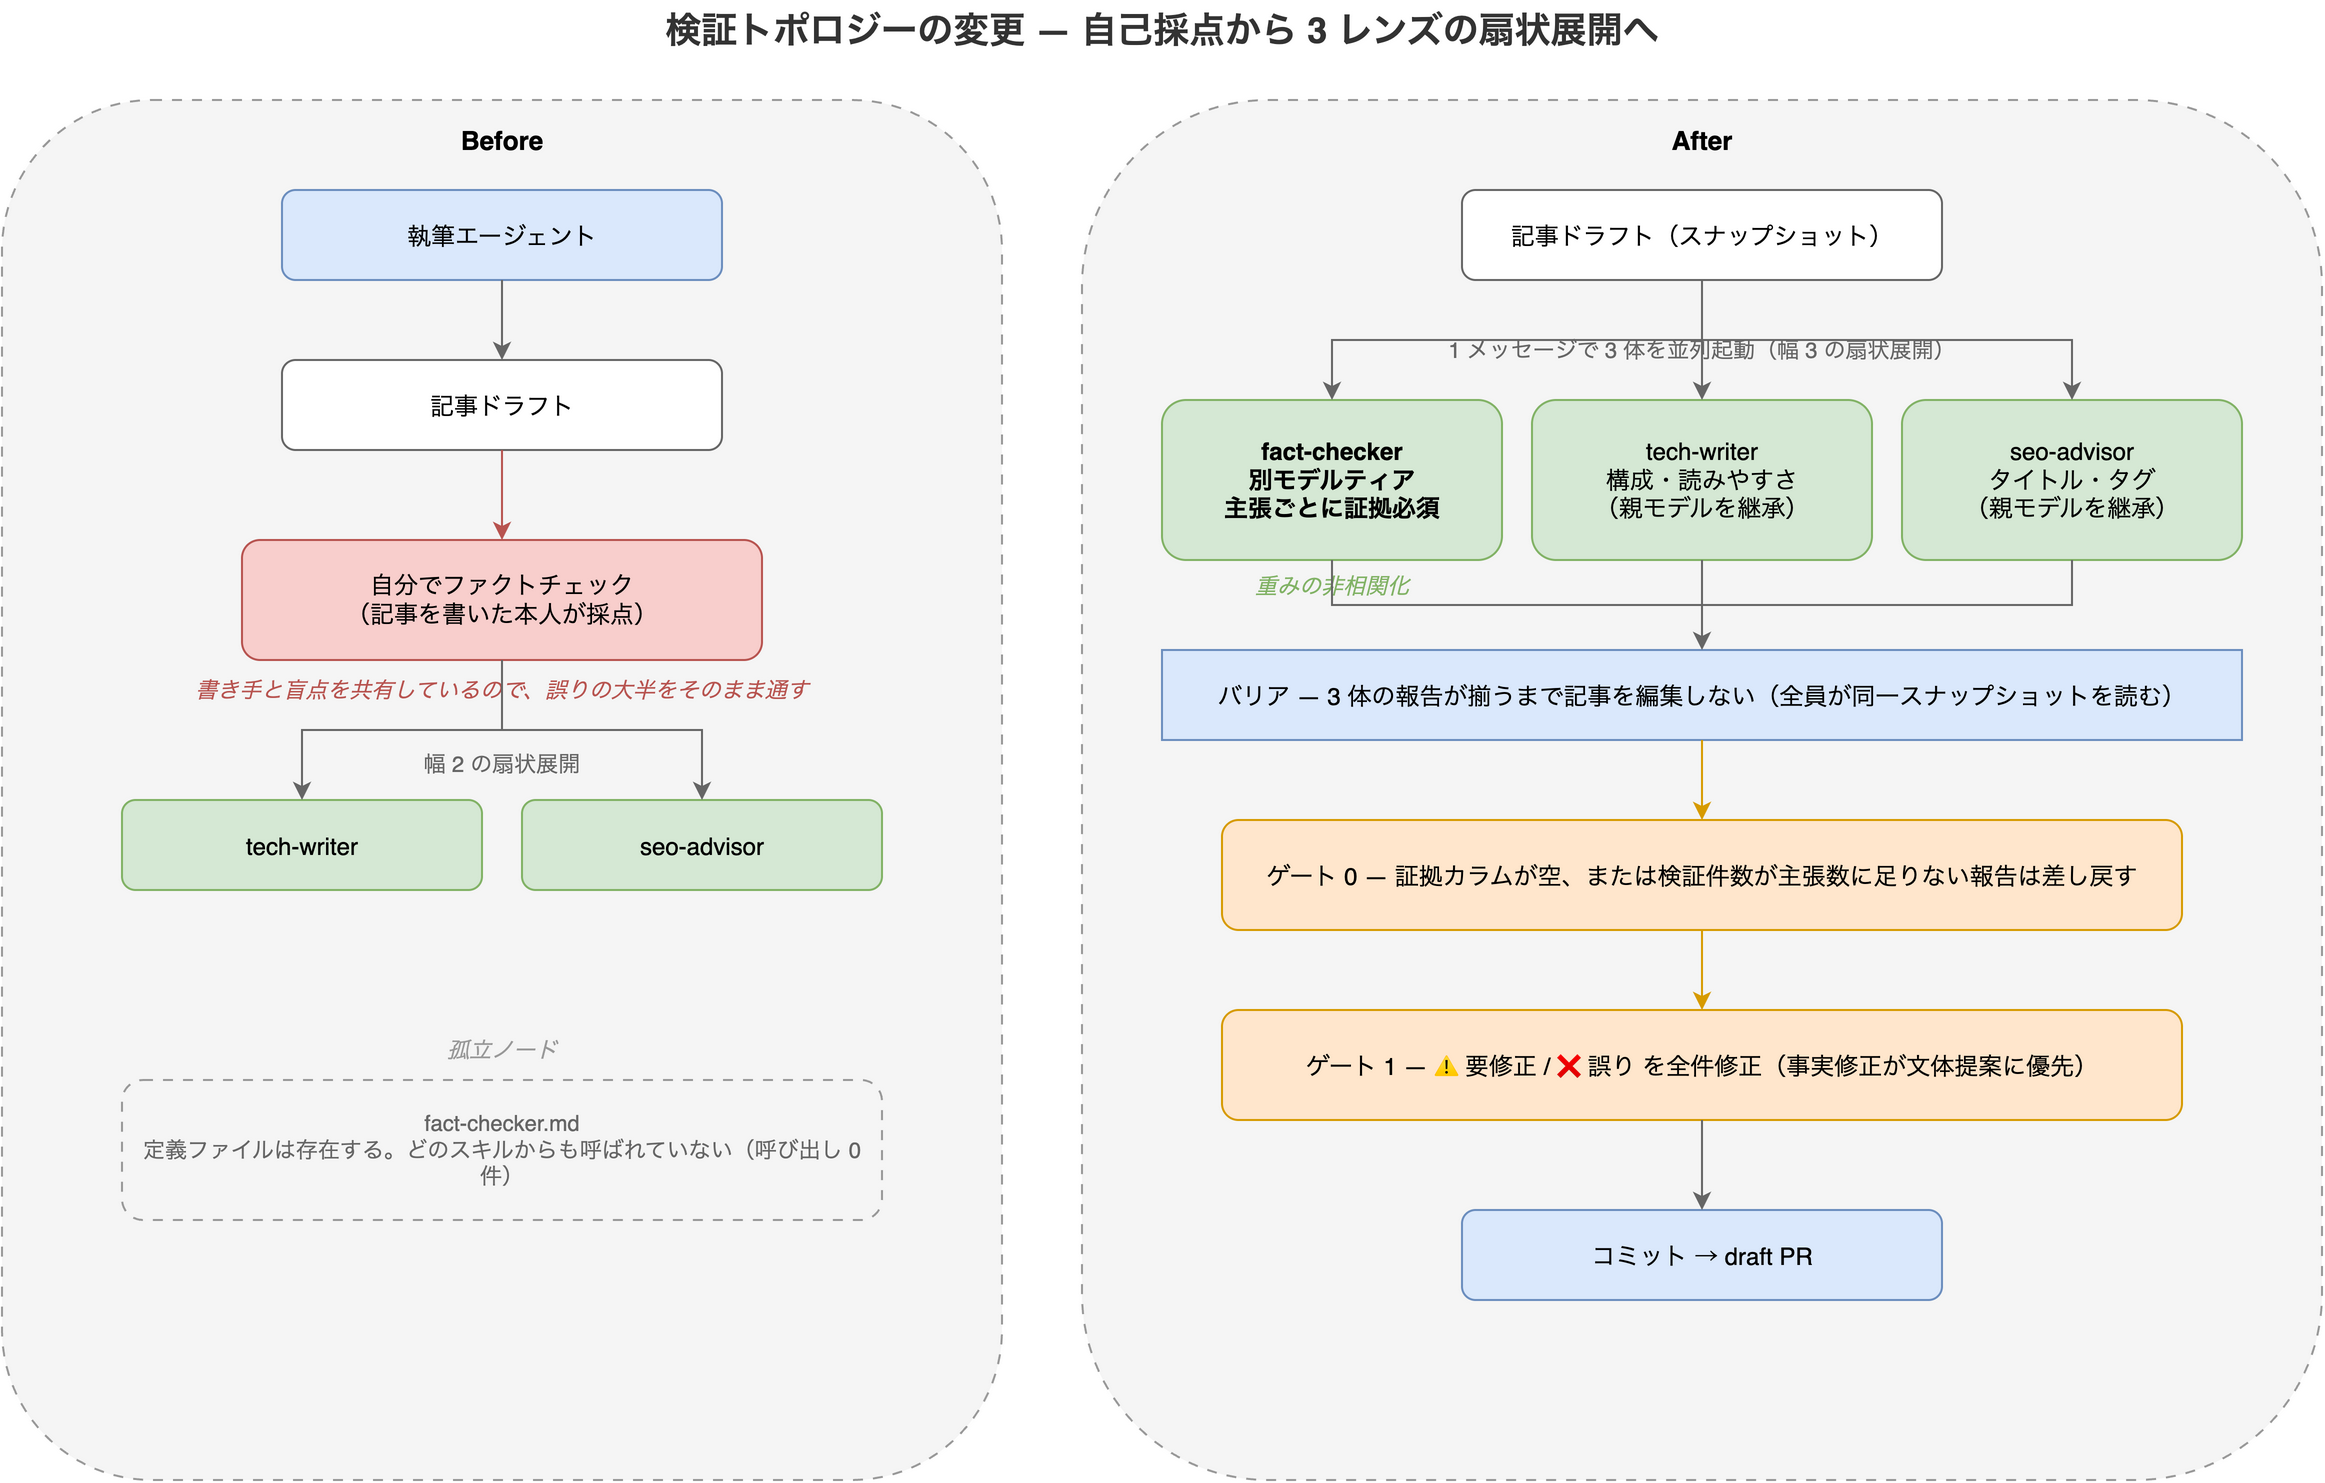
穴 1: サブエージェントの定義ファイルはあるが、誰も呼んでいない
まず見つけ方から。エージェントが実際に使われているかは、定義ファイル以外からの参照があるかで分かる。
grep -rn "fact-checker" .claude/返ってきたのは 1 行だけだった。
.claude/agents/fact-checker.md:2:name: fact-checker自分自身の name: フィールドである。つまりこのエージェントを起動するコードもドキュメントも、リポジトリのどこにも無い。同じことを tech-writer でやると、.claude/skills/blog/SKILL.md の Agent(subagent_type=...) 呼び出しがヒットする。差は明確だった。
CLAUDE.md には「Custom agents」の一覧があり、そこには堂々と載っている。
- **fact-checker** — fact-checks posts (tool names, commands, URLs, versions)一覧に載っていて、定義ファイルもあって、中身もちゃんと書いてある。それでも呼ばれていない。ドキュメントとして読むぶんには完全に「ある」ように見えるので、何度レビューしても見逃す類の穴だった。
では誰がファクトチェックしていたのか
SKILL.md を読むと、## Fact-checking という節に検証チェックリストがインラインで書かれていた。つまり記事を書いたエージェント本人が、そのまま続けて自分の記事を検証していた。
これは maker-checker(作る側と確認する側を分ける原則、four-eyes principle)の正面からの違反にあたる。このブログの wiki 側にも、まさにその一文がある。
同じエージェントに自分の答案を採点させない(maker-checker / four-eyes principle) — 自分の出力をレビューするモデルは、間違えたのと同じ場所から評価するので誤りの大半を見逃す
しかも悪いことに、品質レビュー側は既に分離されていた。tech-writer と seo-advisor は別エージェントとして並列起動されていて、tech-writer の定義にはこう書いてある。
- 記事の技術的な内容の正誤判断はしない(それはファクトチェッカーの役割)役割分担の宣言だけが正しく、受け手がいなかった。 「それはファクトチェッカーの役割」と譲られた先に、誰もいない。事実の正誤を独立に見る目が 1 つも無い状態が完成していた。文体は 2 人がかりで見て、事実は誰も見ていない。
塞ぎ方: 既存の並列レビューに合流させる
直列の前段に足すのではなく、既にある並列レビューに 3 体目として合流させた。3 者は互いの出力を消費しないので、直列にする理由(=データが渡る本物のエッジ)が無い。データを運んでいない「偽エッジ」を消すという発想は Claude Code の動的ワークフローで組むグラフエンジニアリング 14 ステップ で整理した。3 体が出揃うまで待ってから次に進む、いわゆるバリア同期になる。
SKILL.md には次の形の指示が並んでいる。実際に動くコードではなく、スキルがエージェントに書かせる呼び出しの形だ。
Agent(subagent_type="fact-checker", model="<別ティア>", prompt="以下の記事をファクトチェックしてください: $WORKTREE_DIR/...")
Agent(subagent_type="tech-writer",  prompt="以下の記事をレビューしてください: $WORKTREE_DIR/...")
Agent(subagent_type="seo-advisor",  prompt="以下の記事を分析してください: $WORKTREE_DIR/...")
model 引数を明示しているのは後述の穴 3 の対策で、この時点ではまだ書いていない。
同時に SKILL.md 側のインライン検証チェックリストは丸ごと削除した。fact-checker.md にほぼ同文のものが既にある。2 か所に同じ規約を置けば、必ず片方だけが更新されてズレる。スキル側には「エージェント定義を見よ、ここに書き写すな」とだけ残した。
副次的な効果として、所要時間が ファクトチェック + max(レビュー2体) から max(3体) に縮んだ。ただしこれはおまけで、狙いではない。並列実行が実際にどう効くかは Claude Code の「Dynamic Workflows」を冷静に検証 で測っている。
穴 2: 検証者を分けても「自明だから」で素通りする
エージェントを分けただけで満足しかけたが、fact-checker.md の出力形式を読み直して手が止まった。
- ✅ **確認済み**: 裏付けが取れた事実
- ⚠️ **要修正**: 部分的に正しいが修正が必要
- ❌ **誤り**: 裏付けが取れなかった(ハルシネーションの可能性)
- ℹ️ **未確認**: 検証できなかったが重大なリスクは低い
問題は最後の ℹ️ である。「検証できなかった」の中に、「検証しようとしたが取れなかった」と「そもそも検証しなかった」が混ざる。そして後者は、報告書の上では前者と見分けがつかない。
さらに、この出力は箇条書きなので、証拠を書かなくても体裁が整ってしまう。「✅ 確認済み」とだけ書けば通る。裏を取ったのか、モデルが知っている気になっただけなのか、読み手には判定できない。
いちばん厄介なのは、この 2 つが合流する地点だ。検証者が「これは自明だから調べなくていい」と判断したとする。自明に見える理由は、書き手と事前分布を共有しているからだ。つまり書き手が確信を持って間違えた箇所こそ、検証者にも自明に正しく見えて素通りする。エージェントを分けた意味が、この 1 点で消える。自分の欠陥に自分で気づけない構造そのものについては 自律システムはなぜ自分の欠陥に気づけないのか で書いた。
塞ぎ方: 証拠を構造で強制する
fact-checker.md に ## 検証の規律(最重要) を新設し、いま書いた理屈をそのまま冒頭に置いた。
**「自明だから検証不要」は認められない。** あなたが自明だと感じる主張は、記事を書いた
エージェントも自明だと感じた主張である。同じモデル族は同じ事前分布を持つので、
**書き手が確信を持って間違えた箇所こそ、あなたにも正しく見える**。
規律は 4 つ。
- 主張ごとに証拠を 1 つ紐付ける — 実行した
gh apiコマンド、WebSearch のクエリ、fetch した URL のいずれかを判定と一緒に記録する - 記憶を証拠として使わない — 「知っている」「一般的にそうである」は証拠ではない。裏を取っていない主張は ✅ にできない
- ℹ️ 未確認 は「試した上で取れなかった」場合限定 — 何を試して何が返ってこなかったのかを書く
- ソース元に無い主張を優先的に検証する — 記事にはあるがソース元(Issue やコメント)に無い記述は執筆中に足されたもので、ハルシネーションの最大の発生源
そして出力形式を箇条書きから証拠カラム付きの表に変えた。
| 判定 | 主張(記事中の記述) | 証拠(コマンド / クエリ / URL) | 備考 |
|---|---|---|---|
| ✅ | … | gh api /repos/foo/bar --jq '.full_name' → foo/bar | |
| ❌ | … | WebSearch「…」→ 該当なし | 削除を推奨 |
最後に「主張 N 件中、✅ x / ⚠️ y / ❌ z / ℹ️ w」の内訳も出させることにした。
塞ぎ方 2: 呼び出し側にもゲートを置く
エージェント側の規律だけでは不十分で、受け取る側が空欄を見逃せば同じことになる。SKILL.md の結果適用手順に、修正を始める前のゲートを足した。
0. **Check that `fact-checker` actually checked.** It must return a per-claim table with an
   evidence column (a command, a query, or a URL) and a final tally. If the tally covers
   noticeably fewer claims than the post makes, or verdicts arrive with an empty evidence
   column, **send it back rather than accepting it** — an unchecked ✅ is worse than no
check, because it launders a guess into a confirmation.証拠カラムが空、または検証件数が記事の主張数に対して明らかに少ない報告は、受け取らずに差し戻す。未検証の ✅ は、検証しないより悪い。 「調べていない」が「確認済み」に洗浄されて、下流の人間が信用してしまうからだ。
穴 3: サブエージェントは親モデルを継承する
3 つ目は、答えを既に自分の手元に持っていたのに、このリポジトリには適用していなかったものだった。グローバル側のエージェント設定(~/.claude/agents/、全プロジェクト共通)に、別のワークフロー用の検証専用エージェントを置いてある。その description にこう書いてあった。
呼び出し時に model 引数で実装とは別ティアを必ず指定すること
(省略すると親と同じモデルを継承し、盲点を共有して牽制にならない)同じ理屈がブログの検証にもそのまま効くのに、/blog 側には一言も書かれていなかった。実際、.claude/agents/ のどの定義ファイルにも model: フィールドは無い。他所のエージェント定義がこのフィールドをどう使っているかは サブエージェントの役割は tools で縛る — ECC の68体を数えて見えた設計と抜け穴 で数えた。
grep -rn "^model:" .claude/agents/*.md何も返らない。つまり穴 1 を塞いだ直後の状態では、fact-checker は記事を書いたのと同じモデルで走っていた。
この時点で分離できているものを整理すると、こうなる。
- ✅ 文脈の非相関化 — 別エージェントなので、記事を書いたときの推論チェーンを見ていない。どの記述を自分ででっち上げてどれを出典から取ったかを知らないので、記憶に頼って正当化できない
- ❌ 重みの非相関化 — 事実に関する事前分布は書き手と同一
ファクトチェックが本来狙う失敗は「モデルが CLI のフラグやバージョンやリポジトリの存在について自信満々に間違っている」類だ。同じ重みの検証者は、その間違いを同じ確信度で共有する。穴 2 の「自明だから素通り」と、原因が同じところに合流する。
塞ぎ方: fact-checker のモデルティアを跨がせる
fact-checker の呼び出しに model を必須にし、対応表を書いた。
| 執筆側 | fact-checker |
|---|---|
sonnet(バッチ実行の既定) | opus |
opus | sonnet |
- haiku は禁止 — 証拠が主張を実際に支持しているかの判定が仕事の本体で、そこが最初に劣化する
- opus → sonnet 方向の劣化は許容する — 穴 2 の証拠必須ルールを入れた結果、判定の大半は
gh apiや WebSearch が返したもので決まる。検証者の推論の深さへの依存が下がっているので、非相関化と引き換えにできる - tech-writer と seo-advisor は継承のまま — 文体とタグは好み(taste)の問題で、共有事前分布による盲点という問題が存在しない
補足: コスト削減は動機にならなかった
最初は「検証は安いモデルでいい」というコスト論で考えていたが、これは筋が悪かった。理由は 2 つある。なお、サブエージェントへのモデル割り当てとコストの関係そのものは 「Codex 裏技」を検証 — サブエージェントのモデル指定は codex-router なしでできる で検証している。
1 つは、記事をまとめて生成する夜間バッチのスクリプトが、既に上限を持っていること。
claude -p \
  --model "$MODEL" \
  --dangerously-skip-permissions \
  --max-budget-usd 2.00 \
  "$PROMPT"
1 件あたりの支出は --max-budget-usd で構造的に抑えられている。安いモデルに落として買えるのは「上限内の余裕」であって、青天井の出費を止める話ではない。
もう 1 つは、ファクトチェックが反復的な抽出・分類ではなく裁定に近いこと。「この主張は裏が取れているか」は判断の仕事なので、ここを安くするのは方向として逆になる。
ティア分離の価値はコストではなく非相関化にある。結果として「安いから下げる」ではなく「違うから跨がせる、ただし下げすぎない」という設計になった。
この記事自身を、その仕組みにかけた
せっかくなので、この記事の初稿をそのまま新しい 3 体並列にかけた。fact-checker は sonnet ティア(執筆は opus)で走らせている。
返ってきた内訳は 主張 25 件中、✅ 20 / ⚠️ 3 / ❌ 0 / ℹ️ 1。⚠️ の 3 件はどれも「引用の不正確さ」だった。
- ゲート 0 の引用が実ファイルと違った — 上に載せている英語のブロックは、初稿では日本語だった。意味は合っていたが、実ファイルの文面は英語で、逐語引用の体裁を取りながら中身は筆者の意訳という状態だった。実際の文面に差し替えた
- 出典の帰属が間違っていた — 穴 3 で引用した検証エージェントの description を、初稿では「このリポジトリが既に自分で書き留めていた」と書いていた。実際の置き場所は
~/.claude/agents/すなわちグローバル設定で、このリポジトリのスキルではない。「手元には持っていたが、このリポジトリには適用していなかった」に直した - wiki からの引用で括弧書きを落としていた — 「(maker-checker / four-eyes principle)」を省略してダッシュを句点に置き換えていた。
>の引用符を使う以上は逐語であるべきなので戻した
どれも記事の主張自体は壊していないが、3 件とも自分では気づけなかった種類の誤りだった。特に 2 番目は、「自分のリポジトリの話だ」という思い込みが検証を素通りさせる典型で、証拠を要求されなければそのまま通っていたはずだ。
そして、この仕組みの外側から一番重い指摘が来た。「記事が『塞いだ』と書いている変更が、まだどのコミットにも入っていない」。 指摘の時点で 3 ファイルの変更はメインの作業ツリーに未コミットで置いてあり、記事の PR ブランチにも main にも入っていなかった。記事だけをマージすると、リポジトリの正式な状態は記事が主張する After にならない、というプロセス上の指摘である。
これを受けて、この記事と設定変更 3 ファイルは同じ PR に入れることにした。
記事の事実検証を頼んだのに、記事とリポジトリの整合性まで見て返ってきたのは予想外だった。証拠を集めさせると、主張の周辺にある前提まで一緒に踏むことになる、という副次効果だと思う。
なお品質レビュー側(tech-writer)も 1 件、実ファイルのバグを見つけている。検証規律 4 のラベルが初稿では「記事に書かれていない主張も拾う」になっていたが、拾う対象は「記事にはあるがソース元に無い主張」なので、ラベルと説明が逆の意味になっていた。これは記事ではなく .claude/agents/fact-checker.md 本体の記述ミスで、そちらも直した。
残っている穴 — --skip-review フラグ
夜間バッチのスクリプトには --skip-review という高速化フラグがある。
# --skip-review ファクトチェック・エージェントレビューを省略(高速化)挙動は以前から変わっていないが、ゲートを強くした分だけ、このフラグで開く穴は相対的に大きくなった。夜間バッチで常用するなら、--skip-review を分割するのが筋だと思う。省略するのは tech-writer / seo-advisor だけにして、fact-checker は必ず走らせる。ここはまだ手を付けていない。
一般化 — エージェント検証を機能させる 3 層
3 つの穴は別々に見つかったが、教訓は 1 本に繋がっている。検証は「分けた」だけでは成立せず、3 つの層を全部塞いで初めて機能する。
| 層 | 塞がないと起きること | 塞ぎ方 |
|---|---|---|
| 接続 | 定義しただけのエージェントは呼ばれない | 呼び出しを実際に書く(grep で確認) |
| 規律 | 「自明だから」という逃げ道で検証を飛ばす | 証拠を書く欄を作り、空欄を可視化する |
| 重み | 書き手と同じ盲点を持つ | モデルティアを跨がせる |
そして自己診断の入口はどれも安い。grep -rn "<agent-name>" .claude/ を叩くだけで、層 1 は今すぐ分かる。 エージェント定義を書いたきり呼び出しを書き忘れた経験がある人は、一度走らせてみると何か出てくるかもしれない。
もう 1 つ、書いていて効いたと感じたのは、規約を「文章」ではなく「埋める欄」にすることだった。「証拠を書くこと」と散文で書いても、守らなくても報告の体裁は成立してしまう。表の証拠カラムにすると、守らなかったことが空欄として残る。エージェントに規律を課すときは、破ったことが構造として見える形にしておくと、下流のゲートで機械的に弾ける。