IP 制限されている SaaS があり、社外の端末からは使えない。 オフィスの回線から出れば通る。ならば社外の端末の通信をオフィス経由にすればいい、 という話である。
やること自体は単純だが、利用者に渡す設定を 2 回間違えて、原因の特定に 4 日と 6 往復かかった。構成の記録と、その障害の経緯を残す。
2 つの障害の原因は、どちらも利用者に渡す設定ファイルの 1 行だった
(DNS の欠落と MTU の過大)。1〜4 章は構成と運用上の落とし穴、
5〜6 章は 2 つの障害の切り分け、7〜8 章は恒久対処とその反映、9 章は教訓を扱う。
構成だけ知りたい場合は 2 章と付録で足りる。
なお本稿の固有名詞・IP アドレス・鍵はすべて匿名化してある。IP は RFC 5737 のドキュメント用アドレスに置き換えた。
1. 要件と制約
- 社外の端末(自宅・出張先)から、IP 制限されている SaaS へアクセスできること
- SaaS 側に見える送信元 IP がオフィスの固定 IP であること
- 社外の端末から社内 LAN へは到達させないこと(これが効いてくる)
- SSH は開けない。管理は AWS Systems Manager(SSM)経由のみ
- 利用者は非エンジニアを含む。設定は PDF の手順書 1 枚で完結させる
3 番目が単なるお題目ではないところが、後の障害の伏線になる。
2. 構成
全体像は次のとおりである。
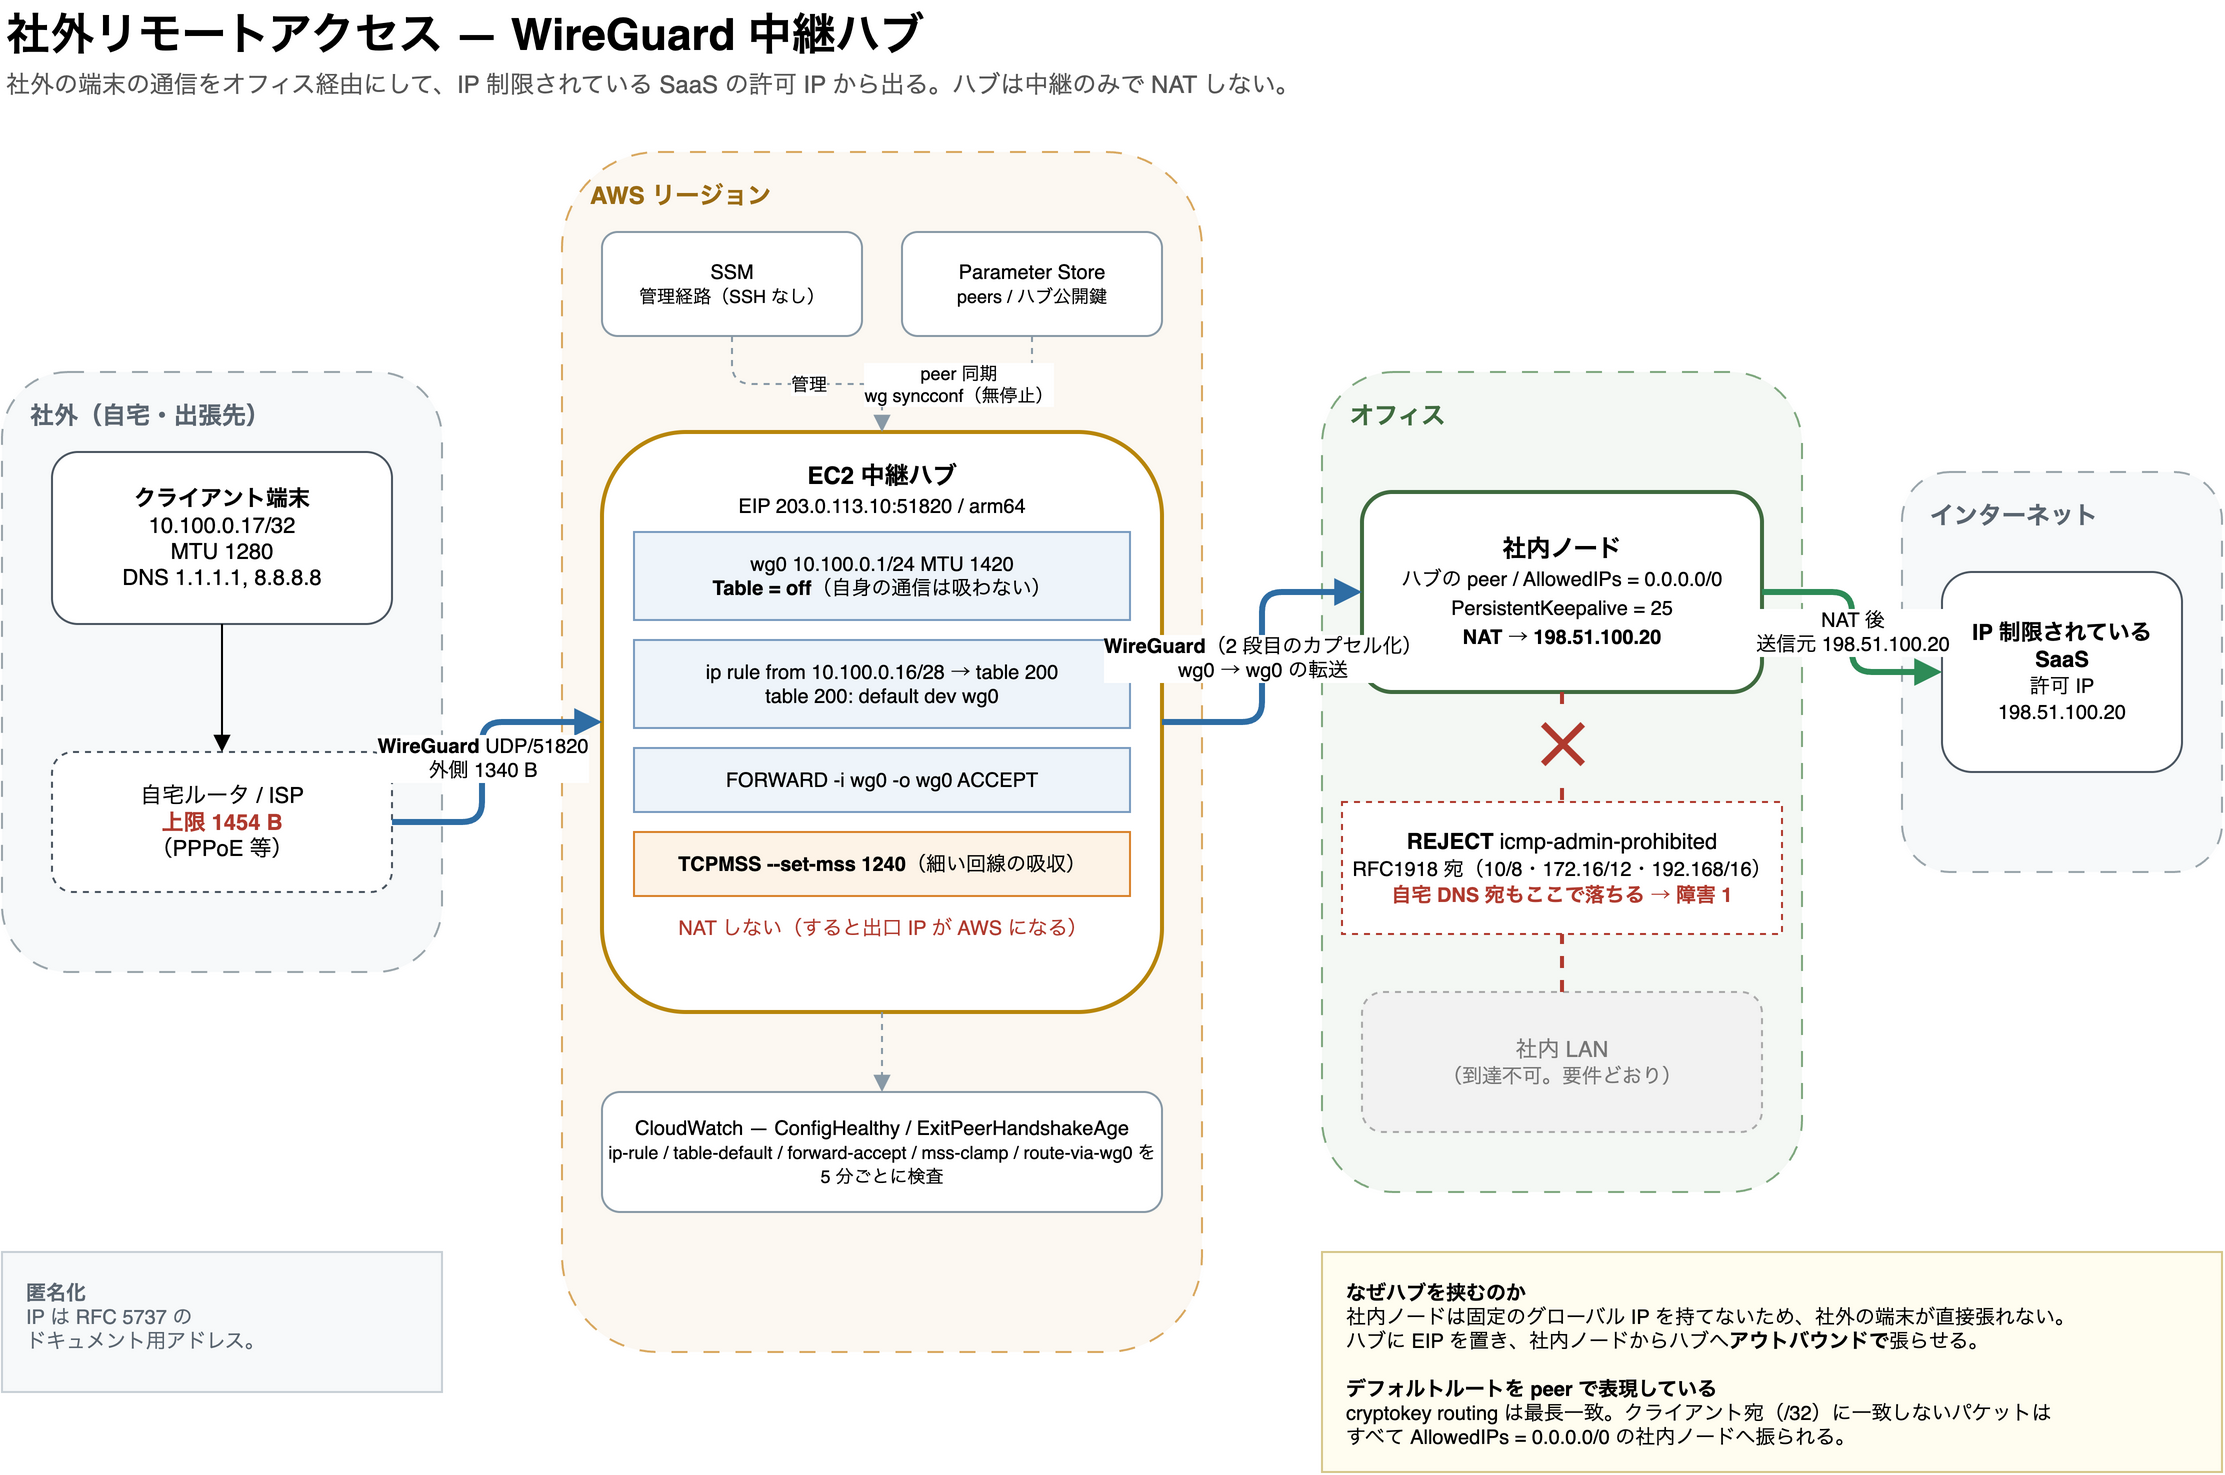
なぜ中継ハブを挟むのか。社内ノードは固定のグローバル IP を持てないため、 社外の端末が直接そこへ張れない。ハブに EIP を置き、社内ノードからハブへ アウトバウンドで張らせる。社外の端末もハブへ張る。ハブは中継だけを行い、 自分では NAT しない(NAT すると出口 IP が AWS になって IP 制限を通らない)。
- ハブ: EC2 1 台(arm64 / Ubuntu 24.04)、EIP、WireGuard
- 社内ノード: オフィスの Linux 機。ハブの peer として
AllowedIPs = 0.0.0.0/0 - クライアント:
10.100.0.16/28から/32を払い出す
cryptokey routing は最長一致なので、クライアント宛(/32)に一致しない
パケットはすべて 0.0.0.0/0 の社内ノードへ振られる。「デフォルトルート」を
peer で表現しているわけで、これが構成の中核である。
2.1 ハブの wg0.conf
[Interface]
Address    = 10.100.0.1/24
ListenPort = 51820
MTU        = 1420
PrivateKey = <hub private key>

Table      = off
PostUp     = ip route add default dev wg0 table 200
PostUp     = ip rule  add from 10.100.0.16/28 table 200
PostUp     = iptables -A FORWARD -i wg0 -o wg0 -j ACCEPT
PostDown   = ip rule  del from 10.100.0.16/28 table 200
PostDown   = iptables -D FORWARD -i wg0 -o wg0 -j ACCEPT
Table = off が必須である。 AllowedIPs = 0.0.0.0/0 を素直に書くと
wg-quick がハブ自身の通信までトンネルへ吸い込み、SSM が切れて管理経路を失う。
SSH を開けない構成なので、これは復旧不能を意味する。
off にしたうえで、クライアント由来のパケットだけをポリシールーティングで
別テーブルへ振る。ip rule add from 10.100.0.16/28 table 200。ハブ自身の通信は
main を使い続けるので SSM は生き残る。
初回構築時は保険を入れておいた。
systemd-run --on-active=30min --unit=wg-deadman /bin/systemctl stop wg-quick@wg0設定を間違えて SSM ごと切断された場合、30 分後に wg0 が落ちて管理経路が戻る。
SSH がない構成では他に復旧手段がない。SSM 接続を確認できたらタイマーを止める。
2.2 社内ノード側の遮断
要件の 3 番目はここで実装している。
iptables -I FORWARD 1 -i wg0 -o eno1 -d 10.0.0.0/8     -j REJECT --reject-with icmp-admin-prohibited
iptables -I FORWARD 2 -i wg0 -o eno1 -d 172.16.0.0/12  -j REJECT --reject-with icmp-admin-prohibited
iptables -I FORWARD 3 -i wg0 -o eno1 -d 192.168.0.0/16 -j REJECT --reject-with icmp-admin-prohibitedトンネルから来たパケットのうち、RFC 1918 宛のものは拒否する。 社外の端末はインターネットへは出られるが社内 LAN へは入れない。
この 3 行が、後述する 1 つ目の障害の直接の原因になる。
3. 設計上の判断
IaC は Terraform を使っている。以降 plan / apply はその操作を指す。
3.1 ハブの秘密鍵はインスタンス上で生成し、外に出さない
初回起動時に wg genkey して、公開鍵だけを Parameter Store に載せる。
Terraform の state に秘密鍵が入らない。
引き換えに、インスタンスを作り直すとハブの鍵が変わり、全クライアントの
設定変更が必要になる。 EC2 と EIP には prevent_destroy を付けた。
3.2 peer 定義は 3 層で、更新タイミングが違う
台帳(T)・Parameter Store(S)・稼働中の設定(L)の 3 層に分かれ、更新の タイミングがそれぞれ違う。
| 層 | 実体 | 更新する操作 |
|---|---|---|
| T | peers.json | 人が編集(台帳そのもの。git 上の正) |
| S | Parameter Store | apply |
| L | 稼働中の wg0 | wg syncconf(無停止) |
peer を user_data に埋めると、追加のたびにインスタンスが replace されて ハブ鍵が変わる。だから Parameter Store に切り離した。
反映は wg syncconf を使うのでインターフェースが落ちない。既存の接続が
切れずに peer を追加できる。スクリプトは既存 peer の転送カウンタを前後で
比較して、巻き戻っていないことを確認する。
層のずれは棚卸しスクリプトが TSL の並びで出す。T-- や TS- は反映が
途中で止まっている状態。
3.3 台帳は HCL ではなく JSON
以前は *.tfvars を正規表現で編集していた。[^\n]* がブロック境界を越えて
peer 2 件をまとめて消すバグを踏んだ。
スクリプトが機械的に編集するものを HCL で持ってはいけない。 JSON なら
json.load / json.dump で構造ごと扱えるので、この種の事故が原理的に起きない。
IaC 側は jsondecode(file(...)) で読む。
引き換えに JSON はコメントを持てないので、peer ごとの注記は note フィールドに
入れて wg0.conf のコメント行として出力している。
file() 由来だと variable の validation が使えないため、
lifecycle.precondition で plan 時に落とす(鍵の形式・名前・改行混入・重複・
レンジ外)。スクリプトも同じ検査をするが、台帳を手で編集された場合は
precondition が最後の砦になる。
3.4 秘密鍵は受け取らない
利用者には「空のトンネル」をアプリで作らせ、公開鍵だけを送ってもらう。 端末で生成された秘密鍵は端末に残るのが正しい。
4. 運用上の落とし穴
構成そのものより、こちらのほうが厄介だった。
4.1 systemd-networkd がポリシールーティングルールを消す
networkd の既定は ManageForeignRoutingPolicyRules=yes で、自分の
.network に書かれていないポリシールールを起動時に削除する。
ip rule add from 10.100.0.16/28 はまさにこの「foreign」に該当する。
厄介なのは非対称性である。wg0 は networkd 管理外なので table 200 の
経路は残る。しかしポリシールールはリンク単位ではなくグローバルなため、
まとめて消される。結果、トンネルは繋がるのにクライアントが出口へ行けない
半壊状態になる。
さらに厄介なのは、再起動テストでは検出できないことである。再起動では networkd が
先に上がり wg-quick が後なので、PostUp が最後に勝つ。壊れるのは
wg-quick が up した後に networkd が再起動したときだけで、これは日次の
unattended-upgrades が systemd を re-exec するたびに起こる。
稼働 1 日でルールが消えた。
# /etc/systemd/networkd.conf.d/99-hub.conf
[Network]
ManageForeignRoutingPolicyRules=no
netplan 側に routing-policy を書いて networkd に所有させる案は採らなかった。
ルールは netplan・経路は wg0.conf という分割になり、定義が 2 箇所に散る。
4.2 StatusCheckFailed では検出できない故障がある
上記の半壊は、OS が生きている限り EC2 のステータスチェックでは正常に見える。 1 日気づかれなかった。
自前のヘルスチェックを 5 分ごとに回し、カスタムメトリクスへ publish するように
した。検査部分だけを抜粋する(note は失敗理由を記録する自作の関数)。
systemctl is-active --quiet wg-quick@wg0                       || note wg0-active
ip rule show | grep -q "from $CLIENT_CIDR lookup $TABLE"       || note ip-rule
ip route show table "$TABLE" | grep -q 'default dev wg0'       || note table-default
[ "$(cat /proc/sys/net/ipv4/ip_forward)" = 1 ]                 || note ip-forward
iptables -C FORWARD -i wg0 -o wg0 -j ACCEPT                    || note forward-accept

# 「無いべきものが在る」も見る。ここに MASQUERADE が生えたら
# 出口 IP が AWS になり、IP 制限を通らなくなる。
iptables -t nat -S POSTROUTING | grep -q MASQUERADE            && note masquerade-present

# 設定の羅列ではなく、カーネルの経路選択そのものを問う。
ip route get 1.1.1.1 from "$CLIENT_IP" iif wg0 | grep -q 'dev wg0' || note route-via-wg0設定値を並べて見るだけでは足りない。最後の行のように、カーネルに 「このパケットをどこへ出すか」を直接問うのが確実である。前述の故障は 個別の設定値ではなく、この結果に現れた。
自動修復はしない。黙って直すと同じ故障が再発しても誰も気づかず、原因が 残り続ける。検出してアラームを上げるところまでに留める。
4.3 user_data を変えるとインスタンスが stop/start される
EC2 は稼働中インスタンスの user_data を変更できない。IaC のプロバイダは
自動で stop → 変更 → start する。
plan には will be updated in-place と出る。「in-place」なので気づきにくい。
実際に踏んだ。
user_dataだけを変える apply は、EC2 の stop/start と同じ承認を要する- 鍵と cloud-init の結果は保全される。失われるのは WireGuard のセッションと
systemd-runで作った一時ユニット - 社内ノードは
PersistentKeepalive = 25でアウトバウンドに張るので自力で復帰する。 実測 16 秒
peer 管理スクリプトには、plan が想定外のリソースを触ろうとしたら中断する
ガードを入れた。peer の付け外しで aws_instance が動くのは事故である。
4.4 保存された新しい user_data は実行されない
これが一番効いた。user_data を変えて apply しても、インスタンス上の設定は
変わらない。 cloud-init は再実行されないからである。
つまり user_data の編集は「次にインスタンスを作り直したとき用」であって、
実機への反映手段ではない。実際に反映するには SSM で別途配布する必要がある。
そして user_data だけ直して apply しないのは、もっと悪い。 plan に恒久的な
差分が残り、無関係な apply のついでに stop/start が起きる地雷になる。
触るなら apply まで通すか、そもそも触らないかのどちらかにする。
4.5 稼働中の wg0.conf は唯一のコピー
[Interface] セクションは user_data が初回起動時に一度だけ書いたもので、
cloud-init は再実行されないため他に複製がない。
peer 同期スクリプトは最初の [Peer] より前をそのまま保持して以降を差し替えるので、
[Interface] を壊すとそれでは直らず、再起動で wg-quick@wg0 が上がらなくなる。
SSH は開いていないため復旧手段が限られる。
手で編集するときは必ずバックアップを取り、wg-quick strip wg0 でパースを
検証する(適用せず構文だけ見られる)。この検証で後述のミスをやる。
4.6 AMI を追うと plan が落ちる
ami を「最新の Ubuntu」を返す public parameter から取っていた。ディストリ側が
AMI を publish するたびに replace が計画される。
ami = ami-0aaa... -> ami-0bbb...   # forces replacement
Error: Instance cannot be destroyed
prevent_destroy があるので実機は守られる。しかし plan 自体がエラーで落ちる。
peer 管理スクリプトは plan を通すので、peer の追加・削除ができなくなっていた。
端末紛失時の失効手段が塞がっていた。
無関係な検証の副産物として気づいた。棚卸しスクリプトは output しか使わないため
検出できていなかった。
このインスタンスはそもそも作り直さない前提である(鍵が実機にしかない)。
追随しても適用する手段がないので、ignore_changes = [ami] で追うのをやめた。
5. 障害 1 — DNS を書かなかったら利用者が何もできなくなった
利用者に設定を渡し、こう返ってきた。
$ curl -s -w '\ncode=%{http_code}\n' https://tracker.example.com/api/v2/account
code=000

$ curl -s https://ifconfig.example
(空白)

ブラウザを立ち上げましたが、どこにも行けない状態でした。
SaaS だけでなく通信が全部死んでいる。これが手がかりだった。IP 制限の問題なら その SaaS だけが 403 になるはずで、他のサイトは普通に応答する。
5.1 原因
渡した設定に DNS の行がなかった。
AllowedIPs = 0.0.0.0/0 は DNS も含めて全通信をトンネルへ送る。
DNS を明示しないと、WireGuard クライアントは端末の既存の DNS 設定を残す。
その DNS は多くの場合 DHCP で配られた自宅ルータ(192.168.x.1 など)である。
- 端末が
192.168.x.1:53へ DNS クエリを送る AllowedIPs = 0.0.0.0/0なのでトンネルへ入る- ハブが社内ノードへ転送する
- 社内ノードが RFC 1918 宛として REJECT する(2.2 節のあの 3 行)
- 名前解決が一切できない → ホスト名を使う通信すべてが失敗する
curl の code=000 は「HTTP 応答が無い」であり、名前解決の失敗でもこうなる。
ブラウザがどこにも行けなかったのは、通信できないからではなく名前が引けないから
だった。
5.2 対照実験
ハブ上でクライアントレンジの一時アドレスを lo に付け、そこから発信して
クライアントの経路を再現した(終了時に必ず外す)。
ip addr add 10.100.0.30/32 dev lo
ip route get 1.1.1.1 from 10.100.0.30
→ 1.1.1.1 from 10.100.0.30 dev wg0 table 200 ← ポリシールールに載っている| 試験 | 経路 | 結果 |
|---|---|---|
| 生 IP へ HTTPS | トンネル経由 | 200 / 出口 198.51.100.20 |
| 同上 | 対照・ハブ自身 | 200 / 出口 203.0.113.10 |
| SaaS の API | トンネル経由 | 401(許可済み IP) |
| 同上 | 対照・ハブ自身 | 403(弾かれている) |
DNS @1.1.1.1 | トンネル経由 | 解決成功 |
DNS @192.168.1.1 等 | トンネル経由 | host unreachable |
ping 192.168.1.1 | トンネル経由 | 100% packet loss, +2 errors(拒否応答) |
対照との差が「トンネルを通っている」ことの証明になっている。 片方だけ測っても何も言えない。
5.3 対処
DNS を必須項目にした。公開リゾルバでなければならない。
DNS = 1.1.1.1, 8.8.8.8 # これが無いと壊れる結果として社内のホスト名は引けない。これは「社外端末から社内 LAN へ 到達させない」という要件から導かれる帰結であり、不具合ではない。
5.4 AllowedIPs を絞る split tunnel は採らなかった
DNS を壊さない別解として、AllowedIPs を SaaS の IP だけにして残りを素の回線へ
流す方法がある。しかし その SaaS の IP はリゾルバによって違う値が返る。
dig @1.1.1.1 tracker.example.com  → 203.0.113.200
dig @8.8.8.8 tracker.example.com  → 203.0.113.201
IP を設定に焼き込む方式は成立しない。
6. 障害 2 — 同じ症状で、原因が違った
DNS の行を足してもらった。直らなかった。
$ curl -s -m 15 https://tracker.example.com/api/v2/account
応答なし

$ curl -s -m 15 https://ifconfig.example
応答なし

$ curl -s -m 10 https://1.1.1.1/cdn-cgi/trace | grep ip=
ip=198.51.100.20
ここで判断を誤った。
3 番目が通ったことで「通信は生きている、残るは DNS」と考えた。しかも前回の記録に 「どこにも行けない → まず DNS を疑う」と書いてあった。だから 「アプリ内で編集しないと設定が反映されない」という一般論としては正しいが 今回は事実でなかった仮説を渡してしまった。
(余談だが、この一般論自体は本当である。WireGuard アプリは macOS も Windows も
設定を読み込んだ時点で自分の中に写しを作る。手元の .conf をテキストエディタで
書き換えてトンネルをオフ・オンしても、アプリが使う設定は古いままである。
これはこれで手順書に書くべき落とし穴だった。)
6.1 決め手になったデータ
利用者に nslookup の対照を取ってもらった。
$ nslookup tracker.example.com 1.1.1.1     # 問い合わせ先を明示
Address: 203.0.113.200

$ nslookup tracker.example.com             # 端末の設定で引く
Address: 203.0.113.200

$ scutil --dns | grep 'nameserver\['
  nameserver[0] : 1.1.1.1
両方成功した。DNS は正常だった。これを最初に取らせていれば 1 往復で 否定できていた。
そこで成否を応答の大きさで並べ直したら、境目が見えた。
| 試したもの | 応答の大きさ | 結果 |
|---|---|---|
1.1.1.1/cdn-cgi/trace | 約 350 バイト | 成功 |
| DNS の問い合わせ | 約 100 バイト | 成功 |
| SaaS の API | TLS 証明書のやり取りで数 KB | 失敗 |
| 別のサイト | 同上 | 失敗 |
名前解決の可否ではなく、パケットの大きさが境目だった。
私が「名前を使わない疎通」として渡した 1.1.1.1/cdn-cgi/trace は、
リテラル IP かつ応答が約 350 バイトという 2 つの特殊性を持つ。
私は「名前を使わない」という軸だけを見て、応答の大きさという軸を
見ていなかった。この URL を通信全体の代表として扱ってしまった。
IPv6 も疑ったが、対象ホストに AAAA レコードがなかったので否定した。
6.2 サーバ側は正常だった
前回は生 IP で確認していた。今回は利用者が失敗した URL そのもので測った。
| 試験 | 経路 | 結果 |
|---|---|---|
| SaaS の API | トンネル経由 | 401(許可済み IP) |
| 同上 | 対照・ハブ自身 | 403 |
| 出口 IP | トンネル経由 | 198.51.100.20 |
| 同上 | 対照・ハブ自身 | 203.0.113.10 |
| DF 付き ping 内側 1400 バイト | トンネル経由 | 通る |
| 1 MB ダウンロード | トンネル経由 | 5.5 MB/秒 |
ハブから先は、大きいパケットも含めて健全。残るのは利用者の端末とハブの間だけ。
6.3 原因は MTU
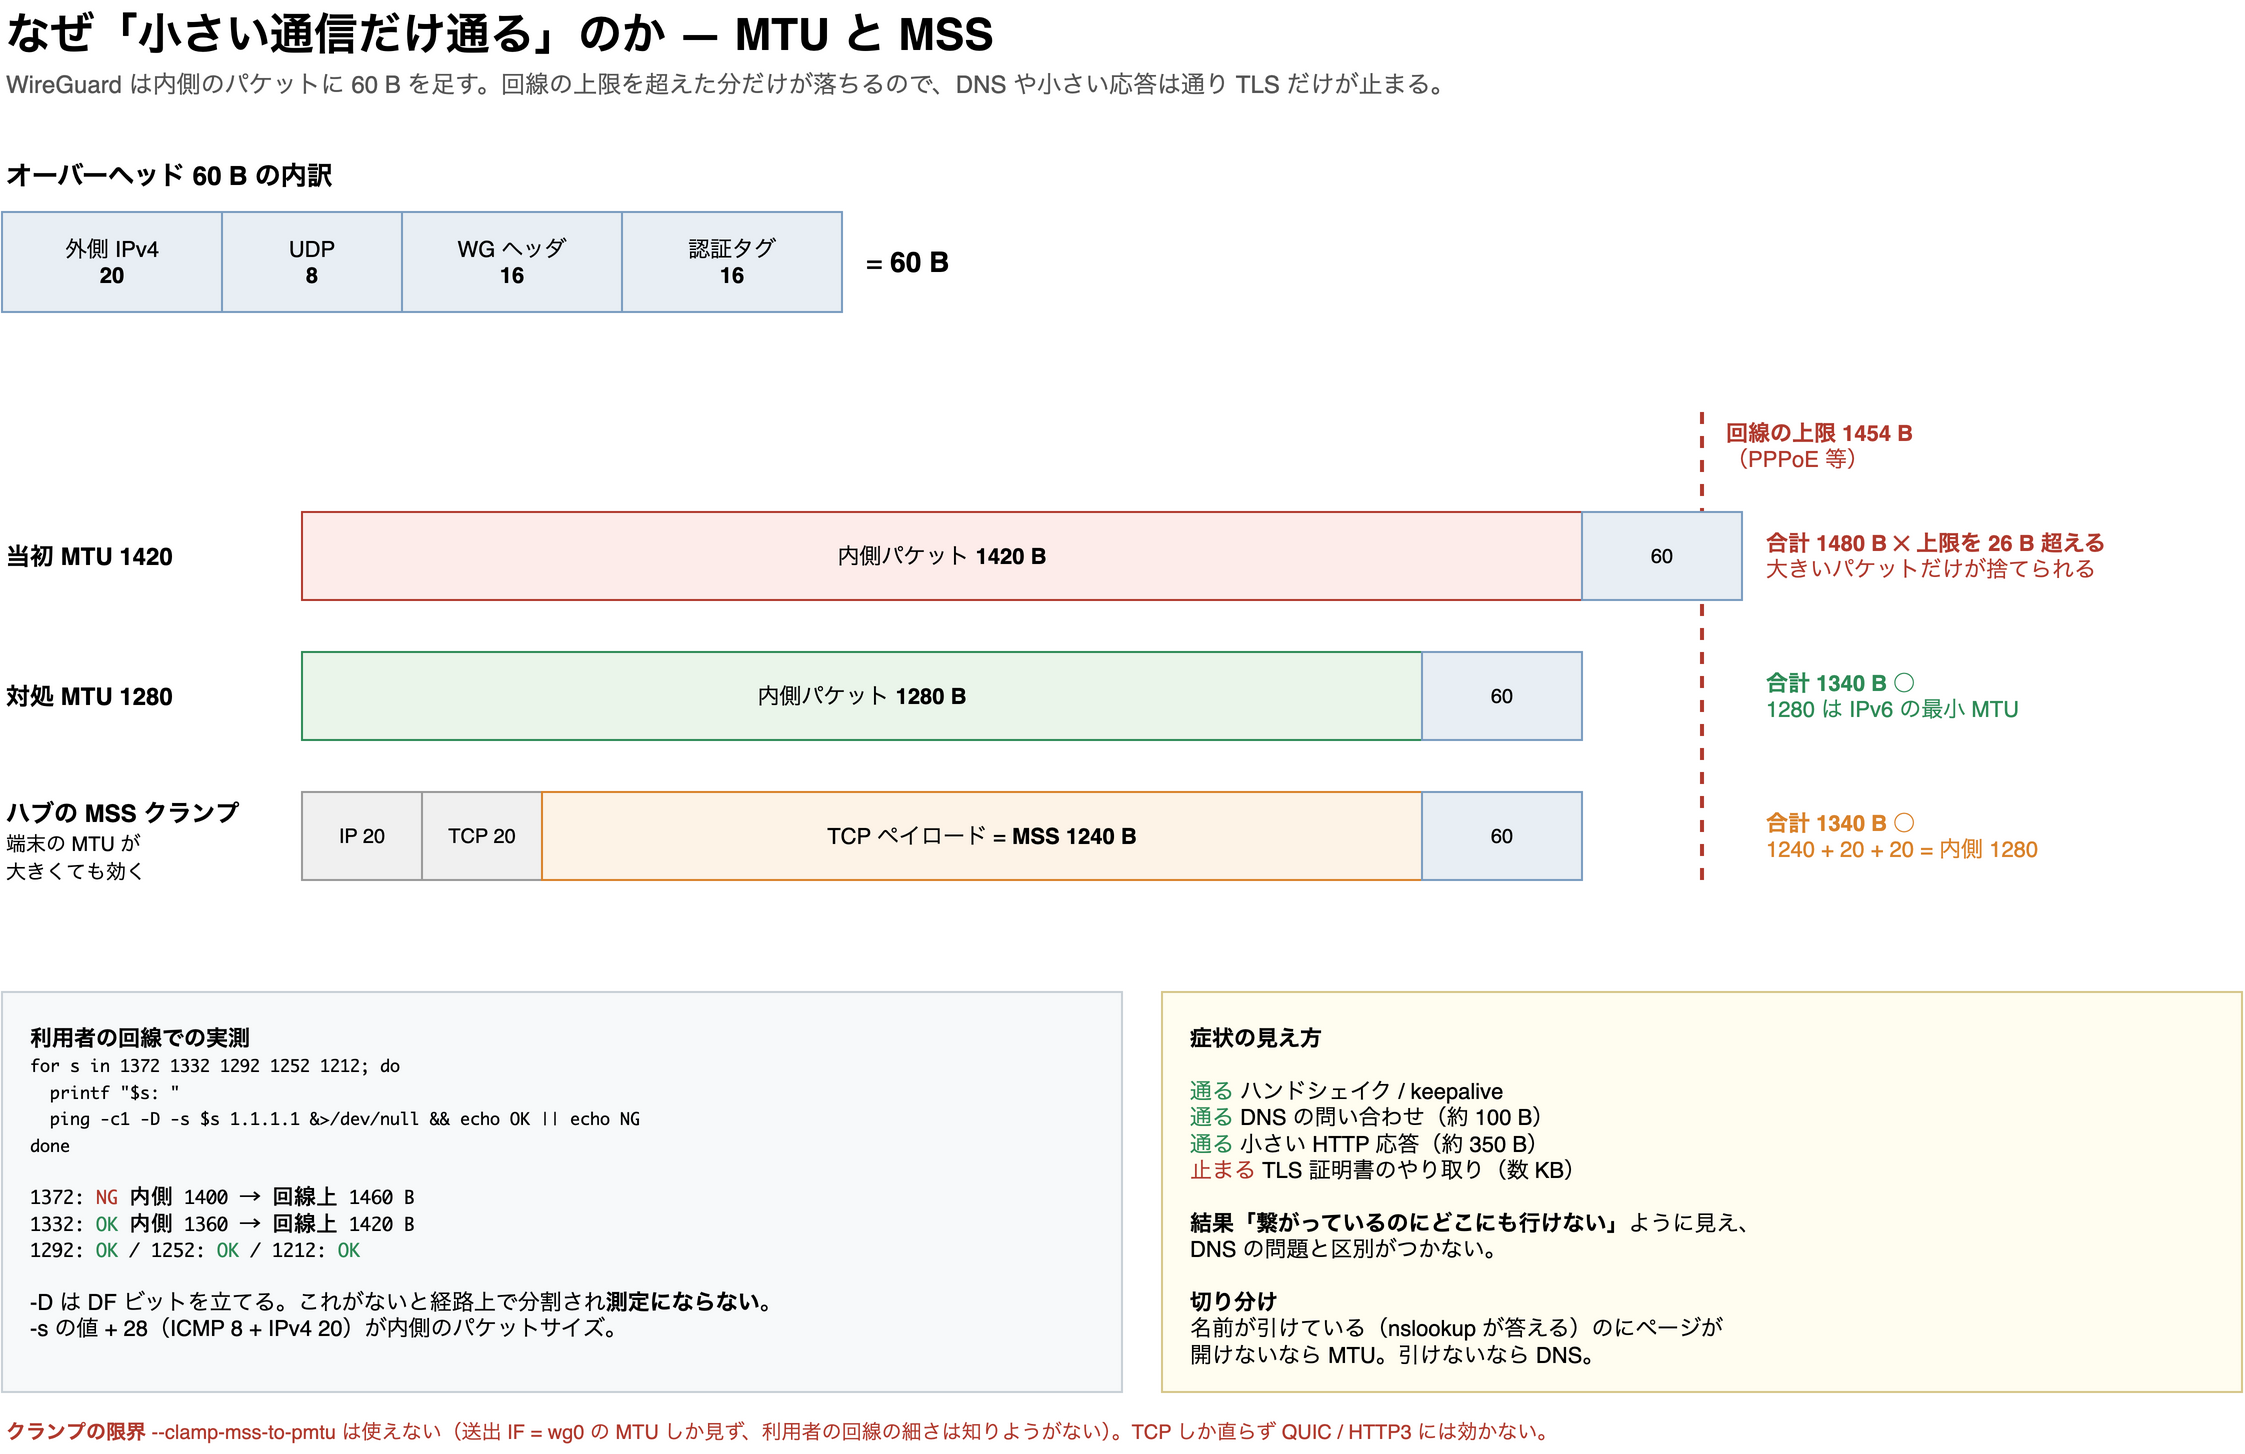
図の下段にある MSS クランプは 7 章の恒久対処である。ここではまず上段の オーバーヘッドを見る。
WireGuard は内側のパケットに 60 バイト(外側 IPv4 20 + UDP 8 +
WG ヘッダ 16 + 認証タグ 16)を足す。MTU = 1420 は回線上 1480 バイトになる。
利用者の回線で実測した。
for s in 1372 1332 1292 1252 1212; do
  printf "$s: "
  ping -c1 -D -s $s 1.1.1.1 &>/dev/null && echo OK || echo NG
done
1372: NG 内側 1400 → 回線上 1460 バイト
1332: OK 内側 1360 → 回線上 1420 バイト
1292: OK
1252: OK
1212: OK-D は DF ビットを立てる指定で、これがないと経路上で分割されてしまい測定に
ならない。-s の値 + 28(ICMP 8 + IPv4 20)が内側のパケットサイズになる。
回線上 1420 バイトは通り、1460 バイトは通らない。フレッツ系の PPPoE 接続 (IPv4 の上限 1454 バイト)であれば説明がつく範囲である。PPPoE 一般の標準は 1492 バイトなので、この値は日本の回線に固有のものである。
小さい通信(ハンドシェイク、keepalive、DNS、350 バイトの HTTP 応答)はすべて通る。 TLS の証明書のやり取りで数 KB が流れた瞬間に止まる。 「繋がっているのに何も開けない」の正体はこれだった。
MTU = 1280 で解消した。1280 は IPv6 の最小 MTU で、実質どの回線でも通る。
7. 恒久対処 — ハブ側で TCP MSS をクランプする
利用者ごとに MTU を測り直す運用は割に合わない。ハブが転送する TCP の SYN に 書き込む MSS を下げておけば、利用者が MTU を大きめに設定していても TCP は 成立する。
iptables -t mangle -A FORWARD -i wg0 -o wg0 -p tcp --tcp-flags SYN,RST SYN \
  -j TCPMSS --set-mss 1240
1240 は配布 MTU (1280) から IPv4 20 + TCP 20 を引いた値。内側 1280 バイト = 回線上 1340 バイトに収まる。
--tcp-flags SYN,RST SYN は SYN と SYN/ACK の両方に当たるので、
双方向とも小さいセグメントで話すようになる。効くのは主に下りである。
サーバが 1380 バイトのセグメントを送ってきて利用者の最終区間で捨てられる、
という形が実際の壊れ方だった。
7.1 --clamp-mss-to-pmtu は使えない
送出インターフェース(wg0 = 1420)の MTU を見るだけで、その先にある
利用者の回線の細さは知りようがない。固定値で下げる必要がある。
7.2 TCP しか直らない
QUIC / HTTP3 は UDP なので MSS の概念がなく、効かない。ブラウザは TCP へ フォールバックするので実用上は足りるが、この制約は残る。
7.3 配布値とクランプ値を別の変数にした
配布 MTU は出力とスクリプト経由なので user_data に影響しない。実機を止めずに 変えられる。一方クランプ値は user_data に埋まるので、変更は stop/start を伴う。
クランプ値を配布 MTU から算出したくなるが、してはいけない。 derive すると 配布 MTU を触るだけで実機が止まることになり、分離した意味が消える。
7.4 ヘルスチェックにも項目を足した
iptables -t mangle -C FORWARD -i wg0 -o wg0 -p tcp --tcp-flags SYN,RST SYN \
  -j TCPMSS --set-mss "$MSS_CLAMP" || note mss-clamp
このルールが消えると、細い回線の利用者だけが「大きい通信が通らない」形で 壊れる。ハブ自体は正常なままなので、検査しないと誰も気づかない。 4.2 節と同じ性質の故障である。
8. 反映と検証
クランプの設計が決まっても、それを動いているハブへ届けるところが別の問題として
残る。4.4 節のとおり apply は実機に届かないので、反映は 3 段階に分かれる。
8.1 反映は 3 段階
| 手順 | 何が変わるか |
|---|---|
| user_data のテンプレートを編集 | 次に作り直したとき用 |
apply | EC2 が stop/start される |
| SSM 経由の反映スクリプト | 実機へ反映。無停止 |
4.4 節のとおり、apply だけでは実機に届かない。これを実測で確認できた。
apply 後のインスタンスは up 1 min(再起動している)にもかかわらず、
wg0.conf は旧内容のままで TCPMSS の行はなく、iptables -t mangle -S FORWARD
も空だった。
反映スクリプトは冪等にし、失敗時は wg0.conf を復元するようにした。
- TCPMSS ターゲットが使えるか、専用チェーンを作って確認してから消す
wg0.confをバックアップ(4.5 節。唯一のコピーである)[Peer]より前だけを対象に、既存ルールの行を目印に挿入wg-quick stripでパースを検証。壊れていたら復元して中断- 稼働中の iptables へ適用(
wg0は落とさない) - ヘルスチェックへ検査項目を挿入。
bash -nを通してから install - 事後検証
- 呼び出し側が全 peer の転送カウンタを前後で比較し、セッションが切れて いないことを確認する
8.2 検証結果
クランプが実トラフィックに当たっていることをカウンタで確認した。 利用者が接続中だったため、20 秒で 4 パケット増えた。
40  2472 TCPMSS  tcp flags:0x06/0x02 TCPMSS set 1240
44 2720 TCPMSS (20 秒後)ヘルスチェックが検出できることを対照実験で確かめた。ルールを一時的に外し、 検出を確認してから戻す。片方だけでは検出できる証明にならない。
ルールを外す  → ConfigHealthy=0 failed: mss-clamp
戻す          → ConfigHealthy=1
この試験でメトリクスに 0 が 1 点入るが、アラームは Minimum / period 300 /
evaluationPeriods 2 なので連続 2 期間でなければ発火しない。状態は OK の
ままで通知は飛んでいない(アラーム履歴で確認)。検査項目の試験は 1 点で
終わらせる。
再起動後も残ることは、同じ仕組みの既存ルールが実際に生き残っていることを
根拠にした。この日の stop/start 直後、wg0.conf の PostUp が書いた
-A FORWARD -i wg0 -o wg0 -j ACCEPT は filter テーブルに存在していた。
新しい行は同じ [Interface] の同じ位置にある。wg-quick@wg0 の再起動による
直接の確認はしていない(利用者が接続中でセッションを切れなかった)。
ここは未確認として記録した。
8.3 反映スクリプトは最初、自分の検証ガードに弾かれた
wg-quick strip の出力に Address が在ることを検査していた。しかし
strip は wg-quick 固有のキーを仕様として除去する。残るのは
PrivateKey / ListenPort / FwMark と [Peer] 群だけで、Address / MTU /
Table / PostUp / PostDown / DNS は消える。
正しく書けた wg0.conf を「壊れた」と判定してバックアップから戻していた。
実機は無傷で健全なままだったので、ガードは意図どおり働いた。
しかし検証条件そのものを、実機の出力を見てから書くべきだった。
二段構えに直した。strip はパースが通ることと wg 側のキーの生存を見る。
wg-quick 側のキーは実ファイルの [Interface]([Peer] より前)を直接見る。
パターンは実機の内容を再現したファイルに対して事前に全件テストした。
9. 教訓
9.1 切り分けの軸は 1 つではない
「名前を使わない疎通」だけでは足りなかった。軸は「名前解決の可否」と 「パケットの大きさ」の 2 つある。利用者に投げるコマンドは小さい応答と 大きい応答の両方を含めなければ、片方の軸しか測れない。
いま手順書のトラブルシュートはこうなっている。
curl -s -m 10 https://1.1.1.1/cdn-cgi/trace | grep ip=   # 名前を使わない・応答が小さい
nslookup tracker.example.com # 名前解決だけを見る| trace | nslookup | 原因 |
|---|---|---|
| 出ない | — | 通信自体が通っていない |
| 出る | 答えが返らない | DNS 行の欠落 |
| 出る | 答えが返る | MTU が大きすぎる |
9.2 同じ症状に既知の原因があると、そこで探索が止まる
前回の記録が「どこにも行けない → まず DNS」と書いていたことが、今回は逆に 足を引っ張った。トラブルシュートは「最初に疑うもの」だけでなく 「それを否定する方法」を併記しなければ次へ進めない。
9.3 仮説を裏付ける前に対処を渡さない
「アプリ内で編集しないと反映されない」は一般論としては正しいが、今回は事実で
なかった。nslookup の対照を先に取らせていれば 1 往復短縮できた。
9.4 検証環境と利用環境の差は 1 つとは限らない
構築時の検証は AWS 上のテストクライアントで行った。そのため、
resolv.confが公開リゾルバを指していた → 障害 1 が現れなかった- 回線が 9001 バイトのジャンボフレームだった → 障害 2 が現れなかった
「テスト環境が良すぎる」という一つの根から 2 つの障害が出ている。
9.5 利用者に渡す設定は、それ自体が成果物である
インフラが正常であることと、利用者が使えることは別である。2 回とも インフラの障害ではなく、こちらが渡した設定の不備だった。
9.6 「確認できた」の根拠が本当にその主張を支えているか毎回疑う
同じプロジェクトで、これ以外にも 2 回踏んでいる。
- SaaS の IP 制限を確認するのにルート URL の 200 を見ていた。HTML パスは 送信元に関係なく OAuth へリダイレクトするため、許可外の IP からでも同じ 200 が 返る。IP 制限が可視化されるのは API エンドポイントのみだった
- 社内 LAN の遮断を確認するのに、その宛先をトンネルへルーティングせずに ping していた。単にインターネットへ出て捨てられただけで、遮断ルールを 一切通っていなかった
8.3 節で自分の検証条件が間違っていたのも、根は同じである。
対照実験を用意する。「通る条件」と「通らない条件」の両方を測り、差が出ることを 確認して初めて証明になる。片方だけでは何も言えない。
付録: 利用者に渡す設定
[Interface]
PrivateKey = (端末で生成済みのもの。管理者へ渡す必要はない)
Address    = 10.100.0.NN/32          # 払い出した値
DNS        = 1.1.1.1, 8.8.8.8        # 省略不可(障害 1)
MTU        = 1280                    # 省略不可(障害 2)

[Peer]
PublicKey           = <hub public key>
Endpoint            = 203.0.113.10:51820
AllowedIPs          = 0.0.0.0/0
PersistentKeepalive = 25
接続後の確認は 必ず API エンドポイントで行う。
curl -s -w '\ncode=%{http_code}\n' https://tracker.example.com/api/v2/account
#   401 → 許可済み IP から出ている(成功) / 403 → 弾かれている
curl -s https://ifconfig.example      # 198.51.100.20 になること