テストが全部緑だった。だからといって、そのコードについて何かが分かったわけではない。
この記事は、わざとコードを壊してテストが落ちるかを確かめる仕掛け(mutation harness)の話である。専用ツールは使わない。30 行の Python スクリプトを手で書いて回した実例、そこで踏んだ 6 つの罠、同じ発想を共有する周辺の技法、そしてこの検査を AI コーディングエージェントに任せるときの指示の書き方までをまとめた。コード例は Python と pytest だが、発想は言語を問わない。
発端
あるレビューで、こういう指摘を受けた。
このガード、
if False:に書き換えても全テストが緑のままです。
ガードは実在した。コメントも付いていた。レビューでも「妥当な防御」に見えた。 しかし誰も守っていなかった。到達不能な分岐だったのだ。
テストは 20 件すべて緑だった。緑であることは、そのガードについて何も語っていなかった。
これが mutation harness を回す動機のすべてである。
概要 — 何をする道具か
mutation harness とは、わざとコードを壊して、テストが落ちるかを確かめる仕掛けのこと。
- コードを 1 箇所だけ変異させる(mutant を作る)
- テストを回す
- 落ちなければ、その変異は「生き残った(survived)」= テストに検出力がない
- 必ず元に戻す
学術的には mutation testing(ミューテーション(mutation)テスト)と呼ばれる古い技法である
(DeMillo, Lipton, Sayward, 1978)。ただし専用ツール(mutmut / cosmic-ray / Stryker / PIT)は要らない。
手書きの 30 行のスクリプトで十分な価値が出る。 というより、手で狙いを定めたほうが、
自動生成された数千の mutant を眺めるより速く核心に届くことが多い。
なぜ必要か — カバレッジは検出力ではない
行カバレッジ 100% のテストは、assert が 1 つもなくても達成できる。
def test_it_works():
do_everything() # 全行を通る。何も検査していないカバレッジが測るのは「実行されたか」であって「検査されたか」ではない。 この差を埋める唯一の実用的な方法が変異を当てることである。
この主張を実測した続編がある。同じ関数に対する分岐カバレッジ 100% の 2 つのテストスイートが、 ミューテーションスコアでは 0% と 100% に割れた: ホワイトボックスとブラックボックスの違いを実測した
否定的な主張ほど危ない。 「変わらない」「起きない」「呼ばれない」という結論は、 実験が壊れていても同じ形で出る。テストが空振りしていても、対象が存在しなくても、 早期 return で到達していなくても、出力は同じ「緑」だ。
使い方 — 最小の実装
やることは 3 つしかない。
- 対象ファイルの元の内容を保存する
- 変異を当てる → テストを回す → RED / GREEN を記録する
- 必ず元に戻す(
finally/trapで。ここを落とすと作業ツリーが壊れる)
図にすると、2 を「変異」「テスト」「記録」に割った 5 段のループになる。 右側は判定の読み方、下は最後に残す成果物である。
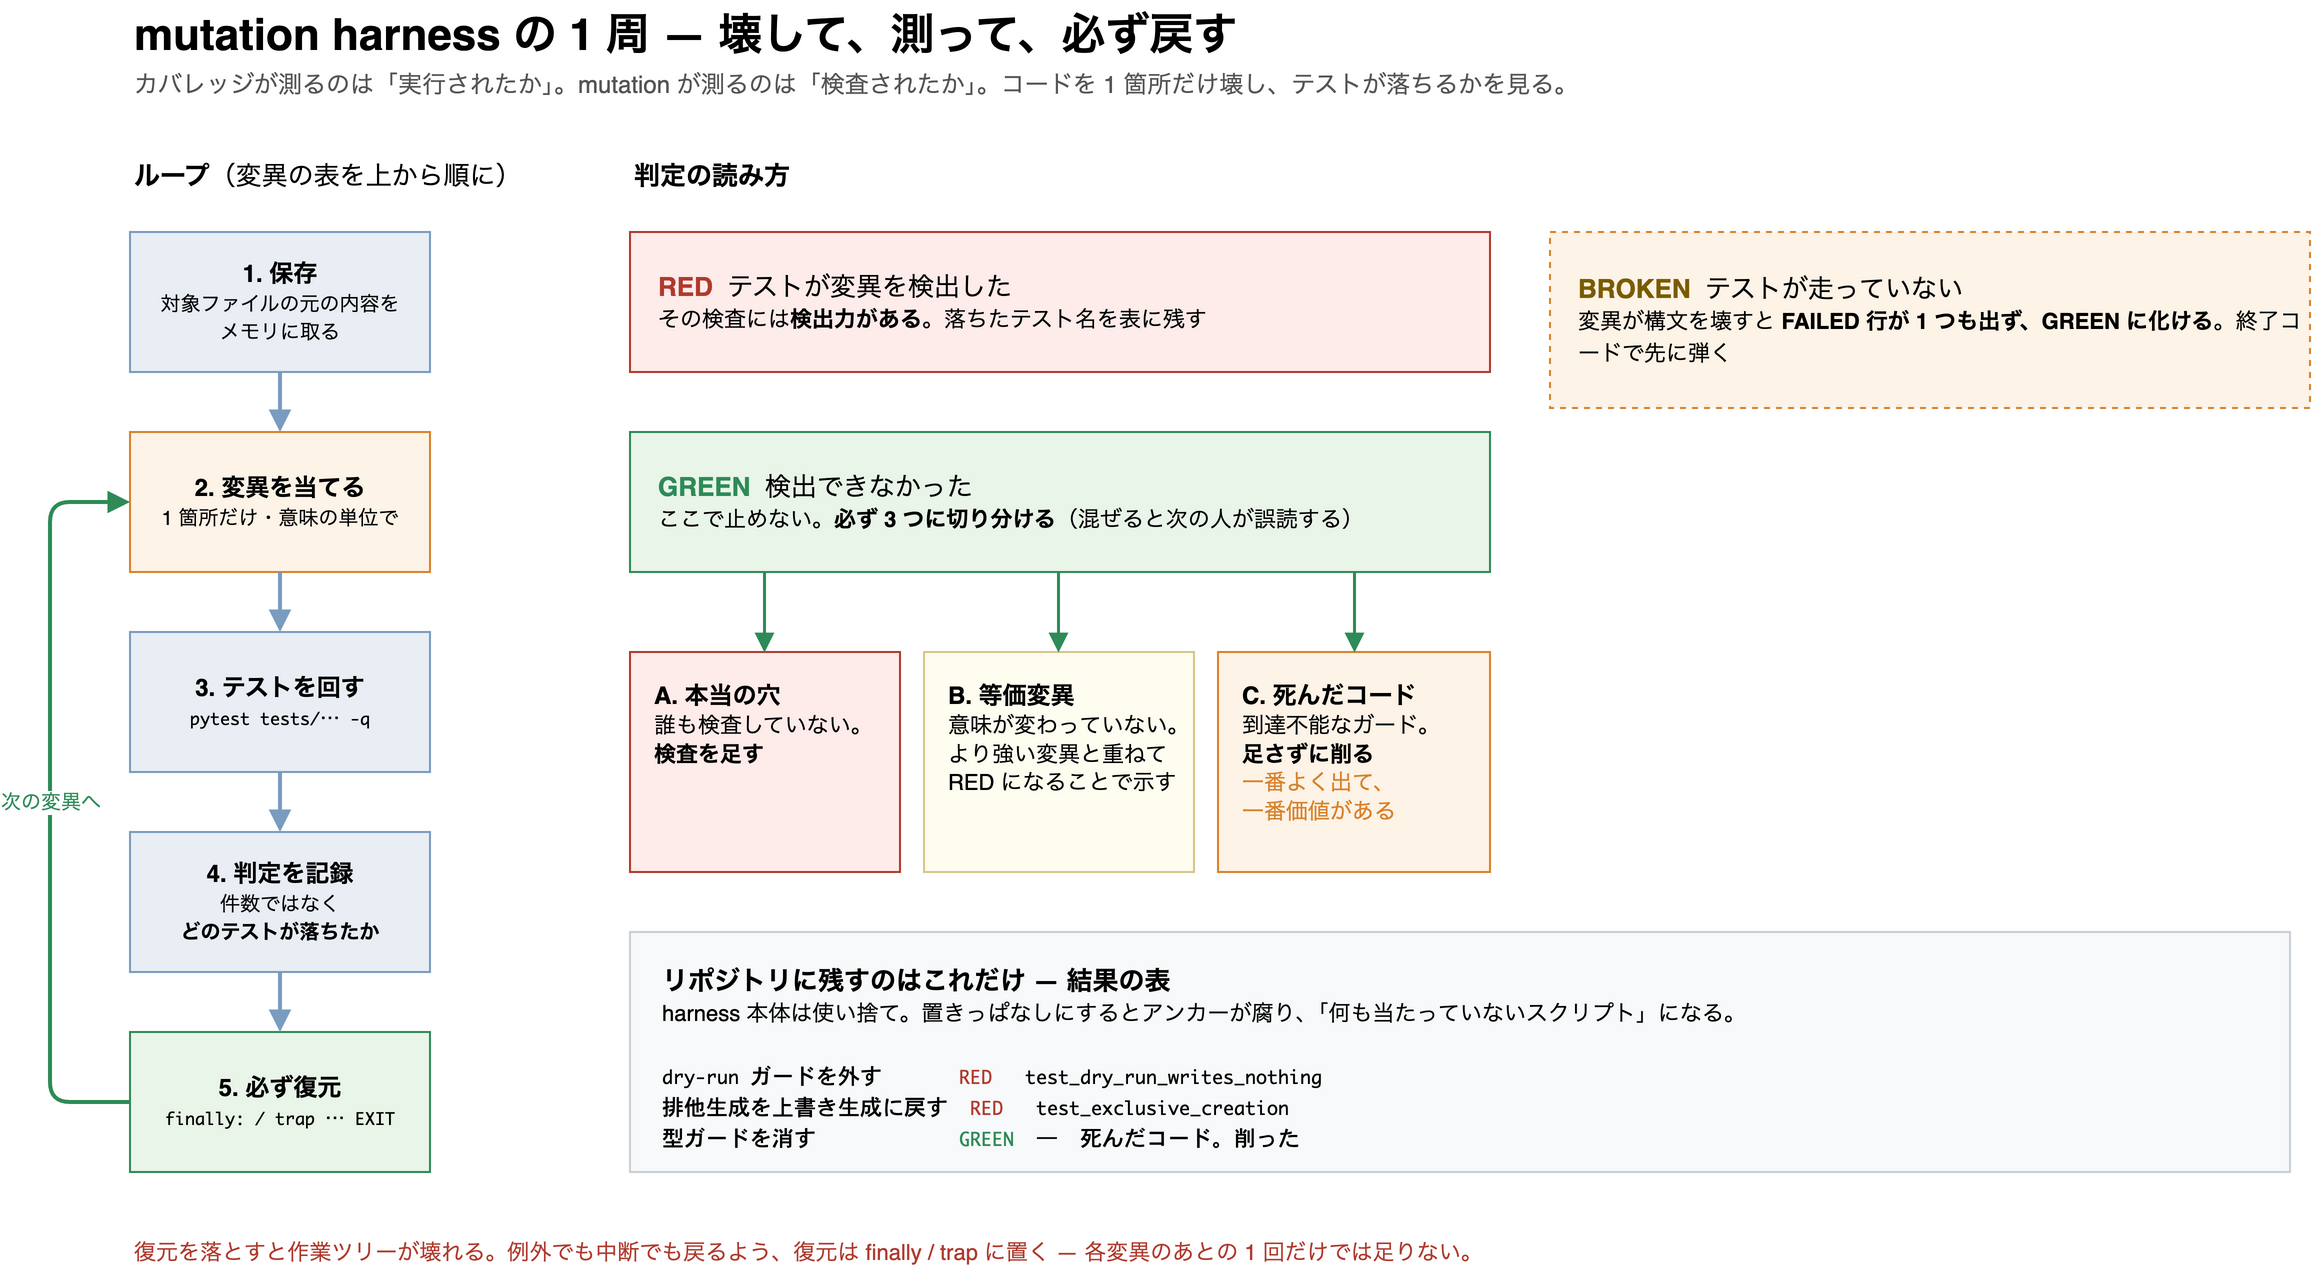
Python なら 30 行で書ける。MUTATIONS のアンカーには行頭のインデントまで含める —
理由は後述する(罠 3 を、この表の書き方だけで踏める)。
import pathlib
import subprocess

TARGET = pathlib.Path("src/prune.py")
TESTS  = "tests/test_prune.py"

MUTATIONS = [
    # (説明, 置換前, 置換後)
    ("dry-run ガードを外す", '    if not apply_it:\n        return 0\n', ""),
    ("排他生成を上書き生成に戻す", 'open(path, "x")', 'open(path, "w")'),
    ("型ガードを消す", '    if not isinstance(data, list):\n        raise SystemExit(...)\n', ""),
]

original = TARGET.read_text()
try:
    for title, old, new in MUTATIONS:
        if old not in original:
            print(f"{title}: !! アンカーが見つからない(表が腐っている)")
            continue
        TARGET.write_text(original.replace(old, new, 1))
        r = subprocess.run(["pytest", TESTS, "-q"], capture_output=True, text=True)
        TARGET.write_text(original)          # 各変異のあとで戻す

        # 変異がテストを「走らせられなくした」場合を先に弾く。
        # pytest は 0=全通過 / 1=失敗あり。それ以外は収集エラー等で、
        # このとき FAILED 行は 1 つも出ない → 素通しすると GREEN に化ける
        if r.returncode not in (0, 1):
            print(f"{title}: !! BROKEN  テストが走っていない(exit {r.returncode})")
            continue

        # FAILED 行は "FAILED tests/test_prune.py::test_name - AssertionError: ..." の形。
        # 失敗理由まで付いてくるので、テスト名だけを取り出す
        failed = [line.split("::")[-1].split(" ")[0]
                  for line in r.stdout.splitlines() if line.startswith("FAILED")]
        print(f"{title}: {'RED' if failed else 'GREEN'}  {failed}")
finally:
    TARGET.write_text(original)              # 例外・中断でも必ず戻す
    print("restored")
出力はこうなる。GREEN が並んだ行が、次に調べるところである。
dry-run ガードを外す: RED  ['test_dry_run_writes_nothing']
排他生成を上書き生成に戻す: RED  ['test_exclusive_creation']
型ガードを消す: GREEN  []
restored
Bash なら trap 'cp "$BACKUP" "$TARGET"' EXIT が同じ役割を果たす。
returncode を見る 4 行が、なぜ要るか
この 4 行は後から足したものである。無いとどうなるかを、実際に見たほうが早い。
アンカーから行頭の 4 スペースを落とすと、削除跡のインデントが壊れて IndentationError になる。
テストは 1 件も走らない。しかし FAILED で始まる行も 1 つも出ないので、素通しすると
「落ちたテストなし」= GREEN と表示される。
dry-run ガードを外す: GREEN [] ← 検出力が無いのではない。実験が動いていないreturncode を見ると、同じ変異がこう出る。
dry-run ガードを外す: !! BROKEN テストが走っていない(exit 2)壊れた実験と、否定的な結果が、同じ出力になっていた。 この記事で繰り返し書いていることが、 harness 自身に返ってきた形である。測る道具も測られなければならない。
結果の読み方
| 結果 | 意味 | すること |
|---|---|---|
| RED | テストがその変異を検出した | その検査には検出力がある。表に記録する |
| GREEN | 検出できなかった | 3 つに切り分ける(下記) |
| BROKEN | テストが走っていない | 変異が汚い。GREEN と混ぜない(罠 3) |
GREEN が出たら、次のどれなのかを必ず判定する。混ぜると次の人が誤読する。
- 本当の穴 — 検査を足す
- 等価変異(equivalent mutant) — 意味が変わっていない。例: 正常系で到達しない
except節の中身を変えた。より強い変異と重ねて RED になることで示せる - 到達不能な死んだコード — そのガードは削る。効かない防御は次に読む人を誤解させる
3 番目が一番よく出る。そして一番価値がある。
どこに置くか
リポジトリに入れない。 mutation harness は使い捨ての計測器であって、成果物ではない。 リポジトリに残すのは結果の表(どの変異がどのテストを落としたか)だけでよい。
置きっぱなしにすると、本体の変更に追随せずアンカーが腐り、 「昔は動いていたが今は何も当たっていないスクリプト」になる。
実例 — 実際に何が見つかったか
ある PR(本番 DB の 1 行を書き換える運用スクリプトとその検証)で、 変異を当てて見つかったものを挙げる。すべて、テストが緑のまま潜んでいた。
到達不能な死んだガード
if class_names(after) != EXPECTED_AFTER and not args.force:
    return 2
--force が無い経路では、直前のチェックで EXPECTED_BEFORE が保証されている。
だから after は決定的に EXPECTED_AFTER になる。--force がある経路では
not args.force が偽。どちらからも到達しない。
if False: に書き換えても全テスト緑。→ and not args.force を外して、
本当に検査したい場面(--force のとき)で効くようにした。
テストが 1 件も無い防御
if not isinstance(data, list):
    raise SystemExit(...)     # 消しても緑だった
docstring には「壊れていたら例外を投げる(黙って空にしない)」と書いてあった。 書いてあるだけだった。
消しても緑な「足場」
検証用に mock を 9 個、フィクスチャを 1 セット足していた。
全部消しても緑だった。 原因は広すぎる except:
try:
    do_it()
    outcome[name] = None
except SpecificError as e:
    outcome[name] = str(e)
except Exception:
    outcome[name] = None      # ← 「成功」と「別の理由で落ちた」が同じ値に潰れる
ここまで潰れると、その先の assert は何も区別しない。足場は足さずに削るのが正解だった。
罠 — 踏んだ 6 つ
6 つとも実際に踏んだ。共通しているのは、どれも出力は正常に出ることだ。 壊れた計測器は、壊れた顔をしていない。
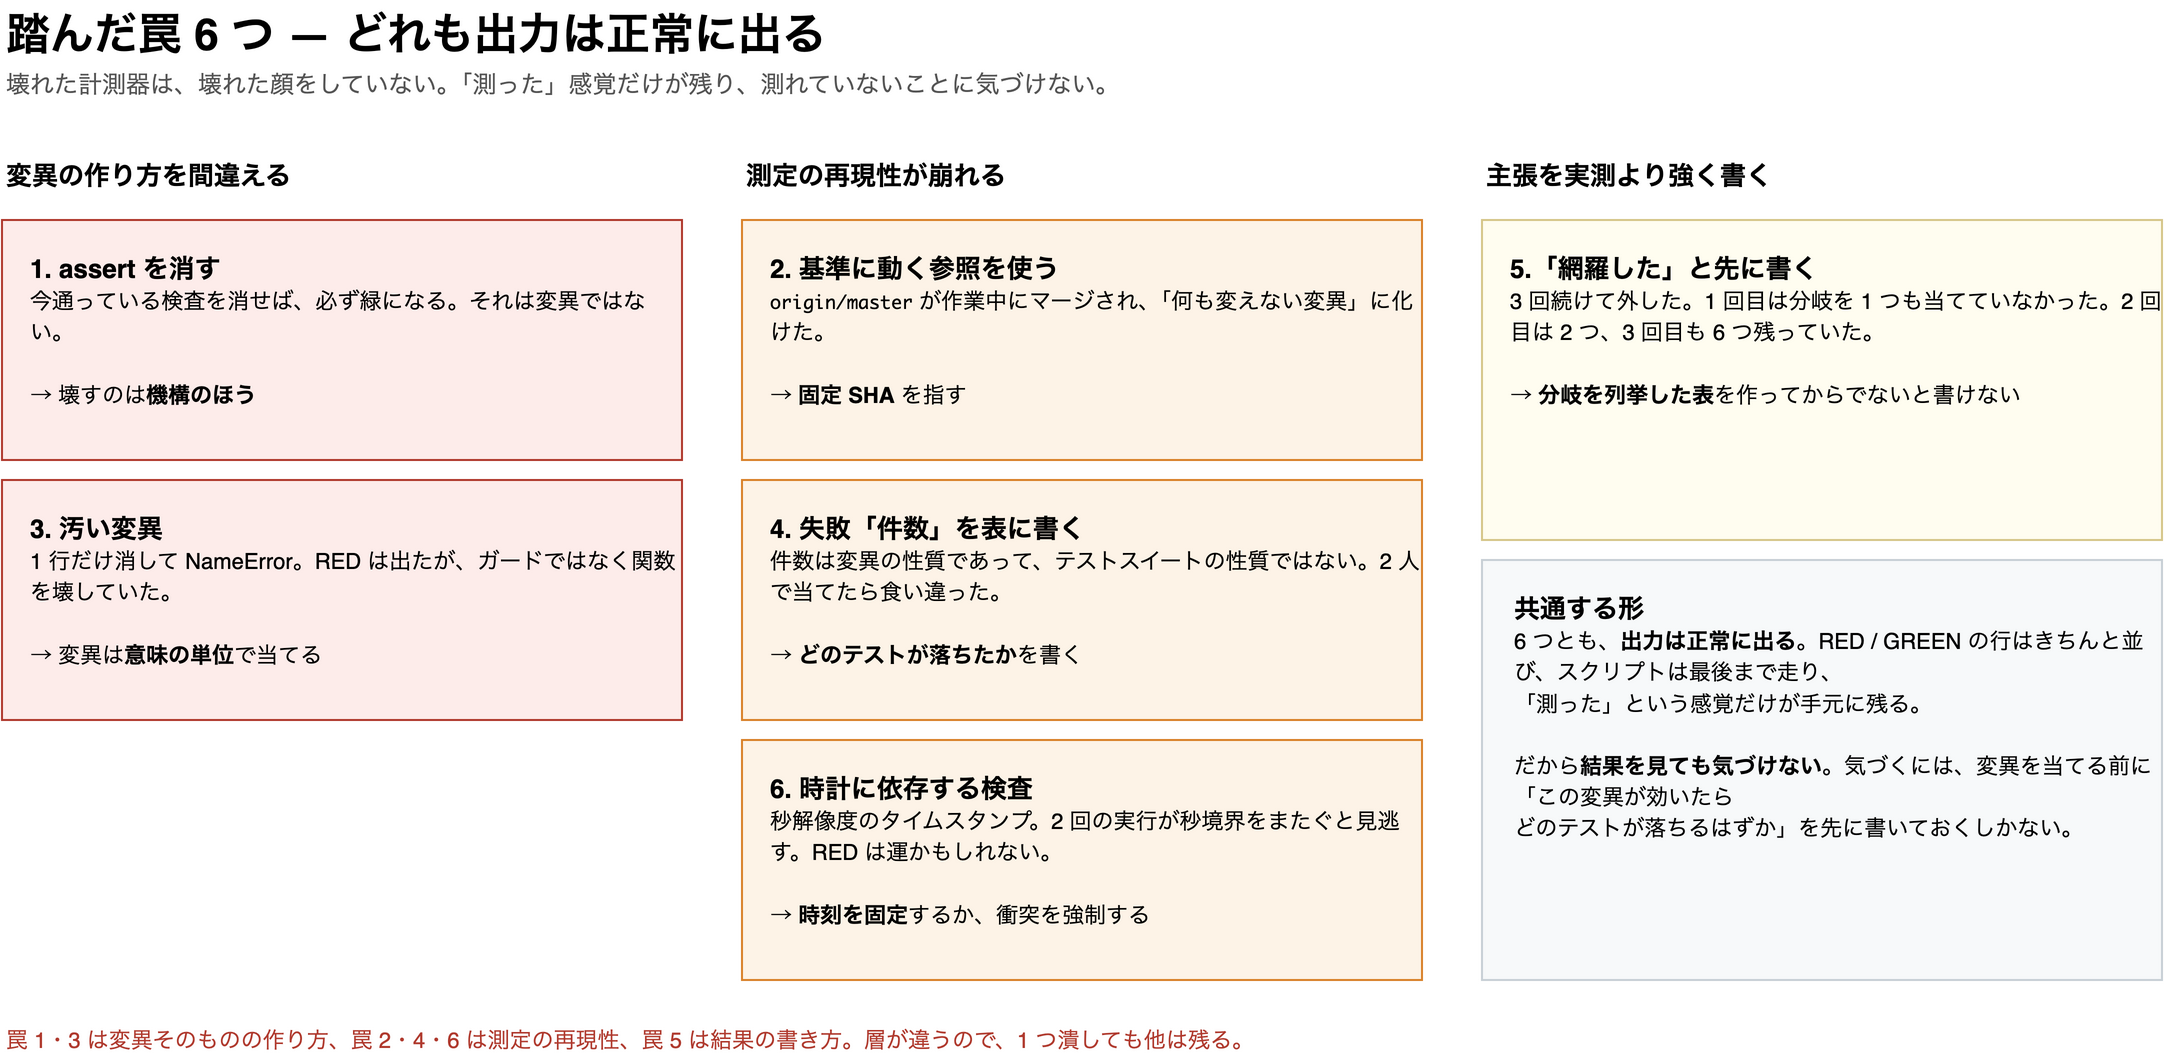
罠 1: assert を消すのは変異ではない
# これは「変異」ではない。今通っている assert を消せば、必ず緑になる
- self.assertGreater(sentinel.reads, 0)
+ pass検出力を測りたいなら、機構のほうを壊す。
# 正しい変異: 番兵が読み取りを数えないようにする
  def __get__(self, obj, objtype=None):
-     self.reads += 1
      raise AssertionError(...)
罠 2: 基準に「動く参照」を使うと黙って無効になる
# NG: 長い作業の途中で基準そのものが動く
git show origin/master:src/foo.py

# OK: 固定 SHA
git show 397bd5774:src/foo.py
比較対象のブランチが作業中にマージされ、「何も変えない変異」に化けたことがある。 出力は正常に出るので「測った」感覚だけが残る。 固定 SHA を指すこと。
罠 3: 汚い変異は、別のものを測ってしまう
  def restore(...):
-     before = write_backup(...)          # この 1 行だけ消した
      print(f"退避: {before}")            # → NameError
RED にはなった。しかしガードを外したのではなく関数を壊していた。 測りたかったものを測っていない。変異は意味の単位で当てる。
罠 4: 失敗件数はテストスイートの性質ではない
同じ趣旨の変異でも、テキストが違えば巻き込む範囲が変わる。
2 人が別々に当てたら、3 つの変異それぞれで落ちたテストの件数が
2 / 9 / 3 と 1 / 10 / 1 に食い違った。どちらも正しい。
→ 表に書くのは件数ではなく、どのテストが落ちたか。
罠 5: 「網羅した」と書く前に、分岐を数え上げる
これを 3 回続けて外した。1 回目は対象ファイルの分岐を 1 つも当てていなかった。 2 回目は「今度は両方覆った」と書いてまだ 2 つ残っていた。3 回目も 6 つ残っていた。
主張の強さを、実際に検証したことに合わせる。 「全部当てた」は、 分岐を列挙した表を作ってからでないと書けない。
罠 6: 時計に依存する検査は、検出力が揺れる
stamp = now().strftime("%Y%m%d_%H%M%S") # 秒解像度「同じ秒に 2 回走ると上書きされる」バグを、2 回の実行が秒境界をまたぐと見逃す。 変異が RED になったのは運かもしれない。時刻を固定するか、衝突を強制する。
似たような考え方
mutation harness は孤立した技法ではない。「その観測は、主張が偽のときに違う結果を出すか」 という一つの問いの、いろいろな現れ方がある。
ポジティブコントロール / ネガティブコントロール(実験科学)
生物学や化学で最初に習うこと。「検出されなかった」と言う前に、 検出できるはずの対象を入れて、実際に検出されることを見る。
ソフトウェアでの対応物:
# 「0 件でした」の前に、1 件出ることを見る
self.assertEqual(24, len(found_for_known_input))   # ポジティブコントロール
self.assertEqual(0,  len(found_for_target))        # 本命
「0 件」を合格の証拠にしない。 対象が空でも 0 件、クエリが壊れていても 0 件、 そもそも到達していなくても 0 件になる。 逆にネガティブコントロールは、検出されないはずの対象を入れて、実際に 0 件になることを見る。 ポジティブだけだと「何を入れても検出する」計測器を見逃す。
反証可能性(Popper)
「この主張が偽なら、何が観測されるはずか」を先に決める。 決められないなら、その実験は主張を支持していない。
GREEN を見たとき「検出力がない」と読むか「バグがない」と読むかは、 先に決めておかないと後付けで都合よく決まる。
交絡(confounding)の排除
「変わらなかった」という結果が、主張が正しいからなのか、 実験の設定がそうさせたからなのかを切り分ける。
実際に踏んだ例: ある属性が「読まれない」ことを番兵(読むと落ちるデスクリプタ)で
示したが、そのクラスにはその属性を触るコードが 1 行も無かった。
番兵が効いていようがいまいが reads == 0 になる。結果が他の形では出ようがない実験は、
証拠ではない。
このときポジティブコントロールは別の属性に当てていた。
だから「番兵という機構は動く」ことは示せても、
「この実験が読み取りを検出しえた」ことは示せない。
この落とし穴の実例は AI エージェントにリファクタさせるときの「完了の定義」の引き方 でも扱っている。
TDD の RED を先に見る
新しいテストを書いたら、まず落ちることを確認してから実装する。 これは「1 個の変異(= 実装が無い状態)を当てている」のと同じこと。 後からテストを足したときに省略されやすい手順で、省略すると検出力ゼロのテストが量産される。
フォールトインジェクション / カオスエンジニアリング
対象がコードではなくインフラになっただけで、発想は同じ。 「落ちても大丈夫なはず」を実際に落として確かめる。 Netflix の Chaos Monkey が有名だが、粒度が違うだけで問いは変わらない。 pytest に障害注入を組み込む具体例は pytest.mark.chaos で始めるカオスエンジニアリング に書いた。
Property-based testing(Hypothesis / QuickCheck)
mutation が「実装を揺らしてテストの感度を測る」のに対し、 property-based testing は「入力を揺らして実装の穴を探す」。 方向は逆だが、どちらも「例示 1 個で満足しない」という同じ不満から来ている。 併用すると強い — 不変条件を property で書き、その property の検出力を mutation で測る。
メタモルフィックテスティング
期待値が書けない対象(機械学習の推論、複雑な数値計算)で、 「入力をこう変えたら出力はこう変わるはず」という関係を検査する。 「変えたら変わること」を見るという点で、mutation と発想を共有している。
コードレビューにおける「削ってみる」
レビューで一番効く質問は、しばしば 「この行、消したら何が壊れますか?」である。 答えられないなら、その行は誰にも守られていない。
AI に検査させるときの指示の書き方
「この行、消したら何が壊れますか?」は、AI コーディングエージェントに投げる問いとしても効く。 ただし投げ方を間違えると、ここまで書いてきた失敗がそのまま再現する。
「適切なテストをして」と指示しても効かない。 エージェントは「妥当な検査に見えるもの」を選んで緑を報告できる。 その報告は、検査が効いていなくても同じ形で出る。 人間が空振りのテストを書くのと、構造はまったく同じである。
指示すべきは手法名ではない。手法の選び方の規則と、止まってよい条件の 2 つである。
実際に渡している指示
先に現物を置く。以下がそのまま貼れる形である。
PR #123 の指摘を検査せよ。

## 前提

- 審査対象の作業ツリー(このリポジトリ)には **書き込むな**。
- mutation は `./run-mutations.sh <commit>` が作る複製の中だけで行え。
- 報告の末尾に、元ツリーの `git status --short` を貼れ。

## 手順

1. 指摘ごとに、**それが何を主張しているか**を 1 行で書け。
2. 主張の形から下表で検査を選べ。**コードの見た目からは選ぶな。**

   | 主張の形 | 検査 |
   |---|---|
   | 「このガード / 検査は効いている」 | mutation |
   | 「〜は起きない」「呼ばれない」「0 件」 | ポジティブコントロール |
   | 「この入力範囲で正しい」 | property-based |
   | 期待値が書けない | メタモルフィック |
   | 「落ちても復旧する」 | フォールトインジェクション |
   | 「挙動を変えていない」 | 固定 SHA との比較 + 特性テスト |

3. 変異を当てる前に、**変異なしでスイートが緑になること**を示せ。
   ここが緑でないなら、以降の RED は変異のせいではない。
4. 表に当てはまらない主張は「当てはまらない」と書け。**近い行に寄せるな。**

## 止まってよい条件

**その検査は、主張が偽のときに違う結果を出すか。** 出ないなら、それは証拠ではない。
「起きない」「変わらない」「0 件」は、実験が壊れていても同じ形で出る。
否定的な結論を出す前に、ポジティブコントロールを 1 件通せ。

## 出力

1 主張 1 行。**件数ではなく、どのテストが落ちたか**を書け。

| 指摘 | 主張(1 行) | 検査 | 実行したコマンド | 結果 | 判定 |

GREEN が出たら 3 つに切り分けよ — 本当の穴 / 等価変異 / 死んだコード。
検査を選べなかった、または走らせられなかったものは **未検査** と明記せよ。
**黙ってコードを読むだけに引き下がるな。**
以下、この指示が何をしているのかを分解する。
1. 検査は「コードの形」ではなく「主張の形」で選ばせる
レビューで出てくる指摘は、必ず何かを主張している。その主張の形が、効く検査をほぼ一意に決める。 表にして渡すのが一番速い。
| 指摘の主張の形 | 効く検査 |
|---|---|
| 「このガード / 検査は効いている」 | mutation — その行を壊して RED になるか |
| 「〜は起きない」「呼ばれない」「0 件」 | ポジティブコントロール — 起きるケースを先に入れ、検出できることを見る |
| 「この入力範囲で正しい」 | property-based — 不変条件を書いて入力を揺らす |
| 期待値が書けない(推論・数値計算・描画) | メタモルフィック — 入力を変えたとき出力がどう変わるはずかを検査 |
| 「落ちても復旧する」「timeout しても安全」 | フォールトインジェクション — 実際に落とす |
| 「既存の挙動を変えていない」(リファクタ) | 固定 SHA との比較(罠 2)+ 特性テスト — 現在の出力をそのまま期待値に固定する |
| 「性能は劣化していない」 | ベースライン付きベンチ — 固定シード・相対値。絶対秒数を根拠にしない |
肝は表そのものより、まず指摘の主張を 1 行で書き出させることにある。 そこを飛ばすと、主張ではなくコードの見た目から検査を選んでしまう。
2. 止まってよい条件を、反証可能な形で渡す
表だけ渡しても形骸化する。次の 1 文を添える。
その検査は、主張が偽のときに違う結果を出すか。 出ないなら、それは証拠ではない。
これは反証可能性の節で書いたことの言い換えにすぎないが、指示に書いていないと実行されない。
3. 書き手と検査役を分ける
一番効くのは、指示の中身より配置である。 プロジェクト共通の設定ファイルに書くと常時読まれるが、書いた本人が自分で検査する形になる。 経験上、同じモデルは同じ思い込みを持つらしく、 書き手が確信を持って間違えた箇所は、検査役にも正しく見える。
だから専用のサブエージェントに分け、使うモデルも実装側と変える。 エージェントを分ければ見ている文脈がずれ、モデルを変えれば間違え方がずれる、という見立てである。 片方だけでは足りない。
この記事自体、書いたモデルとファクトチェックしたモデルを変えて通している。
4. ハーネスは「使い捨ての複製」に組む
ここが実際に詰まったところである。検証エージェントには、普通こういう不変条件を置く。
リポジトリの追跡対象ファイルを変更しない。終わったときに
git statusが検証開始時と同じであること。
そして mutation は対象ファイルを書き換えないと成立しない。正面から衝突する。
「例外を書いて、復元を約束させる」で解決したくなるが、これは筋が悪い。
明るい線は機械的に検査できるが、条件付きの線は検査できないからだ。
「書くな」は git status で判定できる。「書いてよいが必ず戻せ」は、戻し損ねたときにしか
違反が見えない。順序が逆である。しかも失敗したときに壊れるのは、審査対象のソースそのものだ。
かといって「mutation を禁止する」と、「このガードは効いている」という主張を判別する手段が消える。 検査役はコードを読むだけのレビューに引き下がり、その報告は「反証なし」と見分けがつかない。 罠 1(今通っている assert を消せば必ず緑になる)とまったく同じ形である。
出口は、禁止でも例外でもない。変異させる対象を変える。
審査対象のツリー  →  絶対に書かない(git status で機械的に判定できる)
使い捨ての複製    →  ここを壊す。壊れても誰も見ていない
複製を作るところまでをシェルに寄せる。
#!/usr/bin/env bash
# run-mutations.sh <commit-ish>
# 審査対象の作業ツリーには一切書かない。複製を作り、そこだけを壊す。
set -euo pipefail

REV="${1:?検査する commit を指定する}"
WORK="$(mktemp -d)/tree"

# 1. 複製。以後、元のツリーには触らない
git worktree add --detach "$WORK" "$REV"
trap 'git worktree remove --force "$WORK" 2>/dev/null || true' EXIT

# 2. 依存を入れる。submodule を忘れると、
#    「環境が違うから落ちた」を「変異を検出した」と読み違える
git -C "$WORK" submodule update --init --recursive
python3 -m venv "$WORK/.venv"
"$WORK/.venv/bin/pip" install -q -e "$WORK[dev]"

# 3. ポジティブコントロール。変異なしで 1 周回す。
#    ここが緑でないなら、以降の RED は変異のせいではない
if ! "$WORK/.venv/bin/pytest" -q "$WORK/tests"; then
  echo "BASELINE RED — 環境が違う。以降の測定は無意味" >&2
  exit 1
fi

# 4. ここから変異
"$WORK/.venv/bin/python" mutate.py "$WORK"
変異を当てる側は、前半に書いた 30 行から複製のルートを受け取るようにするだけでいい。
import pathlib, subprocess, sys

ROOT   = pathlib.Path(sys.argv[1])          # 複製のルート
TARGET = ROOT / "src/prune.py"
TESTS  = ROOT / "tests/test_prune.py"
PYTEST = ROOT / ".venv/bin/pytest"

MUTATIONS = [
    ("dry-run ガードを外す", '    if not apply_it:\n        return 0\n', ""),
    ("排他生成を上書き生成に戻す", 'open(path, "x")', 'open(path, "w")'),
    ("型ガードを消す", '    if not isinstance(data, list):\n        raise SystemExit(...)\n', ""),
]

original = TARGET.read_text()
for title, old, new in MUTATIONS:
    if old not in original:
        print(f"{title}: !! アンカーが見つからない(表が腐っている)")
        continue
    TARGET.write_text(original.replace(old, new, 1))
    r = subprocess.run([PYTEST, TESTS, "-q"], capture_output=True, text=True)
    TARGET.write_text(original)     # 次の変異と混ざらないように戻す
    if r.returncode not in (0, 1):
        print(f"{title}: !! BROKEN  テストが走っていない(exit {r.returncode})")
        continue
    failed = [line.split("::")[-1].split(" ")[0]
              for line in r.stdout.splitlines() if line.startswith("FAILED")]
    print(f"{title}: {'RED' if failed else 'GREEN'}  {failed}")
finally が消えたことに気づいてほしい。 複製の中なので、途中で落ちて変異が残っても、
壊れるのは捨てるツリーだけである。各変異のあとの復元は残っているが、役割が変わった。
安全のためではなく、変異どうしを独立させるためにある。
不変条件が「守る規律」から「そもそも触れない構造」になった。
5. 複製が持ち込む罠 — 環境差は検出力と見分けがつかない
これは言っておかないとフェアではない。複製には submodule も node_modules も .venv も無い。
入れ忘れたまま走らせると、テストは落ちる。あるいは、何も走らないまま成功して終わる。
実際この構成で踏んだ — submodule を初期化しないまま静的サイトをビルドしたら、 成功したまま記事が 1 枚も出力されなかった。検証は緑だった。
環境差で出た結果は、検出力の結果と見分けがつかない。 記事の主題そのものが、 ハーネスの外側で再演される。だから上のスクリプトの手順 3 がある。 変異を当てる前に、変異なしで 1 周回して期待どおりの結果になることを見る。 これは環境そのものに対するポジティブコントロールである。ここを飛ばすと、 全部 RED の表が「検出力が高い」ように見えてしまう。
6. 「当てたか」ではなく「届いたか」を検査させる
最後は、一番外しやすいところである。
「mutation を当てたか」を検査させると、当てた事実だけ確認して通る。 必要なのは「当てた変異が、検査したい分岐に届いているか」である。 罠 3(汚い変異)と罠 5(数え上げる前に「網羅した」と書く)が、そのままここに出る。
対処も同じで、分岐を列挙した表を先に作らせ、どれに当てたかを埋めさせる。 列挙していない状態で「網羅した」とは書けない。 これは人間に対する規律と、1 文字も変わらない。
まとめ
- カバレッジは「実行されたか」、mutation は「検査されたか」を測る。
- 専用ツールは要らない。30 行のスクリプトと、意味の単位で選んだ数個の変異で足りる。
- GREEN が出たら 3 つに切り分ける: 本当の穴 / 等価変異 / 死んだコード。 死んだコードは足すのではなく削る。
- 否定的な結果ほど疑う。 「変わらない」「起きない」は、実験が壊れていても同じ形で出る。
- 主張の強さを、実際に検証したことに合わせる。 「全部当てた」は、分岐を列挙してからでないと書けない。
- AI に検証させるときは、手法名ではなく「主張の形 → 検査」の対応と停止条件を渡す。
書き手と検査役は分け、復元したという主張にも
git statusという証拠を出させる。
まずは直近の PR から分岐を 1 つ選び、if False: に書き換えてテストを回すところから始めればいい。
エージェントに任せるのは、自分で 1 周回してからでいい。
最後にもう一度。
テストが緑であることは、そのコードについて何も語っていない。 何かを語らせたければ、壊してみるしかない。