ホワイトボックステストとブラックボックステストの違いは、たいていこう説明される。前者は内部構造を見る、後者は入出力だけを見る。定義としては正しいが、これだけ読んでも「で、どちらをどれだけやればいいのか」は分からない。
そこで、定義の整理は最小限にして、実際に走らせた。結論から書くと、同じ関数に対する 4 つのテストスイートはすべて分岐カバレッジ 100% で、うち 2 つが仕込んだバグを見逃した。ミューテーションスコアは 0% と 100% に割れた。そして AI エージェントに実装コードだけを見せてテストを書かせたら、実装のバグをそのまま「正解」として書き写したテストが出てきた。バグが残っているあいだは全件パスし、バグを直すとそのテストが落ちる。テストがバグを守る側に回ってしまう。
計測環境は Python 3.14.7 / pytest 9.1.1 / coverage.py 7.16.1 で、本記事のコードはすべてこの環境で実行した出力を貼っている。
ホワイトボックスとブラックボックスの違い — C0 / C1 / C2 と用語の揺れ
二分法のおさらい
ホワイトボックステストは、プログラムの内部構造に着目して、命令や分岐をどれだけ通したかを基準にテストケースを作る。主に単体テストの工程で使われ、代表的な技法として制御フローテスト(処理の流れを網羅する)とデータフローテスト(データの流れを追う)がある。
網羅の基準は日本語圏では C0 / C1 / C2 という呼び方が定着している。
| 記号 | 呼び名 | 意味 |
|---|---|---|
| C0 | 命令網羅 | すべての命令を 1 回以上通す |
| C1 | 分岐網羅 | すべての分岐を真・偽の両方向に 1 回以上通す |
| C2 | 条件網羅 | 分岐を構成する個々の条件の真偽を組み合わせる |
以降、C1(分岐網羅)は計測ツールの表示に合わせて「分岐カバレッジ」と呼ぶ。
この表で注意したいのは、C0 → C1 → C2 と基準を厳しくしていっても、数えている対象がずっと実装の中身だということだ。命令、分岐、条件 — どれもソースコードに書かれているものを数えている。網羅の粒度を上げる行為は、実装を細かく見る行為であって、仕様に近づく行為ではない。
そのことは、C2 の定義が一意でないという事実にも表れている。SHIFT の解説によれば、複合条件 A and B の扱いには (1) 4 パターン全部、(2) 短絡評価を踏まえた 3 パターン、(3) 関数内の全条件文の全組み合わせ(条件文が 10 個なら 1024 パターン)という複数の立場があり、カバレッジ計測ツールの多くは (2) に従う。つまり「どこまでやれば C2 100% か」という目盛りそのものが、条件文が何個あるか・短絡評価が効くかといった実装の書かれ方で決まっている。仕様は目盛りの決定に一切関与していない。
実務的には、この揺れは「C2 100% でテストしました」という報告が単体では何も特定しない、という注意にもなる。相手が (3) のつもりなら実施量は桁違いだ。ただしこの記事で効いてくるのは前者のほう — 基準をいくら厳しくしても実装の外には出られない、という性質のほうだ。この話には最後にもう一度戻る。
一方のブラックボックステストは、中身を見ずに入力と出力だけを見る。テストケースを絞るための技法が同値分割法(同じ結果になる入力をグループ化し代表値を選ぶ)と境界値分析(グループの境目の値を狙う)で、これらは仕様書から導出される。
ここで、ホワイトボックステストの限界を SHIFT の解説がはっきり書いている。
基本的に、ホワイトボックステストを実施する際には書かれたプログラムを網羅するように設計します。しかし、根本的に誤っていてプログラムに書かれていないと、そもそも間違いを発見できない可能性があるのです。
ホワイトボックステストの穴と、その塞ぎ方
この一文が、この記事の出発点だ。言い換えるとこうなる。
ホワイトボックステストのテストケースは、実装コードを読んで作る。だから「実装に書かれた境界が仕様とずれている」という種類の間違いに対しては、原理的に無力になる。ずれを教えてくれる情報が、読んでいる場所 — コード — のどこにも存在しないからだ。網羅率を上げても、上げる先は同じコードなので何も変わらない。C1 を C2 にしても同じである理由は、さっき見たとおりだ。
では、どうすれば検知できるのか。答えは単純で、コード以外の情報源からテストを作るしかない。つまり仕様書から作る。仕様を読んで同値クラスを切り、その境目の値を取り、その値に対する正解も仕様から引く。これがブラックボックステストのやっていることで、ホワイトボックステストの穴を埋める手段はここしかない。
教科書の結論としてはここで終わりだが、実務で効いてくるのはその先だ。仕様から作れと言われても、実際にどれだけ差が出るのか。作ったつもりで作れていないとき、何を見れば気づけるのか。そこで以降では、導出元だけが違うテストスイートを並べて実際に走らせ、次の 3 点を測る。
- カバレッジで区別が付くか — 付かない。どちらも 100% になる
- ミューテーションスコアで区別が付くか — 付く。0% と 100% に割れる
- 導出元の何が効いているのか — 入力の選び方ではなく期待値の出どころだった。AI エージェントにテストを書かせた実験で、そこがはっきり出る
実験の設計 — 境界値分析と off-by-one を仕込んだ運賃計算関数
仕様はこれだけにする。
運賃 fare(age) を求める
  0〜5 歳    : 0 円
  6〜12 歳   : 500 円
  13〜64 歳  : 1000 円
  65 歳以上  : 700 円
実装には、シニア料金の境界を 1 つずらしたバグを仕込む。
# fare.py
def fare(age: int) -> int:
    if age < 6:
        return 0
    if age < 13:
        return 500
    if age < 66:      # 仕様は「65 歳以上がシニア」。ここが off-by-one
        return 1000
    return 700
ホワイトボックス側のテストは、実装の分岐を 1 本ずつ通す代表値を選ぶ。ここで大事なのは、期待値は仕様から取っていることだ。実装から期待値を写したら同語反復になって議論にならないので、そこは公平にしてある。入力の選び方だけが実装由来という条件だ。
# test_whitebox.py
import pytest
from fare import fare

# 実装の分岐を 1 本ずつ通す代表値。期待値は仕様から取っている。
@pytest.mark.parametrize("age,expected", [
    (3, 0),
    (8, 500),
    (30, 1000),
    (70, 700),
])
def test_fare(age, expected):
    assert fare(age) == expected
ブラックボックス側は、仕様の同値クラスの端、つまり境界値分析で出てくる値を並べる。実装は一切見ていない。
# test_blackbox.py
import pytest
from fare import fare

# 仕様の同値クラス境界から作った値。実装は一切見ていない。
@pytest.mark.parametrize("age,expected", [
    (0, 0), (5, 0),
    (6, 500), (12, 500),
    (13, 1000), (64, 1000),
    (65, 700), (66, 700),
])
def test_fare(age, expected):
    assert fare(age) == expected
結果 — 分岐カバレッジは両方 100%、合否は逆
2 つのスイートを走らせる
ホワイトボックス側。
$ coverage run --branch -m pytest test_whitebox.py -q
....                                                                     [100%]
4 passed in 0.01s

$ coverage report -m fare.py
Name      Stmts   Miss Branch BrPart  Cover   Missing
-----------------------------------------------------
fare.py       8      0      6      0   100%
-----------------------------------------------------
TOTAL         8      0      6      0   100%
命令 8/8、分岐 6/6、カバレッジ 100%。そして 4 件すべてパス。バグは残ったままだ。
ブラックボックス側。
$ coverage run --branch -m pytest test_blackbox.py -q
E       assert 1000 == 700
E        +  where 1000 = fare(65)

test_blackbox.py:12: AssertionError
=========================== short test summary info ============================
FAILED test_blackbox.py::test_fare[65-700] - assert 1000 == 700
1 failed, 7 passed in 0.01s

$ coverage report -m fare.py
Name      Stmts   Miss Branch BrPart  Cover   Missing
-----------------------------------------------------
fare.py       8      0      6      0   100%
-----------------------------------------------------
TOTAL         8      0      6      0   100%
カバレッジはまったく同じ 100%。それでいて age=65 で落ちる。
「分岐カバレッジ 100%」とは何が起きた状態か
ここで指標の意味を確認しておく。分岐カバレッジ 100% とは、すべての if を、成立する側と成立しない側の両方に 1 回以上通した状態のことだ。
def fare(age: int) -> int:
    if age < 6:       # 分岐 1: True / False
        return 0
    if age < 13:      # 分岐 2: True / False
        return 500
    if age < 66:      # 分岐 3: True / False
        return 1000
    return 700
if が 3 つ、それぞれ 2 方向なので、分岐は全部で 6 本。これが coverage report の Branch 6 の正体だ。入力 3 / 8 / 30 / 70 を流すと、6 本すべてに印が付く。
| 入力 | 分岐 1 | 分岐 2 | 分岐 3 |
|---|---|---|---|
| 3 | True | — | — |
| 8 | False | True | — |
| 30 | False | False | True |
| 70 | False | False | False |
これで BrPart 0 / 100% になる。入力が 3 だけだと 29% にしかならない。
似た指標の C0(命令網羅)とは別物だという点も、短い例で見ておく。
# f.py
def f(x):
    y = 0
    if x > 0:
        y = 1
    return y
f(1) だけをテストすると、5 行すべてを実行しているので命令カバレッジは 100% になる。だが x > 0 が偽になる経路 — if を素通りして return に行く道 — を一度も通っていないので、分岐カバレッジは落ちる。
$ coverage run -m pytest -q      # 命令のみ
$ coverage report f.py
Name    Stmts   Miss  Cover
---------------------------
f.py        5      0   100%

$ coverage run --branch -m pytest -q      # 分岐も
$ coverage report -m f.py
Name    Stmts   Miss Branch BrPart  Cover   Missing
---------------------------------------------------
f.py        5      0      2      1    86%   3->5
Missing の 3->5 が「3 行目から 5 行目へ直接抜ける道を通っていない」という意味だ。else のない if を素通りするケースが典型で、C0 だけ見ていると取りこぼす。
カバレッジは「どの道を通ったか」しか見ていない
ここからが本題で、分岐カバレッジは道の通過だけを見ており、その分岐の境界が正しい位置にあるかは見ていない。
それを確かめるために、test_whitebox.py の入力 30 を 65 に差し替えて測ってみる。65 は仕様上バグが露出する唯一の値だ(カバレッジだけを見たいので、このスイートの期待値は実装に合わせてある。仕様どおり 700 にすれば当然落ちる — それがこの記事の主題そのものだ)。
# test_swap.py
import pytest
from fare import fare

@pytest.mark.parametrize("age,expected", [(3, 0), (8, 500), (65, 1000), (70, 700)])
def test_fare(age, expected):
    assert fare(age) == expected
$ coverage run --branch -m pytest test_whitebox.py -q # 入力 3 / 8 / 30 / 70
$ coverage report fare.py
Name Stmts Miss Branch BrPart Cover
-------------------------------------------
fare.py 8 0 6 0 100%
$ coverage run --branch -m pytest test_swap.py -q # 30 を 65 に差し替え
$ coverage report fare.py
Name Stmts Miss Branch BrPart Cover
-------------------------------------------
fare.py 8 0 6 0 100%まったく同じ 100% になる。バグ入り実装では 65 も 30 も同じ age < 66 の True 側に落ちるので、カバレッジから見た 2 つは区別が付かない。バグが出る唯一の値に差し替えても、指標は何も変わらないということだ。
つまり分岐カバレッジという指標は、「実装に書いてある分岐を全部通った」以上のことを一言も言っていない。仕様の境界が実装の分岐境界と一致している保証はどこにもないのに、100% という数字はあたかも網羅が終わったかのように見える。
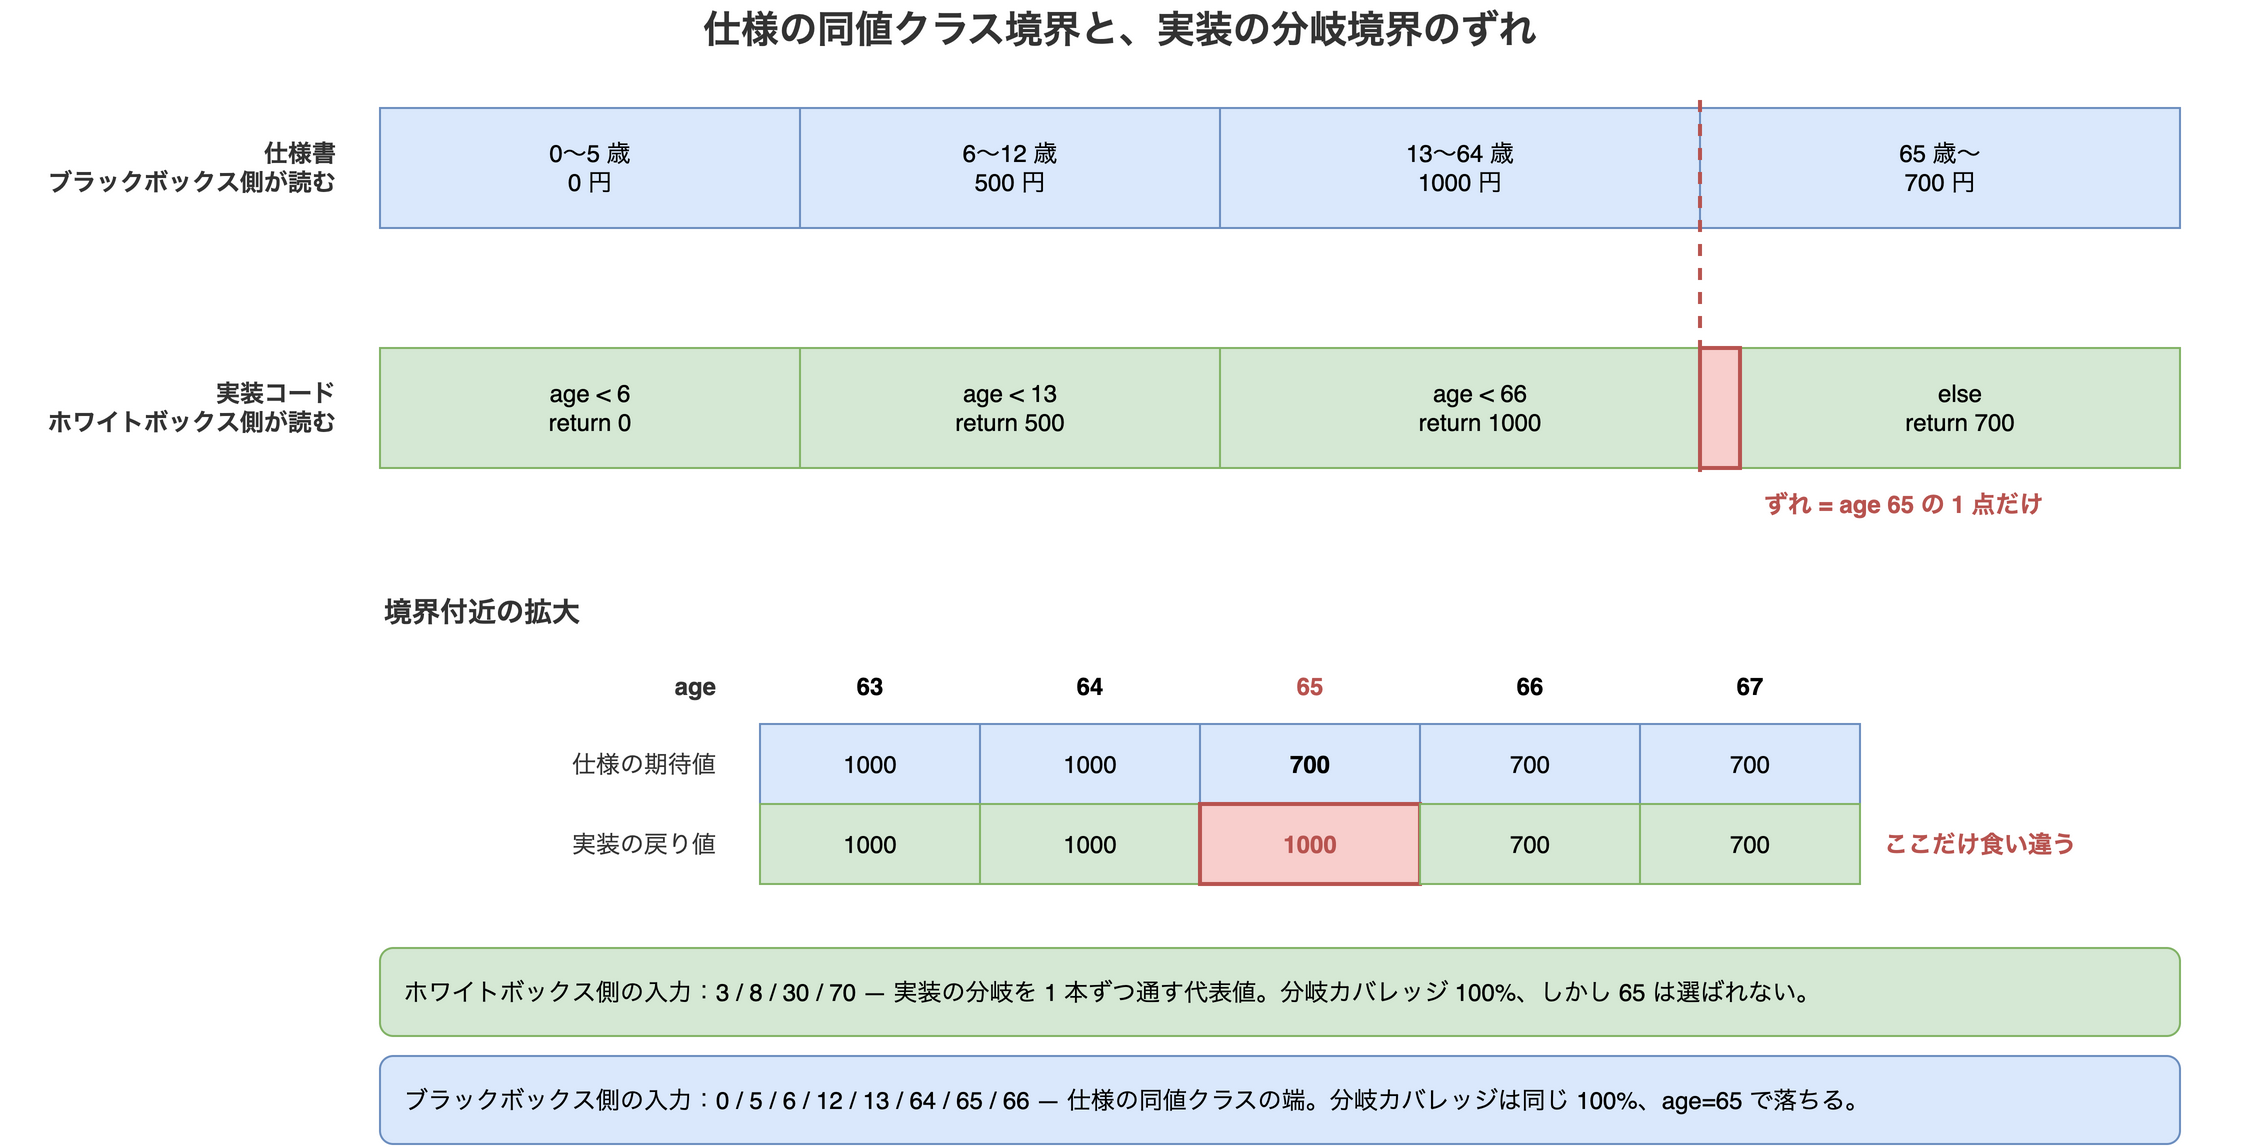
ずれているのは age 65 のただ 1 点だ。ホワイトボックス側の入力 3 / 8 / 30 / 70 は、どれも各分岐の「真ん中」に落ちる。分岐を通すという目的だけなら真ん中でも端でもいいので、実装の分岐を通すことだけを目的に代表値を選ぶかぎり、この 1 点が選ばれる必然性はない。
ミューテーションスコアで測り直す
カバレッジがあてにならないなら、テストの強さを別の方法で測る。前回書いた mutation harness と同じ発想で、実装をわざと書き換え、テストが落ちるかを見る。
殺す・生き残る・スコア
先に用語を決めておく。正しい実装を少しだけ書き換えたものを**変異体(mutant)**と呼ぶ。その変異体に対してテストを走らせて、
- テストが落ちれば、テストは改変に気づいた → その変異体を殺した(killed)
- テストが通ってしまえば、気づかなかった → 変異体が生き残った(survived)
ミューテーションスコア = 殺した数 ÷ 変異体の総数。テストの検出力を表す指標だ。
1 個だけやってみると分かりやすい。正しい実装の age < 65 を age < 64 に書き換える。境界を 1 つずらしただけの変異体だ。
$ pytest test_whitebox.py -q      # 入力 3 / 8 / 30 / 70
....                                                                     [100%]
4 passed in 0.01s

$ pytest test_blackbox.py -q      # 入力に 64 と 65 を含む
=========================== short test summary info ============================
FAILED test_blackbox.py::test_fare[64-1000] - assert 700 == 1000
1 failed, 7 passed in 0.01s
whitebox はこの変異体を生き残らせた。境界が 65 から 64 に動いても、入力 30 は相変わらず 1000 円側、70 は相変わらず 700 円側で、返る値が何も変わらないからだ。blackbox は 64 をテストしていて、64 はちょうど境界が動いた先なので 1000 円が 700 円に変わり、そこで落ちる。こちらは殺したことになる。
境界が 1 ずれたことに気づけるのは、境界の値そのものを踏んでいるテストだけだ。真ん中の値をいくつ並べても気づけない。この性質を 9 個の変異体で一度に測る。
変異体とハーネス
ここは公平を期すために、仕様どおりの正しい実装(age < 65)を土台にする。バグ入りのままだとブラックボックス側のベースラインが赤で、ミューテーションテストの前提(ベースラインが緑)が崩れるからだ。
変異体は境界に効くものだけ 9 個。整数リテラル 6 / 13 / 65 をそれぞれ ±1 したもの 6 個と、< を <= にしたもの 3 個。
# mutate.py
import os, pathlib, shutil, subprocess, sys

# .pyc の有効性は「ソースの mtime(秒単位)+ サイズ」で判定される。同サイズの
# 変異体を 1 秒以内に書き換えると古い .pyc が使い回される。環境変数は新規書き込みを
# 止めるだけで既存の .pyc を無効化しないので、先に消すことの両方が要る。
shutil.rmtree("__pycache__", ignore_errors=True)
ENV = {**os.environ, "PYTHONDONTWRITEBYTECODE": "1"}

BASE = pathlib.Path("fare_ok.py").read_text()   # 仕様どおりの正しい実装
TARGET = pathlib.Path("fare.py")

MUTANTS = []
for lit, alts in [("6", ("5", "7")), ("13", ("12", "14")), ("65", ("64", "66"))]:
    for alt in alts:
        MUTANTS.append((f"age < {lit} -> age < {alt}", f"age < {lit}:", f"age < {alt}:"))
for lit in ("6", "13", "65"):
    MUTANTS.append((f"age < {lit} -> age <= {lit}", f"age < {lit}:", f"age <= {lit}:"))


def run_pytest(suite):
    return subprocess.run([sys.executable, "-m", "pytest", suite, "-q"],
                          capture_output=True, text=True, env=ENV).returncode


for suite in sys.argv[1:]:
    TARGET.write_text(BASE)
    baseline = run_pytest(suite)                 # ポジティブコントロール
    killed, survived = [], []
    for name, old, new in MUTANTS:
        assert BASE.count(old) == 1, f"変異パターンが一意でない: {old}"
        TARGET.write_text(BASE.replace(old, new))
        (killed if run_pytest(suite) != 0 else survived).append(name)
    TARGET.write_text(BASE)
    print(f"== {suite}")
    print(f"   baseline (正しい実装): {'GREEN' if baseline == 0 else 'RED'}")
    print(f"   killed {len(killed)}/{len(MUTANTS)}  (score {100 * len(killed) // len(MUTANTS)}%)")
    for n in survived:
        print(f"   survived: {n}")
結果
$ python mutate.py test_whitebox.py test_blackbox.py
== test_whitebox.py
   baseline (正しい実装): GREEN
   killed 0/9  (score 0%)
   survived: age < 6 -> age < 5
   survived: age < 6 -> age < 7
   survived: age < 13 -> age < 12
   survived: age < 13 -> age < 14
   survived: age < 65 -> age < 64
   survived: age < 65 -> age < 66
   survived: age < 6 -> age <= 6
   survived: age < 13 -> age <= 13
   survived: age < 65 -> age <= 65
== test_blackbox.py
   baseline (正しい実装): GREEN
killed 9/9 (score 100%)分岐カバレッジでまったく同じ 100% に見えた 2 つのスイートが、この指標では最低と最高に分かれた。ちなみに、生き残った変異体の情報を LLM に返してテストを強化するループを実際に組んだ研究もある(LLMLOOP の Loop 5)。
| スイート | 分岐カバレッジ | 殺した / 全変異体 | ミューテーションスコア |
|---|---|---|---|
| whitebox(入力 3 / 8 / 30 / 70) | 100% | 0 / 9 | 0% |
| blackbox(入力 0 / 5 / 6 / 12 / 13 / 64 / 65 / 66) | 100% | 9 / 9 | 100% |
2 つの指標が見ているものが違うからこうなる。カバレッジが訊いているのは「その行を通ったか」で、ミューテーションスコアが訊いているのは「その行が間違っていたら気づくか」だ。whitebox は全部の行を通っているが、9 通りの間違え方すべてに気づけなかった。
代表値を真ん中から選ぶかぎり境界の変異体は 1 つも殺せない、という予想どおりの結果ではあるが、0/9 という全滅は想像より極端だった。
途中で踏んだ罠: __pycache__ で変異体が生き残って見える
最初に書いたハーネスには __pycache__ の後始末が入っていなかった。そのときのスコアが、同じコード・同じ入力のまま実行ごとに動いた。手元で 5 回回すと 4/9、5/9、5/9、9/9、9/9。この記事のファクトチェックを別セッションに頼んだときは、同じ環境で 6/9、9/9、7/9 だった。
原因は .pyc のキャッシュ判定にある。CPython は __pycache__ の .pyc ヘッダにソースの mtime とサイズを記録し、それが一致すれば再コンパイルしない(PEP 552)。そしてこの mtime は秒単位で記録される。age < 6: → age < 5: のような同じ文字数の置換を 1 秒以内に連続で書き込むと、mtime(秒)もサイズも変わらないので古い .pyc がそのまま使われる。テストは 1 つ前の変異体のコードに対して走り、落ちるはずが緑になる。
ここで一段ハマったのが、PYTHONDONTWRITEBYTECODE=1 を入れるだけでは足りないことだった。この環境変数が止めるのは .pyc の書き込みであって、すでにある .pyc の読み込みではない。
$ python -c "import probe; print(probe.fare(0))"   # probe.py は 111 を返す
111
$ # probe.py を同じ文字数で「222 を返す」に書き換えてから
$ PYTHONDONTWRITEBYTECODE=1 python -c "import probe; print(probe.fare(0))"
111
古い .pyc が読まれて 111 のままになる。掲載した mutate.py が起動時に shutil.rmtree("__pycache__") と環境変数の両方をやっているのはこのためだ。
この手の罠が厄介なのは、ハーネスが壊れている方向が「安全側」に見えないことだ。変異体が生き残ったという報告は「テストが弱い」という結論を導くので、一見すると保守的で無害に思える。だが実際にはテストは強かった。自分のハーネスを疑う材料が出力の中に一切ないまま、テスト設計のほうを直しにいく — というのが一番ありそうな失敗の形だった。手計算した期待値と突き合わせていなければ、55% という数字をそのまま信じていたと思う。
ミューテーションスコアが測っていないもの
念のため強調しておくと、これはミューテーションスコアが万能という話ではない。変異体は実装から機械的に作られるので、ミューテーションテストもまた仕様を見ていない。測っているのは「テストが実装を今の形にピン留めしているか」であって、「実装が仕様に合っているか」ではない。
そのことは、この計測を成立させるために正しい実装を土台に選んだ手続きそのものに現れている。バグ入りの実装を土台にすると、仕様側のスイートはベースラインが赤になる。ベースラインが赤のスコアは、0% や 100% のような分かりやすい値にはならず、それらしい中途半端な数字が出る — 次の節でその実例が出てくる。つまりミューテーションテストは「実装は正しい」という前提の上でテストの強度を測る道具であって、その前提自体は測定対象の外にある。
AI エージェントにテストを書かせるとホワイトボックスになる
ここまでは古典的なテスト設計の話だが、コーディングエージェントを使うようになって性質が変わった部分がある。ここは推測で書くと外しそうだったので、測った。
コーディングエージェント(Claude Sonnet)を 2 つ立て、同じ関数のテストを書かせた。片方には実装コードだけ、もう片方には仕様だけを渡し、どちらにもリポジトリの他のファイルは読ませていない。指示は「pytest のテストを書いて」だけで、境界値を狙えといった誘導はしていない。各 1 回の試行なので、傾向の観察であって統計ではない。
実装だけを渡したエージェント
出てきた入力がこれだ。
(0, 0), (5, 0), (6, 500), (12, 500), (13, 1000), (65, 1000), (66, 700), (100, 700)
# 加えて fare(-1) == 0
ここで最初の予想が外れた。「実装を読めば各分岐の真ん中の代表値を選ぶだろう」と思っていたが、エージェントは境界値をきちんと選んでいる。5/6、12/13、65/66 と両側が揃っていて、本人の説明も「各境界の直前値と境界値そのものをペアで網羅し、境界が off-by-one なくコード通り実装されていることを確認する」だった。入力の選び方だけなら、私が手書きした test_whitebox.py よりずっと良い。
問題は入力ではなく期待値のほうにあった。(65, 1000) — 仕様では 700 円のはずの 65 歳について、「1000 円が正解」と書いている。実装の age < 66 を読んでそのとおりに書いたからで、「コード通り実装されている」という本人の説明のとおり、正解の出どころが仕様ではなくコードになっている。
バグ入り実装に対しては、当然こうなる。
$ pytest test_agent_impl.py -q
.........                                                                [100%]
9 passed in 0.01s
分岐カバレッジ 100%、全件グリーン。そして、バグを直すとこうなる。
$ pytest test_agent_impl.py -q     # fare.py を仕様どおりの age < 65 に修正して
FAILED test_agent_impl.py::test_fare_boundaries[65-1000] - assert 700 == 1000
1 failed, 8 passed in 0.01s
バグを修正するとテストが落ちる。このテストはもう、バグを守る側にいる。
仕様だけを渡したエージェント
こちらは 0 / 3 / 5 / 6 / 9 / 12 / 13 / 40 / 64 / 65 / 80 / 120 を選び、各区間の下端・中間・上端を取るという説明だった。バグ入り実装に対しては age=65 で落ちる。
4 スイートを並べる
| スイート | 入力の導出元 | 期待値の導出元 | 分岐カバレッジ | バグ入り実装 | 正しい実装 | ミューテーションスコア |
|---|---|---|---|---|---|---|
| 手書き whitebox | 実装の分岐 | 仕様 | 100% | 4 passed | GREEN | 0/9 |
| 手書き blackbox | 仕様の境界 | 仕様 | 100% | 1 failed | GREEN | 9/9 |
| エージェント(実装のみ) | 実装の境界 | 実装 | 100% | 9 passed | 1 failed | 7/9(無効) |
| エージェント(仕様のみ) | 仕様の境界 | 仕様 | 100% | 1 failed | GREEN | 9/9 |
4 つとも分岐カバレッジは 100% で、バグを検出したのは期待値を仕様から取った 2 つだけだった。
ミューテーションスコアの列は、実装だけを渡したエージェントの行だけ読んではいけない。ベースラインが赤だからだ。
== test_agent_impl.py
   baseline (正しい実装): RED
   killed 7/9  (score 77%)
   survived: age < 65 -> age < 66
   survived: age < 65 -> age <= 65
生き残った 2 個は age < 65 -> age < 66 と age < 65 -> age <= 65、つまり正しい実装をあのバグに戻す変異体だ。テストがバグを期待値にしているので、バグに戻す変異体だけが殺せない。
前節で「赤いベースラインのスコアはそれらしい中途半端な数字になる」と書いたのはこれのことで、77% は何も知らずに見れば「まあまあ強いテスト」に見える。ベースラインの色を出力に載せていなければ、そう読んでいたはずだ。
運用として何を変えるか
- 入力の指示では直らない。このエージェントは境界値を網羅していた。「境界値分析をして」と足しても、境界が実装由来である以上、結果は変わらない。入力の観点を増やしたいなら、QA ペルソナを分けて観点漏れを潰す のように、仕様を見る役を別に立てるほうが効く。
- 期待値の出どころを指示に書く。「期待値は仕様のこの記述から引くこと、実装の戻り値を根拠にしないこと」を明示する。書かなければ手近なほうから取る。仕様が文脈に入っていなければ、エージェントに取れる期待値は実装の戻り値しかない。
- カバレッジを完了条件にしない。今回は 4 スイートすべてが 100% だった。完了条件にするなら、仕様のどの境界を踏んだかのリストのほうが情報量がある。AI にリファクタさせるときの完了条件 と同じ話で、指標を完了条件に据えると指標のほうが最適化される。
- ミューテーションスコアはベースラインの色とセットで読む。緑であることを確認せずにスコアだけ見ると、バグを固定したテストが 77% として通る。
- 実装を書いた主体と、期待値を決める主体を分ける。ファクトチェックで maker-checker を分けた話 と同じ構図が、テストにもそのまま当てはまる。
実装から期待値を取ったテストが完全に無価値なわけではない。次の変更で挙動が変わったら気づくという回帰検出の役には立つ。ただしそれは「今の挙動が正しい」とは一言も言っていない。カバレッジは上がり、レビューは通り、バグは残る。
「仕様も一緒に作ったなら、実装は仕様どおりでは?」
ここまで書くと、こういう反論が来る。プロジェクトの最初からコーディングエージェントで開発していて、仕様書もエージェントと一緒にレビューしながら策定し、顧客にも確認を取っている。そうやって作った仕様から起こしたコードは仕様どおりのはずで、わざわざ仕様からテストを作り直す意味があるのか。エージェントが自分で書いた仕様を誤解して実装するとでも言うのか、と。
もっともな疑問だが、論点が 1 つずれている。この反論が問うているのは実装が間違っている確率で、仕様由来テストの価値が出てくるのは独立性のほうだ。
- 期待値を仕様から引く → 「仕様 → 期待値」と「仕様 → 実装」という 2 本の独立した経路ができる。食い違えば、どちらかが間違っている
- 期待値を実装から引く → 経路は 1 本。同じものを 2 回数えているだけなので、何が起きても食い違わない
複式簿記は経理担当者を疑っているから導入されているわけではない。転記ミスの確率がどれだけ低くても、独立した 2 経路には情報があり、写した 1 経路には情報がない。エラー率がいくら低くても、写した期待値の検出力はゼロのままで、ゼロには掛け算が効かない。
むしろ、その環境では仕様のほうが強い
反論の前提をそのまま受け取ると、成果物のレビュー状況はこうなっているはずだ。
| 成果物 | 目を通した人 |
|---|---|
| 仕様書 | エージェント + 開発者 + 顧客 |
| 実装コード | エージェント(+開発者のレビューがあれば) |
顧客はコードを読んでいない。仕様書を読んで承認している。つまりそのプロジェクトで外部の検証を受けている唯一の成果物が仕様書だ。そこからコードのほうを正解として期待値を取るというのは、誰も外部検証していない成果物をオラクルに採用することにあたる。
エージェントで最初から作っているからこそ仕様書がオラクルとして相対的に強い、という話になる。この記事の主張は、そういう環境で弱まるのではなく強まる。
実際に壊れるのはどこか
「仕様を誤解して誤実装する」も起きるが、主犯ではない。実務で効く順に並べるとこうなる。
- 境界の翻訳 — 「65 歳以上」を
>=に落とす工程は機械的で、ここに off-by-one が住む。以上 / 未満 / 超 / 以下の取り違えは日本語仕様では特に起きやすい - 仕様が形式的でない — 「65 歳以上」は誕生日基準か年度基準か。仕様が黙っている部分は実装が勝手に決め、それが未レビューのまま既成事実になる
- ドリフト(これが最大) — 仕様は 1 回書かれ、コードは何百回も編集される。リファクタ、別機能の追加、性能改善。そのたびにコードは仕様から離れうる。仕様由来テストはそれに気づく唯一の仕掛けで、コード由来テストは変更のたびに作り直せば常に現在のコードに同意する
- 仕様変更の取りこぼし — 顧客が「65 → 60」を承認し、仕様書を更新した。コードは追随したか。落ちるべきテストがなければ誰も気づかない
- 相関した誤解 — 同じモデルが仕様・実装・テストを書くと、要件の読み違いが 3 つすべてに一貫して伝播し、どこも食い違わない。ただし開発者と顧客が仕様をレビューした時点で、この鎖は仕様のところで切れている。だからこそ仕様が使える
なお、この記事の fare.py はバグを故意に埋めたものなので、発生頻度については何も測っていない。主張は「エージェントはよく間違える」ではなく、「写した期待値では、間違いの頻度がどうであれ検出できない」のほうだ。
この議論が崩れる条件
条件が 1 つある。仕様書がコードから作られている場合は、まったく同じ問題が起きる。「この実装をドキュメント化して」で生まれた仕様書は独立した情報源ではなく実装の写しで、名前が「仕様書」でも独立性はゼロだ。
効いているのは成果物の名前ではなく、導出の向きのほうだ。
- 仕様 → コード、仕様 → テスト = 独立。使える
- コード → 仕様 → テスト = 見かけだけ独立。使えない
プロトタイプを先に書いてから仕様を起こす順になっているプロジェクトは珍しくないので、自分のところがどちらなのかは一度確認する価値がある。
CLAUDE.md に書けば直るのか
ここまでの実験は「仕様だけ」「実装だけ」という人工的な分離だった。実際のリポジトリでは両方が存在する。そのときエージェントはどちらを正解に採るのか、そして「期待値は仕様から引け」とプロジェクトのルールに書いておく必要があるのか。ここも測った。
仕様と実装の両方を渡したうえで、ルールの有無だけを変えた 2 条件を走らせる。
- 条件 A — 指示なし。仕様と実装を貼って「テストを書いて」とだけ言う
- 条件 B — 同じ材料に、CLAUDE.md 相当のルールを添える。「期待値は必ず仕様書の記述から導出すること。実装の戻り値を期待値の根拠にしてはならない」
結果: 差が出なかった
| 条件 | 渡したもの | 期待値の出どころ | バグ入り実装に対して |
|---|---|---|---|
| 実装のみ(既出) | 実装 | 実装 | 9 passed(バグを固定) |
| A: 指示なし | 仕様 + 実装 | 仕様 | 1 failed |
| B: ルールあり | 仕様 + 実装 + ルール | 仕様 | 1 failed |
$ pytest test_both_plain.py -q     # 条件 A
FAILED test_both_plain.py::test_fare[65-700] - assert 1000 == 700
1 failed, 11 passed in 0.01s

$ pytest test_both_ruled.py -q     # 条件 B
FAILED test_both_ruled.py::test_fare[65-700] - assert 1000 == 700
1 failed, 7 passed in 0.01s
A と B に差はなかった。どちらも自発的に仕様を正解に採り、しかも報告の中で「実装側の境界バグ疑い」と食い違いを指摘してきた。
ここから言えるのは、決定要因がルールの有無ではなく仕様が文脈に入っているかどうかだということだ。実装しか渡していない最初の実験でバグが固定されたのは、モデルが横着したからではなく、単に取れる正解が実装しかなかったからだ。
この実験は楽な条件だという注意
ただしこの結果には交絡がある。条件 A では仕様を実装より先に、「仕様書(顧客確認済み)」という見出し付きで貼っている。関数は 7 行、ずれは 1 箇所、65 歳以上 と age < 66 という露骨な不一致だ。
実際のリポジトリはこうならない。仕様は docs/ の中の別ファイルにあり、エージェントがそれを開くとは限らない。「このモジュールのテストを書いて」と言われたエージェントがコードだけ読んでテストを書くのは普通に起こることで、そのとき起きるのは「実装のみ」条件のほうだ。n も各 1 回で、傾向の観察に過ぎない。
実際に書くべきルール
そう考えると、CLAUDE.md に書く価値はある。ただし理由は「書かないといい加減になるから」ではなく、仕様を読ませるためだ。
## テスト生成のルール

- テストを書く前に、対象機能の仕様を `docs/specs/` から読むこと。
  仕様が見つからない場合はテストを書かず、どこにあるか確認すること。
- 期待値は仕様の記述から導出すること。実装の戻り値を期待値の根拠にしない。
- 仕様と実装が食い違う場合、テストは仕様に従わせ、食い違いを報告すること。
- カバレッジ 100% を完了条件にしない。仕様のどの境界を踏んだかで報告すること。
重いのは 1 行目だ。2 行目だけ書いても、仕様がコンテキストに入っていなければ従いようがない。「期待値は仕様から」というルールは、仕様が読まれていて初めて意味を持つ。3 行目は今回 A・B とも自発的にやったが、明示しておくほうが安全だ。4 行目は測定の完了条件を指標から外すためのもので、この記事の前半がその理由になっている。
まとめ
- ホワイトボックス / ブラックボックスの違いは「内部を見るか」ではなく、テストケースの導出元が実装か仕様かという違いとして捉えるほうが実務では効く。さらに分けるなら、効いてくるのは入力より期待値の導出元だった。
- 分岐カバレッジ 100% の 4 スイートのうち 2 つがバグを見逃した。カバレッジは実装の分岐を通したかしか言っていない。
- ミューテーションスコアでは 0% と 100% に割れた。ただしミューテーションテストも実装しか見ていないので、仕様適合の証明にはならない。ベースラインが赤なら、スコアは読んではいけない。
- 変異体を書き換えるハーネスは、
__pycache__を消すこととPYTHONDONTWRITEBYTECODEの両方が要る。環境変数は書き込みを止めるだけで、既にある.pycは読まれる。 - エージェントに「このコードのテストを書いて」と頼むのは、ホワイトボックステストの発注である。しかも壊れるのは入力の選び方ではなく期待値のほうで、出てきたのは実装のバグをそのまま正解として書き写したテスト — バグを直すと落ちるテストだった。
- 「仕様もエージェントと一緒に作ったのだから実装は仕様どおりのはず」は、確率の話であって独立性の話ではない。写した期待値の検出力は、エラー率がいくら低くてもゼロのままだ。
- 分けるべきなのはテスト全体ではなく、入力値と期待値だ。入力は実装由来でもよく、むしろ仕様の境界と実装の分岐の両方から集めるのが最善だった。一方通行にすべきなのは期待値だけで、これは仕様からしか取ってはいけない。「実装コードからテストを作るな」ではなく、実装コードから正解を決めるなが正確なところだ。
- ホワイトボックステストを捨てろという話ではない。到達しないコードや死んだ分岐、仕様に書かれていない実装上の経路を洗い出すのは今もカバレッジの仕事だ。できないのが仕様適合の判定だけ、というだけの話で、カバレッジ 100% を「テストが十分」と読み替えるところが間違いになる。
- エージェントに仕様と実装の両方を渡すと、ルールを書かなくても仕様を正解に採った。効くのはルールの有無より仕様が文脈に入っているかで、CLAUDE.md にまず書くべきは「期待値は仕様から」より前に「テストを書く前に仕様を読め」のほうだ。
最初に置いておいた C2 の話に戻る。目盛りを C1 から C2 に上げても結論は変わらない。C2 が細かく見る「個々の条件」もまた実装に書かれたものであり、どこまでやれば 100% かという基準そのものが実装の形から作られているからだ。網羅の粒度をいくら上げても、導出元が実装であるかぎり、仕様に書いてあって実装に書かれていないことは見つからない。二分法の片方だけでは足りない、という教科書の結論は正しい。正しいのだが、その「足りなさ」が具体的に何 % に見えるのかは、実際に測ってみるまで分からなかった。