S3 に Parquet ファイルを置いておけば、とりあえず Athena や Spark から SQL を投げられます。ただし 1 行だけ直したい、昨日の状態に戻したい、列を 1 つ足したい、となると途端に面倒になります。こうした課題の解決策として広まっているのが Apache Iceberg です。
この記事では、次の 3 つの資料を手がかりに Iceberg の位置づけと仕組みを整理します。後半では、手元の分析でよく使われる DuckDB から Iceberg テーブルを読み書きする方法と、現時点の制約を具体的に見ていきます。
- Apache Iceberg– なぜ今、Icebergなのか?(Qiita)
- 【第1回】AWS × Apache Iceberg入門:データレイクの課題とIcebergの全体像を整理してみた(NTTインテグレーション)
- Apache Iceberg とは(AWS)
Apache Iceberg とは
Apache Iceberg は、オブジェクトストレージ上に置かれたファイル群を、データベースのテーブルのように扱えるようにするオープンテーブルフォーマットです。Netflix で開発され、のちに Apache Software Foundation に寄贈されました。ライセンスは Apache 2.0 です。
ここで混同しやすいのが Parquet や ORC との関係です。Parquet は「1 つのファイルの中身をどう並べるか」を決めるファイルフォーマットです。一方の Iceberg は、「どのファイルの集まりが、いまこのテーブルを構成しているのか」を管理するテーブルフォーマットです。Iceberg のデータ本体は多くの場合 Parquet で保存されるので、両者は競合せず、レイヤーが違います。
Qiita の記事は、データ基盤を次の 3 層で捉えています。
| 層 | 役割 | 例 |
|---|---|---|
| 分散ストレージ | 大量のデータを安く保持する | S3、HDFS |
| 計算エンジン | クエリを実行する | Spark、Trino、Athena、Snowflake、DuckDB |
| テーブル化技術 | ファイル群をテーブルとして見せる | Iceberg、Delta Lake、Hudi |
Iceberg はこの 3 層目にあたります。
なぜ今 Iceberg なのか:エンジンとデータの疎結合
Qiita の記事が強調しているのは、技術的な機能よりも設計思想の部分です。
従来の DWH(データウェアハウス)では、ストレージ・テーブル管理・計算エンジンが 1 つの製品に閉じていました。チームごとに別の DWH を使えば、同じデータのコピーがそれぞれに作られ、どれが正しいのか分からなくなります。
Iceberg はテーブル管理の層を OSS の仕様として切り出します。データは S3 に 1 か所だけ置き、BI チームは Snowflake から、データエンジニアは Spark から、アナリストは手元の DuckDB から、という具合に用途ごとにエンジンを選べるようになります。記事はこれを、指標定義の独立になぞらえています。BI ツールの中に埋め込まれていた指標定義を、dbt semantic layer や Cube といった独立したツールで管理するようになった流れです。
その代わり、Qiita の記事も指摘しているとおり、自由度が上がるほど運用とガバナンスは複雑になります。誰がどのエンジンから書き込めるのかを決める仕組みが別途必要です。
従来の S3 データレイクの何がつらいのか
NTTインテグレーションの記事は、S3 中心のデータレイクで起きがちな課題を次のように整理しています。
| 項目 | 従来の S3 データレイク | Iceberg |
|---|---|---|
| 更新・削除 | 1 行の修正でもファイル(パーティション)単位の作り直しになりがち | レコード単位の UPDATE / DELETE / MERGE を扱える |
| 履歴管理 | スナップショットを自前で管理しないと過去の状態に戻せない | タイムトラベルで過去の状態を参照できる |
| スキーマ変更 | 互換性の確認に手間がかかる | スキーマ進化を前提にした設計 |
スキーマ進化とは、列の追加・削除・名前変更などを、既存のデータファイルを書き換えずに行えることです。記事はメリットとして、Hive 方式の運用で負担になりがちなパーティションの追加・修復を意識しなくてよい場面が増える点も挙げています。
これに加えて、AWS の解説ページは ACID トランザクションとインクリメンタル処理(前回から変わった分だけを処理する)を主な特徴に挙げています。
Iceberg の仕組み:カタログ・メタデータ・データの階層
これらの機能は、Iceberg がファイルの上に重ねるメタデータの階層によって実現されています。
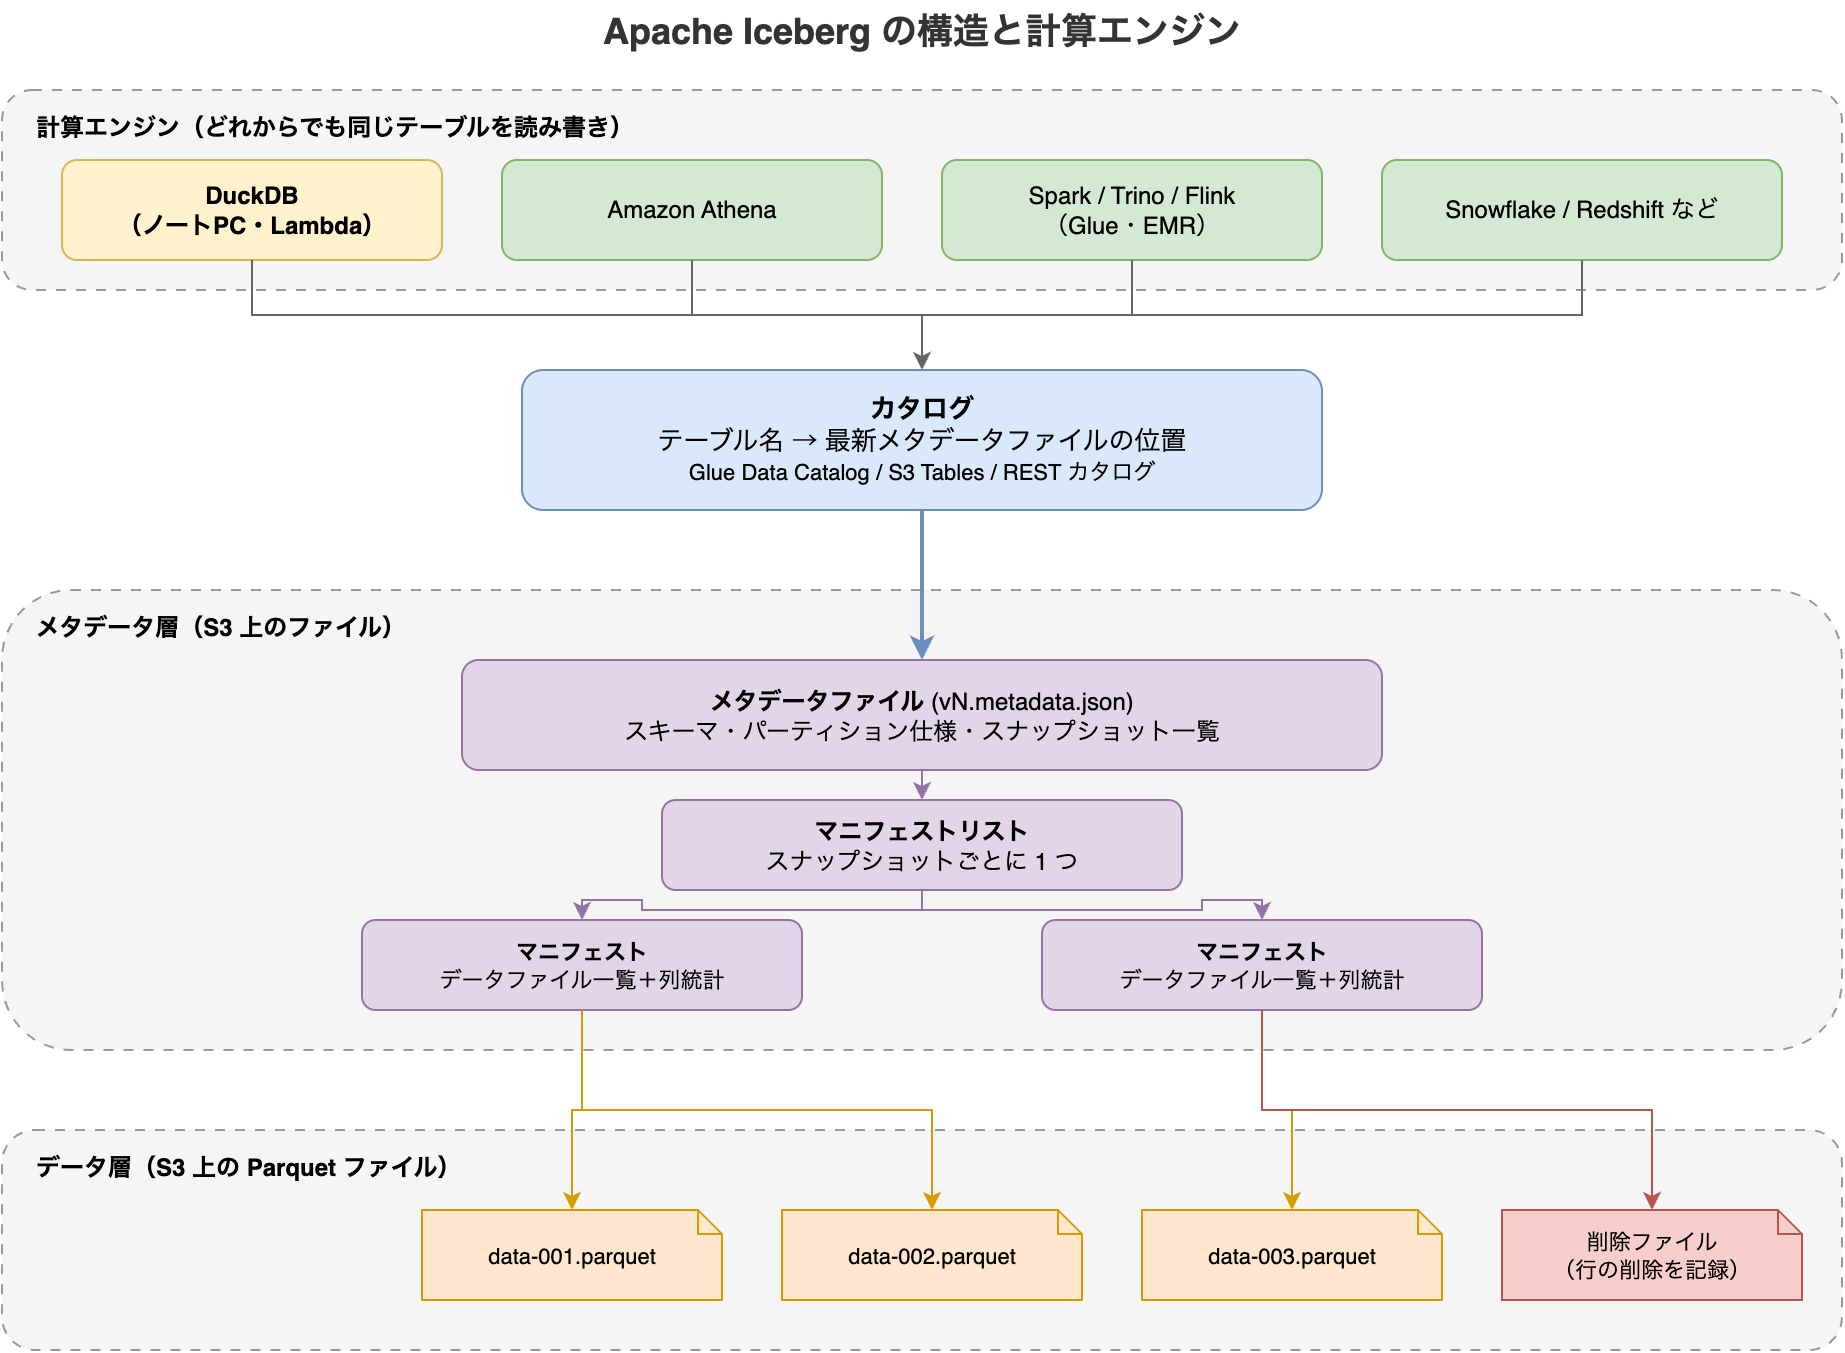
カタログ
テーブル名と、そのテーブルの「最新のメタデータファイルがどこにあるか」を対応づける入り口です。AWS なら AWS Glue Data Catalog や Amazon S3 Tables がこの役割を担います。ベンダー中立な Iceberg REST カタログという API 仕様もあり、エンジン側はこれに対応していれば、カタログの実装を問わずに接続できます。
メタデータ層
- メタデータファイル(
vN.metadata.json):スキーマ、パーティションの仕様、これまでのスナップショットの一覧を持ちます。 - マニフェストリスト:スナップショットごとに 1 つ作られ、そのスナップショットを構成するマニフェストを列挙します。
- マニフェスト:データファイルのパスと、列ごとの最小値・最大値などの統計情報を持ちます。
データ層
実データの Parquet ファイルと、行の削除を記録する削除ファイルです。行を削除するとき、Parquet ファイルを書き直す代わりに「どのファイルの何行目を消したか」を削除ファイルに記録しておき、読み取り時に除外する方式があります。後述する DuckDB の書き込みは、この方式を使います。
構造が機能をどう支えているか
書き込みのたびに新しいファイルが追加され、新しいスナップショットができます。最後にカタログが指すメタデータファイルを新しいものへアトミックに差し替えることで、書き込みは「全部反映されるか、何も反映されないか」のどちらかになります。これが ACID を支えています。
古いスナップショットのメタデータは残っているので、それをたどれば過去の状態を読めます。これがタイムトラベルです。また、マニフェストに列統計があるため、エンジンはファイルを開かずに「この範囲のデータは含まれない」と判断して読み飛ばせます。
パーティションも同じ考え方です。Iceberg では day(event_time) のように「列からパーティション値を導く変換」をテーブル定義に持たせます。クエリは event_time で絞り込むだけで済み、利用者がパーティション用の列を意識する必要がありません。これを hidden partitioning(隠れパーティショニング)と呼びます。
AWS での使い方
NTTインテグレーションの記事は、AWS で Iceberg を使う典型構成を次のように示しています。
- 各種ソースから S3 にデータを取り込む
- AWS Glue や Amazon EMR で整形し、Iceberg テーブルとして書き込む
- 更新・削除・履歴管理は Iceberg に任せる
- Amazon Athena などで参照・検証する
AWS の解説ページによると、Athena、EMR、Glue、Redshift、Amazon Data Firehose がそれぞれ Iceberg に対応しています。NTTインテグレーションの記事は、今後の検証対象として Amazon S3 Tables も挙げています。S3 Tables は Iceberg テーブルの保存に特化した S3 のバケット種別で、後述のとおり DuckDB からも直接接続できます。
DuckDB との関係
ここからが本題です。DuckDB はプロセス内で動く分析用データベースで、ノート PC や Lambda のような小さな環境でも動かせます。DuckDB 自体の位置づけは DuckDB・Apache Arrow・Parquetの関係を整理する を参照してください。
冒頭のデータ基盤の 3 層モデルに当てはめると、DuckDB は計算エンジンの 1 つです。Spark クラスタを立てるほどではない規模の分析を、S3 上の Iceberg テーブルに対して直接実行できます。DuckDB からは iceberg 拡張を使ってアクセスします。通常は初回の利用時に自動でインストール・ロードされます。明示する場合は次のとおりです。
INSTALL iceberg;
LOAD iceberg;
テーブルを直接読む(カタログなし)
iceberg_scan にテーブルのディレクトリやメタデータファイルを渡すと、カタログを介さずに読めます。S3 上のテーブルを読む場合は httpfs 拡張と S3 の認証情報も必要です(認証情報は後述の CREATE SECRET で設定します)。
SELECT count(*)
FROM iceberg_scan('s3://bucketname/lineitem_iceberg/metadata/v1.metadata.json');
スナップショットの一覧やタイムトラベルにも対応しています。
-- スナップショットの一覧
SELECT * FROM iceberg_snapshots('data/iceberg/lineitem_iceberg');

-- 特定時点の状態を読む
SELECT count(*)
FROM iceberg_scan(
    'data/iceberg/lineitem_iceberg',
    snapshot_from_timestamp = TIMESTAMP '2023-02-15 15:08:00'
);ただし、この方法は読み取り専用です。また、どのメタデータファイルが最新かを DuckDB 側では判断できません。そのため、バージョンを明示するか、最新のメタデータのバージョンを書いた version-hint.text ファイルが必要です。上のディレクトリを渡す例も、このファイルがある場合にだけ動きます。最新版を推測させる unsafe_enable_version_guessing という設定もあります。ただし名前のとおり ACID の保証を破る可能性があるため、既定では無効です。
カタログに ATTACH する
本格的に使うなら、カタログに ATTACH します。以下の <...> の部分は、自分の環境の値に置き換えてください。Amazon S3 Tables の場合は次のとおりです。
CREATE SECRET (
    TYPE s3,
    PROVIDER credential_chain
);

ATTACH '<S3 テーブルバケットの ARN>' AS my_catalog (
    TYPE ICEBERG,
    ENDPOINT_TYPE s3_tables
);
AWS Glue Data Catalog の Iceberg REST エンドポイントにつなぐ場合は、SigV4 認証を指定します。
ATTACH '<ACCOUNT_ID>' AS glue_catalog (
    TYPE ICEBERG,
    ENDPOINT 'glue.<REGION>.amazonaws.com/iceberg',
    AUTHORIZATION_TYPE 'sigv4'
);
ATTACH したテーブルには、DuckDB のテーブルと同じように SQL を書けます。カタログ経由なら、書き込みも可能です。次の例は、先ほど my_catalog として ATTACH したカタログに default.events テーブルがある想定です。
SELECT count(*) FROM my_catalog.default.events;

UPDATE my_catalog.default.events SET event_name = 'view' WHERE id = 1;

-- タイムトラベル
SELECT * FROM my_catalog.default.events
AT (TIMESTAMP => TIMESTAMP '2025-09-22 12:32:43.217');
DuckDB の公式ブログによると、読み取りの全面対応と書き込みの初期対応は v1.4.0 で入り、Iceberg v2 テーブルへの UPDATE / DELETE は v1.4.2 で追加されました。現行のドキュメントには MERGE INTO の例も載っています。
書き込み時の制約
一方で、制約もあります。公式ドキュメントに記載されている主なものは次のとおりです。
- 書き込みにはカタログへの ATTACH が必要です。
iceberg_scanによる直接読み取りは読み取り専用です。 - UPDATE / DELETE は位置指定の削除ファイル(positional delete)を書く方式のみです。これは merge-on-read(変更を削除ファイルに記録し、読み取り時に合成する方式)にあたります。copy-on-write(変更のたびにデータファイルを書き直す方式)には対応していません。
- テーブルの
write.update.mode/write.delete.modeが merge-on-read 以外に設定されていると、UPDATE / DELETE は失敗します。 - GitHub リポジトリ(duckdb/duckdb-iceberg)では、拡張はまだ experimental とされています。
現時点では、重い ETL は Glue や EMR の Spark で書き込み、DuckDB は手元での探索や軽い集計、小規模な修正に使う、という分担が無難です。
DuckLake という別の選択肢
DuckDB チームは、Iceberg とは別に DuckLake というテーブルフォーマットも作っています。データを Parquet で持つ点は Iceberg と同じです。違いはメタデータの置き場所です。Iceberg はメタデータを S3 上のファイルとカタログに分けて持ちます。一方 DuckLake は、PostgreSQL などのSQL データベースにメタデータを丸ごと格納します。DuckLake v1.0 は 2026 年 4 月 13 日にリリースされました。
使い分けの目安は単純です。
- Iceberg:Spark、Trino、Athena、Snowflake など複数のエンジンで同じテーブルを共有したい場合。エコシステムの広さが最大の強みです。
- DuckLake:読み書きするのがほぼ DuckDB だけで、メタデータを RDB で管理するほうが運用しやすい場合。
Iceberg の価値が「エンジンを選べること」にある以上、DuckDB 中心の小さな構成なら DuckLake、組織横断のデータ基盤なら Iceberg、という切り分けになります。
まとめ
- Apache Iceberg は、S3 上のファイル群をテーブルとして扱うためのオープンテーブルフォーマットです。Parquet とはレイヤーが違い、組み合わせて使います。
- カタログ → メタデータファイル → マニフェストリスト → マニフェスト → データファイルという階層によって、ACID、タイムトラベル、スキーマ進化、hidden partitioning を実現しています。
- 最大の価値は、テーブル管理をベンダーから切り離し、用途ごとに計算エンジンを選べることです。
- DuckDB はその計算エンジンの 1 つで、
iceberg拡張により S3 Tables や Glue Data Catalog 上の Iceberg テーブルを読み書きできます。 - ただし DuckDB からの UPDATE / DELETE は merge-on-read のみで、拡張自体もまだ experimental です。
- DuckDB だけで完結する構成なら、DuckDB チームの DuckLake も選択肢に入ります。