AWS で分析基盤を作るとき、まず候補に挙がるのが Amazon Redshift です。一方で、S3 に Apache Iceberg 形式でデータを置き、Athena や Spark、DuckDB から読むレイクハウスという作り方も広まっています。
この記事は、次の 2 本に続くシリーズの 3 本目です。
- Apache Iceberg 入門:データレイクを「テーブル」にする仕組みと DuckDB との関係
- DuckLake 入門:メタデータを SQL データベースに置くレイクハウスフォーマットと Iceberg との違い
前の 2 本では Iceberg と DuckLake というテーブルフォーマット同士を比べました。今回は一段上がって、「データを Redshift の中に持つか、S3 にオープンな形式で持つか」というアーキテクチャの選び方を整理します。両者の位置づけの違い、Redshift Serverless・Athena・DuckDB の料金構造、Redshift から Iceberg に書き込む方法と制約、構成の選び方を順に見ていきます。
結論を先に書くと、共有するデータは S3 の Iceberg テーブルに置き、BI から何度も読まれる集計だけを Redshift に持つ組み合わせが現実的です。
Redshift と Iceberg は同じ土俵にない
最初に押さえておきたいのは、Redshift と Iceberg は直接比べるものではない、という点です。
- Iceberg / DuckLake:S3 上のファイルをテーブルとして管理する形式です。計算エンジンは持たず、Athena や Spark、DuckDB などが読み書きします。
- Redshift:計算エンジン・テーブル管理・ストレージが一体になった DWH(データウェアハウス)製品です。1 本目で紹介した「分散ストレージ/計算エンジン/テーブル化技術」の 3 層モデルで言えば、3 層すべてを 1 つの製品の中に持っています。
さらに、2025 年 11 月以降の Redshift は Iceberg テーブルを読むだけでなく書くこともできます。つまり、両者は「どちらか」ではなく組み合わせられる関係です。そのため比べるべきは、データの置き場所になります。
なお、DuckLake は 2 本目で見たとおり DuckDB を中心としたフォーマットです。Redshift や Athena と同じデータを共有するなら、この記事では Iceberg を前提に考えます。
データの置き場所で比べる
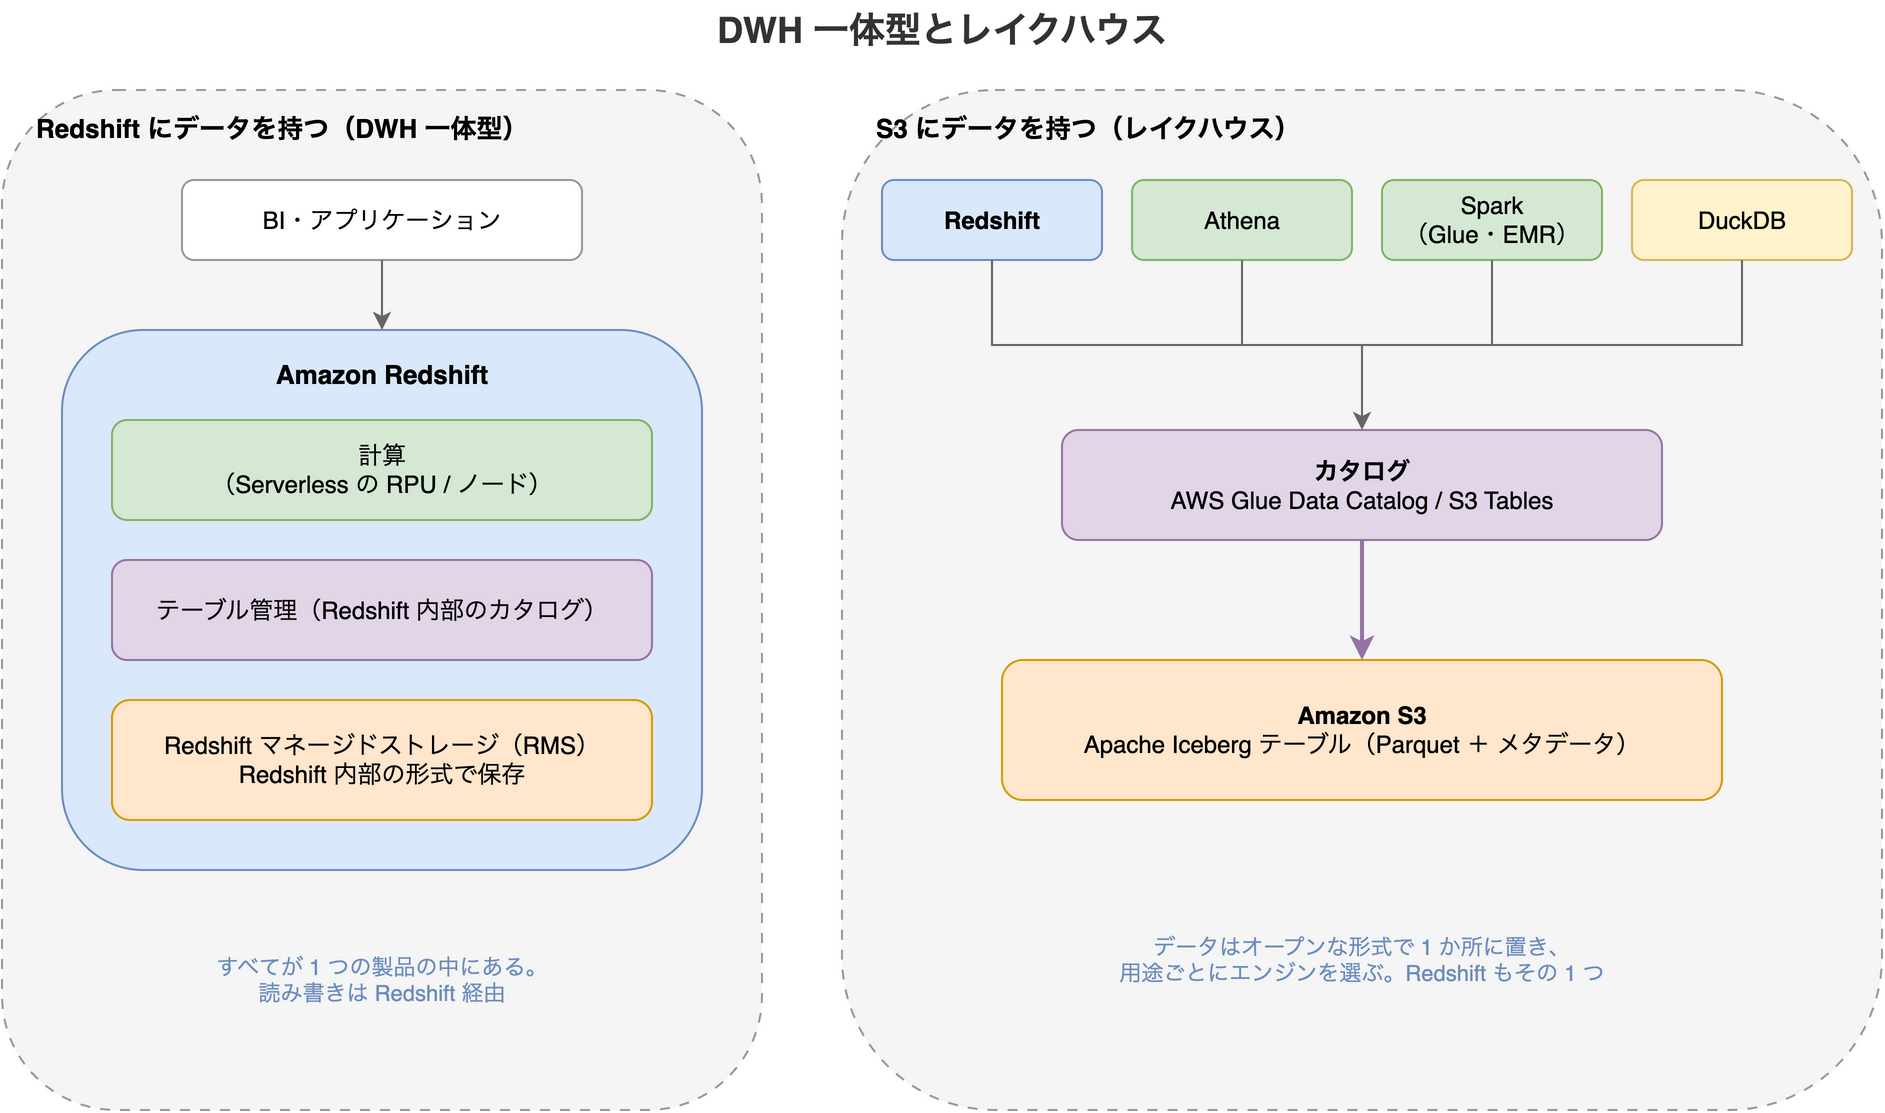
Redshift のテーブルデータは、Redshift マネージドストレージ(Redshift Managed Storage、以下 RMS)に保存されます。RMS は計算から切り離されたストレージ層で、計算リソースとは別に容量が伸縮し、料金も別に課金されます。
| 観点 | Redshift にデータを持つ(RMS) | S3 に Iceberg で持つ(レイクハウス) |
|---|---|---|
| データの形式 | Redshift 内部の形式 | Parquet + Iceberg のメタデータ(オープン) |
| 読み書きできるエンジン | 基本は Redshift のみ | Redshift、Athena、Spark、DuckDB など |
| テーブル管理 | Redshift 内部 | AWS Glue Data Catalog / S3 Tables |
| トランザクション | 通常の DWH として複数文のトランザクションが使える | エンジンごとの制約あり(Redshift は後述、DuckDB は 1 本目を参照) |
| ベンダーロックイン | 強い | 弱い(形式がオープン) |
Redshift Serverless と Athena・DuckDB の料金の違い
Redshift には、ノード数を決めて常時起動するプロビジョンド型と、使った分だけ課金される Redshift Serverless があります。ここでは Serverless を中心に見ます。料金ページの記載は次のとおりです(金額はバージニア北部リージョンの計算例)。
| 項目 | 内容 |
|---|---|
| 計算 | RPU(Redshift Processing Unit)× 時間で課金。計算例では 1 RPU 時間あたり $0.375 |
| 基本容量 | 4〜1024 RPU の範囲で設定 |
| 課金単位 | 秒単位(最低 60 秒) |
| アイドル時 | 課金なし |
| ストレージ(RMS) | 計算例では 1 GB・月あたり $0.024 |
| S3 上の外部データへのクエリ | 別課金ではなく、RPU 時間に含まれる |
計算例の単価で最小の 4 RPU を動かすと、1 時間あたり $1.50 です(料金ページにも「as low as $1.50 per hour」とあります)。アイドル時に課金されないので、日中だけ使うような負荷なら Serverless が合います。
レイクハウス側の代表である Athena は、料金ページの計算例ではスキャンしたデータ 1 TB あたり $5 です。DuckDB は自分の PC や Lambda で動かすので、エンジンの利用料はかからず、実行環境のコストだけになります。レイクハウス側のデータは S3 に置くので、ストレージは S3 の通常の料金です。
ここから言えるのは、料金の構造が違うということです。
- Redshift Serverless:起動している時間と RPU 数で決まります。基本容量で収まる範囲なら、クエリの本数が増えても料金は変わりません。ただし負荷が高まって RPU が自動で増えると、その分も同じ単価で課金されます。
- Athena:スキャン量で決まります。たまにしか投げないなら安いですが、大量のデータを何度も読むと膨らみます。
- DuckDB:エンジンの利用料はかからず、実行するマシンの能力が上限になります。
どれが安いかはクエリの頻度とデータ量で逆転するので、一概には言えません。実際の見積もりは、自分のリージョンの料金で試算してください。
なお、プロビジョンド型の場合は、混雑時に自動で処理能力を足す Concurrency Scaling の無料枠が、1 日最大 1 時間分たまります。
Redshift から Iceberg を読み書きする
Redshift の Iceberg 対応は、2025 年 11 月から 2026 年 8 月にかけて大きく広がりました。
| 時期 | 内容 |
|---|---|
| 2025 年 11 月 | Iceberg テーブルへの書き込みが GA(一般提供)に。CREATE TABLE、INSERT など |
| 2026 年 5 月 | Iceberg テーブルへの ALTER TABLE と、自動マウントされる awsdatacatalog 経由の書き込みに対応 |
| 2026 年 8 月 | Iceberg v3 テーブル(削除ベクター、行の系譜(row lineage)、列の既定値)に対応 |
v3 の削除ベクターは、2 本目で触れた DuckLake の削除ベクターと同じく、削除した行をビットマップで持つ仕組みです。
現行のドキュメントでは、CREATE TABLE、CREATE TABLE AS SELECT、INSERT、UPDATE、DELETE、MERGE が使えます。Iceberg テーブルは AWS Glue Data Catalog(以下 Glue Data Catalog)に登録されている必要があり、プロビジョンド型と Serverless のどちらからも書き込めます。
次の例の <...> は、自分の環境の値に置き換えてください。まず、Glue Data Catalog(自動マウントされた awsdatacatalog)上に Iceberg テーブルを作って書き込む場合です。
CREATE TABLE awsdatacatalog.<Glue データベース>.orders (
  order_id INT,
  status VARCHAR,
  region VARCHAR
)
USING ICEBERG
LOCATION 's3://<汎用バケット>/orders/';

INSERT INTO awsdatacatalog.<Glue データベース>.orders
VALUES (1, 'pending', 'us-east-1');
S3 Tables のテーブルバケットに作る場合は、"<バケット名>@s3tablescatalog" という 3 部構成の名前を使います。テーブルの場所は S3 Tables が決めるので、LOCATION は書きません。
CREATE TABLE "<テーブルバケット>@s3tablescatalog".<名前空間>.orders (
  order_id INT,
  status VARCHAR,
  region VARCHAR
)
USING ICEBERG;

INSERT INTO "<テーブルバケット>@s3tablescatalog".<名前空間>.orders
VALUES (1, 'pending', 'us-east-1');
ここで作ったテーブルは、Athena や Spark からも、DuckDB からも(1 本目の「カタログに ATTACH する」の手順で)同じように読めます。Redshift で集計した結果を Iceberg テーブルとして書き出し、ほかのチームは別のエンジンで使う、という分担ができるわけです。
Iceberg への書き込みの制約
一方で、Redshift の内部テーブル(RMS)と同じ感覚では使えません。トランザクションの仕様には、次の制約があります。
- Iceberg への書き込みは 1 文が 1 トランザクションです。
BEGIN〜COMMITの中に Iceberg への書き込みを入れると、同じブロックにほかの文は入れられません。 - 2 つのトランザクションが同じテーブルやパーティションを同時に変更すると、コミットが失敗します。Redshift は自動で再試行しないので、アプリケーション側で再実行が必要です。
- ストアドプロシージャの中からは、Iceberg に書き込めません。
- Redshift 以外で作った Iceberg テーブルに書く場合は、Iceberg のフォーマットバージョンが v2 か v3 で、データ形式が Parquet であることなどが条件です。
複数のテーブルをまとめて更新する ETL や、ストアドプロシージャで組んだ既存の処理は、RMS のテーブルに残すほうが無難です。
Redshift・Iceberg・DuckDB の使い分け
ここまでの 3 本をまとめると、選び方は次のようになります。
| 状況 | おすすめの構成 |
|---|---|
| 分析するのは 1 人〜少人数で、データが 1 台のマシンで扱える規模 | DuckDB + DuckLake(または S3 上の Iceberg を DuckDB で読む) |
| 複数のチームが別々のエンジンで同じデータを使う | S3 + Iceberg(Glue Data Catalog / S3 Tables)を中心にする |
| 多数のユーザーが BI ダッシュボードから同時にクエリする | Redshift(RMS)にデータを持つ |
| 複数チームでの共有と、BI からの同時アクセスの両方がある | 共有データは Iceberg、頻繁に読む集計は Redshift の RMS |
誰が、どう使うかで考える
この表を、使い方の違いとして言い直すと次のようになります。
- 専門の担当者が探索的に分析する:クエリの形が毎回違い、目的に合わせてエンジンを選びたい用途です。レイクハウスが向いています。頻度が低ければ、Athena のスキャン課金や手元の DuckDB のほうが安く済みます。
- 分析結果を業務に組み込み、多くの利用者に見せる:同じダッシュボードや定型の集計を、たくさんの人が同時に何度も読む用途です。応答の速さと同時実行性能が要るので、Redshift(RMS)が向いています。
ただし、「データを広く開示する」には 2 つの意味があり、どちらを指すかで向いている構成が逆になります。
| 「広く開示する」の意味 | 向いている構成 |
|---|---|
| 多くの人が、同じ定型の集計を BI から同時に見る | DWH 一体型(Redshift の RMS) |
| 多くのチームやシステムが、同じ元データを別々のツールで使う | レイクハウス(S3 + Iceberg) |
後者で大事なのは、データを特定の製品に閉じ込めないことです。そのため、利用者が多くてもレイクハウスのほうが有利になります。
実際の組織では、この 2 つの使い方が同時に起きることがほとんどです。そのため、使い分けの表の最後の行にある組み合わせになることが多いはずです。生データや履歴は S3 の Iceberg テーブルに置き、どのエンジンからも読めるようにしておきます。そのうえで、BI から何度も読まれる集計テーブルだけを Redshift の RMS に持ち、同時実行性能を確保します。
Redshift から Iceberg に書けるようになったので、「Redshift を使う=データを Redshift に閉じ込める」ではなくなりました。AWS 上で複数のエンジンやチームがデータを共有する前提なら、最初から Redshift に全部入れる必要はありません。まず Iceberg で持つことを基本にし、性能が必要な部分だけ Redshift に寄せます。この順番で考えると、あとで構成を変えやすくなります。
DuckDB だけで小さく始める場合は、2 本目で見たとおり、まず DuckLake で始めて、必要になったら Iceberg へ移す道もあります。
まとめ
- Redshift は計算・テーブル管理・ストレージが一体の DWH 製品で、Iceberg や DuckLake はテーブルの形式です。比べるべきは「データをどこに、どの形式で置くか」です。
- Redshift Serverless は RPU 時間で課金され、アイドル時は無料です。Athena はスキャン量、DuckDB は利用料なしと、料金の構造がそれぞれ違います。
- Redshift は Iceberg テーブルの読み書きに対応し、2026 年には ALTER TABLE や Iceberg v3 にも対応しました。ただし書き込みは 1 文 1 トランザクションで、競合時は自動で再試行されないなどの制約があります。
- 実務では、共有データを Iceberg に置き、同時実行性能が必要な集計だけ Redshift の RMS に持つ組み合わせが現実的です。
- シリーズ全体では、小規模で DuckDB 中心なら DuckLake、AWS のエンジンと共有するなら Iceberg、BI からの同時アクセスが多い集計は Redshift の RMS、という使い分けになります。