はじめに
2026 年 9 月 24 日に Findy 主催のウェブセミナーで、木下 雄一朗(Kinopee)氏が「ハーネス設計入門 〜 基礎知識の整理から実務へのステップアップ 〜」と題して登壇した。全 30 枚のスライドは 2 部構成になっている。
- 第1部:ハーネスエンジニアリングという言葉がどこから来て、どう定義が分かれ、どう収束したか
- 第2部:エージェントが自分で失敗に気づき、自分で直して完走するための設計方法
本記事ではこの資料をもとに、特に実務で使える第2部の「馬具・柵・境界」という3層モデルを中心に整理する。
ハーネスエンジニアリングとは
資料の定義は次の一文に集約されている。
エージェントが同じ失敗を繰り返さないよう、モデルの外側(環境)を設計すること
式で書けば AGENT = MODEL + HARNESS で、指示ファイル・ツール・検証・ガードレール・ループなど、モデル以外のすべてがハーネスにあたる。呼び名はプロンプトエンジニアリング(2022 年〜)、コンテキストエンジニアリング(2024 年〜)を経て、ハーネスエンジニアリング(2026 年〜)へと移ってきた。
資料が挙げる起点は 2026 年 2 月の2つの出来事だ。
- 2026 年 2 月 5 日:Mitchell Hashimoto 氏が命名。「失敗したら、二度と起きないよう環境を直す」
- 2026 年 2 月 11 日:OpenAI が実践例を公開。資料では「3人で100万行、95%をAIが生成」と紹介されている
職場に例えると:新人を受け入れる環境の一式
「モデル以外のすべて」と言われてもつかみにくいので、新人を受け入れる職場に置き換えてみる(資料にはない、筆者による例えである)。
ハーネスを「社員向けのハンドブック」に例えたくなるが、それで表せるのは一部だけだ。ハンドブックを読んだ新人でもミスはする。だから会社はハンドブックとは別に、検品や承認フロー、入館証や権限の設計を用意している。ハーネスも同じで、本体はむしろハンドブック以外の部分にある。
職場の仕組みは、本記事の後半で扱う資料の3層(馬具・柵・境界)とループに次のように対応する。
| 職場の仕組み | ハーネスの層 | 役割 |
|---|---|---|
| ハンドブック・業務手順書・部署の役割分担 | 馬具(AGENTS.md・Skills・サブエージェント) | 方向を示す。読んで守ってくれることを期待する |
| 検品・入力チェック・承認フロー | 柵(lint・型・テスト・Hooks) | 読んだかどうかに関係なく、間違いを機械的に弾く |
| 入館証・アクセス権限・金庫の鍵を渡さない | 境界(サンドボックス・最小権限) | 守るかどうか以前に、そもそも手が届かない |
| 「この検査に全部通ったら完了」という合格基準 | ループ(check がすべて通る) | 自分で確かめ、自分で直して仕上げられる |
ただし、AI の新人には人間と違う点が2つある。
- 毎日、記憶を失って出社する:人間は一度読めば覚えるが、エージェントはセッションごとに忘れる。ハンドブックは毎回読ませることになり、そのたびにコンテキストを消費する。厚いハンドブックほど良いわけではない
- 叱っても直らない:人間なら教育や注意で直すが、エージェントには効かない。だから「同じ失敗が二度と起きないよう、検品や権限の側を直す」というのがハーネスの考え方になる
ハンドブックばかり厚くするのは、資料が戒める失敗パターンだ。入館証と権限を決め(境界)、最低限のハンドブックを渡し(馬具)、検品の仕組みを据える(柵)。記事の最後で紹介する6つの手順も、この順番に沿っている。
5つの流派と、その収束
その後、各社・論者が追随したが、定義は論者ごとに違った。資料ではこれを5つの流派に整理している。
| 流派 | 代表者 | 中核の主張 |
|---|---|---|
| Chase 派(広義・分類論) | Harrison Chase(LangChain) | モデル以外のすべてがハーネス |
| Hashimoto 派(運用哲学) | Mitchell Hashimoto | 失敗したら環境を再設計せよ |
| Fowler 派(制御理論) | Birgitta Böckeler(Thoughtworks) | コンテキスト設計の特殊形として定義 |
| Chawla 派(同心円モデル) | Avi Chawla | LLM の OS 層、三重の入れ子 |
| Codex 派(スケール駆動) | Ryan Lopopolo(OpenAI Codex) | スケールで壊れる問題への答え |
対立の焦点は「どちらが外側か」だった。Chase 派・Chawla 派は「ハーネス ⊃ コンテキスト」、Fowler 派は「コンテキスト ⊃ ハーネス」と、包含関係が逆になる。Fowler 派はハーネスを guides(フィードフォワード)と sensors(フィードバック)という制御理論の言葉で捉える。
どこに収束したのか
資料によれば、5つの流派の言葉づかいは 2026 年 3〜7 月の約5か月でほぼ一つにまとまった。資料が挙げる節目は次のとおりだ。
| 時期 | 出来事 |
|---|---|
| 2026 年 3 月 10 日 | LangChain が「The Anatomy of an Agent Harness」でハーネスの構成要素を整理 |
| 2026 年 4 月 19 日 | Addy Osmani 氏「ハーネスは、モデル同士より互いに似てきている」 |
| 2026 年 6 月 | Build 2026 で Microsoft Agent Framework の Agent Harness が安定版に。Pydantic AI v2.0 がハーネス中心に再設計 |
| 2026 年 8 月 6 日 | Agent Plugins 1.0 で、Skills と MCP サーバーを1つのフォルダ形式(plugin.json+skills/+mcp.json)にまとめられるようになる |
資料は「どの流派が勝った」とは書いていない。ただ、収束した先は次の2点に整理できる(ここからは筆者の読み)。
- 定義は「モデル以外のすべてがハーネス」にそろった:
AGENT = MODEL + HARNESSという Chase 派の広い定義が共通の土台になった。資料自身も、第2部をこの「モデル以外のすべて」という定義から始めている。どちらが外側かという論争は、外枠を広く取り、その中を役割で分ける形に落ち着きつつある。実際、第2部の馬具(走る前に伝える)と柵(走った後に検証する)の区別は、Fowler 派の guides(フィードフォワード)と sensors(フィードバック)に重ねて読める - 中身は部品として標準化され始めた:AGENTS.md・Skills・MCP といった部品が、特定のツールに縛られない共通の形式になりつつある。Agent Plugins 1.0 はその代表例だ(詳しくは次項)。部品を中立の場で預かる動きもあり、Linux Foundation が 2025 年 12 月に設立した Agentic AI Foundation は、MCP・AGENTS.md・goose を創設時のプロジェクトとして引き受けている(資料では 2026 年の出来事として載っているが、設立の発表は 2025 年 12 月だった)
つまり「ハーネスとは何か」という言葉の争いはほぼ収まり、関心は「ハーネスをどう組むか」に移った。資料の第2部が設計の実践に充てられているのも、この流れの上にある。
形式の標準化:Agent Plugins 1.0 で決まったこと・決まっていないこと
標準化のいちばん具体的な成果が、2026 年 8 月 6 日の Agent Plugins 1.0 だ。資料の記述をもとに、決まったことと、まだ決まっていないことを分けて整理する。
決まったこと
-
配布の単位:Skills と MCP サーバーを1つのフォルダにまとめ、「プラグイン」として配る
-
フォルダの構成:次の3つを置く
ファイル/フォルダ 置くもの plugin.jsonプラグインの定義(マニフェスト) skills/Skills(手順書)一式 mcp.json使う MCP サーバーの設定 -
策定の体制:Vercel が発案し、Amazon(AWS)・Cursor・GitHub・Microsoft・OpenAI の代表とともに仕様を詰めた。Google も後から運営の中心メンバー(Core Maintainer)として加わっている
-
対応クライアント:発表時点で ChatGPT・Codex・Cursor・GitHub Copilot・Kiro・VS Code に実装が出ている。その後も増えており、最新の一覧は公式の対応クライアント表で確認できる
-
得られること:一度作ったプラグインを、複数のクライアントで使い回せる
まだ決まっていないこと
- Claude Code は未対応:資料によれば独自のプラグイン形式のままで、公式の対応クライアント表にも載っていない
- 部分対応のクライアントがある:Skills と MCP の片方にしか対応していないクライアントもあり、使う前に対応表を確かめる必要がある
- hooks・コマンド・rules は対象外:これらは標準に含まれず、クライアントごとに書き方が違う。仕様が対象外と明記しているのは commands・hooks・agents で、rules は資料の指摘による
本記事の3層に当てはめると、馬具のうち Skills と、MCP で渡すツールは、対応クライアントの間なら持ち運べるようになった。一方、柵にあたる hooks や、ルール類はまだツールごとに用意し直す必要がある。言葉はまとまり、形式の標準化も始まったが、互換性はまだ一部にとどまる、というのが資料の見立てだ。
ハーネスで結果が変わるという実証
資料は、モデルを変えずハーネスだけで結果が変わった例を3つ挙げている。
- LangChain:ハーネスの変更だけで Terminal Bench 2.0 の順位が 30 位からトップ 5 に上がった
- Anthropic「2026 Agentic Coding Trends Report」:ハーネスの設定だけでスコアが ±5pt 以上動く
- 2026 年 4 月の Claude Code の品質低下:原因が特定された3件は、いずれもハーネス側の変更だった
モデルが同じでも、外側の作り方で成績も品質も変わる。だから設計する価値がある、というのが第2部への導入になっている。
前提:生成 AI は確率で動く
第2部の出発点は、生成 AI が確率的に動くという当たり前の事実だ。1トークンごとに確率で次の語を選ぶため、同じ指示でも出力は毎回同じとは限らない。小さな揺らぎが数千トークン積み重なると、あるときは動くコードに、あるときは別解に、ごくまれに危険な一手にたどり着く。
従来のプログラムは「同じ入力 → 同じ出力」の決定的な世界だった。生成 AI は「同じ入力 → 分布からのサンプル」だ。したがって指示だけに頼らず、環境と検証で受け止める必要がある。
ハーネスとガードレール:役割の違う2つの仕組み
資料は第1部の広義のハーネス(モデル以外のすべて)を、性質の違う2つに分けて考える。
| ハーネス(馬具) | ガードレール(柵) | |
|---|---|---|
| タイミング | 走り出す前 | 走った後 |
| 役割 | 「どう走ってほしいか」を伝える | 「逸脱していないか」を検証する |
| 性質 | 主観。自然言語の意図で、確率的に効く | 客観。誰が実行しても同じ結果になる |
| 例 | AGENTS.md・Skills・サブエージェント | lint・型チェック・ビルド・テスト・Hooks |
ハーネスは書いた分だけ効くが、モデルが確率で動く以上、効き目は絶対ではない。書きすぎればコンテキストを圧迫する。一方のガードレールは機械的に Yes / No を返すので、何度実行しても同じ判定になる。資料はこれを「機械的な判定が強いほど、エージェントにハンドルを預けられる」とまとめている。
平たく言い換えると、ガードレールは次のような仕組みだ(筆者による言い換え)。
AI の意思に関係なく、決定論的な処理(スクリプトやツール)が自動で走り、逸脱を検知して止める、または差し戻す仕組み
この一文には、押さえておきたい点が4つ含まれている。
- 守らせるより、見つけて差し戻す:失敗の出力はエージェントへの入力になり、エージェントはそれを読んで自分で直す。止めるだけでなく、後述するフィードバックループの材料になる
- 事後の検証だけでなく、事前のブロックもある:書いたコードを検証する柵のほかに、危険なコマンドを実行前に止める柵がある(後述の「成果物への柵と、行動への柵」)
- 自動で走ることが大事:スクリプトを用意しても、エージェントが実行しなければ意味がない。だから Hooks・Git hooks・CI という「レール」で、エージェントの意思に関係なく走らせる(後述)
- 決定論的でも、正しいとは限らない:判定が毎回同じでも、テストが弱ければ間違ったコードを毎回合格させてしまう。柵の強さは検査の中身で決まる。また、LLM にコードをレビューさせる仕組みは便利だが、判定が確率的なので、資料の定義(機械的に判定する層)には当てはまらない
フィードバックループ:検証器とゴールを渡す
第2部のゴールは「エージェントが自分で失敗に気づき、自分で直して完走する」ことだ。そのために人が用意するものは2つしかない。
- 検証器=門:lint・型・テストなどを束ねた
checkの1コマンド - ゴール:
checkがすべて通ること
エージェントは「実装する → check を自分で実行して結果を読む → 失敗の出力をもとに直す」を自分で繰り返す。実行コマンドと共通の条件は AGENTS.md に書き、タスク固有の条件はプロンプトで渡す。タスク固有の条件もテストにして check に入れてしまえば、「check がすべて通る」だけで完了を判定できる。
たとえば Node.js のプロジェクトなら、門は package.json のスクリプト1つにまとめられる。
{
  "scripts": {
    "format:check": "prettier --check .",
    "lint": "eslint .",
    "typecheck": "tsc --noEmit",
    "build": "vite build",
    "test": "vitest run",
    "check": "npm run format:check && npm run lint && npm run typecheck && npm run build && npm run test"
  }
}エージェントにも人にも「npm run check が通ったら完了」と伝えれば、両者が同じ門をくぐることになる。
ハーネスの道具箱:ルール・Skills・サブエージェント
「事前に伝える」道具は3つあり、効く範囲と深さが違う。
| 道具 | 適用 | 向いている内容 |
|---|---|---|
| ルール(AGENTS.md) | 常時 | 規約・コマンド・禁止事項 |
| Skills | 必要なとき | 定型作業の手順 |
| サブエージェント | 役割単位 | 並列化と文脈の分離 |
資料の結論は「第一歩はルール」だ。常時効く土台を固め、Skills とサブエージェントはその上に積む。
AGENTS.md に何を書き、何を書かないか
ルールは毎セッションのコンテキストに読み込まれるので、1行ごとに「家賃」がかかる。資料が示す書き分けは次のとおりだ。
| 書くこと | 書かないこと |
|---|---|
| プロジェクト概要(1段落) | 一般常識・言語の一般的な作法(モデルはすでに知っている) |
| ビルド・テスト・lint のコマンド | コードを読めばわかること(二重管理になり、すぐ食い違う) |
| プロジェクト固有の規約・構成 | 長大な設計書の貼り付け(Skills や参照リンクへ) |
| してはいけないこと(触れてはいけないファイル、変更禁止の API) | 検証できない精神論(「きれいに書く」は機械判定できる形にする) |
目安は「最初は最小限に。全行が実際の失敗や規約に対応していること」。足りない分は、逸脱が出たら1行足して育てる。
なお資料の補足によれば、Claude Code は CLAUDE.md があればそちらを優先し、なければ AGENTS.md を読む(v2.1.277 以降)。ただし利用環境によっては対応したバージョンが異なるとの報道もあるので、手元のバージョンの changelog で確認しておきたい。
Skills:必要なときだけ読む手順書
ルールに全部書くとコンテキストが溢れる。定型作業は Skill に切り出し、必要な場面でだけ読ませる。資料では次のような SKILL.md の基本形が紹介されている。
# エンドポイント追加

## 使いどころ
REST API に新しいルートを足すとき

## 手順
1. routes/ にルート定義を追加
2. handlers/ に処理を実装
3. バリデーションを schemas/ に定義
4. テストを __tests__/ に追加
5. docs/api.md を更新

## 模範例
routes/health.ts を参照
判断基準は単純で、毎回必要ならルール、特定の作業でだけ必要なら Skill にする。迷ったら Skill に逃がす。
サブエージェント:2つの呼び出し方
サブエージェントは、親の文脈を汚さずに役割を分けて委任する仕組みだ。
- オンデマンド生成:親が必要になった瞬間に子を起こして仕事を振る、使い捨ての委任。大量の調査や比較の並列化、結果の要約だけ持ち帰りたいときに向く(例:「3つのライブラリを別々のサブエージェントで並列に調査して要点だけ報告して」)
- 事前定義して呼び出す:役割・観点・出力形式をファイルに定義して名前で呼ぶ、育てて共有する委任。レビューやセキュリティ監査のように、毎回同じ観点で行う作業に向く。定義ファイルは、サブエージェント用の AGENTS.md にあたる
並列に走らせれば待ち時間は大きく減るが、同時に走る数だけ時間あたりのトークン消費は増える。数と深さは費用対効果で決める。
ガードレールの階層と、それを走らせるレール
ガードレールはどれも機械的に Yes / No を判定するが、検証する対象の深さが違う。
| 段階 | 検証内容 | 例 |
|---|---|---|
| フォーマッタ | 表記の統一 | Prettier / gofmt |
| リンター | 作法の検査 | ESLint / Clippy |
| 型チェック | 整合性の検証 | tsc / mypy |
| ビルド | 成果物として成立するか | — |
| テスト | 仕様どおり振る舞うか | ユニット / 結合 / E2E |
下に行くほど判定が強く、検証が深い。この5つを check の1コマンドに束ね、人も AI も同じ門をくぐる。
土台:エージェントの仕事が流れる場所
レールの話に入る前に、エージェントの仕事が成果物になるまでに通る場所を確認しておく。どれも、エージェントがいなくても開発に欠かせない土台だ。「モデル以外のすべて」という広い定義ではハーネスに含まれるが、エージェントのために新しく作るものではない。ハーネスは、この土台に据え付けて使う(ここは筆者による整理である)。
| 場所 | 役割 | エージェントにとっての意味 |
|---|---|---|
| クライアント(Claude Code・Cursor など) | エージェントが動く場所。モデルの出力を受けて、ファイルの編集やコマンドの実行を実際に行う | モデルの外で実際に手を動かす実行環境の中心。許可設定や Hooks はここに据え付ける |
| リポジトリ(Git) | 成果物と変更履歴の置き場 | 間違えても巻き戻せる。後述する「可逆な逸脱は柵で拾ってループに戻す」が成り立つのは、変更が履歴に残り、戻せるからだ |
| リモート(GitHub など) | チームの正本。PR・レビュー・マージの場 | エージェントの変更がチームの仕事に混ざる前の最後の関門。CI・ブランチ保護・人のレビューがここに集まる |
エージェントの仕事は、クライアントで編集し、リポジトリにコミットし、リモートに push して PR を出す、という順に外へ流れていく。外に出るほど、他人の仕事への影響が大きくなる。
柵を走らせる3本のレール
柵は判定する道具であり、それを自動で走らせる仕組みを資料は「レール」と呼ぶ。レールは、上の3つの場所に1本ずつ据え付けられ、外側ほど強制力が強い。
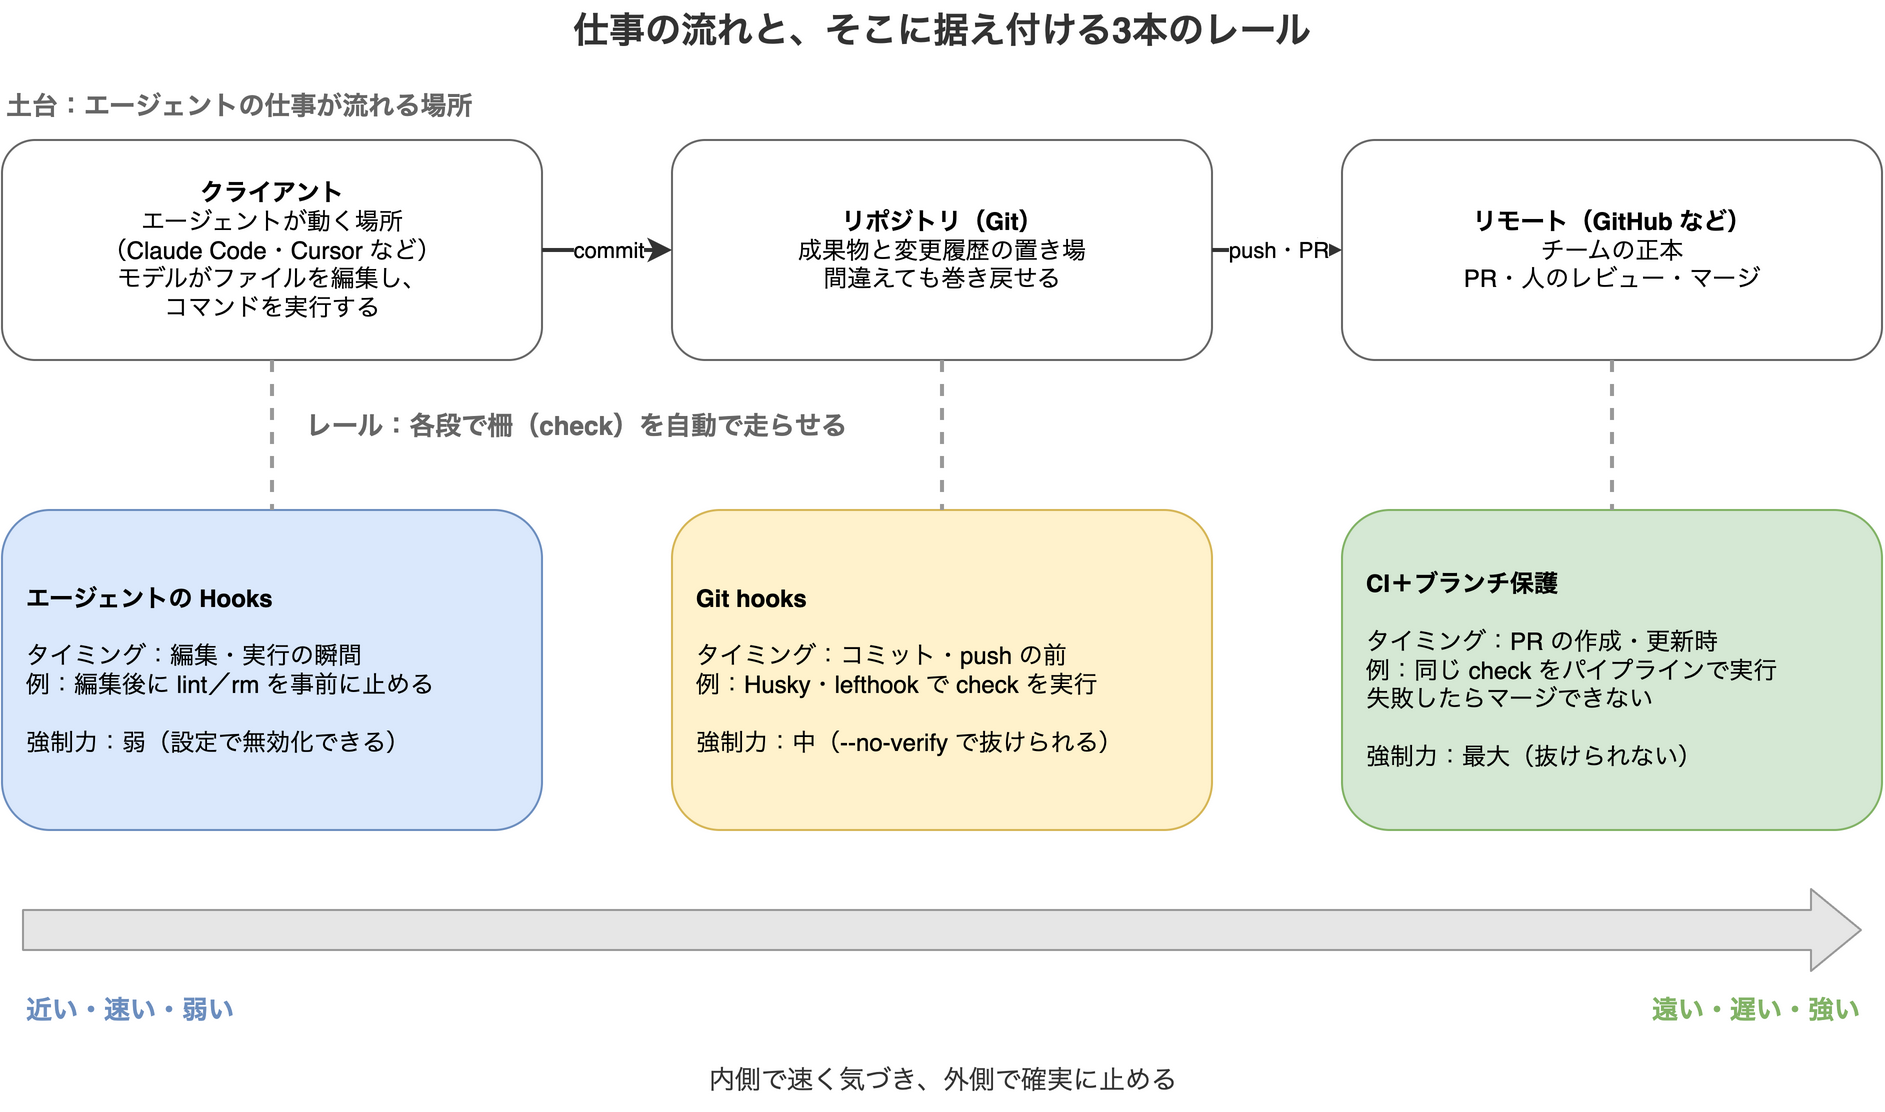
- エージェントの Hooks(クライアント内):編集・実行の瞬間に走る。最速だが、クライアントの設定で無効にできる
- Git hooks(リポジトリ):Husky や lefthook で、コミットや push の前に
checkを実行する。--no-verifyで抜けられるので強制力は中程度 - CI(リモート):PR の作成・更新時に同じ
checkを実行する。ブランチ保護と組み合わせれば失敗時はマージできず、抜け道がない
内側で速く気づき、外側で確実に止める。レールも、広義のハーネス(モデルの外側の環境)の一部だ。
柵は2種類ある:成果物への柵と、行動への柵
ここまでの柵は、すべて「書いたもの」を事後に検証する柵だった。もう1種類、「これからやること」を事前に止める柵がある。
| 成果物への柵 | 行動への柵 | |
|---|---|---|
| 問い | 正しく作れたか | 実行してよいか |
| 対象 | コード | 行為 |
| 道具 | lint・型・ビルド・テスト | Hooks・許可リスト |
| 失敗の扱い | ループの入力になる | 起きる前に止めるしかない |
行動への柵の例は、シェル実行の直前に走る Hooks で rm や外部への送信を止めるような使い方だ。どちらの柵も、人の注意力に頼らず機械的に止めるという原理は共通している。テストが落ちたコードをマージできないのも、危険なコマンドを実行できないのも、同じ仕組みだ。
柵の外側にある「境界」
資料がもっとも強調する新しい層が、境界である。柵は漏れることがあり、漏れたときに取り返しのつかない事故もある。そこで、判定するのではなく到達そのものを無くす層を一番外側に置く。
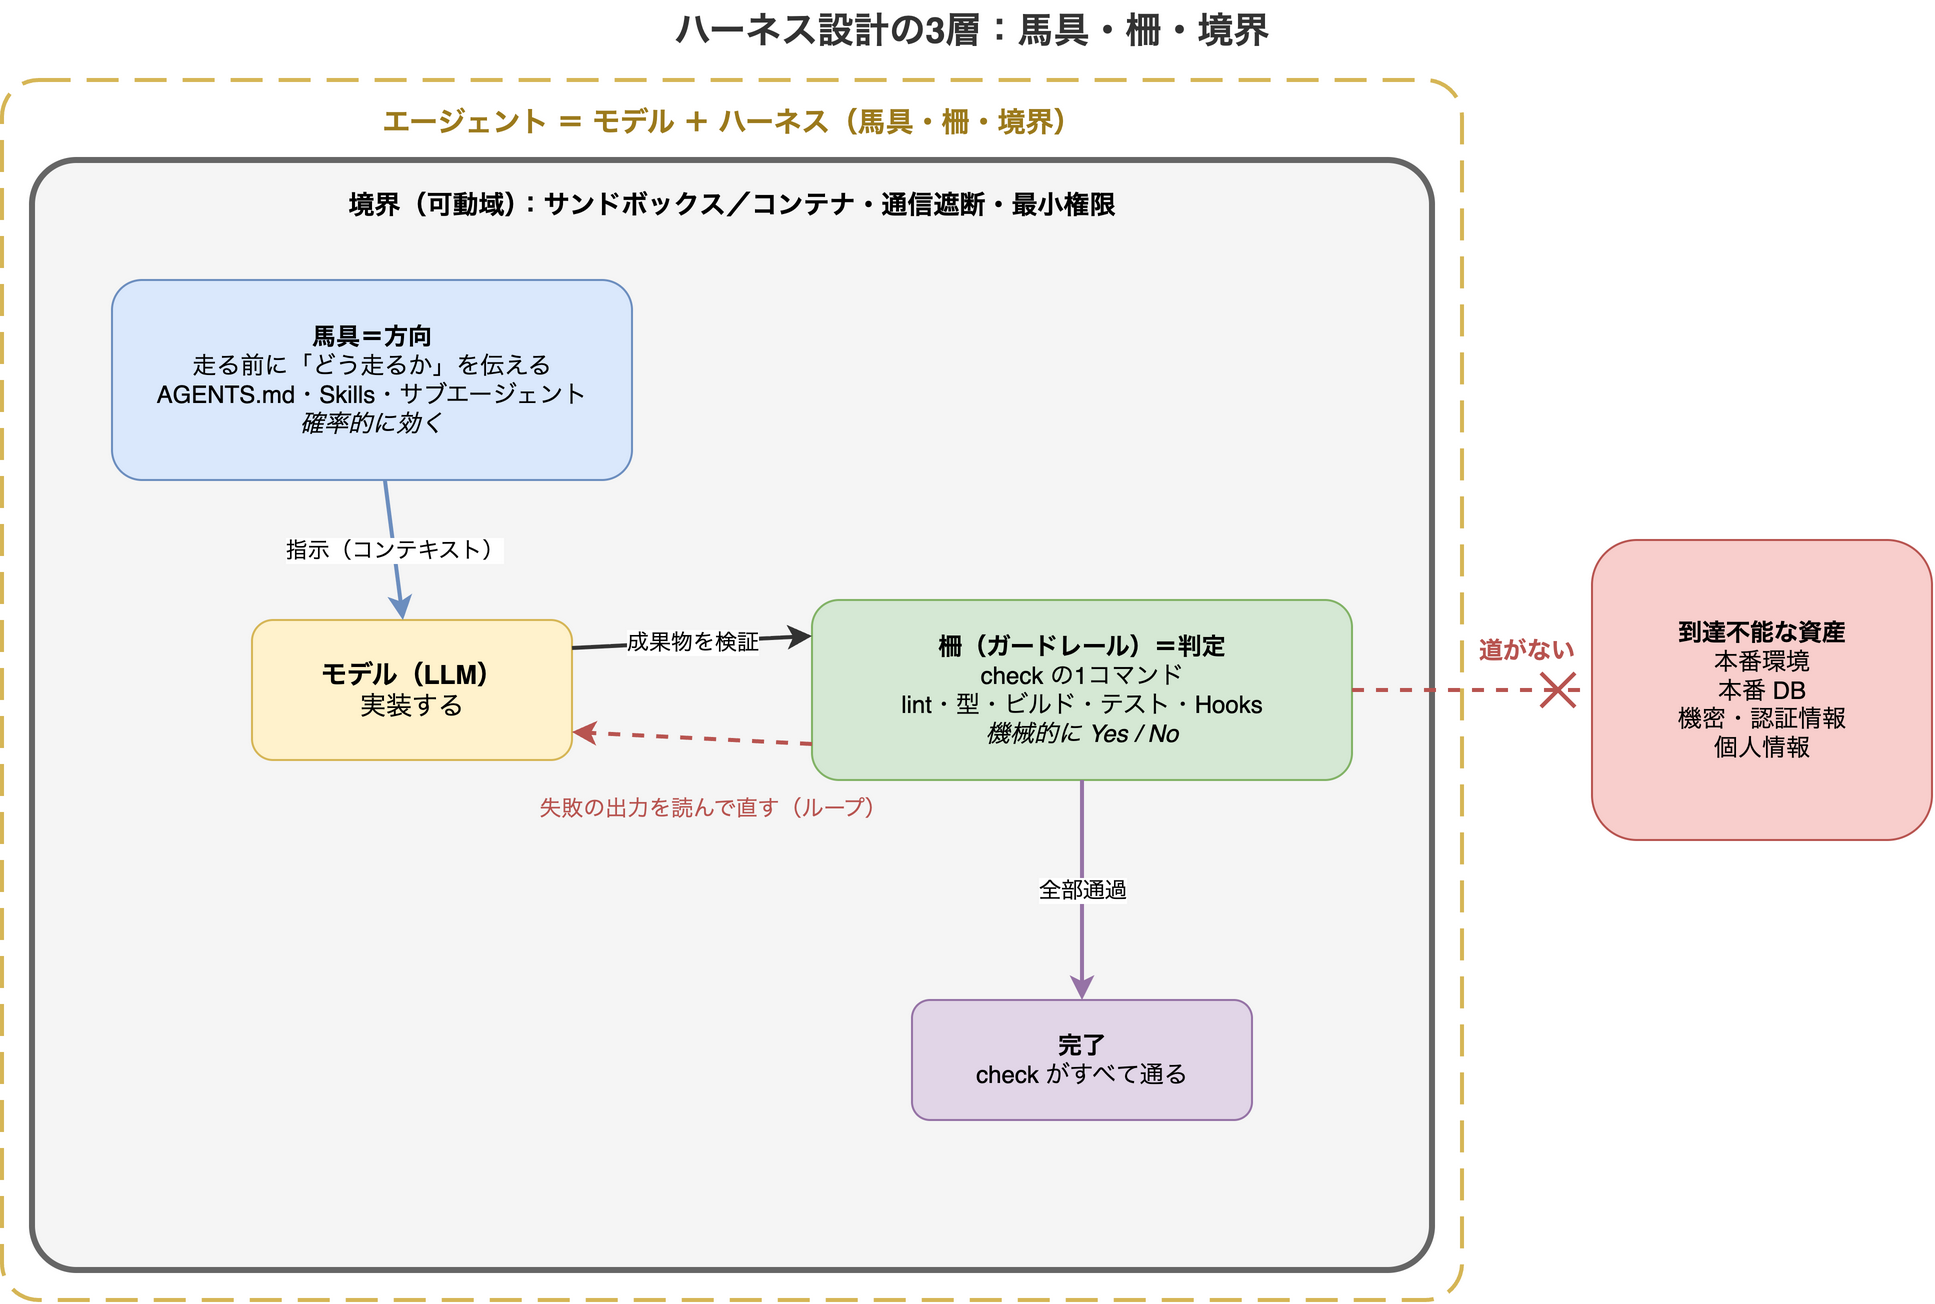
図の外枠が示すとおり、馬具・柵・境界はどれもエージェントの外にある道具ではなく、エージェントそのものの一部だ(AGENT = MODEL + HARNESS)。指示を受けて実装し、柵の結果を読んで直すのはモデルで、そのモデルを3層のハーネスが包む。本文で「エージェントが自分で直す」と書くときも、この組全体の振る舞いを指している。
| 層 | 役割 | 性質 | 道具 |
|---|---|---|---|
| 馬具 | 方向を与える | 確率的(指示する) | AGENTS.md・Skills |
| 柵 | 道から外れていないかを判定する | 機械的 | lint・型・テスト・Hooks |
| 境界 | 可動域を決める | 構造的(到達自体を無くす) | コンテナ/サンドボックス・通信遮断・最小権限 |
使い分けの原則は明快だ。可逆な逸脱は柵で拾ってループに戻す。不可逆な逸脱は境界で、試行そのものを無くす。本番環境・本番 DB・機密情報・個人情報は境界の外に置き、そこへ通じる道を最初から作らない。
「ハーネスエンジニアリングとは」の節で使った「新人を受け入れる職場」の例えに置き換えれば、ハンドブックが馬具、検品が柵、入館証と権限が境界にあたる。
構成の式と、実行時の式
AGENT = MODEL + HARNESS は、エージェントを「何を作り、何を管理するか」という構成の面から見た式だ。同じエージェントを、動いているときの姿から見ると、次のように書ける(資料にはない、筆者による整理である)。
構成:    agent = model + harness
実行時: agent = model + context + runtime| 視点 | 数えているもの |
|---|---|
| 構成(作るもの・管理するもの) | リポジトリや設定として持つ部品。AGENTS.md・Skills・テスト・Hooks の設定・CI の定義・サンドボックスの設定 |
| 実行時(動いているときの姿) | モデルが読んでいるコンテキストと、モデルの外で動いている実行環境 |
ソースコードと、それが動いているプロセスの関係に近い。ハーネスの部品を context と runtime に分けて作る必要はなく、部品は実行するときに振り分けられる。
- AGENTS.md・Skills:実行時には context に読み込まれる
- テスト:実行時には runtime で実行され、その失敗ログが context に入る
- CI・Hooks:runtime で動き、落ちればマージや実行を止める。止められたという結果は context に戻ることもある
- サンドボックス・権限:runtime として効くだけで、context には現れない
なお、実行時の context にはハーネス由来でないものも入る。ユーザーが渡したタスクの指示や、会話・ツール実行の履歴だ。2つの式の右辺は1対1には対応しない。
実行時の式で見ると、3層の強さの差も説明できる。馬具はほぼ context だけで効くので、モデルが読んで従うかどうかに左右される(確率的)。柵は runtime で確実に判定し、その結果を context に戻すことでループを閉じる(機械的)。境界は runtime だけで効き、モデルが知る必要すらない(構造的)。context への依存が減り、runtime に寄るほど、仕組みは強くなる。
ハーネスとセキュリティ
自律性を上げるほど、エージェント自体が攻撃の入口になる。資料が挙げるリスクと対策は4つだ。
| リスク | 対策 |
|---|---|
| 間接プロンプトインジェクション(外部コンテンツに紛れた指示に従ってしまう) | 不審なコンテンツと機密・外部送信を同時に扱わせない |
| 機密・個人情報の漏洩 | 認証情報や顧客データを読ませない |
| 破壊的操作 | rm や force push を実行できなくする |
| サプライチェーン | 提案された依存パッケージは人が確認する |
危険が最大化するのは、機密データへのアクセス・不審なコンテンツの読み取り・外部への送信の3つが同時に揃ったときだ。Simon Willison 氏はこれを「The lethal trifecta for AI agents」と名付けた。この3条件が同時に揃わないように設計する。
守りも仕組みで作り、行動への柵・隔離(サンドボックス)・信頼境界(審査済みの Skill や Plugin だけを使う)を組み合わせる。
クレデンシャルの扱い
資料が述べているのは「本番の認証情報は渡さない」「認証情報を読ませない」までだ。しかし実務では、データベースや社内 API のように、業務上どうしても認証が要るデータソースをエージェントに使わせたい場面がある。ここでは、その扱い方を原則と3層への当てはめで整理する(資料にはない、筆者による補足である)。
原則は一つで、前述の実行時の式を使えば次のように言える。
クレデンシャルは runtime に置き、context には入れない
モデルには秘密の値そのものを見せない。モデルは「このデータを取ってきて」と頼むだけにして、認証はモデルの外にあるツール・MCP サーバー・プロキシが行う。context に入った値は、モデルの出力やログに紛れ込んだり、プロンプトインジェクションで外へ持ち出されたりしうるからだ。
この原則を3層に当てはめると、次のようになる。
| 層 | やること |
|---|---|
| 境界(いちばん効く) | 本番ではなく、開発用やマスク済みのデータソースを使う。認証情報は読み取り専用にし、対象を必要なものだけに絞る(最小権限)。長期の固定キーを置かず、期限の短いトークンを実行のたびに発行する。クレデンシャルを持つエージェントの通信先は、許可した宛先だけに絞る。秘密情報を置いたファイルは、サンドボックスのファイルシステム隔離でそもそも見えなくする |
| 柵 | 秘密情報を置いたファイル(.env や鍵ファイルなど)の読み取りを、許可設定や Hooks で拒否する。ただしシェルコマンド経由など別の経路で読める場合があるので、境界の隔離と組み合わせる。コミット前と CI でシークレットスキャンを走らせ、秘密情報がリポジトリに入るのを止める |
| 馬具(いちばん弱い) | AGENTS.md に「秘密情報を出力しない・ファイルに書かない」と書く。書くこと自体は無駄ではないが、確率的にしか効かないので、これだけに頼らない |
通信先を絞る項目は、前述の lethal trifecta への対策でもある。クレデンシャルで機密データにアクセスできるエージェントについて、外部への送信という3つ目の条件を、許可した宛先だけに絞って弱める。ただし許可した宛先そのものがデータの持ち出し先に使われうるので、これだけで3つの条件の組み合わせが無くなるわけではない。宛先を最小限にしたうえで、機密データへのアクセスや不審なコンテンツの読み取りの側も減らす。
加えて運用として、アクセスの監査ログを残し、漏れたときにすぐ失効・ローテーションできるようにしておく。漏れないことを前提にせず、漏れても被害を小さく、短くする設計にしておくのが、境界の考え方とも一致する。
ここでいう監査ログは、データソース側(データベース・社内 API・クラウドの監査ログ)に残る「どのクレデンシャルで、何にアクセスしたか」の記録だ。エージェント側にも監査の仕組みはある。Claude の場合、Enterprise プランなどでは Compliance API で組織の操作履歴(管理・設定の変更やファイル操作など)を取得できる。Claude Code は OpenTelemetry で、ツールの実行や許可の判断をイベントとして監視基盤に送れる。ただし、これらが記録するのは Claude 側で起きたことだ。漏れたクレデンシャルが Claude を通さずに使われれば、痕跡はデータソース側にしか残らない。失効やローテーションも、クレデンシャルを発行した側で行う操作だ。データソース側のログでクレデンシャルの使われ方を見て、Claude 側のログで、どのエージェントの作業がそのアクセスを引き起こしたかを突き合わせる。両方をそろえて初めて追跡できる。
実装例:クレデンシャルを中継サーバーに閉じ込める
「runtime に置き、context に入れない」を具体的に組む方法の一つが、外部 API を呼ぶための中継サーバーを置く構成だ。エージェントに値を見せず、仲介役が認証情報を付けて呼び出す点で、AI エージェントの文脈で「クレデンシャルブローカー」と呼ばれるパターンの一種だ。ここでは仲介役が、許可した操作だけを代理実行する形をとる。AWS で組む場合を例に示す。
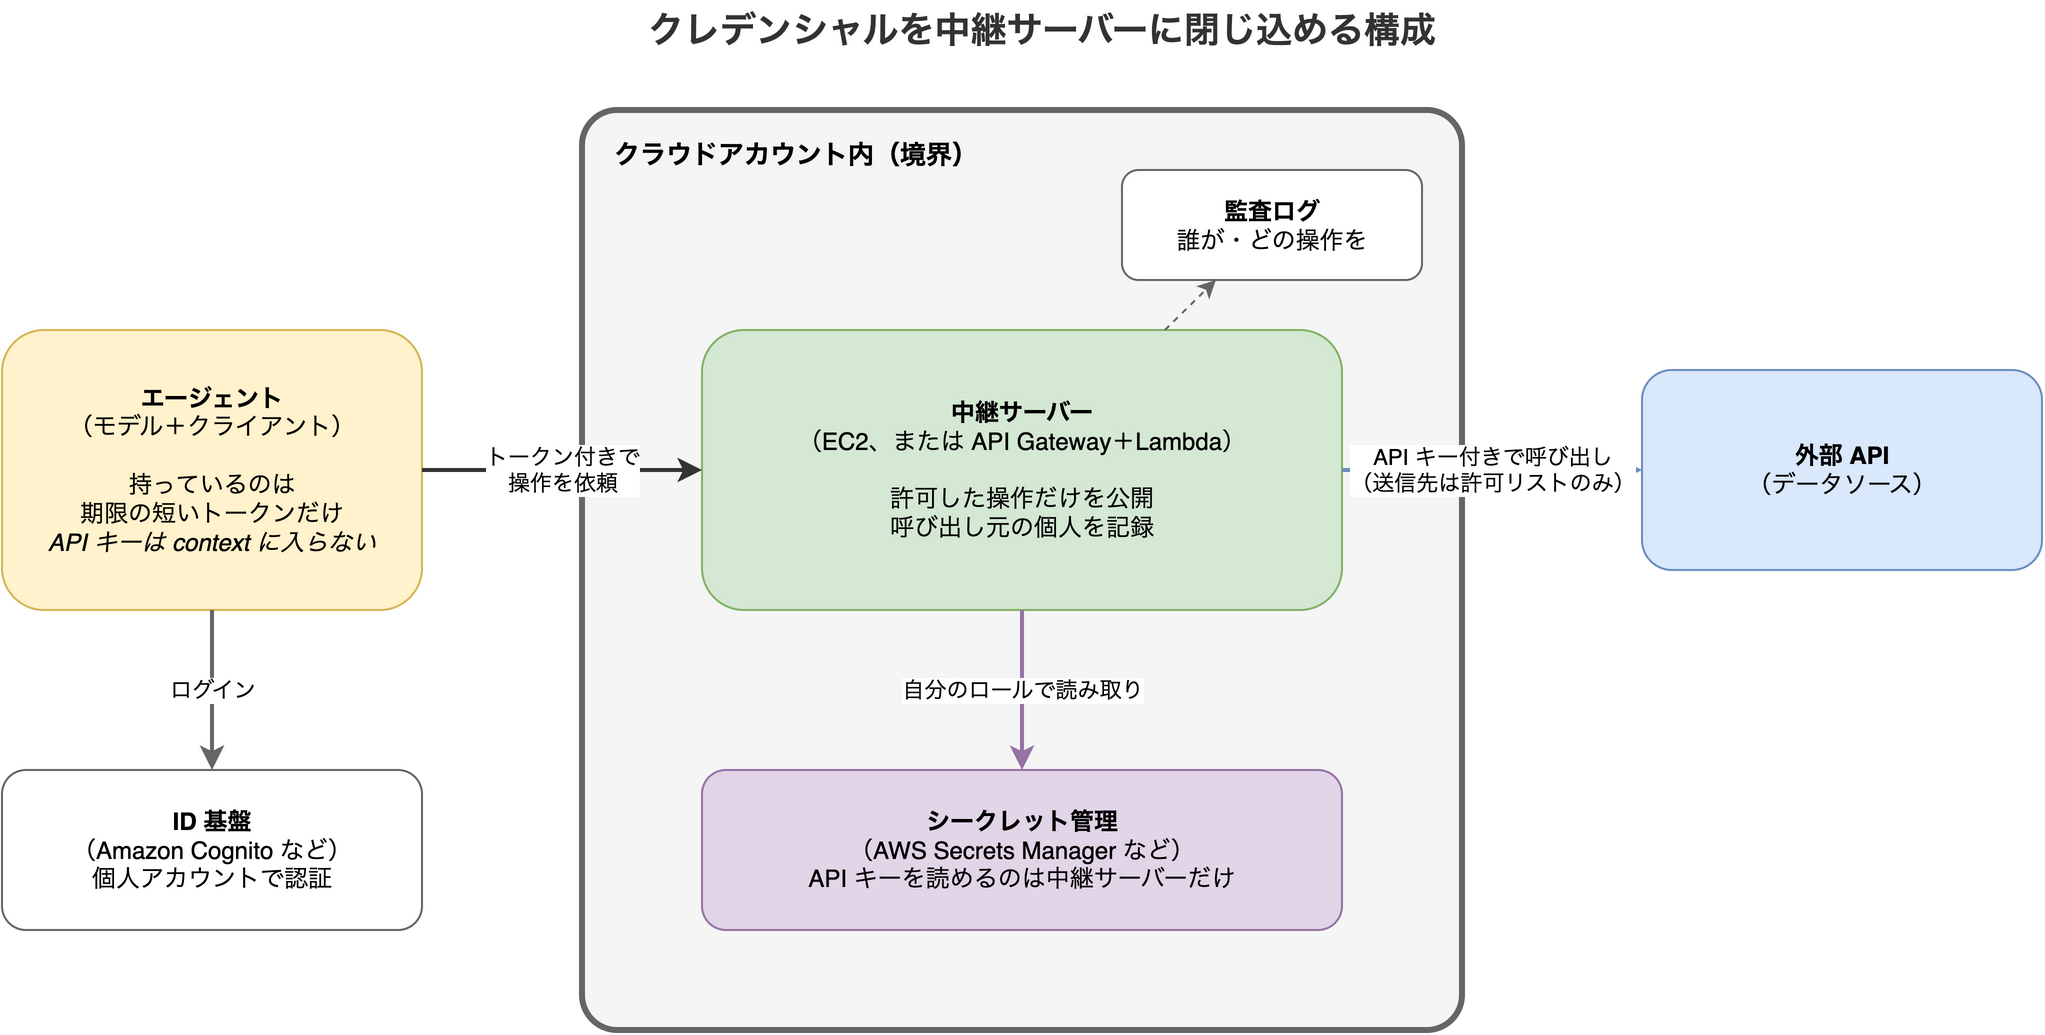
- 外部 API の API キーは AWS Secrets Manager に入れ、中継サーバー(EC2、または API Gateway+Lambda)のロールからしか読めないようにする
- 利用者やエージェントは Amazon Cognito などの ID 基盤に個人アカウントでログインし、中継サーバーを呼ぶ権限だけを得る
- 外部 API は中継サーバーの中からしか呼べない。エージェントは「この操作をして」と頼むだけで、API キーの値を一度も見ない
この構成には、次の利点がある。
- API キーが context に入る経路が無い:プロンプトインジェクションで持ち出される心配も、ログに紛れ込む心配もない
- 共有キーでも個人単位で追跡できる:外部 API から見えるのは共有のキー1つでも、中継サーバーで呼び出し元の個人を記録できる。前述の「データソース側のログ」と「誰の作業か」の突き合わせを、一か所で行える
- 失効とローテーションが一か所で済む:特定の人やエージェントを止めたいときは ID 基盤でアカウントを無効にすればよく、外部 API のキーを回す必要がない(発行済みのアクセストークンは、取り消さない限り期限まで有効なので、期限を短くしておく)。キーの更新も Secrets Manager 側で完結する
ただし、効き目は作り方で大きく変わる。押さえておきたい点は次のとおりだ。
| 観点 | 押さえどころ |
|---|---|
| 何を公開するか(最重要) | 外部 API へのリクエストを何でも素通しする汎用プロキシにすると、値が見えないだけで権限は丸ごと渡しているのと同じになる。必要な操作だけを個別に公開し、パラメータも検証する |
| 外向きの通信 | 中継サーバーの送信先を外部 API のホストだけに絞る。乗っ取られても他所へ送れないようにする |
| ロールの保護 | EC2 なら IMDSv2 を必須にし、SSRF でインスタンスロールの一時認証情報を盗まれにくくする(大半の SSRF を防げるが、完全ではない)。シークレットの読み取り権限は、そのロールだけに IAM で絞る |
| サーバーに入れる人 | SSH や Session Manager で入れる人は秘密の値を読める。入れる人を絞り、操作を記録する |
| エージェントのトークン | エージェントが持つトークン自体もクレデンシャルだ。期限の短いアクセストークンだけを渡し、長期のリフレッシュトークンは渡さない。人の呼び出しとエージェントの呼び出しをログで区別できるようにしておく |
外部サービスが増えたときは、中継サーバーのコードや設定を追加してデプロイする。エージェントから受け取ったスクリプトを中継サーバーで動的に実行する方式は、とるべきではない。エージェントが「シークレットを読んでレスポンスに含める」コードを送れてしまい、秘密の値と任意コード実行の権限を渡すのと同じになるからだ。追加の手間は、次の工夫で小さくできる。
- IaC と CI で、追加を PR 1本にする:ルート・Lambda・IAM ロール・シークレットの参照をまとめて定義し、テストとレビューを通ってからデプロイする。本記事でいう柵とレールを、この変更自体にも効かせる形だ。PR のコードはエージェントに書かせてもかまわない
- 共通部分をまとめる:シークレットの取得とキャッシュ、監査ログの出力、エラー処理を共有ライブラリにまとめれば、サービスごとに書くのは小さなハンドラだけになる
- サービスごとにロールを分ける:各ハンドラが自分のシークレットしか読めないようにすれば、1つに穴があっても漏れるのはそのサービスのキーだけで済む
最後に、この構成はキーを守る仕組みであって、取得したデータを守る仕組みではない。外部 API から返ったデータはエージェントの context に入る。そのエージェントが不審なコンテンツも読み、外部へも送信できるなら、前述の lethal trifecta はそのまま残る。中継サーバーと、通信先の制限やサンドボックスとを組み合わせて使う。
自走時間は目的ではない
エージェントが長時間自走したことは、それ自体では成果にならない。資料は Uber の事例を引き、「短く・少なく・安く」終えることが目標になったと述べる。
Uber はコストを次の6項の掛け算で捉えている。
ユーザー数 × セッション/ユーザー × ターン/セッション × リクエスト/ターン × トークン/リクエスト × 単価/トークン左の2項は利用の広がりなので増えてよい。右端の単価はモデル選択で決まる。中央の3項(ターン・リクエスト・トークン)がエージェントのオーバーヘッドで、これを減らすのがハーネスの仕事だ。
- ターン:計画を速くし、不要なターンやエラーを減らす
- リクエスト:社内情報のグラフで根拠づけ、無駄な探索を減らす
- トークン:常駐コンテキストを削る(MCP の CLI 化、キャッシュ)
資料によれば、Uber では 2026 年 2 月から 8 月にかけて利用者が 7 倍、リクエストが 9.4 倍に増えた。それでも総コストは 4 月以降ほぼ一定に落ち着いている(Uber の原文では “relatively stabilized”)。
- 1,000 リクエストあたりのコスト:ピーク時から 34% 減(モデルは固定)
- 1 セッションあたりのコスト:ピーク時から 52% 減
いちばん効いたのは、サブエージェントを安いモデルに切り替えたこと(方程式の右端「単価」)だったという。
ハーネスは隠れた技術的負債
作り込んだハーネスにも寿命がある。資料は Han Lee 氏の「良いチームほど多くのハーネスを作る。その多くは次世代モデルで不要になる」という言葉を引いている。
- 溶けて消えるもの:現行モデルの弱点を補う注意書き(「省略せずに全部出力して」「全部読んでから直して」)、細かく刻んだ手順、独自のリトライ処理。モデルが賢くなれば吸収される
- 残る中核:テスト(
check)、権限と境界、プロジェクト固有の規約
ある時点の形に固執せず、薄く軽く保ち、定期的に棚卸しする。
何から手をつけるか:6つの手順
資料は着手の順序も示している。逆順にやると、効かないルールと使われない道具が積み上がるという。
- 境界を引く:サンドボックスかクラウドエージェントで作業し、本番の認証情報は渡さない
- ルールを書く(AGENTS.md):最小限から始め、全行を実際の失敗や規約に対応させる。草案は AI に書かせ、人間が削る
- 柵を立て、「1コマンドの門」に束ねる:lint・型・テストを
checkにまとめ、人も AI も同じ門をくぐる - ループを閉じる:検証器とゴール(
checkがすべて通る)を渡し、エージェント自身に回させる - 繰り返しが見えたら、道具を増やす:繰り返す手順は Skills へ、観点はサブエージェントへ
- 運用で育て、定期的に棚卸しする:逸脱が出たら1行追記する。数か月に一度は全削除して、要るものだけ戻す(Git 管理なので安全に試せる)
合言葉は「境界を先に引く。ルールより先に道具を増やさない」だ。
無人で走らせるとき:イベント駆動と定期実行
ここまでは、人がタスクを渡してエージェントを走らせる場面を想定してきた。運用が進むと、Issue が立ったら起動する、毎朝決まった時刻に起動する、といった形で、起動そのものを自動化したくなる。この節は資料にはない、筆者による補足である。
起動の仕組みもハーネスの一部
「モデル以外のすべて」という定義に従えば、エージェントをいつ・何をきっかけに起動するかもハーネスに含まれる。構成の式でいえば、ワークフローの定義ファイルや定期実行の設定、イベントの購読設定は、リポジトリで管理するハーネスの部品だ。実行時の式でいえば、エージェントを起動して呼び出す runtime の一部にあたる。モデルは自分を起動できないので、ループのいちばん外側を回しているのはこの仕組みだ。
ただし、馬具・柵・境界のどれにも当てはまらない。3層は「走り出したエージェントをどう制御するか」の話で、起動は「誰がいつ走らせるか」という一段外側の役割だからだ。4つ目の層というより、3層それぞれに求められる強さを引き上げる要因と捉えるのがよい。
人の目が外れると、何が変わるか
対話で使うときは、人がタスクを渡し、途中で止め、結果を確かめている。起動を自動化すると、そのすべてが無人になる。そのぶん、次の点が重要になる。
| 観点 | 対話で使うとき | 無人で走らせるとき |
|---|---|---|
| 入力 | 人が書いたタスク | Issue の本文・Webhook のペイロード・取り込んだメールなど。外部の誰かが書いた内容は、プロンプトインジェクションの経路になりうる |
| 止める人 | 人が見ていて止められる | 誰も止めない。完了条件に加えて、ターン数・時間・コストの上限が要る |
| 成果物の出し方 | 人が確かめてから反映する | 直接マージやデプロイをさせず、PR として出させる。CI・ブランチ保護・人のレビューというレールを必ず通す |
| クレデンシャル | 個人アカウントでログインする | ログインする人がいない。ワークロード用の ID と期限の短いトークンを使い、どのトリガーが起動したかを監査ログに残す |
| 重複と並行 | 人が1回ずつ起動する | 同じイベントが2回届く、前回の定期実行が終わっていない、といった状況でも壊れないようにする(重複の排除、同時実行数の制限) |
とくに入力の行は、前述の lethal trifecta と直結する。外部から届いた文面を読むエージェントが、機密データにアクセスでき、外部にも送信できるなら、3つの条件がそろい、危険が最大になる。無人の実行では、人が途中で異変に気づくこともない。外部の入力をきっかけに起動するエージェントには、境界をいちばん狭く引いておく。
停止条件の行は、「自走時間は目的ではない」の節とも重なる。あの節は、長時間自走したことはそれ自体では成果にならない、というコストの話だった。無人の実行では、同じ上限が暴走を止める安全装置の役割も担う(この結びつけは筆者の解釈である)。
中継サーバーの構成を、無人実行に使う
表のクレデンシャルの行は、前述の「クレデンシャルを中継サーバーに閉じ込める」構成と組み合わせると実現しやすい。無人の実行こそ、この構成が生きる場面だ。人が見ていないぶん、エージェントの実行環境に API キーを置かずに済む価値が大きくなる。
変えるのは、誰が中継サーバーを呼ぶ権限を持つかの部分だけだ。対話のときは、人が ID 基盤に個人アカウントでログインし、そのトークンで中継サーバーを呼んでいた。無人のときはログインする人がいないので、エージェントを動かす実行環境にワークロード用の ID を持たせ、その ID に中継サーバーを呼ぶ権限だけを与える。
- AWS 上で動かす場合(ECS・CodeBuild・Lambda など):実行環境の IAM ロールに、中継用の Lambda を呼ぶ権限、または API Gateway を IAM 認証で呼ぶ権限だけを付ける
- GitHub Actions で動かす場合:OIDC で AWS のロールを引き受け、そのロールに同じく中継サーバーを呼ぶ権限だけを付ける。長期のアクセスキーをリポジトリのシークレットに置く必要もない
実行環境が持つのは「決まった操作を頼む権限」だけになり、API キーはシークレット管理と中継サーバーの外に出ない。
無人ならではの利点もある。ロールを分ければ、トリガーごとに呼べる操作を変えられる。たとえば、Issue をきっかけに起動するエージェントには読み取り系の操作だけを許し、社内のスケジュール実行には更新系も許す、というように、入力の信頼度に合わせて権限を決められる。呼び出し元のロールを記録すれば、どのトリガーで起動した実行が、どの操作をしたかも追える。ただし記録の取り方は呼び方で変わる。API Gateway を IAM 認証で呼ぶ構成なら、中継サーバーのコードがリクエストの情報から呼び出し元のロールを取得して記録できる。Lambda を直接呼ぶ構成では、関数のコードから呼び出し元のロールは見えないので、CloudTrail で Lambda の呼び出し(データイベント)の記録を有効にして追う(既定では無効で、追加料金がかかる)。
ただし、中継サーバーが守るのは API キーであって、取得したデータではない。無人実行では、次の組み合わせに特に気をつける。
- 外部の誰かが書いた Issue の本文をきっかけに起動する(不審なコンテンツ)
- 中継サーバー経由で機密データを取得できる(機密データへのアクセス)
- 結果を公開リポジトリにコメントや PR として書き込める(外部への送信)
公開された場所への書き込みは、それ自体がデータの持ち出し経路になる。実際に、公開リポジトリに仕込んだ Issue でエージェントに非公開リポジトリの情報を読ませ、公開リポジトリの PR として漏らさせる手口が報告されている。外部の入力で起動するエージェントには、機密データを返す操作を呼ばせない。上で述べたトリガーごとのロール分けは、まさにこの切り分けのための仕組みだ。
まとめ:ハーネスエンジニアリング4原則
資料の結びは次の4原則である。
- 戻れない場所に道を作らない:本番・機密・個人情報・不可逆な操作には到達できないようにする。隔離環境・通信遮断・最小権限で、境界を先に引く
- 進路はハーネスで示す:規約・コマンド・禁止事項を明文化し、逸脱が出るたびに1行足す。書いたあとの運用が大事
- 逸脱はガードレールで検知する:lint・型・テスト・Hooks を「1コマンドの門」に束ね、人も AI も同じ門をくぐる。判定は機械的に
- ループを閉じて自走させる:検証器とゴールを渡せば、エージェントが自分で直して完走する。任せられる範囲が広がる
ハーネスエンジニアリングの議論は「AGENTS.md に何を書くか」に寄りがちだが、この資料は指示(馬具)・判定(柵)・構造(境界)を強さの違う3つの層として並べ、さらに着手順を「境界から」と定めた点がわかりやすい。確率で動くモデルに仕事を任せる以上、指示の巧拙より先に、漏れても壊れない環境と、機械的に落ちる門を用意する。それが自走させるための前提条件になる。