AI コーディングエージェントに開発を任せるとき、仕様をどこまで先に書くかは悩ましい問題です。Spec Loop は、設計先行(Design-First)型のフレームワークです。この問題への答えは、「次の小さな仕様だけを書き、レビューし、テスト付きで実装する。それを繰り返す」というものです。
マインドマップツール Freeplane の開発で生まれ、実際に使われてきました。MIT ライセンスで公開されています。実体は AI エージェント向けのスキル集で、npx skills でプロジェクトに導入できます。
この記事では、README とドキュメントをもとに、Spec Loop の考え方・ワークフロー・タスクファイルの構造、そして他フレームワークとの違いを整理します。
なお、本記事の Spec Loop は dpolivaev/spec-loop のことで、以前書いた 要求仕様書作成ループ や、それを Claude Code プラグインにした記事 とは別物です。要求仕様ループが開発の手前で「何を作るか」を確定させるのに対し、Spec Loop は方向が決まった後の実装の一歩一歩を統制します。
2 つの失敗パターンのあいだ
README は冒頭で、AI を使ったコーディングのよくある 2 つのやり方を挙げています。
- バイブコーディング: 意図だけを伝え、隙間はモデルが埋める。結果として、判断の経緯が記録されない巨大な差分が出てくる。レビューは「考古学」になり、テストは「うっかり」省かれる
- ウォーターフォール: それを避けようと、先に完全な仕様を書こうとする。しかし、事前に完全な仕様を書くことはできない。制約は実装中に見つかるものなので、仕様は膨らみ続け、やがて変更を阻むか、無視されるようになる
Spec Loop はその中間を取ります。仕様は「次の一歩」に必要な範囲だけに留め、それをレビューしてからテスト付きで実装し、また次の一歩へ進みます。
ワークフローの全体像
全体の流れは下図のとおりです。
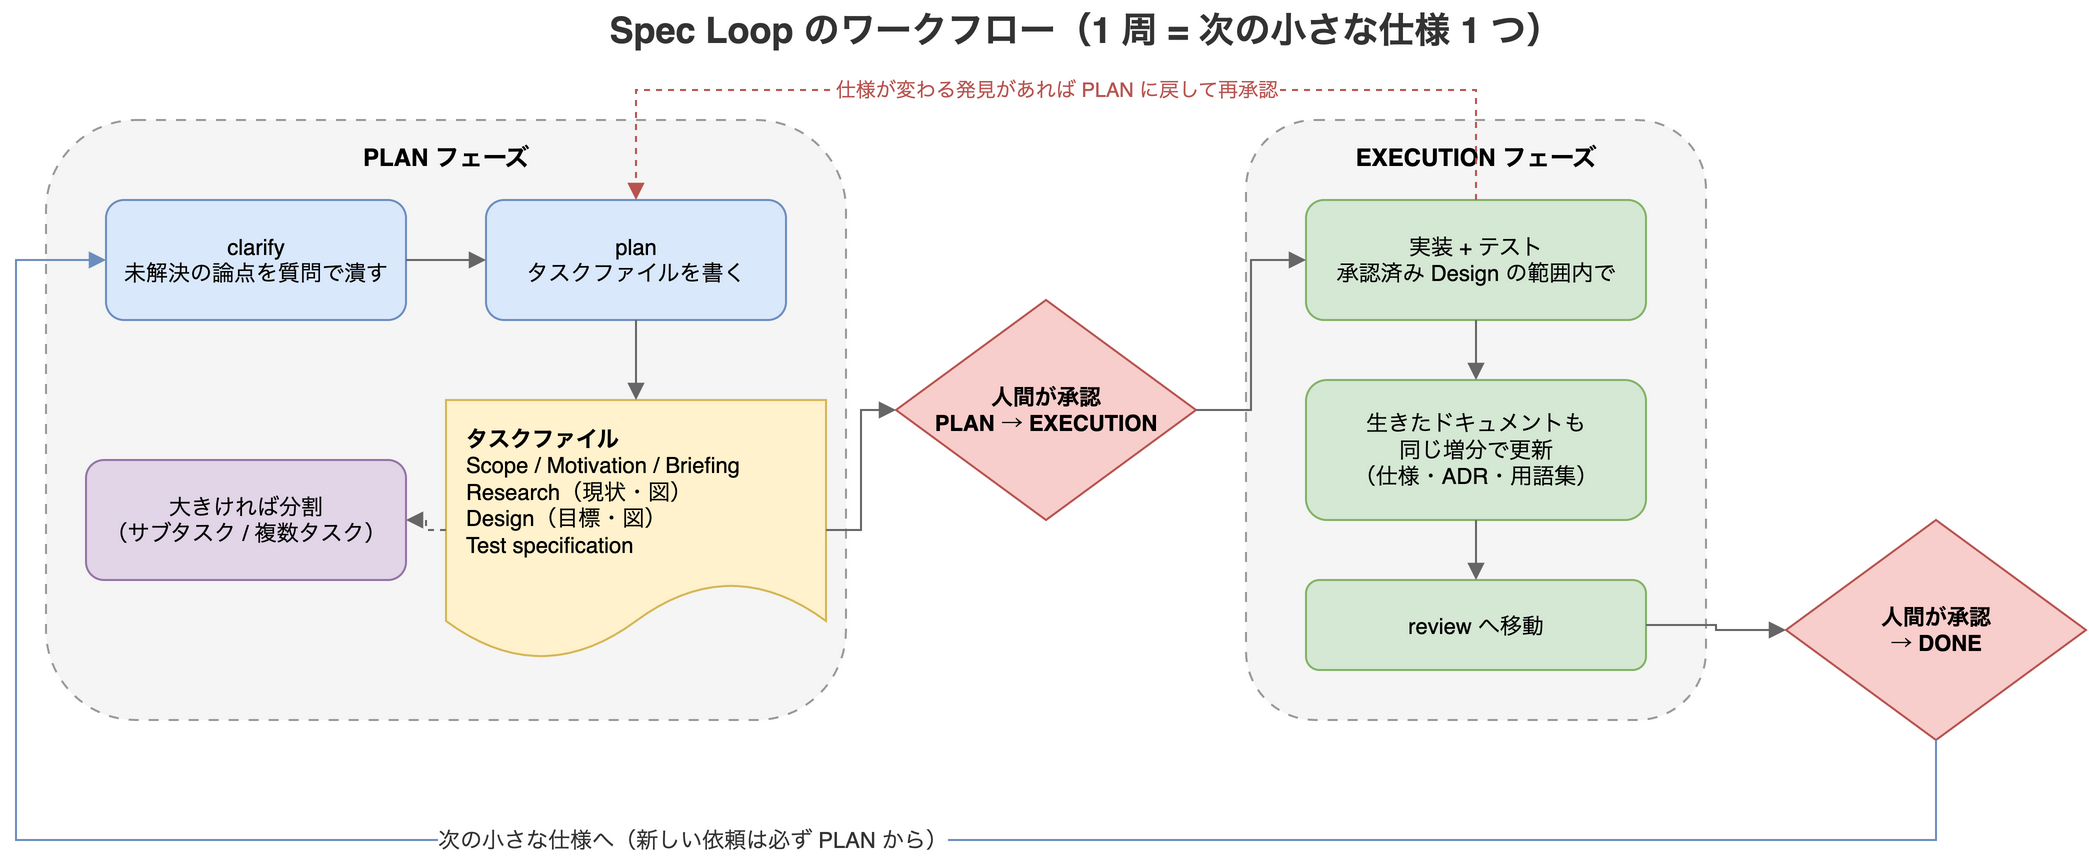
ドキュメント「How Spec Loop Works」では、ワークフローが次のステップで説明されています。
| ステップ | 担当スキル | 内容 |
|---|---|---|
| clarify | spec-loop-clarify-task | 計画の前・途中で、重要な未解決の問いを解消する |
| plan | spec-loop-plan-task | 計画の形式を選び、タスクを書く。ADR やドキュメントへの振り分けもここ |
| break down work | spec-loop-plan-work-breakdown | 大きな作業をサブタスクや複数タスクファイルに分割する |
| approve | spec-loop-prepare-execution-approval | タスクファイルを承認できる状態に整え、人間が承認する |
| execute | spec-loop-implementation-flow | 承認後、コード・テスト・関連ドキュメントの更新を統制する |
| review / ready | spec-loop-implementation-flow | review への移動、またはレビュー準備完了の報告 |
作業には PLAN・EXECUTION・DONE の 3 つのフェーズがあります。PLAN → EXECUTION と EXECUTION → DONE の遷移には、どちらも人間(ユーザー)の明示的な承認が必要です。さらに、新しい依頼・追加の修正・拡張はすべて PLAN に戻ります。依頼の内容が変わったのに、モデルが惰性で実装を続けることを防ぐためです。
実装中に、承認済みの意図そのものを変えるような発見があった場合も、タスクを更新して再承認を得てから続けます。小さな確認で済む範囲なら、タスクをその場で更新して作業を続けてよい、とされています。
計画の形式は 3 段階+分割
いつも重いタスクファイルを書くわけではありません。計画の形式は作業の大きさに応じて選びます。
- taskless: タスクを立てない。ADR などのドキュメントだけの作業か、ユーザーが明示的に同意したごく小さな実装に限られる
- chat-only task: チャット上だけで完結する軽いタスク。セクションは Scope・Design・Test specification の 3 つだけ
- task file: ファイルに書く標準形式(デフォルト)
- task file with subtasks / multiple task files / backlog items: 大きな作業の分割
デフォルトはタスクファイルです。より軽い形式で足りる場合、エージェントはその理由を説明し、使ってよいか許可を求めます。ここで注意したいのは、「形式への同意は実行の承認ではない」と明記されている点です。軽い形式を選んでも、実装に入る前にはあらためて承認が必要です。
チャットだけで済ませられるのは、次の条件をすべて満たす作業に限られます。
- 調査が軽い
- 実装方針が一本道
- 検証が軽い
- 既存のタスクファイルがない
- サブタスクや図が要らない
途中でこの条件を外れたら、タスクファイルに移ってそのルールに従います。
分割する場合、実装タスクやサブタスクは、ユーザーが明示的に例外としない限り、それぞれ単独でリリースできる単位にすることが求められます。「scaffolding」「model」「UI」のように層ごとに切るのではなく、1 つの振る舞いを層をまたいで実装する縦切り(vertical slice)が基本です。
タスクファイルの構造
タスクファイルは、セクションを Markdown の見出しではなく太字ラベルの箇条書きで並べます。サブタスクを入れたときに見出しの階層が深くなりすぎないようにするためです。並び順は次のとおりです(括弧内は筆者の注記)。
# Task: <タイトル>
- **Task Identifier:** YYYY-MM-DD-<slug>
- **Scope:**
- **Motivation:**
- **Scenario:**            (条件付き)
- **Glossary:**            (条件付き)
- **Constraints:**         (任意)
- **Briefing:**
- **Research:**
- **Analysis:**            (条件付き)
- **Design:**
- **Test specification:**
- **Findings:**            (調査タスクのみ)
- **Implementation notes:** (条件付き)
識別子はチケット ID があればそれを、なければ YYYY-MM-DD-<slug> 形式の Task Identifier を使い、コミットメッセージの先頭に付けます。主なセクションの役割は次のとおりです。
- Constraints: 設計と実装が守るべき制約。Design と Constraints が矛盾したら Constraints が優先される
- Briefing: コードベースに不慣れな人向けの短い道案内。Research・Design・Test specification が固まった後、承認を求める直前に仕上げる
- Research: 実装前の現状について、観察・制約・確認済みの事実だけを書く。計画は書かない
- Analysis: 確定した判断を 1 行ずつ「because(理由)」「so that(目的)」で記録する台帳。「ユーザーがそう言ったから」のような経緯は理由として認めない
- Design: 実装の契約。最終的な名前だけを使い、
HelperやManagerのような仮の名前は原則禁止(確立したドメイン用語・フレームワーク用語は除く)。良い名前が付けられないなら設計の欠陥とみなす
Research と Design には PlantUML の図(クラス図・コンポーネント図・シーケンス図)を描くのが原則です。Research には現在の状態を、Design には目標の状態を描きます。Design のクラス図では、型やメンバーの頭に計画上の変更を示す記号を付けます。
- + — 追加する
- = — 既存のものを変更せず再利用する
- ± — 既存のものを変更する
この記号は、Test specification に書く自動テストの項目(Automated tests)にも付けます。実装の進み具合やテスト結果を表すものではない点に注意してください。
状態管理
タスクファイルは backlog・in-progress・review・done の 4 つのフォルダで状態を管理し、フォルダ間の移動は git mv で行います。エージェントが自分でタスクを in-progress から review に移せるのは、実装と自動検証が終わったときだけです。done への移動は、常にユーザーだけが行えます。
生きたドキュメントと短命なタスクファイル
Spec Loop は、寿命の異なる文書をはっきり分けています。
- タスクファイル: 次の具体的なタスクを進めるための短命な作業成果物。過去のタスクファイル同士の整合性は求めない。リリースタグを作った後は作業ツリーから削除する
- 生きたドキュメント(Living Project Documents): タスクが受け入れられた後も役立つ「現在の真実」。仕様、API 契約、アーキテクチャ、運用、ADR、用語集など
コードの変更に伴って生きたドキュメントを直す必要があれば、その作業をタスクの Design に「Living project documents」として列挙し、コードと同じ増分で完了させ、レビューにも含めます。影響がなければ None affected と明記します。
生きたドキュメントが複数あるプロジェクトでは、プロジェクト指示ファイル(既定はルートの README)に一覧を 1 つだけ置きます。一方で、生きたドキュメントが特に要らないプロジェクトに、ワークフローのためだけに作らせることはしません。
用語集で言葉をそろえる
生きたドキュメントのなかでも、Spec Loop が特に重視しているのが用語集、つまり共有のドメイン言語です。プロジェクト用語集(AsciiDoc 形式、spec-loop-write-glossary で管理)があれば、設計文書・テスト・コード上の名前・コミットメッセージを同じ言葉でそろえます。
新しい用語を加える前には、綴りではなく意味が既存の抽象と同じかどうかを確かめます。同じであれば、既存の名前を使うか、明示的にリネームを提案します。大規模なコードベースで多くのタスクやサブシステムをまたいでも、用語がぶれないようにするための仕組みです。
大規模・レガシーなコードベースで効く理由
Spec Loop は、既存の大規模コードベースで使うことを前提に設計されています。古典的な「調査 → 計画 → 実装」を、小さくレビューしやすい単位に分けて回します。
ポイントは、Research が今のタスクに必要な範囲だけに意図的に絞られていることです。調査結果は書き残されるので、人間はコードを書く前に確認できます。モデルが正しい箇所を調べたか、正しいインターフェースを特定したか、既存の書き方に合わせているか、といった点です。「How Spec Loop Works」によれば、この仕組みがレガシーシステムで「白紙からの作り直し(clean-room redesign)」を防ぎ、段階的な変更を安全にします。
背景には「人間の開発者が理解と意図の主たる源泉であり続ける」という前提があります。モデルは明示的な制約の下で動く強力な実装・推論の補助役であり、独立した意思決定者ではない、という位置づけです。
完了の定義も同じ考え方で、「コードが動いた」ことからは完了を推論しません。done になる条件は次のとおりです。
- 承認済みの設計がすべて実装されている
- テスト仕様が実装され、通っている
- 計画からの逸脱がタスクに記録されている
- 生きたドキュメントの更新が完了し、レビューに含まれている
- ユーザーが done への移行を明示的に承認している
他のフレームワークとの比較
リポジトリには、OpenSpec・Superpowers・grill-with-docs・agent-skills と比較したドキュメントもあります。星の数による相対評価で、ベンチマークではないと断ったうえで位置づけています。Spec Loop の特徴が出ている観点を抜粋すると、次のとおりです(「-」はその目的を持たない、または資料から確認できないことを示します)。
| 観点 | Spec Loop の評価 |
|---|---|
| 広い問題領域の分析から始める | ★★(OpenSpec・Superpowers は ★★★★★) |
| 具体的なタスクを実装前に明確化する | ★★★★★ |
| 共有用語集の維持 | ★★★★★ |
| 現状と目標の構造・振る舞いを図で明示する | ★★★★★(他は ★) |
| 1 つの単純な実装ステップを軽量に計画する | ★★★★★ |
| テストファーストを必須の方法とする | ★★(Superpowers は ★★★★★) |
| サブエージェント+レビューループを主戦略にする | -(Superpowers は ★★★★★) |
コスト面の評価は次のとおりです。
| 活動 | Spec Loop のコスト |
|---|---|
| 着手前(明確化・仕様・計画・承認) | 中 |
| コーディングとテスト | 中 |
| システムが育つにつれて文書を保守する | 低 |
| タスクごとの再調査・再整合 | 中 |
文書保守のコストが低いのは、正本として保つ文書の範囲を狭くしているためです。その代わり、タスクごとにコードベースを調査し直して現状を確認するので、再調査・再整合のコストは中程度になります。
OpenSpec や Superpowers は、大まかな問題やアイデアから出発するのが得意です。一方 Spec Loop が最も強いのは、作業の方向が決まった後に、計画・調査・承認・実装の統制を明示的に行いたい場面だ、と自己評価しています。
導入方法
Node.js があれば、npx skills で導入できます。
# 現在のプロジェクトに全スキルを入れる
npx skills add dpolivaev/spec-loop -s '*'

# グローバルに入れる場合
npx skills add dpolivaev/spec-loop -s '*' -g

# 更新
npx skills update
-s '*' を外すと、入れるスキルを対話的に選べます。中心になるのは次の 7 つ(core task-workflow bundle)で、まとめて入れることが推奨されています。
spec-loop-plan-taskspec-loop-plan-work-breakdownspec-loop-clarify-taskspec-loop-prepare-execution-approvalspec-loop-implementation-flowspec-loop-write-adrspec-loop-write-readable-tests
spec-loop-write-readable-tests は、テストの設計・命名・書き方のガイドとして Spec Loop なしでも使えます。このほかに、次のスキルがあります。
spec-loop-write-glossary— プロジェクト用語集を使う場合に必要spec-loop-setup-doc-rendering— 任意。エディタで図をプレビューする環境の構築spec-loop-review-change— 任意。既存の PR・差分のレビューspec-loop-compact-task-file— 肥大化したタスクファイルを、意味を変えずに圧縮する
タスクファイルには PlantUML、用語集には Mermaid の図が入るため、レビューするエディタで図が描画されるよう準備しておくと読みやすくなります。VS Code 系エディタ向けにはセットアップスクリプトも用意されています。次のコマンドは、リポジトリを clone したルートで実行する場合のものです(README には、スクリプト単体を curl で取得する手順も載っています)。
bash skills/spec-loop-setup-doc-rendering/scripts/setup-vscode-server-based.sh --check
bash skills/spec-loop-setup-doc-rendering/scripts/setup-vscode-server-based.sh --apply
具体的な流れを知りたい場合は、2 つのチュートリアルが用意されています。Java で Wordle を作る Wordle Tutorial と、シカゴ美術館のデータを使い、作品を制作年順に並べるブラウザ向けゲームを作る Online Art Game Tutorial です。
まとめ
Spec Loop の考え方は、次の 3 点に集約できます。
- 仕様は「次の一歩」だけ書く。完全な仕様を最初に書こうとしない
- 実装の前後に人間の承認を置く。PLAN → EXECUTION と EXECUTION → DONE は人間が決め、依頼が変わったら必ず PLAN に戻る
- 短命なタスクファイルと、生きたドキュメントを分ける。生きたドキュメントはコードと同じ増分で更新する
AI エージェントに大きな差分を一気に書かせてレビューに苦しんでいる、あるいは仕様書を先に書き切ろうとして疲れている、という場合に、試す価値のある進め方です。特に、既存の大きなコードベースに AI で少しずつ手を入れていく場面と相性が良いでしょう。