Google Research が、エージェントの「ハーネス」をエージェント自身に改善させるフレームワーク Harness²(Harness squared)を OSS として公開しました。モデルの重みには触れず、正解データも使わずに、タスクごとにハーネスを磨いていくのが特徴です。論文は「Harness²: Recursive Agent Harnessing for an Open World」(arXiv:2610.14224)です。実装は google-research/harness2 にあり、ライセンスは Apache-2.0 です。
X では Akshay Pachaar 氏の紹介ポストが広く読まれ、日本語圏でも StudioYebisu 氏が「今週で一番の本質情報っぽい」と取り上げています。同氏は「どっちかというと研究者向けのやつで。利用者側はこれを活用して作られたハーネスとかで恩恵を受けるだろうから、一旦静観でもいい」とも書いています(同氏自身もまだ勉強中で、使い方の案内は保留としています)。
本記事では README と論文の要旨をもとに、何をする仕組みなのか、どう動かすのかを整理します。
そもそも「ハーネス」とは
Harness² の README は、ハーネスを次のように定義しています。
A harness is the system around a model that enables it to act as an agent: prompts, tools, memory, skills, orchestration, and more.
モデルをエージェントとして働かせるための周辺一式、つまりシステムプロンプト・ツール・メモリ・スキル・サブエージェントなどの総称です。Claude Code でいえば CLAUDE.md、Agent Skills、サブエージェント定義、hooks あたりがこれに当たります。そしてハーネスを最適化する作業を、README は「Harnessing」と呼んでいます。
通常、ハーネスは人間が一度設計し、エージェントは新しいタスクが来ても同じ固定のハーネスで走ります。Harness² はこの前提を崩し、モデルの重みには触れずに、タスクごとにエージェント自身がハーネスを調整します。
Harness² が編集対象として公開しているコンポーネントは次の 8 つです。
| 役割 | コンポーネント |
|---|---|
| コンテキストの構築 | system prompt、guardrails、memory、skills |
| ツールのインターフェース | tool guidance、scripts |
| 委譲のオーケストレーション | subagents |
| ミドルウェア(ツールループ内の振る舞い) | plugins |
2 段階の再帰
Harness² の中心は、名前の「²」が示す 2 段階の再帰です。
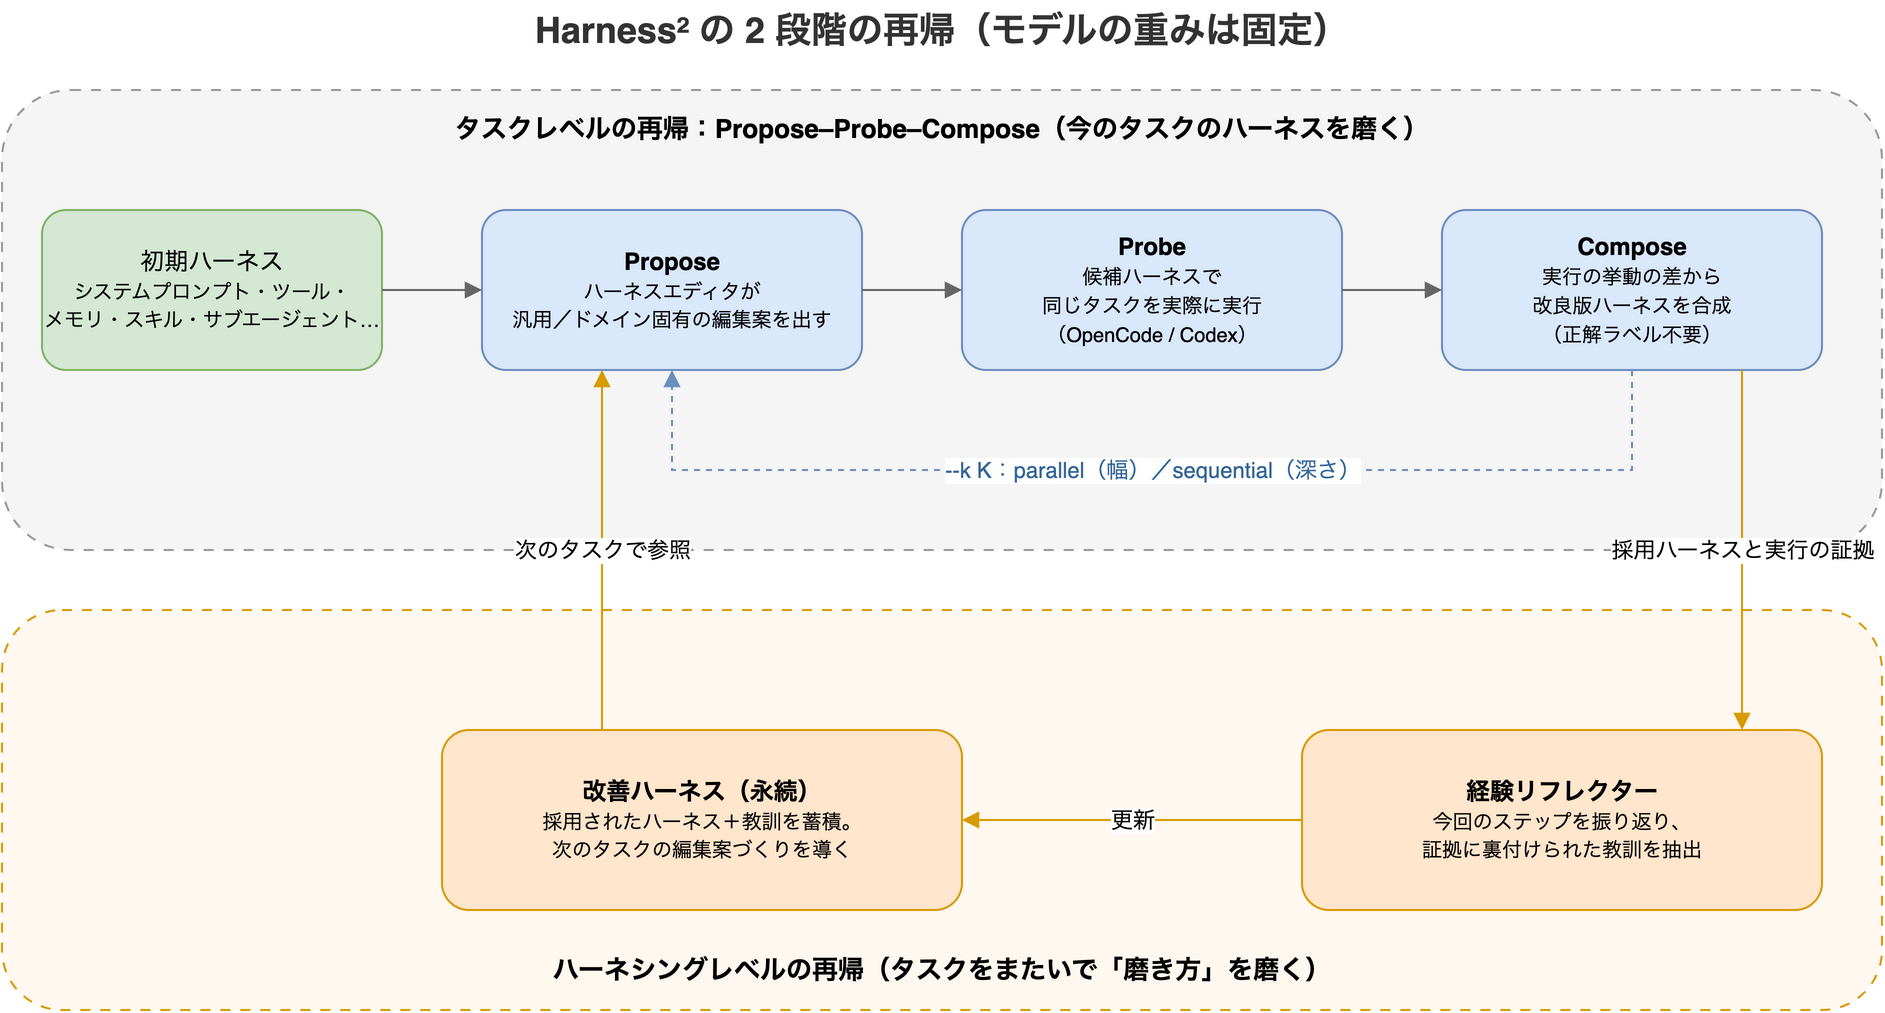
タスクレベルの再帰:Propose–Probe–Compose
今取り組んでいるタスクに対して、実行用のハーネスを磨くループです。
- Propose:ハーネスエディタ(ハーネスを書き換える役)が、汎用的な編集案とドメイン固有の編集案を出す
- Probe:その編集を入れた候補ハーネスで、同じタスクを実際に実行する。実行役(executor)には、OSS のコーディングエージェントである OpenCode(既定)か Codex を使う
- Compose:複数の実行の挙動の違い(behavioral contrasts)を比較し、改良版のハーネスを合成する
ポイントは、正解データ(ground truth)や採点器を必要としないことです。「どちらの出力が正しいか」ではなく「同じタスクを違うハーネスで走らせたら挙動がどう変わったか」から学ぶため、答えの用意されていない未知のタスク(論文のいう open world)にもそのまま適用できます。
ハーネシングレベルの再帰:改善の仕方を改善する
タスクが 1 件終わるたびに、経験リフレクター(experience reflector)がそのステップを振り返ります。採用されたハーネスと、複数の実行にまたがって裏付けが取れた教訓(evidence-supported lessons)は、永続的な「改善ハーネス(improvement harness)」に書き戻されます。次のタスクでハーネスを磨くときは、ゼロからではなくこの蓄積から始めます。
つまり 1 段目は「ハーネスを磨く」、2 段目は「ハーネスの磨き方を磨く」という関係です。タスクをこなすほど、次の編集案の質が上がっていく設計になっています。
ベンチマーク結果
README によると、3 つの専門業務系ベンチマークと 4 つのモデル×ハーネス構成で評価し、Harness² を 1 ステップ回しただけで GLM-5 と Gemini 3.5 Flash がいずれも元のハーネスを上回りました。
| ベンチマーク | 内容 | 改善幅(最大) |
|---|---|---|
| WorkBuddy-Bench | オフィス・Web・コード | 11.5 ポイント |
| JobBench | 専門職の業務 | 4.5 ポイント |
| LAB | 法務 | partial pass rate で 11.8 パーセントポイント |
タスクレベルの再帰の予算(後述の --k)を増やすと、さらにスコアが伸びたと報告されています。
インストールとデモ
動作環境は Linux・Python 3.12・uv が指定されています。リポジトリを clone して、ルートで次を実行します。
git clone https://github.com/google-research/harness2.git
cd harness2
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
harness2-demo は、決定論的な(モデルを呼ばない)エディタと実際の Python 実行で両方の再帰モードを動かすローカルデモです。モデルの認証情報なしで試せます。まずはこれで Propose–Probe–Compose の流れをつかむのがよさそうです。
モデルを使うベンチマークには Node.js 20 以上と Google Cloud CLI が必要で、既定の設定は Vertex AI を前提にしています。
cp .env.example .env
# .env に Vertex AI のプロジェクトとモデル ID を記入
gcloud auth application-default login
LAB には Pandoc と Poppler、WorkBuddy-Bench には Docker が別途必要です。
ベンチマークを 1 件だけ回す
LAB(法務)のタスクを 1 件だけ実行し、評価・レポートまで行う例です。モデル呼び出しには API 費用がかかるので、README も小さなタスク選択から始めるよう勧めています。
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
harness2-judge と harness2-report には、改善実行と同じベンチマーク・executor・subset・--k・--mode・seed を渡す必要があります。harness2 に --dry-run を付けると、モデルを呼ばずにタスク選択だけを確認できます。
主なオプションは次のとおりです。
| オプション | 動作 |
|---|---|
--k 1 | Propose–Probe–Compose を 1 ステップ |
--k K --mode parallel | 汎用・ドメイン固有の候補をそれぞれ K 個試し、K 個の合成を作る(幅を広げる) |
--k K --mode sequential | 改良したハーネスと蓄積した証拠を引き継いで K ステップ磨く(深く掘る) |
--substrate cx | 既定の OpenCode の代わりに Codex を executor に使う |
結果は runs/ 以下に保存され、タスクの要約・成果物・採用されたハーネス・振り返りメモ・評価結果が含まれます。同じコマンドを再実行すると中断したところから再開します。
使う前の注意点
- ネットワークとサンドボックスの制限なし:executor のネットワークアクセスに制限はなく、Codex はサンドボックスを無効にして動きます。
- 採点基準の漏洩:公開ベンチマークの採点基準はネット上にあります。評価前にネットワーク制限を設定するよう README が注意しています。
- API 費用:Probe は候補ハーネスごとにタスクを実際に走らせるので、
--kを増やすほど実行回数が増えます。 - 公式サポート製品ではない:README の Disclaimer に「not an officially supported Google product」と明記されています。
自分のハーネスにどう活かすか(考察)
ここからは筆者の考察です。StudioYebisu 氏の言うとおり、Harness² はそのまま日常の開発に組み込むツールというより、研究用のフレームワークです。それでも、自作ハーネスの運用に持ち込める考え方はいくつかあります。
- 正解がなくても比較はできる:「同じタスクを 2 通りの指示で走らせ、挙動の差を見る」という Probe の発想は、
CLAUDE.mdやスキルの文言を変えたときの効果確認にそのまま使えます。 - 教訓は証拠付きで残す:1 回の成功から教訓を書くのではなく、複数の実行で再現した差だけを改善ハーネスに書き戻す、という線引きは、メモリやルールファイルが思いつきで膨らむのを防ぎます。
- 「磨き方」を別に持つ:実行用のハーネスと、それを改善するためのハーネスを分けて管理する構造は、レビュー用エージェントやルール改善のスキルを本体の指示から切り離しておく設計と重なります。
利用者としては、まず harness2-demo で流れを眺め、自分のハーネスを変えたときに比較実行をしているかを見直すところから始めるのが現実的だと思います。