2026 年 10 月 19 日、Datalab が OCR モデル Indra OCR 1.1 を公開しました。創業者の Vik Paruchuri 氏はリリースの投稿で、特徴を次のように挙げています。
- 主 OCR モデルは 100 万(1M)パラメータで、CPU で毎秒 44 ページ
- Datalab が公開している文書解析ベンチマーク OmniParseBench のスコアは、34 億パラメータの DeepSeek OCR 2 との差が 4 ポイント以内
- Tesseract の 15 倍速く、精度も上
- 80 以上の言語と手書き文字に対応
日本では StudioYebisu 氏の投稿が紹介して話題になりました。CPU で動く軽量 OCR で日本語に対応したものは珍しい、という指摘です。PDF や画像を LLM に読ませる前処理に使えば、トークンを節約しながら大量の請求書を処理できる、とも述べています。
この記事では公式リポジトリ datalab-to/indra の README をもとに、Indra OCR の仕組み、使い方、日本語での実力、LLM 前処理での使いどころ、そして導入前に必ず確認したいライセンスを整理します。
Indra OCR とは
Indra OCR は、PDF や画像を Markdown・プレーンテキスト・座標付き JSON に変換する OCR ツールです。推論は ONNX Runtime で行い、PyTorch にも GPU にも依存しません。
| 項目 | 内容 |
|---|---|
| 開発元 | Datalab(datalab-to) |
| 主認識器のパラメータ数 | 約 125 万(rec.onnx、ラテン文字用) |
| 既定モデル全体のパラメータ数 | 約 730 万(数式用モデルは別) |
| モデルのダウンロードサイズ | 約 76 MB(初回実行時に Hugging Face から取得) |
| 実行環境 | Python 3.10 以上。Linux(x86_64 / aarch64)と macOS(Apple silicon)で動作確認済み |
| 依存ライブラリ | ONNX Runtime、OpenCV、pypdfium2 |
| 出力形式 | Markdown / テキスト / JSON(行・ブロックの座標と信頼度つき) |
「1M パラメータ」は主認識器 1 つの規模を丸めた数字です。実際の処理では、レイアウト検出や向き判定、言語ごとの認識器など複数のモデルを組み合わせて使います。それでも合計 730 万パラメータなので、数十億パラメータ級の VLM(画像を直接読める大規模言語モデル)系の OCR と比べれば桁違いに小さいモデルです。
処理の流れ
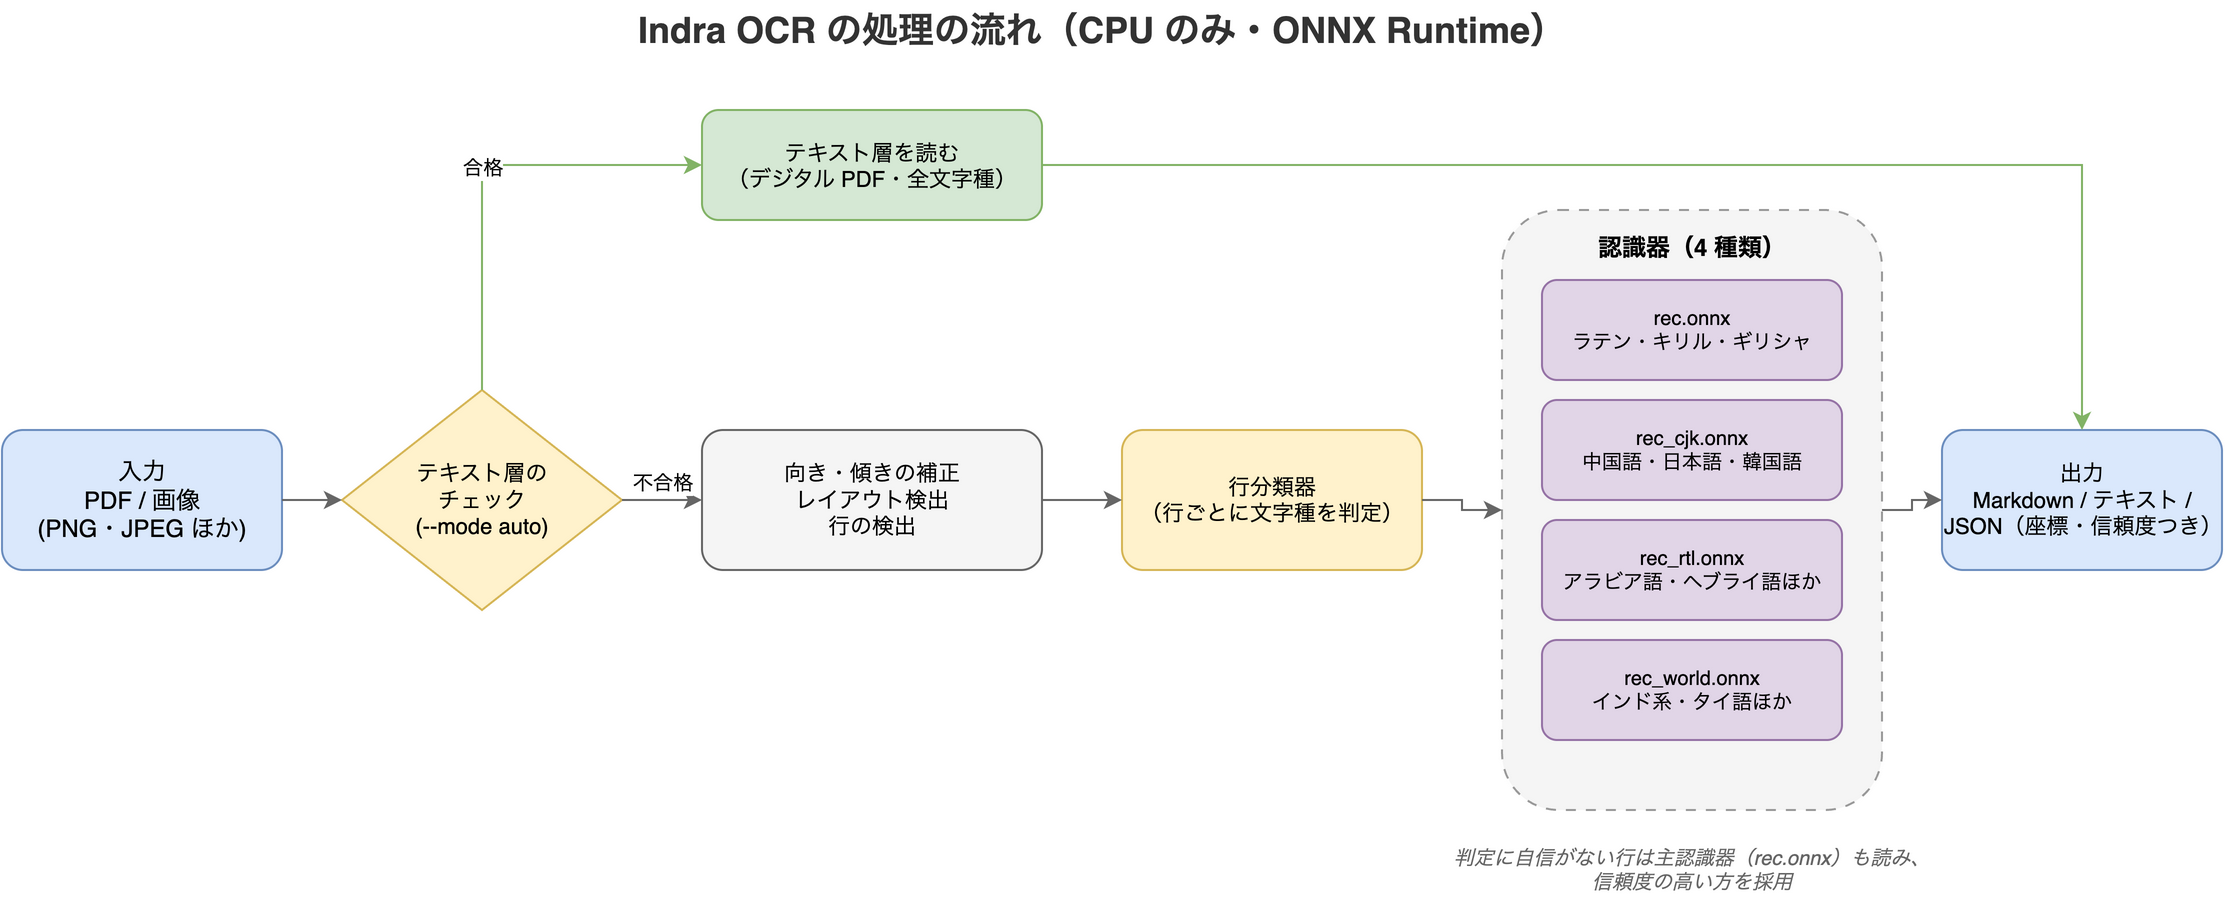
既定の --mode auto は、デジタル PDF のテキスト層がチェックに合格すればそれを読み、合格しない部分だけを OCR します。テキスト層のある PDF なら文字種を問わず読めるので、OCR が必要なのは主にスキャン画像です。
OCR の段階では、検出した行ごとに行分類器が文字種を判定し、4 つの認識器のどれかに送ります。
rec.onnx:ラテン文字(約 50 言語)、キリル文字、ギリシャ文字、ラテン文字の手書きrec_cjk.onnx:中国語(簡体・繁体)、日本語(かな・漢字)、韓国語rec_rtl.onnx:アラビア語、ペルシャ語、ウルドゥー語、ヘブライ語などrec_world.onnx:デーヴァナーガリー(ヒンディー語など)、インド系文字、タイ語、クメール語など
行分類器の判定に自信がない行は主認識器も読み、信頼度の高い方の結果を採用します。
インストールと使い方
CLI
pip install indra-ocr初回実行時にモデルがダウンロードされます。次の例のファイル名は、手元のものに置き換えてください。
indra-ocr paper.pdf                    # Markdown を標準出力へ
indra-ocr *.pdf --out results/         # 入力ごとに .md を出力、全コアを使用
indra-ocr scan.png --format json       # 行・座標・レイアウトブロック・信頼度
indra-ocr paper.pdf --mode ocr         # テキスト層を無視して全ページ OCR
indra-ocr paper.pdf --math             # 数式を LaTeX で出力(既定は無効)

indra-ocr-viewer                       # http://localhost:8765 でローカルビューア
主なオプションは次のとおりです。
--format [md|text|json]:出力形式(既定はmd)--mode [auto|ocr|text]:テキスト層の使い方。autoはチェックに合格したテキスト層を読み残りを OCR(既定)、ocrは常に OCR、textはチェックに落ちてもテキスト層を使う--cores N:使用するコア数(既定は使えるコアすべて)--dpi N:PDF をレンダリングする解像度(既定は 200)--keep-furniture:ページヘッダー・フッターを Markdown に残す
indra-ocr-viewer を起動すると、ブラウザに PDF や画像をドロップするだけで、検出した行・レイアウトブロック・読み順を元のページに重ねて確認できます。ファイルが手元のマシンから出ることはありません。
Python から使う
import indra_ocr

conv = indra_ocr.load(threads=4)          # mode="auto" | "ocr" | "text"
for i, page in conv.convert("paper.pdf"):
    print(page.source, page.timings["total_ms"])
    print(page.markdown)                  # 見出し・リスト・表(HTML)
    # page.blocks : [{"label", "bbox", "text"}] 読み順
# page.lines : [Line(box, text, conf)] 読み順大量のファイルを処理するときは、convert_many を使うとコアごとにワーカープロセスを立てて並列に処理できます。macOS と Windows では if __name__ == "__main__": ガードが必要です。
import indra_ocr

if __name__ == "__main__":
    for path, result in indra_ocr.convert_many(["a.pdf", "b.pdf"], cores=None):  # None で全コア
        if isinstance(result, indra_ocr.InputError):
            continue                      # 読めない・ロックされたファイル
        for i, page in result:
            print(path, i, page.source)
各ページの Page オブジェクトには、Markdown とテキストのほかに、行単位の座標(lines)、レイアウトブロック(blocks)、回転・傾きの補正量、縦書きかどうか(vertical)、工程ごとの処理時間(timings)が入っています。
ベンチマーク
README には、Datalab 自身が公開しているベンチマーク OmniParseBench(2,937 ページ、16,288 件の合否テスト)での結果が載っています。どれも x86・4 vCPU・1 ページずつという同じ条件での計測です。
| エンジン | 総合 | テキスト | 表 | レイアウト | 1 ページの処理時間(中央値) |
|---|---|---|---|---|---|
| Indra OCR(auto) | 66.7 | 46.7 | 61.1 | 92.2 | 212 ms |
Indra OCR --math(auto) | 71.4 | 62.7 | 59.6 | 92.0 | 357 ms |
| PaddleOCR PP-StructureV3 | 58.4 | 55.6 | 47.8 | 71.7 | 40,958 ms |
| Tesseract 5 | – | 19.3 | 0.0 | – | 5,496 ms |
「–」は該当するスコアがないことを示します。Tesseract は行単位のテキストしか出力しないため、表のスコアが 0 になり、レイアウトは採点対象外です。
スループット(AMD EPYC 9004、OCR モード)は次のとおりです。
| エンジン(ページ/秒) | 4 コア | 8 コア | 16 コア | 32 コア |
|---|---|---|---|---|
| Indra OCR | 6.2 | 11.9 | 23.7 | 43.9 |
| PaddleOCR PP-OCRv6 small(テキストモデルのみ) | 0.65 | 1.24 | 2.42 | 4.28 |
| Tesseract 5 | 0.78 | 1.37 | 2.27 | 2.92 |
「毎秒 44 ページ」は 32 コアでの数字です。4 vCPU の x86 環境では、1 ページあたりの中央値が約 210 ms です(README によれば、同じコードでも実行ごとに 15% 程度ぶれます)。
なお --math なしの場合、テキストのスコアは PP-StructureV3 の方が上です。ただし処理時間は Indra OCR の約 190 倍かかります。
ベンチマークは開発元自身によるものなので、自分の文書で試してから判断するのが確実です。
日本語での実力
日本語の OCR は rec_cjk.onnx が受け持ちます。縦書きの中国語・日本語のページは 90 度回転させてから読むため、縦の 1 列が 1 行として認識器に送られます。
OmniParseBench の文字種別スコアは、日本語(かな)が 57.9、中国語が 64.0、韓国語が 79.2 です。ただし日本語のテストは 19 件しかなく、1 件で数ポイント動く程度の参考値にすぎません。
README の制約事項には、縦書きについて次の注意があります。
- 縦書きのスキャンは横書きより精度が落ちる
- 記事が段をまたいで蛇行する新聞のような紙面では、記事の順序が崩れることがある
StudioYebisu 氏も「若干縦書き弱い」と書いています。請求書や見積書のような横書きの帳票が、いちばん相性のよい用途でしょう。
苦手な文書
README は、次の文書には向かないと明記しています。
- 複雑な表:結合セル、セル内での折り返し、入れ子の見出し、罫線のない表は、セルが別の行や列にずれることがある。単純な格子状の表なら問題なく読める
- 手書き:読めはするが、OmniParseBench の手書きテストのスコアは 25.2。筆記体や薄い鉛筆書きが特に弱い
- 劣化したスキャン:古い・かすれた・低解像度のスキャンのスコアは 29.5
- 対象外の文字種:シリア文字、チベット文字、モンゴル文字などは、デジタル PDF のテキスト層からしか読めない
こうした文書について Datalab は、同社の高精度モデル Chandra を使うマネージドサービスを案内しています。Indra OCR は「きれいな印刷物を速く読む」ことに特化したモデル、と位置づけるのが妥当です。
ライセンスに注意:Apache 2.0 なのはコードだけ
StudioYebisu 氏の投稿には「Apache 2.0」とありますが、Apache 2.0 なのはコードだけです。モデルの重みには、修正版の OpenRAIL-M ライセンスが適用されます。
README の「Commercial usage」によると、重みを無償で使えるのは次のケースです。
- 研究目的
- 個人利用
- 調達額または売上が 2,000 万ドル未満のスタートアップ
さらに、Datalab の API と競合する用途には使えません。この条件を外したい場合や、より広い商用ライセンスが必要な場合は、Datalab の料金ページから問い合わせられます。
注意したいのは、2,000 万ドルの基準を判定する対象が利用者本人だけではない点です。LICENSE では、本人・雇用主・関連組織のいずれかが、前年の売上高か累計の調達額のどちらかで 2,000 万ドルを超えていれば、個人利用・研究目的を除いて利用できないとしています。会社の業務で請求書を大量に処理する場合、組織の規模によってはそのままでは使えません。業務で導入する前に、Hugging Face の LICENSE を必ず読んでください。
LLM の前処理として使う
PDF や画像をそのままマルチモーダル LLM に渡すと、画像トークンのコストがかかります。ページ数が多ければ、その分だけ費用も時間も膨らみます。CPU で動く軽量な OCR で先にテキスト化しておけば、LLM には Markdown だけを渡せます。
- トークンの節約:画像ではなくテキストを渡すので入力が小さくなる
- 検索インデックス:RAG やフルテキスト検索の取り込みに、そのまま Markdown を使える
- データを手元に置ける:OCR の段階では文書を外部に送らずに済む
- 座標の追跡:JSON 出力の
bboxを使えば、抽出した値が元ページのどこにあったかを示せる
一方で、表が崩れやすい・手書きに弱いといった制約は、そのまま LLM の入力品質に響きます。対象の文書を少量で試し、indra-ocr-viewer で行とブロックの検出結果を目で確認してから、パイプラインに組み込むのがよいでしょう。
まとめ
- Indra OCR は、主認識器が公称 100 万(実際は約 125 万)パラメータという小さな OCR モデルで、GPU なしの CPU だけで動く
- 32 コアで毎秒約 44 ページ、4 vCPU でも 1 ページ約 210 ms。開発元のベンチマークでは Tesseract より速く、精度も高い
- 日本語(縦書きを含む)に対応する。ただし縦書きは横書きより弱く、複雑な表・手書き・劣化スキャンも苦手
- コードは Apache 2.0 だが、モデルの重みは修正版 OpenRAIL-M。商用利用には条件がある
- LLM に読ませる前のテキスト化に使えば、トークンを節約できて文書も手元に置ける