mizchi さんが 2026/10/05 に Zenn で公開した 俺のAIプログラミング手法(2026/10/05) は、本人いわく「棚卸し的な記事」です。X では、読んだ人が「すごい、全然追いつけてない」という感想を添えて共有していました。
箇条書き中心の短い記事ですが、AI コーディングエージェントとの付き合い方が一貫した方針でまとまっています。軸になっているのは次の 3 点です。
- 人間はコードを書く人から、ループと評価指標を設計する人になる
- 数値化できる完了条件があれば、その仕事は AI に回せる
- 仕様そのものが正しいかは形式手法で検査する
この記事では、原文の構成に沿って要点を整理します。原文にない筆者の補足は「補足すると」で始めて区別します。引用しているプロンプト例やツールは原文のものです。
人間の役割を定義する
最初に、人間がやるべき仕事が 5 つ挙げられています。
| 役割 | 中身 |
|---|---|
| モデルの性能を評価する | 無茶振りしてどこまでできるか観察する。何ができて何ができなかったかがドメイン知識になる |
| ループを構築する | 自動化して得られた時間で、評価指標を改善する |
| 評価指標を作る | どの数値を改善すべきか、トレードオフで何を優先すべきかを決める |
| ループのイテレーションを評価する | AI の行動ログを観察して、評価指標を正しく追えているかを見る |
| テストと CI をチューニングする | 評価指標が増えるほど CI は長くなる。何を優先し、何をやらないかを明確にする |
コードを書く作業そのものは表に入っていません。人間の仕事は、AI が回すループの「外側」を作ることに移っています。
仕事を AI に渡すときの考える順番
ある仕事を AI に任せるかどうかは、次の順番で考えるとされています。全体の流れを図にすると次のとおりです。
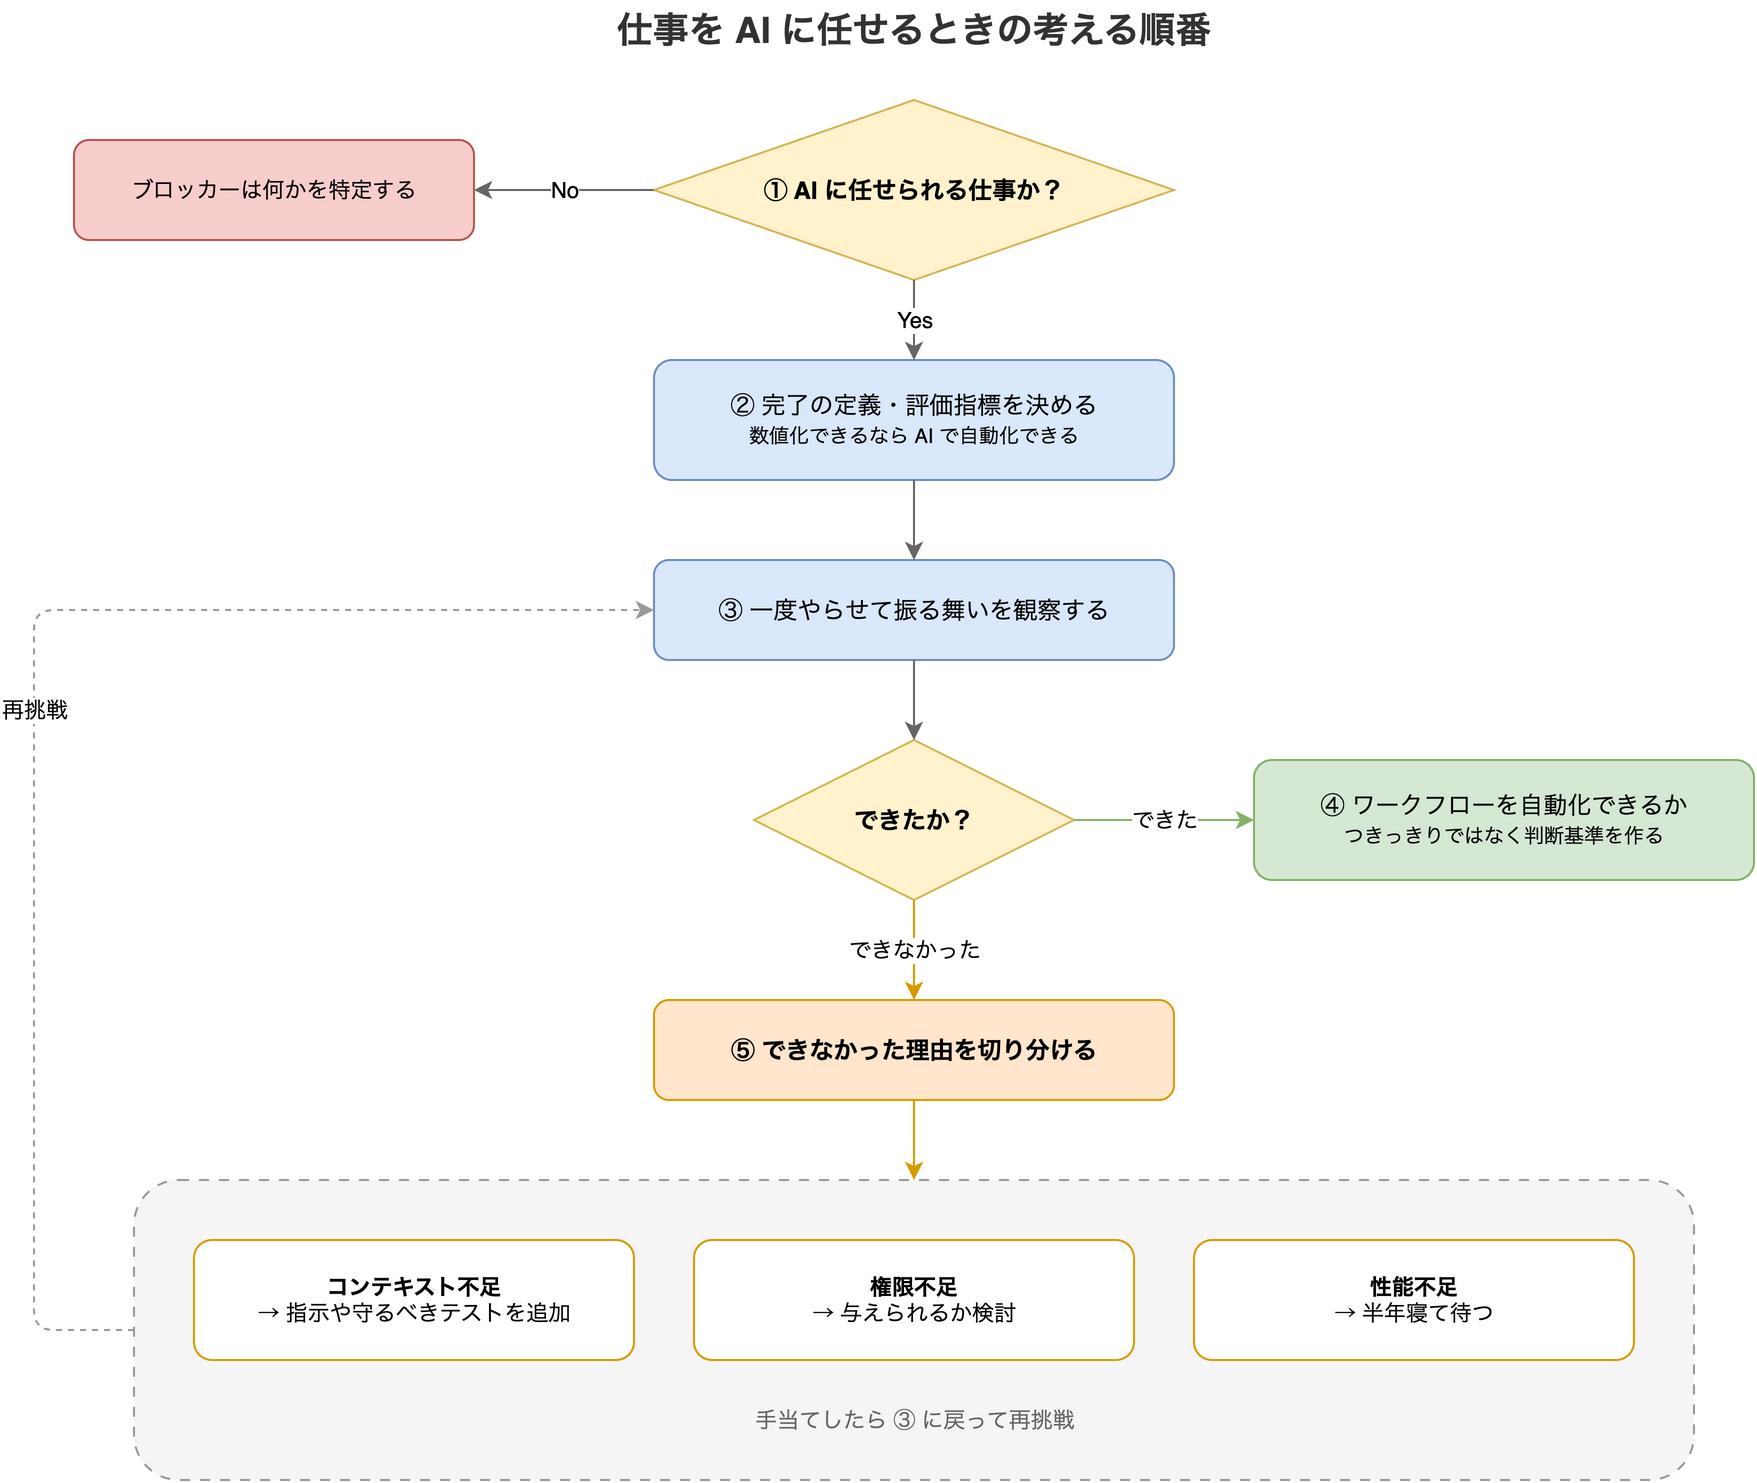
- これは AI に任せられる仕事か — 任せられないなら、そのブロッカーは何か
- この仕事の完了の定義・評価指標は何か — 数値化できるものなら AI で自動化できる
- AI に指示して、一度やらせてみる — まずやらせて、どう振る舞うかを観察する
4 と 5 は、3 の結果による分岐です。
- できたとき、このワークフローは自動化できるか — 人間がつきっきりにならず、判断基準そのものを作れるか
- できなかったとき、その理由は何か
- コンテキストの不足 → 指示や守るべきテストを追加する
- 権限の不足 → それを与えられるか検討する
- 性能の不足 → 「半年寝て待つ」
補足すると、最後の「半年寝て待つ」という割り切りは実践的です。モデルの性能が原因で失敗しているなら、プロンプトを工夫し続けるより、次のモデルを待ったほうが早い場合があります。失敗をこの 3 種類に切り分けておけば、どこに手を入れるべきかを判断できます。
常にアンラーニングする
この節の主張は「プロンプトは高速に陳腐化する」です。例として挙がっているのは次の 2 つです。
- 「あなたは優秀なプログラマです」
- 「問題に取り組む前に、ゆっくり深呼吸してください」(これで数学の性能が 7 ポイント改善していた)
こうしたプロンプトの小技は「もう古い」とされています。代わりにグローバルプロンプトに書くべきなのは、選択肢が複数あるときの判断基準です。原文の例を挙げます。
- node は 24+ を使う
- 既存プロジェクトの設計は尊重しつつ、新規には npm ではなく pnpm を使う
- nix を使う/使わない
- Rust は stable の 1.99 を使う
- gh stack を使う
ただし、こうした判断基準のような最小限を除けば「基本的には Agents.md のグローバルプロンプトは書かない」という立場です。理由は 2 つ挙げられています。
- 最新モデルに組み込まれている知識は半年ほど古い
- skill の使い方は(おそらく)重点的に学習されているので、skill に書いた指示はすぐに不要になる
補足すると、書くのは「モデルが知らない、または迷う箇所」に絞り、モデルがすでに正しくできることは書かない、という方針と読めます。
世界知識と /compact
モデルに埋め込まれた情報を「世界知識」と呼び、コンテキストウィンドウに与えた情報はそれより優先される、と整理しています。
ここから導かれる実践的な指針が、モデルにとって既知の情報が多くなるように作ることです。よく知られた OSS で構築すれば、モデルは世界知識をそのまま使えるので、結果的に効率よく動きます。
Claude Code の /compact(会話のうち重要な情報だけを残してコンテキストを圧縮するコマンド)については、「正しく判断基準が与えられていないと、間違っている側に倒れる」と注意しています。補足すると、圧縮時に何を残すかもモデルの判断なので、判断基準がなければ重要な制約が落ちることがあります。
既存リポジトリへの適用は「解説させる」から
既存のリポジトリに AI を入れるときは、まず次のように頼みます。
現状の構成を読み取って解説して
自分も速習しつつ、AI の理解と自分の理解がずれていないかを確認する、という使い方です。そのための道具として mizchi/explainer が紹介されています。一般的ではないこだわりや制約は Agents.md に書きます。
ループの基礎 — Ralph Loop と /goal
原始的な Ralph Loop
Ralph Loop は、同じプロンプトでエージェントを何度も起動し直し続ける手法です。いちばん素朴な形がこれです(claude -p は Claude Code を非対話モードで 1 回実行するオプション)。
# the bare idea
while :; do
  claude -p "Git 履歴を見て次にやることを探して"
done
ただの無限ループで、毎回 Git 履歴を見て次にやることを決めさせます。Ctrl+C で止めるまで回り続けて利用量を消費するので、試すときは回数の上限やサンドボックスを用意してください。補足すると、状態は Git に残るので、各イテレーションはまっさらなコンテキストで始まっても前回の続きを拾えます。
/goal
原文では次の使い方が紹介されています。
/goal Issues を全部潰して/goal は Claude Code のスラッシュコマンドで、完了条件を与えると、それを満たすまでエージェントが自律的に作業を続けます。原文では「セッションが終了するたびに『Issues を全部潰して』が再送される」と簡潔に説明されています。公式ドキュメントによると、実際の仕組みは次のとおりです。
- セッション単位の Stop フックとして動く
- Claude がターンを終えるたびに、小型の評価モデルが会話を見て完了条件を満たしたかを判定する
- 未達なら、その理由を手がかりに Claude が作業を続ける
外から何度も叩き直すという発想は Ralph Loop と同じです。ただし Ralph Loop が反復ごとにまっさらなコンテキストで始まるのに対し、/goal は同じセッションの会話を引き継いだまま続きます。
実験的な手法:DSPy の RLM とマルチエージェント
DSPy の RLM(Recursive Language Model) は、ある程度ワークフローが決まっているタスク向けの手法です。巨大なコンテキストを、インタプリターで実行されるコード断片に分解します(DSPy RLM)。
マルチエージェントは「現在、決定的な解がない。難しいなら無理して使わなくていい」という評価です。参考として arXiv:2512.08296 が挙がっています。使うなら次のように頼みます。
今あるタスクから、干渉が少ないものをレーンに分割して、レーンごとにサブエージェントを分割して
探索的改善 — 視点を与えて丸投げする
エージェントを信用して、ある程度丸投げする使い方です。「現状でもかなり賢いので、これでもだいぶ網羅できる」とされています。原文のプロンプト例は次のとおりです。
- 「現在の実装と最新の研究を比較して、参考になるものを列挙して」
- 「SRE 視点でテレメトリを計装して」
- 「テストを壊さない範囲でリファクタリングをして」
- 「データベースに対する N+1 を見つけて潰して」
- 「セキュリティ視点で攻撃側としてチェックリストを作り、localhost に閉じてペネトレーションして」
ポイントは視点を与えることです。誰にとってどの数値が大事なのかが、どう改善するかの理由になります。自信がないときは Docker や適切なサンドボックスで実行します。
見つかった問題は「一旦見つかったものは Umbrella Issue でまとめて」と頼んで、1 つの Umbrella Issue(関連する Issue を束ねる親 Issue)に集約します。その Issue を /goal に渡せば、上から順に片付けてくれる、という流れです。探索 → 集約 → ループ実行がつながります。
レビューについては、自分が専門の範囲は自分で精査し、専門外の範囲はレビューを投げます。そのために、メンテナーの人格や好き嫌いを調べて追従するスキル maintainer-persona を作ったそうです。
/goal と一緒に使う評価指標
ループを回すには、完了を判定する数値が必要です。原文で挙がっている指標を整理します。
| 種類 | 指標・ツール |
|---|---|
| パフォーマンス | CI では安定しないので、RSS(メモリ使用量)や Fuel など決定的な指標を優先。計測ツールとして hyperfine・perf・Valgrind |
| 静的解析 | 厳しいルールの lint warning 数、循環複雑度など(moznion/cccc)、コード重複率(mizchi/similarity) |
| テスト | ミューテーションテストの Kill 率、VRT(ビジュアルリグレッションテスト)の一致率 |
原文の結論は「具体的な数値に落とせるものが望ましい。主観的な判断が必要だと、ユーザーが都度呼び出される」です。数値で判定できない完了条件は、ループのたびに人間を呼び出すことになり、自動化の効果が出ません。
補足すると、実行時間のベンチマークは CI 環境の揺らぎで値がぶれるので、そのままではループの停止条件に向きません。hyperfine は実時間を測るツールなので、停止条件には命令数(Valgrind での計測や Fuel)のような決定的な値や、メモリ使用量のように揺らぎの小さい値を組み合わせるのが安全です。停止判定をノイズで誤らせないための工夫です。停止条件と収束の関係は 停止条件は測れても収束しない — AIエージェントのループ設計と「不動点」 でも扱いました。
AI が書いたコードの何を理解するか
AI が書いたコードをすべて読むのは「とてもじゃないが間に合わない」と書かれています。それでも、せめて振る舞いは把握したい、という問題意識です。把握する対象として挙がっているのは次の 3 つです。
- E2E のケース名
- テストコード
- 関数シグネチャ
さらに、スキルを使って AI にコードを概念的に解説させます。紹介されているのは eli5 と mizchi/explainer で、たとえば次のように頼みます。
mizchi/explainer で作った説明画像を gh —attach で添付して PR を作って
GitHub CLI の --attach フラグについては gihyo.jp の記事 が参照されています。
実験的:マージを自動化したい
OpenAI では AI がトリアージして、ある程度マージを自動化しているらしい、という話が紹介されています。
- 安全なコードは AI がそのままマージする
- 危険なコード(DB スキーマ変更や Terraform の変更など)は人間にエスカレートする
mizchi さん自身も、これをやるレビューツールを作っているところだそうです。
形式手法 — 仕様そのものを検査する
記事の後半の柱が形式手法です。テストは「実装が仕様どおりか」を確かめますが、形式手法はそもそも実装しようとしている仕様が合っているかを、依存型や時相論理といった強い型で検査します。
- 実現できない、存在しようがないものを作ろうとしていないか
- 最適化に使うアルゴリズムが正しいか
ただし、自然言語がそのまま形式仕様に落とせるわけではなく、その「性質」を記述するイメージだと補足されています。
道具の使い分けは次のとおりです。
| 対象 | ツール |
|---|---|
| マイクロサービスやマルチスレッドのキャッシュ制御(経験的にほぼ確実に漏れがある) | TLA+ か Quint |
| 述語論理で書ける制約 | Z3 |
| アルゴリズム自体の開発 | Lean |
| ユーザー権限まわり | Alloy |
「困ったら Z3 か TLA+ を使っておくとよい」とも書かれています。
形式仕様をループに組み込むプロンプト
原文の実例は、形式仕様を「テストオラクル」として使うものです。
- 「今あるコードを形式化できる部分を形式化して、それをテストオラクルに、実装がそれに従ってるか確認して」
- 「モデル検査で反例が出たら、それを実際のテストケースに落として」
- 「何を検査したか、ドメインの言葉を使わずに例え話で説明して」
補足すると、モデル検査器が出した反例をテストケースに変換すれば、形式手法の成果が通常の CI に残ります。最後のプロンプトは、人間が検査内容を理解するためのものです。前述の「何を理解するか」の話ともつながります。
使っている仕様化スキルとして formal-methods-reconciler が公開されています。
これらのプロンプトを実際に Claude Code に渡し、Z3 と TLA+ で仕様を検査した結果は、続編の 形式手法を Claude Code で回す — Z3 と TLA+ で仕様の穴を見つけ、反例をテストに落とす にまとめました。
まとめ
記事は「またすぐ変わると思います」で締めくくられています。紹介されている個々のツールやプロンプトは、半年もすれば入れ替わるかもしれません。それでも、次の骨格は当面変わらないと思います。
- 人間は評価指標とループを設計し、ループのログを評価する
- 完了条件を数値に落とせれば AI に回せる。落とせなければ人間が呼ばれ続ける
- 失敗はコンテキスト・権限・性能に切り分ける
- グローバルプロンプトには小技ではなく判断基準を書く
- 実装の正しさはテストで、仕様の正しさは形式手法で検査する
特に「評価指標を数値にする」と「反例をテストケースに落とす」の 2 つは、規模を問わず今日から試せます。
個々のツールやプロンプト例の詳細は、原文を参照してください。