停止条件を書いたのに、ループが収束しない
「エージェントにプロンプトを打つのではなく、ループを設計する」という言い方は、2026年半ばのAnthropic公式ガイドを境に一気に広まった。4つの型(Turn / Goal / Time / Proactive)も、停止条件を書けという原則も、いまや一通り流通している。型の整理そのものは以前にClaude Codeチーム公式ガイド「ループ設計」を読み解くで扱ったので、ここでは繰り返さない。
本記事が扱うのはその次の問題だ。停止条件を書いたのに、ループが収束しない。
具体例がある。GMOペパボのあたに氏は、Claude Codeで6人の専門レビュアーを並列に走らせた。停止条件は「指摘がゼロになるまで」。記事のタイトルがそのまま結論になっている——「指摘ゼロになるまで回すレビューループ」を組んだが、ゼロにならなかった。停止条件は明確だった。件数はちゃんと数えられた。それでもゼロには到達しなかった。
なぜか。停止条件が「測れる」ことと、ループが「収束する」ことは、別の話だからだ。
3つの壊れ方 — 見取り図
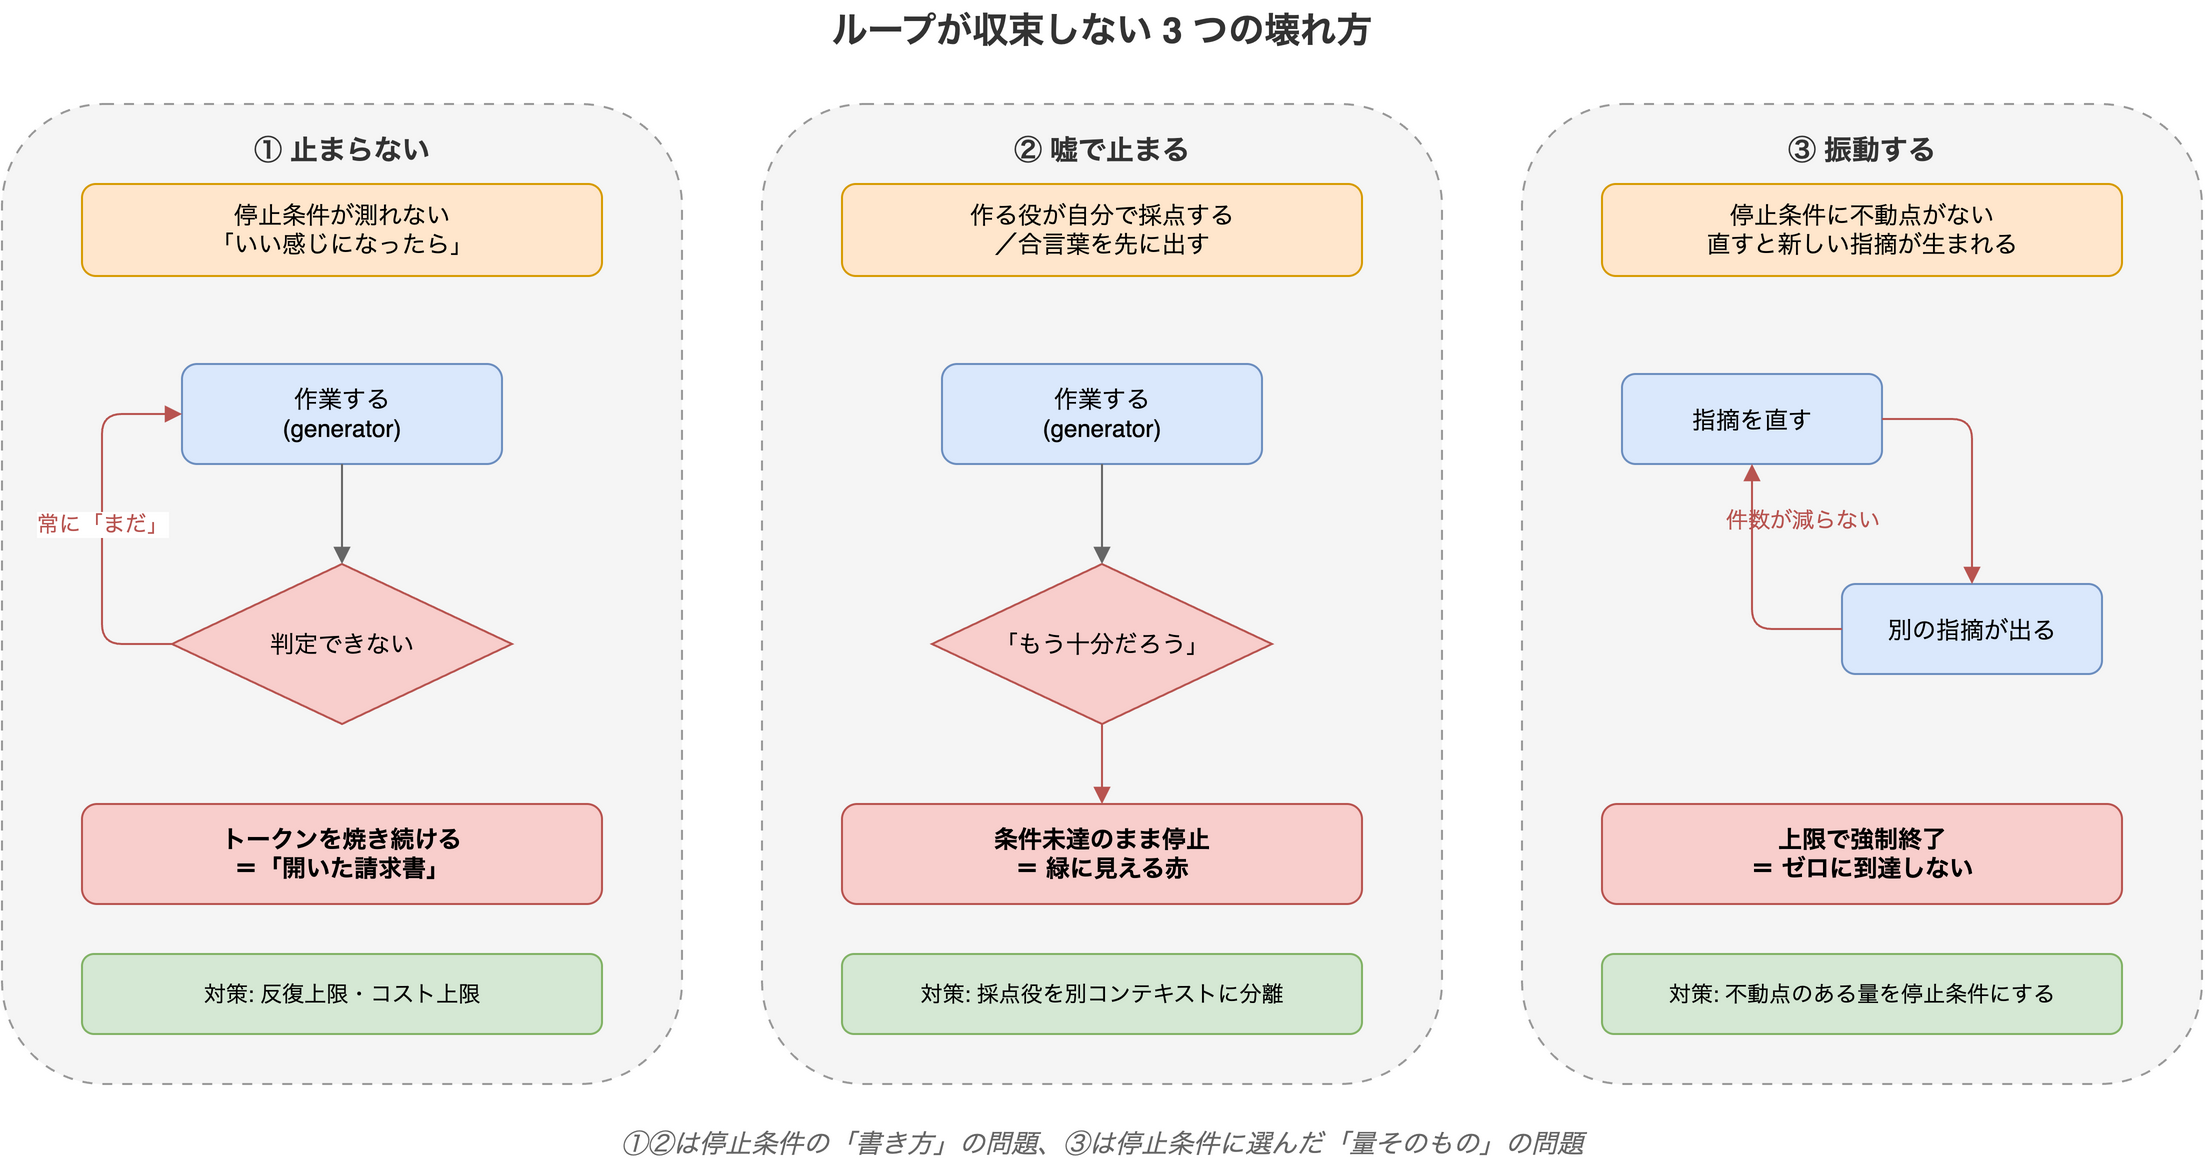
収束しないループは、見た目の症状こそ違うが、原因で分けると3つに落ちる。
| 壊れ方 | 症状 | 原因 |
|---|---|---|
| ① 止まらない | 反復上限に達するまで回り続ける | 停止条件を機械が判定できない |
| ② 嘘で止まる | 条件未達なのに「完了」と報告される | 作る役が自分で採点している |
| ③ 振動する | 直すたびに新しい指摘が出て件数が減らない | 停止条件に選んだ量に不動点がない |
③の「不動点」は本記事の中心概念で、後半で定義する。さしあたり「もう1周かけても状態が変わらない点」と読んでおけばいい。
①と②は停止条件の書き方の問題で、対処法はよく知られている。厄介なのは③で、これは停止条件に選んだ量そのものの性質に起因する。書き方をいくら磨いても直らない。順に見ていく。
① 止まらない — 判定器がYes/Noを返せない
一番素朴な失敗がこれだ。「いい感じになったら終わり」「たぶん大丈夫そうなら」といった停止条件は、判定する側が何を根拠に差し戻せばいいか分からない。結果、永遠に回るか、根拠なく止まる。
Anthropicの公式ガイドがLighthouseスコアを例に使うのは、これが数字で測れるからだ。
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries.90 or above は機械的にYes/Noを返せる。stop after 5 tries は、それでも到達しなかったときの脱出口だ。
Ralph Wiggum(Anthropic公式プラグイン ralph-wiggum)はこれをさらに極端にしていて、完了判定を合言葉の完全一致で行う。stop-hook.sh はワイルドカード照合ではなく文字列リテラルの比較で、<promise> タグの中身が --completion-promise に渡した文字列と一字一句同じかだけを見る。
/ralph-loop "ToDo の REST API を作る。要件: CRUD 4 操作・入力バリデーション・テスト。
             すべて満たしたら <promise>COMPLETE</promise> と出力する。" \
            --completion-promise "COMPLETE" \
            --max-iterations 50
判定を文字列一致まで落とすと、判定器の曖昧さはゼロになる。代償として、合言葉を出す判断そのものがモデルに委ねられる——これが次の②だ。
なお合言葉と反復上限のどちらも設定しないと、Ralphは文字どおり無限に走る。セットアップスクリプトも起動時に「このループは手動では止められない、--max-iterations か --completion-promise を設定しない限り無限に走る」と警告を出す。反復上限とコスト上限は、収束設計の一部というより、収束に失敗したときの火災報知器だと思ったほうがいい。
② 嘘で止まる — 作る役に自分を採点させない
長く回していると、エージェントが「もう十分だろう」と判断して、条件を満たしていないのに合言葉を出してしまう。Ralphの公式コマンド定義には、これを明確に禁じる文言が入っている。
完了の合言葉は、その記述が完全かつ疑いなく真であるときにのみ出力してよい。詰まったと思っても、抜けるために嘘をついてはならない。
ただ、プロンプトで禁じるのは最後の防波堤であって、構造的な対策ではない。構造側の答えが、Anthropicの公式ガイドが繰り返すgeneratorとevaluatorの分離だ。作業するモデル(generator)とは別に、停止条件だけを見る採点役(evaluator)を立て、generatorが「終わった」と言うたびに検算させる。ここまで「判定器」と呼んできたものが、この採点役にあたる。
分ける理由ははっきりしている。自分の成果を自分で採点させると、バグを生んだ盲点をそのまま引きずって甘い自己評価が通る。新しいコンテキストで立ち上げた採点役は、生成時の推論に引きずられない。
ペパボの事例では、6人のレビュアーが出した指摘をもう一段別のClaude Codeエージェントに渡し、コードベースの文脈に照らして妥当性を判定させている。妥当性が低いと判定された指摘は削除するか info レベルに降格する。
ただし同記事は、その効き目についてかなり抑制的に書いている。検証用エージェントが誤って妥当な指摘を却下するリスクは常にある。AI同士の判断が一致したからといって正しいとも限らない。「フィルタとしてある程度機能する」くらいの期待値で使っている、としている。分離は自己採点バイアスを断つが、正しさを保証はしない。
③ 振動する — 停止条件に選んだ量に不動点がない
①も②も潰した。停止条件は数えられる。採点役も分離した。それでもペパボの「指摘ゼロ」は達成されなかった。
同記事はその機構を明示している。AIが修正した箇所に対して別のAIが新しい指摘を出し、それを直すとまた別の指摘が出る、という無限ループが起きうる。
これは判定が甘いのでも、プロンプトが下手なのでもない。「指摘ゼロ」という状態が、もう1周回すと維持されないのだ。
不動点という判別軸
ループの1周を「いまの状態を受け取って次の状態を返す関数」と見ると、収束とは不動点(fixed point、もう1周かけても状態が変わらない点)に到達することだ。停止条件を選ぶときの本当の問いは「測れるか」ではなく、「その条件を満たした状態にもう1周かけて、条件は満たされたままか」になる。
- テストが全て緑:緑の状態でもう1周回しても、直すべきものがないので何も変わらない。緑のまま。不動点がある
- 型エラー0件:同上。不動点がある
- Lighthouse ≥ 90:90を超えた状態で手を加えなければスコアは変わらない。閾値なので不動点がある
- レビュー指摘ゼロ:指摘ゼロの状態でもう1周レビューを回すと、新しい指摘が出る。不動点がない
最後の1行が、ペパボの記事のタイトルの正体だ。
なぜレビュー指摘には不動点がないのか
理由は2つある。
判定器が非決定的だから。 テストランナーは同じコードに同じ結果を返す。LLMレビュアーは返さない。指摘ゼロの状態にもう一度レビューをかければ、前回は出なかった観点が出る。ペパボの実測では、指摘の内訳は有用が約4割、ノイズが約3割、的外れが約2割、意外な発見が約1割だった。ノイズと的外れでちょうど半分を占める。件数ゼロを狙うとは、非決定的に湧き出るノイズがたまたま1件も出ない周を待つということだ。
判定器の出力が、次の修正の入力になっているから。 指摘 → 修正 → その修正が新しい指摘の対象になる、というフィードバックが閉じている。修正が状態を動かし、動いた状態が新しい判定を呼ぶ。これは制御系で言えば、ゲインが高すぎて発振している状態に近い。
つまり収束は、次の3つを全部満たしたときにだけ期待できる。
- 判定器は決定的か(同じ入力に同じ答えを返すか)
- 判定器の出力が、次の修正の入力になっていないか
- 条件を満たした状態にもう1周かけても、条件は満たされたままか
LLMを判定器に据えた時点で1が崩れる。レビューのように「直した箇所がそのまま次の観測対象になる」タスクでは2も崩れる。
非決定的な判定器しか使えないときの逃げ道
成否を機械的に測れないタスク——レビュー品質、文章品質、翻訳——では、判定器をLLMにするしかない。そのときの選択肢は3つある。
(a)決定的な代理指標に翻訳する。 「良いドキュメントになったら」を、用語集との突き合わせ、見出し数の充足、リンク切れゼロ、といった測れる量に置き換える。停止条件が本来測りたいものとズレる代わりに、不動点が手に入る。
(b)量を変えて不動点を作る。 「指摘ゼロ」ではなく「差分が変化しなくなった」を停止条件にする。同じ入力に対して修正が生まれなくなった状態は、判定器が非決定的でも不動点になりうる。
# 前周から差分が出なくなったら完了の合言葉を出す、という素朴な収束判定
# HEAD@{1} は reflog 依存なので、各周で必ず1コミットし、
# ループ外で HEAD を動かさないことが前提になる
git diff --quiet HEAD@{1} HEAD && echo "<promise>STABLE</promise>"
(c)収束を諦めて、上限と残件リストにする。 ペパボが実際に選んだのがこれだ。5ラウンドで強制終了し、収束しなかった場合は残りの指摘をリストにして人間に報告する。
(c) を「妥協」と読むと本質を外す。収束しない量を停止条件に選んだ以上、ループの成果物は「ゼロになった」ではなく「N周回した結果、残ったのはこれ」になる。これは設計上の正しい出力であって、失敗ではない。
収束しないと分かっているループに、何を持たせるか
ここまでの整理を踏まえると、③のタイプのループに必要なのは収束条件ではなく、止め際の設計だということになる。ペパボが入れた安全弁は、そのまま実務のチェックリストとして使える。
- 関係ないリファクタはしない。指摘された箇所だけを最小限に修正する
- 設計判断が必要な指摘は修正しない。人間に判断を委ねて報告だけする
- テスト失敗は最大3回リトライ。3回連続で失敗したら中断して報告する
- 20ファイルを超えるスコープは中断。影響範囲が大きすぎる修正は人間に委ねる
- 5ラウンドで強制終了。収束しない場合は残りの指摘をリストにして報告する
注目したいのは、これらが全部「どこで人間に返すか」の線引きだという点だ。同記事も、6人のレビュアーの並列実行そのものより、この安全弁の設計と「どの指摘を人間に返すか」の判断基準のほうに一番時間を使った、と書いている。
ループ設計の難所は、回す仕掛けではなく、回すのをやめて人間に戻す境界のほうにある。
周をまたいで収束させる — 失敗の記録とCLAUDE.md
(a)(b)(c) はどれも1周の中で完結する選択肢だった。もう一つ、スケールを変えるという手がある。実質は (b) の「量を変えて不動点を作る」を、セッションの外側でやることだ。収束させる対象を、1周の中の指摘件数から、周をまたいだ同じ失敗の再発回数に移す。
合同会社playparkの記事は、この視点をはっきり打ち出している。LLMエージェントは推論時の自己修正(self-correction)は持つが、セッションをまたいだ記憶は持たない。前回の失敗を「覚えて」はいないし、重みも変わらない。だから避けられた失敗も翌日には再発する——これも「再発回数」という量に不動点がない状態だ。
対策として同記事が提示するのは、失敗を外部ストレージに記録し、パターンを抽出し、設定ファイルを書き換えるサイクルだ。実装例では各スキルが実行ログを構造化JSONで ~/.claude/journal/ に書き出し、8つの軸(同じエラーの2回以上の再発、SKILL.mdの記述漏れ、など)でパターンを検出する。優先順位はスコアの掛け算で決める。
pattern_score = frequency * impact * preventabilityfrequency は発生回数、impact は重大度、preventability は対処可能性(記述なし=3、部分的=2、対処済み=1)。スコア9以上は即座に修正提案、4未満は放置。掛け算にすることで、頻度が低くても重大で防げるものが強制的に浮上する。
ここで収束の対象が入れ替わっていることに注意したい。同じエラーの再発回数は、対策を設定ファイルに書けば実際に減る。減ったまま戻らない。つまりこの量には不動点がある。1周の中では収束しなかったループが、周をまたいだスケールでは収束しうる、ということだ。
同記事の実測でも、上位パターンは npm ci 漏れ(env系、5回、スコア45)、Biomeのformatエラー(lint系、8回、スコア8)などで、修正済みSKILL.mdを反映した3週目以降に上位2件がほぼ消え、ヘルススコアが64→82に上昇したと報告されている。
そして、これは専用ツールがなくても始められる。同記事が「最小構成」として挙げているのは、CLAUDE.mdへの3行だ。
## エラー記録ルール

- エラーが発生したら `errors.md` に「日付 / カテゴリ(lint|test|env|config) / 内容 / 対処」を追記すること
- 同じカテゴリのエラーが3回記録されていたら、このCLAUDE.mdに再発防止策を追記すること
- セッション終了時に errors.md を確認し、未対処のパターンがあれば報告すること
記録 → 検出 → 改善。掛け算のスコアリングも8軸の分析も、この3行の延長線上にある。
まとめ
「ループを設計する」の実体は、停止条件を書くことではなく、収束する停止条件を選ぶことだった。
壊れ方の分類
- ①止まらない・②嘘で止まるは、停止条件の書き方で潰せる。反復上限と、採点役の分離。残るのは③だけだ
判別軸
- 停止条件が「測れる」ことと、ループが「収束する」ことは別の話だ。件数は数えられても、ゼロに収束するとは限らない
- 判別軸は不動点にある。条件を満たした状態にもう1周かけても条件が満たされたままなら収束し、新しい違反が湧くなら振動する
打ち手
- LLMを判定器に据えると、判定が非決定的になり不動点が消える。決定的な代理指標に翻訳するか、「差分が変化しない」のような別の量に置き換えるか、収束を諦めて上限+残件リストにするかの3択になる
- 収束しないと分かっているループに要るのは収束条件ではなく止め際の設計だ。スコープ上限・リトライ上限・ラウンド上限・人間へのエスカレーション基準
- 1周で収束しないなら、収束の対象を「同じ失敗の再発回数」に移す。こちらには不動点がある
ループは賢さを生む魔法ではなく、人間が「何をもって完了とするか」に込めた判断を増幅する装置だ。増幅器に不動点のない量を入れれば、増幅されるのは振動になる。回す前に、その量にもう1周かけたらどうなるかを一度考えておきたい。
参考リンク
- Claude Codeで「指摘ゼロになるまで回すレビューループ」を組んだが、ゼロにならなかった — GMOペパボ / あたに氏
- Claude Codeのループ設計入門|プロンプトをやめて自走させる4つの型と停止条件 — AI Heartland(Anthropic公式ガイド「Getting started with loops」の解説)
- AIエージェントが同じミスを繰り返さない3つの設計パターン — 合同会社playpark
- 1回で終わらないタスクを「完了まで」自走させる ─ Claude Code Ralph Wiggum ループ入門 — パイソンエンジニア部