AI にコードを書かせるようになってから、「念のため」の分岐や設定項目が増えていないでしょうか。SRE のじょーしさん(@paper2parasol)は、次のように投稿しています。
AIでオーバーエンジニアリングしやすくなってしまった今だからこそ、より重要だと思うんよなあ
「エッジケースだから、許容してシンプルに保つ」判断ができず、安全側に倒れて少しずつ複雑になること増えているかもな〜
この投稿が引用しているのは、リクルートの 2026 年度エンジニアコース新人研修の講義資料 「事業価値と Engineering 2026年度版」(黒田 樹さん)です。本記事では、この資料のうちオーバーエンジニアリングを扱ったスライド(22〜23 枚目)を中心に整理します。テーマは、AI 時代に「作らない判断」をどう下すかです。
結論から言えば、エッジケースは「インパクト × 発生確率」で見積もり、小さければ許容してシンプルに保ちます。
オーバーエンジニアリングは「期待値の見誤り」から起きる
資料はオーバーエンジニアリングの典型を 4 つ挙げ、それぞれの裏にある錯覚を対にしています。
| よくあるオーバーエンジニアリング | 背後にある錯覚 |
|---|---|
| ほぼ存在しないユーザーを想定して、レアケース仕様を大量に増やす | 大きな少数の声が全体だと錯覚 |
| 将来必要かもしれない拡張性を過度に盛り込む | 数年後の拡張性問題が、明日くらいに発生すると錯覚 |
| 全体の性能ネックではない部分を高性能化する | 何でも高性能にすべきという錯覚 |
| 優先度の低いバグを、事業インパクトを見ずにすべて直す | 眼の前で起きたこと全てが大問題だと錯覚 |
2 行目は、いわゆる YAGNI(You Aren’t Gonna Need It)原則が戒めるものと同じです。
資料はさらに、「全ての可能性が全て発生した世界」が多分オーバーエンジニアリングの理論上の最大拡張幅とも言える、と述べています。起こりうるケースすべてに対応したコードが、オーバーエンジニアリングの行き着く最大の姿だということです。筆者の見方では、どの錯覚も「起こりうること」を「起こりやすいこと」と取り違えている点で共通しています。
判断の物差しは「期待値 = インパクト × 発生確率」
錯覚を防ぐものとして資料が挙げるのが「事業理解」です。ただし、ここでいう事業理解は、市場規模や競合を暗記していることでも、P/L や B/S(損益計算書・貸借対照表)の知識でもありません。もっと手前の、次のような現場感で十分だとしています。
- 事象 A が 1 年に 1 度しか起きないことを知っている
- 事象 B が 1% しか起きないことを知っている
- 事象 C が起きたとしても軽微なインパクトであると知っている
この相場観がないと、年 1 回の事象を毎日起きると思い込み、1% を 100% と思い込み、軽微な影響を致命的だと思い込みます。そこで判断の物差しになるのが、資料が示す次の式です。
期待値 = インパクト × 発生確率資料が示すのは式までです。この式を使ってエッジケースへの対応を決める流れを、筆者なりに図にすると次のようになります。
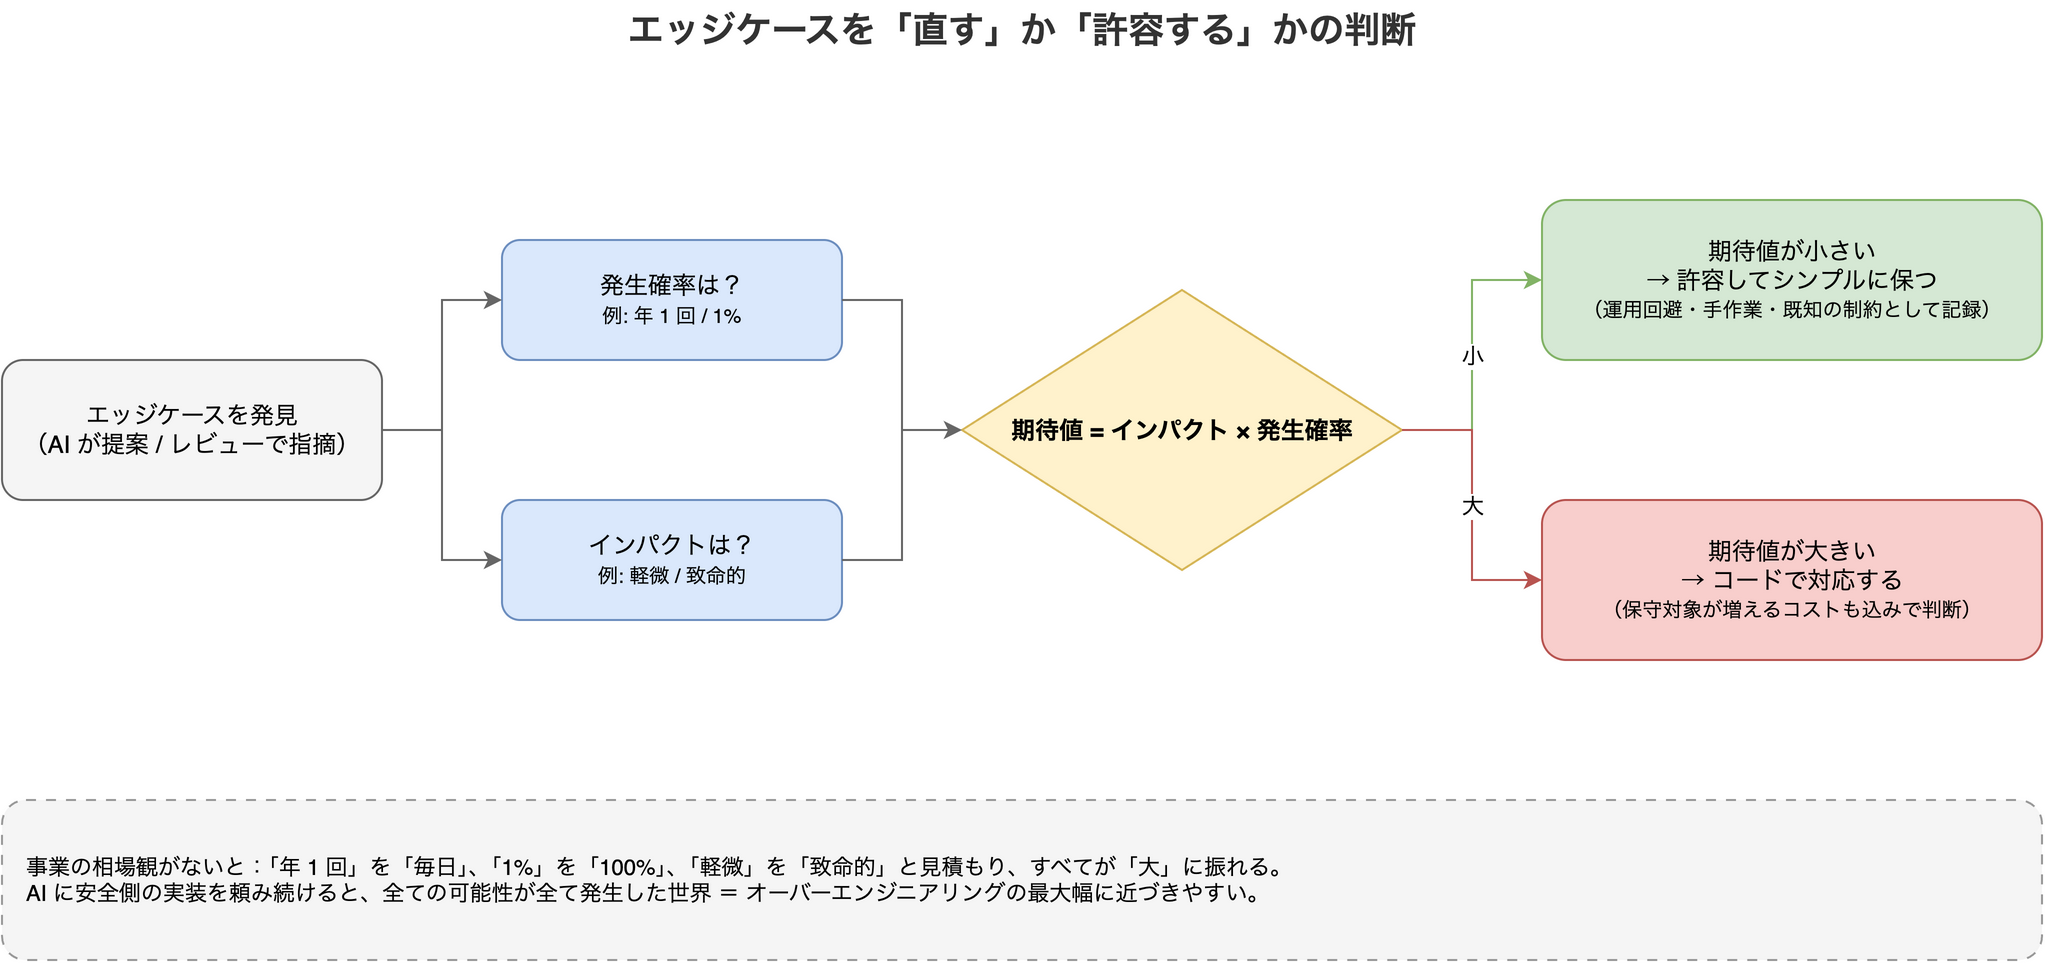
期待値が小さければ、コードを書かずに許容します。運用で回避する、手作業で対処する、既知の制約として記録しておく、といった選択肢があります。期待値が大きいときだけコードで対応します。その場合も、「コードを足すと保守対象が増える」というコストを含めて判断します。
なぜ AI 時代にこそ重要なのか
「念のため」のコストが見えにくくなった
人間が手で書いていた頃は、レアケースへの対応にも実装の手間がかかりました。その手間が自然なブレーキになり、「これは今やらなくていいか」と判断する機会になっていました。
AI に頼めば、エッジケース対応は数秒で出てきます。筆者の経験では、AI は指摘されたケースを拾う方向に振れやすい傾向があります。レビューで「この場合はどうなりますか?」と聞かれれば、分岐を 1 つ足して応えることが多いのです。一つひとつは正しい対応に見えるので、断る理由が見つからないまま、少しずつ複雑になっていきます。冒頭の投稿にある「安全側に倒れて少しずつ複雑になる」は、この状態を指していると読めます。
コードは書いた瞬間から保守対象になる
資料は、コードの総量そのものが未来の開発生産性を下げると指摘します。変更のたびに、既存コードの仕様確認・影響範囲調査・設計・テスト・運用確認が発生するからです。これは、そのコードが事業価値を生んでいてもいなくても同じです。
さらに、コードが増えると監視・障害対応・セキュリティ対応・依存関係管理・EOSL(End of Service Life、製品やサービスのサポート終了)対応・問い合わせ対応も増えます。資料の言葉を借りれば、作ることが速く安くなる時代ほど「動かし続ける力が事業価値の上限になる」のです。
AI で書くコストが下がっても、持ち続けるコストは対象が増えた分だけ膨らみます。書くコストの低下がそのまま保守対象の増加につながる点が、この問題の核心です。
目指すのは「事業価値濃度」の高いコード
資料はこれを「ソースコードに対する事業価値濃度」という言葉で表しています。目指す状態は次の 4 つです。
- 本当に必要なコードを増やす
- 事業価値を生まないコードを増やさない
- 既に価値を生まなくなったコードを除却する
- 価値を生むコードの保守性を上げる
ほぼ起きないエッジケースへの対応コードは、2 つ目の「事業価値を生まないコード」の典型です。そして AI が書くコストを下げた今、最も増えやすいのもこの種類のコードです。
実践:AI と開発するときの歯止め
資料の考え方を AI との開発に当てはめると、次のような運用が考えられます。
エッジケース対応の前に、発生確率とインパクトを書き出す
AI が「このケースも考慮しましょう」と提案してきたら、実装の前に発生確率とインパクトを言葉にします。たとえば次のように、PR の説明や設計メモに残しておくと、後から判断を見直せます。
## 対応しなかったエッジケース

- 同一ユーザーの同時 2 端末からの注文確定
  - 発生確率: 過去 1 年のログで 0 件
  - インパクト: 重複注文 1 件。カスタマーサポート(CS)の手動キャンセルで解消できる
  - 判断: 許容。月次で重複注文件数を確認し、発生したら再検討する
確率もインパクトも、手元のログや問い合わせ件数で裏付けられるとさらに強くなります。数字が出せない場合は、それ自体が「相場観が足りていない」というサインです。
AI への指示に「許容してよい範囲」を含める
AI は放っておくと安全側に倒れがちです。プロジェクトの指示ファイル(CLAUDE.md など)やタスクの依頼文に、許容してよい範囲を明示しておくと歯止めになります。
## 実装方針

- 発生頻度が低く、影響が軽微なエッジケースは実装しない。
  代わりに「対応しなかったケース」として PR 説明に列挙する。
- 将来の拡張のための抽象化・設定項目は、具体的な要求が出るまで追加しない。
- 性能最適化は、計測でボトルネックと確認できた箇所に限る。
こうしておくと、AI はエッジケースを黙って実装せず、一覧として報告しやすくなります。許容するかどうかの判断が、人間の手元に戻ってきます。
レビューで「足す」だけでなく「足さない」を評価する
レビューで「このケースは?」と問うのは大切ですが、答えが常に「対応しました」である必要はありません。「期待値が小さいので許容します」という返答を、正当な回答として受け入れられるか。その文化の有無で、コードベースの複雑さは大きく変わります。
仕組みにする:仕様と受入基準を先に決めてから開発ループを回す
ここまでの歯止めは、どれも人の注意に頼っています。筆者がメンテナンスしている Claude Code プラグイン spec-loop と dev-loop の組み合わせでは、同じ判断を手順として組み込んでいます。spec-loop が仕様と受入基準を確定させ、dev-loop がそれを満たすまで開発ループを回すという分担です(設計の背景は 要求仕様ループを Claude Code プラグインにする を参照)。
「エッジケースだから許容する」を既定の線にする
spec-loop の範囲の決まり(references/spec-scope.md)は、仕様に書く場面を頻度と影響の 2 軸で分けます。
| 影響が大きい | 影響が小さい | |
|---|---|---|
| よく起きる | 範囲の中(場面ごとに書く) | 範囲の中(場面ごとに書く) |
| まれ | 範囲の中。ただし原則 1 本で受ける | 範囲の外(範囲の文書に 1 行) |
「まれ × 影響が小さい」場面は、仕様に分岐もテストも足さず、範囲の文書(spec/scope.md)に 1 行記録するだけです。まれでも影響が大きい場面は、場面ごとの分岐にせず「原則 1 本」で受けます。資料の期待値の考え方を、仕様を書く段階の規則にしたものと言えます。
安全側に倒すかを AI に決めさせない
この線をどこに引くかは利用者の判断で、仕様を書くスキル(spec-review)は線を当てるだけで動かしません。仕様をレビューする判定役(Red Team など)がエッジケースを見つけても、範囲の外の場面は「仕様が未完成」の根拠にできず、「範囲の外として記録する」という案として挙がります。指摘されるたびに仕様が膨らむ流れを、構造で止めています。
同じ機能についての質問が溜まってくると(既定では 3 問目)、個別の質問の代わりに範囲を決め直す質問を出し、そこに「質問を生んでいる前提を単純にする」という選択肢を必ず添えます。エッジケースを 1 つずつ潰すより、その源になっている前提を消すほうが早いことが多いからです。
受入基準を先に固定し、実装を縛る
確定した仕様は、実装が無いと失敗する Red テストと Issue に変換されます。このとき、仕様に書いていないケースは足しません。dev-loop の側では、受入基準は計画の段階で固定され、周の途中で基準を足せるのは人間だけです。計画した変更範囲の外へ黙って出ることも禁じています。範囲を広げるなら、手を動かす前に理由を計画に書き、広げた分の受入基準も足さなければなりません。採点表が先にあるので、「念のため」のコードは誰にも採点されないコードになります。
それでも残る穴
資料の 4 つの錯覚に当てはめると、効き方には差があります。
| 錯覚 | 効き | 理由 |
|---|---|---|
| レアケース仕様を大量に増やす | 強い | 頻度 × 影響の既定の線そのもの |
| 優先度の低いバグをすべて直す | 効く | 受入基準が固定され、変更範囲を広げるには計画への記録が要る |
| 過度な拡張性 | 弱い | 拡張性は「実現の手段」として仕様に書かない。そのぶん、実装の中で抽象化を盛ることは止めにくい |
| 不要な高性能化 | 弱い | 同じく実装側の判断で、受入基準が求めなくてもできてしまう |
ほかにも、次の点には注意が要ります。
- 既定の線の頻度の例は、ディスクがいっぱい・時計が戻るといった技術的な事象が中心です。資料の「年 1 回」「1%」のような業務の頻度は、プロジェクトの範囲の文書に線として書き足す必要があります。範囲の外の行には「決めた根拠」を書く欄があるので、筆者はそこにログや問い合わせ件数などの実データを書く運用をお勧めします。
- 判断を利用者に戻しても、答える人の相場観がずれていればそのまま通ります。最後は人の事業理解です。
- 小さな変更にまで全部のループを回すと、プロセスそのものが別のオーバーエンジニアリングになります。
実装の中での抽象化や性能の盛りすぎは、コードレビューや簡素化のレビューで別に見る必要があります。
まとめ
- オーバーエンジニアリングは、発生確率やインパクトの見誤りから起きる
- 必要な事業理解は、「この事象は年に 1 回しか起きない」と知っている程度の現場感で十分
- 判断の物差しは「期待値 = インパクト × 発生確率」。期待値が小さいエッジケースは許容してシンプルに保つ
- AI で書くコストが下がった分、「念のため」のコードと保守対象が増えやすくなった
- だからこそ、作らない判断と、その判断を記録して見直せる仕組みが重要になる
- 仕様と受入基準を先に確定させる開発ループ(spec-loop + dev-loop)にすると、レアケースの許容を規則として組み込める
- 明日からできること:対応しなかったケースを PR に記録する、指示ファイルに許容範囲を書く、レビューで「足さない」を評価する
資料の結びの一文が、この話をよく要約しています。
AI時代のEngineeringは、たくさん作ることではない。価値になるものを作り、価値にならないものを作らず、作った価値を止めないことである。