ボイスレコーダーやスマートリングで録った音声を文字起こしにかけると、雑音や残響のせいで認識結果が崩れることがあります。STT(Speech-to-Text)のモデルを替える前に、入力の音声そのものをきれいにする手があります。
2026 年 10 月末、NVIDIA の研究チームによる音声強調モデル NemotronLabs RE-USE が X で話題になりました。パラメータ数はわずか 9.6M で、モデルカードのベンチマークでは前処理に挟むだけで ASR の文字正解率が 81.3% から 89.2% に上がっています。この記事では、モデルカードに書かれている性能・使い方・制約を整理し、文字起こしの前処理として使う場面を考えます。
きっかけ:「声色あんま変わらない」
発端は NVIDIA AI 公式アカウントの 告知ポスト です。背景ノイズやエコーなどの歪みを取り除いて話し声を聞き取りやすくする、多言語対応のオープンモデルとして紹介されました。
これを引用した GOROman 氏は 「これMacでも動いたので、みんな試そう。ボイスレコーダーのファイルとか食わせるとまじでビビるw」 と投稿しています。さらにそれを引用した Shinichi Ohki 氏は 「RE-USEすごかった。声色あんま変わらないし Index01の音声これ通してSTT通してってやりたい」 と書いています。
Index 01 は、Pebble の創業者が率いる Core Devices が 2025 年 12 月に発表した指輪型のボイスレコーダーです。ボタンを押している間だけ録音する、短い音声メモ専用のデバイスです。指に付けた小さなマイクで録るので、音質は録音環境に大きく左右されます。
「声色が変わらない」という感想は重要です。ノイズ除去をかけると、話者の声質まで変わってしまうモデルが少なくありません。話者の特徴を残したまま劣化だけを取り除けるかどうかが、音声強調モデルの評価の分かれ目になります。
RE-USE とは
モデルカード によると、RE-USE は 多言語ユニバーサル音声強調(Universal Speech Enhancement, USE) モデルです。特徴は次のとおりです。
- 多様な劣化に対応:加算性ノイズ、残響、クリッピング、帯域制限、コーデック由来の歪み、パケットロス、低品質なマイクによる歪み
- 複数のサンプリングレート:8 / 16 / 22.05 / 24 / 32 / 44.1 / 48 kHz の入力を受け付ける
- 言語非依存:学習データは英語・ドイツ語・スペイン語・フランス語・中国語だが、言語に依存しない処理を狙っている
- 主話者を優先:複数人の声が重なった場合は主話者を残し、他の話者を抑えるよう学習されている
アーキテクチャは、畳み込みのエンコーダ/デコーダの間に、時間・周波数方向をモデル化する双方向 Mamba を 30 層挟んだ構成です。Mamba は、長い系列を Transformer より軽い計算量で扱える状態空間モデル(SSM)です。
学習データは約 2,500 時間の音声です。LibriTTS、VCTK、Multilingual LibriSpeech、Common Voice 19.0 などのクリーンな音声に、DNS5 チャレンジのノイズや、シミュレーションした室内インパルス応答(部屋の残響特性)を合成して作られています。
小さいのに主要指標で大型モデルを上回る
モデルカードには、音声強調の国際チャレンジ URGENT 2025 の非ブラインドテストセットで、他のオープンソース USE モデルと比べた結果が載っています。全体セットから主な指標を抜き出すと次のとおりです。PESQ は音質の客観評価、STOI は聞き取りやすさ(了解度)の指標で、どちらも高いほど良い値です。
| モデル | パラメータ数 | PESQ | STOI | 話者類似度 | ASR 文字正解率(%) |
|---|---|---|---|---|---|
| ノイズ入り(処理なし) | - | 1.34 | 0.50 | 0.73 | 81.29 |
| Sidon | 250M | 1.73 | 0.62 | 0.74 | 84.68 |
| UniPASE | 500M | 2.17 | 0.76 | 0.81 | 87.28 |
| RE-USE | 9.6M | 2.57 | 0.78 | 0.86 | 89.17 |
注目したい列は 2 つあります。
1 つは 話者類似度 です。話者認識モデル ECAPA-TDNN で埋め込みを取り、元の音声との類似度を測ったものです。RE-USE は 0.86 で、比較対象の中で最も高い値です。「声色が変わらない」という体感は、この数値と合っています。
もう 1 つは ASR 文字正解率 です。音声認識モデル OWSM v3.1 で文字起こしした結果の正解率で、処理なしの 81.29% が 89.17% まで上がっています。音声強調を前処理に挟むと文字起こしの精度が上がることを、モデルカード自身が示しています。
ただし、DNSMOS や UTMOS といった「聞いた感じの自然さ」を推定する指標では、250M の Sidon が上回っています。すべての指標で勝っているわけではありません。それでも、パラメータ数が 26 分の 1 から 52 分の 1 程度でこの水準に届いている点が見どころです。
文字起こしパイプラインへの組み込み
Ohki 氏の「Index 01 の音声を通して STT を通す」という使い方を図にすると、次のようになります。
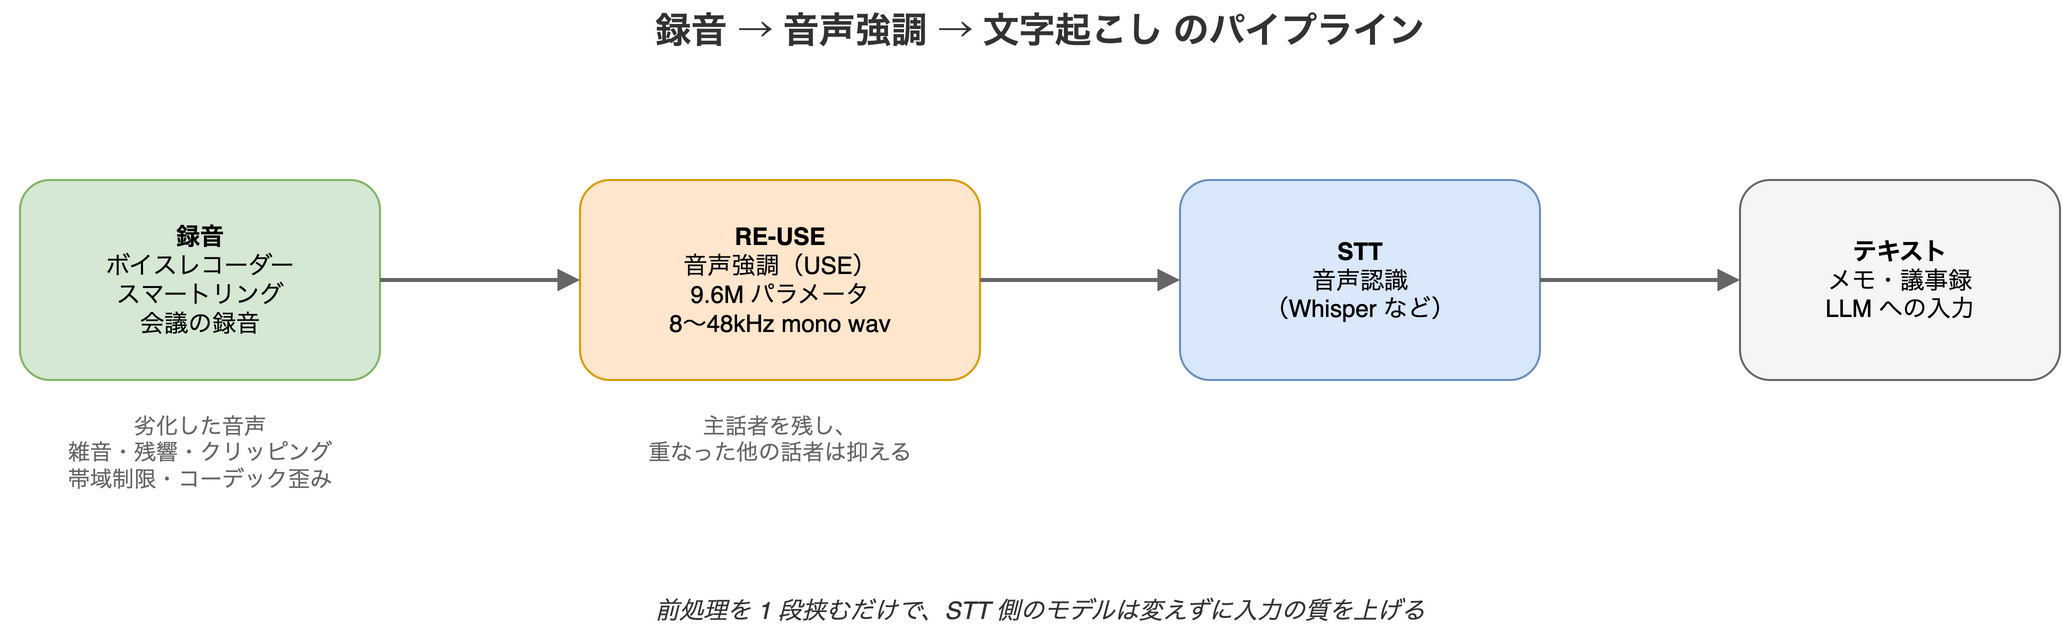
この構成の利点は、Whisper などの STT 側のモデルに手を入れなくてよいことです。RE-USE の出力フォルダを、そのまま STT の入力にすれば済みます。STT を別のモデルに替えても、前処理の 1 段はそのまま使えます。
試し方
いちばん手軽なのはデモ
モデルカードは、まず Hugging Face の Gradio デモ を勧めています。ノイズの入った音声をアップロードすれば、強調後の音声を聞き比べられます。手元の環境を用意する前に、自分の録音で効果があるかを確かめられます。
ローカルで動かす前提:Linux + NVIDIA GPU
モデルカードに記載されている動作環境は、Linux と NVIDIA Ampere 世代の GPU(A100)です。モデルのコードは mamba-ssm パッケージの Mamba を直接 import しています。推論スクリプトも CUDA が使えないと Currently, CPU mode is not supported. というエラーで止まります。
PyTorch や mamba-ssm などの依存は自分で揃える必要があります。モデルカードでは、Mamba の環境構築に SEMamba リポジトリ の Docker 環境を使うよう案内しています。
GOROman 氏は Mac で動かせたと報告していますが、その方法はポストでは明かされていません。公式スクリプトのままでは動かないので、何らかの手を入れたと考えられます。Mac で試すなら、まず Gradio デモで効果を確かめ、そのうえでローカル実行の手間をかけるか判断するのが現実的です。
ローカルで動かす
モデル一式をダウンロードします。帯域拡張(BWE)を使う場合は resampy も入れておきます。
# 帯域拡張(BWE)を使う場合
pip install resampy

# モデル一式をダウンロード
huggingface-cli download nvidia/NVIDIA-NemotronLabs-RE-USE --local-dir ./NemotronLabs_REUSE --local-dir-use-symlinks False
cd ./NemotronLabs_REUSE
モデルカードの入出力の仕様は、8〜48 kHz のモノラル音声です。ステレオの録音は、事前に ffmpeg などでモノラルにしておくと確実です。
ffmpeg -i input.m4a -ac 1 noisy_audio/input.wavノイズの入った音声を noisy_audio/ に置いて実行すると、結果が enhanced_audio/ に出力されます。推論スクリプトは結果を .flac で保存するので、STT 側が flac を読めるか確認しておきましょう。
sh inference.sh学習データは 10 秒未満のクリップで構成されています。30 秒を超えるような長い音声や、GPU のメモリ不足になる音声は、チャンク分割版を使います。long_noisy_audio/ に置いて実行します。
sh inference_chunk.sh出力先は、モデルカードでは Long_enhanced_audio/ と書かれていますが、スクリプトの指定は小文字の long_enhanced_audio/ です。Linux ではファイル名の大文字・小文字が区別されるので注意してください。
チャンクの長さ(chunk_size_in_seconds)と重なり(hop_length_portion)はスクリプト内で調整できます。会議の録音のような長いファイルはこちらを使うことになります。
ライセンス
Hugging Face には RE-USE の名前を持つリポジトリが 2 つあります。
nvidia/RE-USE:2026 年 3 月に作成された先行版。Hugging Face 上のライセンス分類はother(独自ライセンス)nvidia/NVIDIA-NemotronLabs-RE-USE:2026 年 7 月に作成され、10 月 22 日に更新された版。ライセンスは OpenMDW-1.1 で、モデルカードには「商用利用可能」と明記されている
業務の録音に使うなら、商用利用可と明記されている NemotronLabs 版を選ぶのが無難です。
まとめ
- NVIDIA の RE-USE は、9.6M パラメータで雑音・残響・コーデック歪みなどをまとめて取り除く音声強調モデル
- 250M〜500M クラスのモデルと比べても、話者類似度と ASR 文字正解率で上回っている。聞いた感じの自然さ(DNSMOS・UTMOS)では 250M の Sidon が上
- STT の前処理として挟めば、STT 側を替えずに文字起こしの精度向上が期待できる
- 公式の動作環境は Linux + NVIDIA GPU。まずは Gradio デモで手元の録音を試すのが早い
スマートリングやボイスレコーダーで場所を選ばず録音できるようになった分、音質のばらつきは大きくなっています。録音の質を前処理で底上げできる小さなモデルは、音声メモを LLM に渡す流れを支える部品になりそうです。
参考リンク
- nvidia/NVIDIA-NemotronLabs-RE-USE(Hugging Face)
- RE-USE Gradio デモ
- Rethinking Training Targets, Architectures and Data Quality for Universal Speech Enhancement(arXiv:2603.02641)
- One Model, Many Latencies: Universal Speech Enhancement for Diverse Real-Time Applications(arXiv:2606.25621)
- NVIDIA AI の告知ポスト
- Pebble Index 01 の発表(MacRumors)