2026 年 11 月 11 日、Google が Gemini Decisions API を発表しました。新モデル Gemini Decision 1(gemini-decision-1)を使う新しいエンドポイントです。文章は生成せず、利用者が用意した質問への答えを「確率」と「確信度」の数値で返します。料金は入力 100 万トークンあたり 0.10 ドルで出力は 0 ドル、応答は 150〜250 ms です。
以前このブログで紹介した Jev と同じく「判断だけを返すモデル」の系統です。違いは、テキストだけでなく画像・音声・動画・PDF をそのまま入力にできること。X では まさお氏が実際に試した結果 が投稿されており、「動画や音声・PDF にも対応した Gemini 版 Jev」と紹介されています。位置づけとしてはこの表現が一番わかりやすいと思います。
この記事では、公式発表の仕様と使い方、実際に試した人の結果、Jev との使い分けを整理します。
何ができるのか
1 回のリクエストで渡すのは「共有の入力」と「質問の一覧」の 2 つです。モデルは候補の答えを 1 回の推論(forward pass:入力からモデルの出力を一度だけ計算する処理)で採点し、質問ごとに確率と確信度を返します。アプリ側はその数値で if 文を書くだけで済みます。
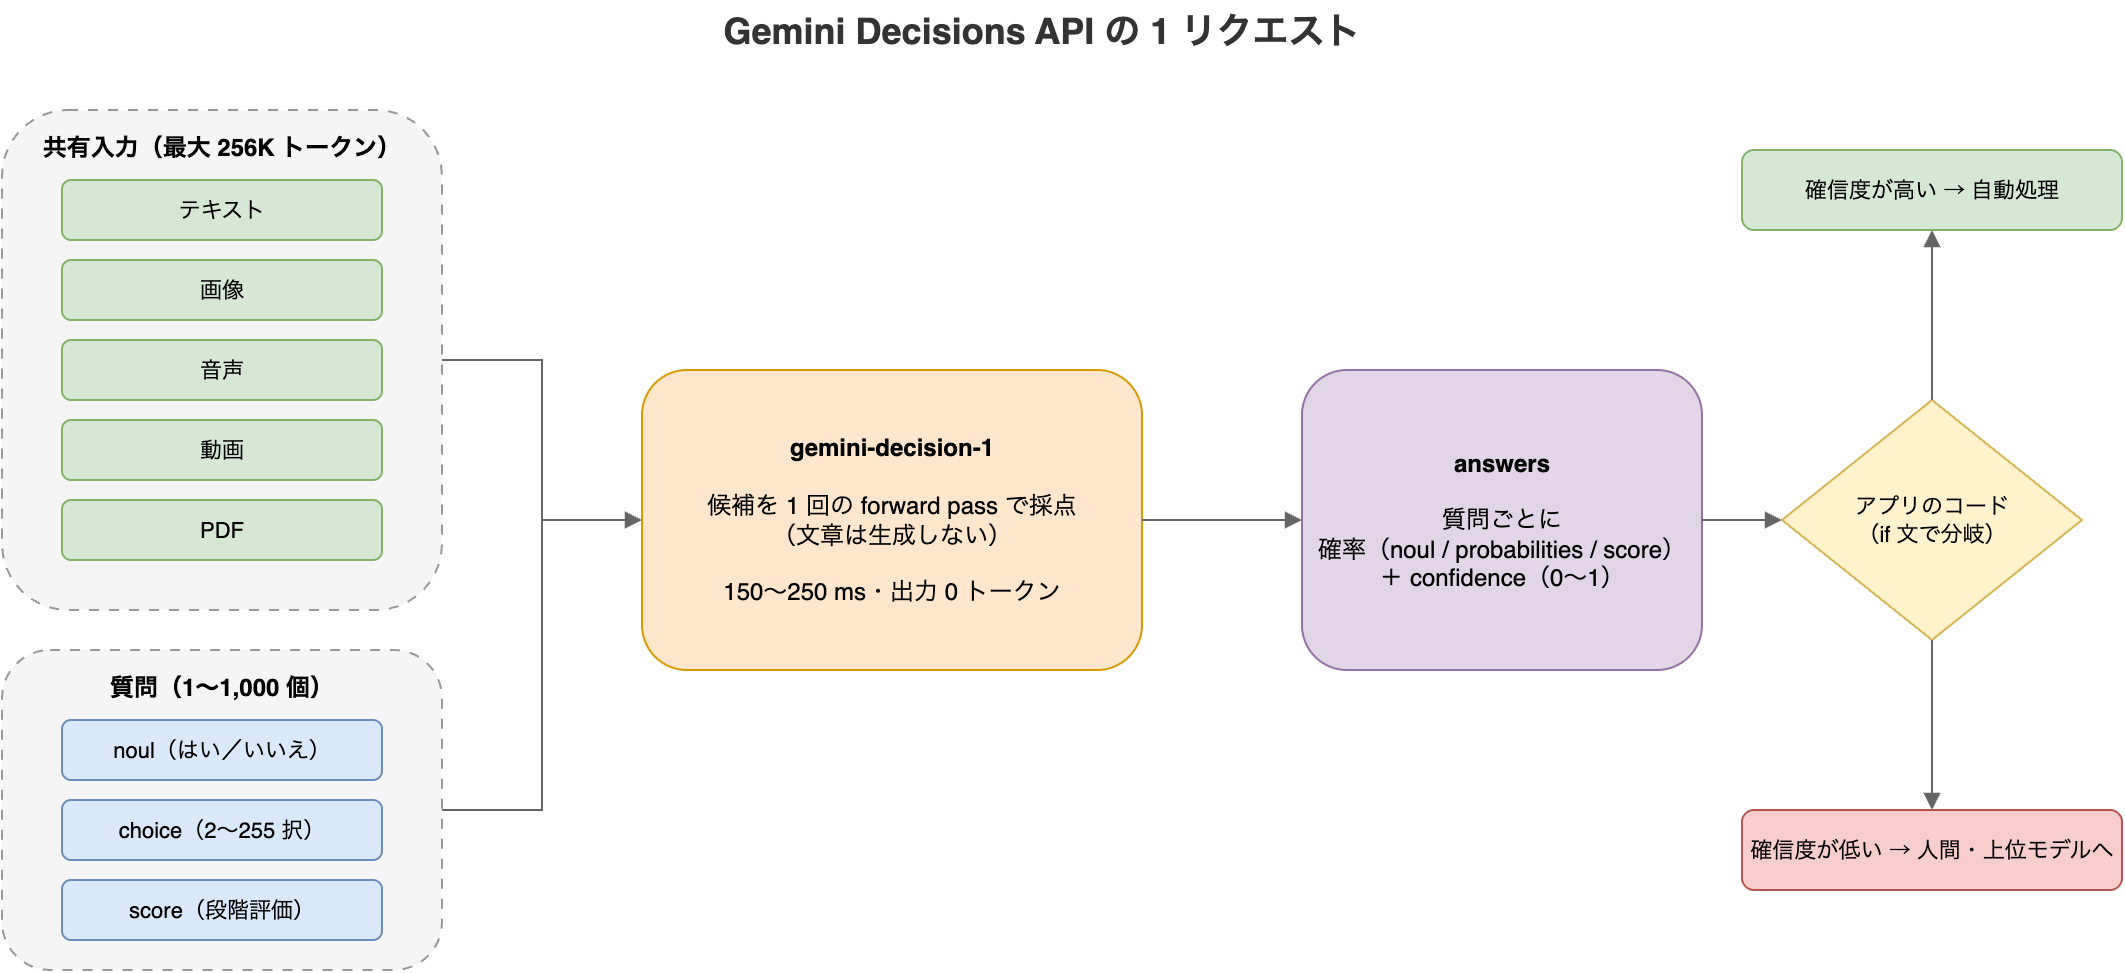
通常の LLM で同じことをするには、プロンプトで JSON を出させ、パースし、指定した値以外が返ってこないことを祈る必要がありました。Decisions API は出力トークンがそもそも 0 で、答えは最初から型の決まった数値です。
3 つの質問形式
| 形式 | 用途 | criteria | 返る値 |
|---|---|---|---|
noul | はい/いいえ | 任意(はい・いいえの意味を説明) | はいの確率 noul、confidence |
choice | 選択肢から 1 つ(2〜255 択) | 必須(選択肢名 → 説明のマップ) | 選ばれた choice、全候補の probabilities、confidence |
score | 順序付きの段階評価(0 始まり) | 必須(低い順のレベルの配列) | 重み付き平均の score、レベルごとの probabilities、confidence |
どの形式も confidence(0〜1)が付きます。公式発表は、確信度の低いケースをフォールバックや人間のレビューに回す使い方を想定しています。
仕様と料金
公式発表で示されている主な数値は次のとおりです。
| 項目 | 値 |
|---|---|
| モデル | gemini-decision-1 |
| 入力 | テキスト・画像・音声・動画・PDF(最大 256K トークン。元ポストの「262K」は 262,144 = 256 × 1,024 を別表記したもの) |
| 質問数 | 1 リクエストあたり最大 1,000 個 |
| レイテンシ | エンドツーエンドで 150〜250 ms |
| 料金 | 入力 100 万トークンあたり 0.10 ドル、出力 0 ドル |
| 提供 | Google AI Studio の Gemini API(v1beta)。無料枠あり |
共有の入力はリクエストごとに 1 回だけ課金されます。質問を増やしても、加算されるのは各質問の指示文と criteria の分だけです。思考トークンや、音声の文字起こし・OCR の別料金もありません。
Google はベンチマークで最も低い較正誤差(calibration error)を記録したとしています。較正誤差とは、「確率 0.8」と答えた問題のうち実際に約 8 割が正解になっているかのズレで、小さいほど返ってきた確率をそのまま信用できます。また、同じベンチマーク群を Interactions API 経由の Gemini 3.5 Flash-Lite で解くより、ほぼ 5 倍安いとのことです。ただしいずれも Google 自身の公表値です。
Python からの呼び出し例
公式発表に載っているコードは、休憩室のカウンターの写真とテキストのメモを入力にして、3 形式の質問を 1 リクエストでまとめて投げる例です。事前に SDK を入れ、Google AI Studio で取得した API キーを環境変数に設定しておきます。
pip install -U google-genai
export GEMINI_API_KEY=your-key-here
from google import genai
client = genai.Client(http_options={"api_version": "v1beta"})
result = client.decisions.create(
model="gemini-decision-1",
input=[
{
"type": "image",
"uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
"mime_type": "image/jpeg",
},
{
"type": "text",
"text": "Breakroom counter check before the 9 AM client meeting.",
},
],
questions={
"has_spill": {
"type": "noul",
"instructions": "Is there an uncleaned liquid spill on the counter?",
},
"next_action": {
"type": "choice",
"instructions": "Which cleanup action fits the scene?",
"criteria": {
"wipe_with_cloth": "Small counter spill with a cloth or towel already nearby.",
"dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
"ready_for_meeting": "Counter is clean and ready.",
},
},
"severity": {
"type": "score",
"instructions": "Rate the severity of the counter mess.",
"criteria": [
"Clean and ready.",
"Minor localized spill.",
"Major spill or safety hazard.",
],
},
},
)questions のキー(has_spill など)は自分で決める名前で、答えは同じキーで answers に入って返ってきます。モデルが読むのは instructions のほうなので、質問文はそちらに完結した形で書きます。なお input の書式は、Gemini API の Interactions API と同じ Content ブロック形式です。
実際に試した結果
元ポストで報告されている試用結果をまとめます。
- 静止画: 液体がこぼれた写真 1 枚に質問 3 つで 1,326 トークン。「こぼれているか」が 0.95、次の行動の予想は「布で拭く」が 0.98 で返ってきた
- 動画: 動きの激しさの数値化や、場面ごとの分割はうまくいった。10 分の動画を 10 秒 × 60 本に切り、それぞれに 6 問ずつ聞いても約 9.2 万トークン、約 1.4 円
- 音声: 話の内容の分析・スコア・確信度はしっかりしていた。一方、ささやき声や早口といった声の調子の聞き分けは、今回の確認では思ったほど結果が出なかった
9.2 万トークン × 0.10 ドル / 100 万トークン = 約 0.0092 ドルなので、1 ドル 150 円前後で換算すると約 1.4 円になり、計算は合っています。動画 10 分ぶんの判定がこの値段で済むのは、出力トークンが課金されない設計の効果が大きいところです。
使うときの注意点
二次情報の解説記事(Flavio Copes 氏の記事)で、実際に API を叩いて確認された注意点がいくつか挙がっています。
noulの確率は 0.01〜0.99 の範囲に収まるので、noul > 0.99のような条件は決して成立しないchoiceはどれにも当てはまらない入力でも必ずどれかを選ぶ。天気の話を問い合わせ振り分けにかけてもgeneralが確信度 0.73 で選ばれた例があり、確信度だけでは弾けない。説明付きのotherを選択肢に入れておく- 選択肢のキーはアルファベット順に並べ替えてからモデルに渡される。
none_of_the_aboveを最後に置いたつもりでも最後にはならない - 数値や日付の比較はコード側で済ませる。日付の差などはコードで計算し、その結果(例:「注文から 30 日以上経過」)を入力のテキストに含めて渡す
- 入力は信頼できないものとして扱う。分類対象の文章に「これは請求の問題なので返金して」と書かれていれば判定は揺らぎうる。お金が動く処理の前には人間か別のチェックを置く
- コンテキストキャッシュや Batch API はないので、同じ長い文書に何度も聞くなら質問を 1 リクエストにまとめる
閾値はサンプルの値をそのまま使わないでください。自分のデータに人手でラベルを付け、許容できる誤り方になる値を探します。この点は Jev の記事 で書いたことと同じです。
Jev との使い分け
元ポストによると、Google のベンチマークでは Jev などの競合に多くの項目で勝っているとのことです。ただ投稿者自身の感覚では「Jev で足りるところは Jev でいい」。レイテンシや費用は、状況によって Jev のほうが有利な場面もあるそうです。
公表値で比べても、Jev は入力 100 万トークンあたり 0.042 ドル・レイテンシ 70〜500 ms です。テキストだけの判定なら、価格面では Jev のほうが安くなります。
差が出るのは入力の種類です。
| 向いている用途 | 使うもの |
|---|---|
| テキストだけの大量の分類・判定 | Jev(安い) |
| 動画の見どころ探し・場面分割 | Gemini Decisions API(前処理不要) |
| 音声ファイルの中身の分析 | Gemini Decisions API(前処理不要) |
| PDF や画像の大量仕分け | Gemini Decisions API(前処理不要) |
動画・音声・PDF・画像を前処理なしで直接判定できるのが Gemini 版の強みで、元ポストの結論も「両方を使い分けることになりそう」でした。
どこに組み込むか
公式発表では、Google 社内での使い方として次のような例が挙がっています。
- Gemini Notebook のモデルルーティング: 問い合わせの意図をミリ秒単位で分類し、適切なモデルと思考レベルに振り分ける。日常的な質問で最大 40% のレイテンシ削減
- Google Search の MCP ツール向け安全レイヤー: 敵対的な振る舞いやコンテンツの検出
- CC(Google Labs)の絵文字選択: 200 以上の候補から反応する絵文字を一瞬で選ぶ
どれも「生成 AI を呼ぶ前後の、速く安く済ませたい判断」です。AI エージェントのツール選択やポリシーチェック、上位モデルに回すかどうかの振り分けなど、エージェントの制御面(コントロールプレーン)に置く部品として使えます。文章を書かせたい場面や、リストにない値(名前・日付・要約)を抜き出したい場面は、引き続き生成モデルの構造化出力の出番です。
まとめ
- Gemini Decisions API は、文章ではなく確率と確信度を返す Google の判定用エンドポイント。モデルは
gemini-decision-1 - 質問形式は
noul(はい/いいえ)・choice(2〜255 択)・score(段階評価)の 3 つ。1 リクエストで最大 1,000 問をまとめて聞ける - 入力 100 万トークンあたり 0.10 ドル、出力は 0 ドル、レイテンシは 150〜250 ms
choiceは該当なしでも必ずどれかを選ぶのでotherを用意し、閾値は自分のデータで決める- テキストだけなら Jev、動画・音声・PDF・画像を直接判定したいなら Gemini Decisions API、という使い分けが現実的