仕様駆動開発(Spec-Driven Development、SDD)は、たいてい「開発者 1 人・リポジトリ 1 つ・具体的な課題 1 つ」から始まります。GitHub Spec Kit を入れて、constitution・spec・plan・tasks を作り、AI エージェントに実装させます。ここまでは個人でもすぐに回せます。
難しいのはその先です。マイクロサービスで複数のリポジトリがあり、全社の標準があり、Spec Kit を使っているチームといないチームが混在し、経営層からは成果が見えない。この状態で SDD を「組織の開発能力」にするにはどうすればよいのでしょうか。
Microsoft Tech Community(ブラジル開発者向けブログ)に、この問いに答える記事が 2026 年 11 月 15 日に公開され、X でも紹介されていました。
- Além do repositório: a jornada de maturidade do Spec-Driven Development(ポルトガル語。邦題を付けるなら「リポジトリの外へ — 仕様駆動開発の成熟の道のり」)
本記事では、この記事が示す 6 つの段階(実験 → 再現性 → 一貫性 → 協調 → ガバナンス → 計測)と、実際に進めるときの考え方を日本語で整理します。SDD や Spec Kit そのものの説明は、以下の記事を参照してください。
- 仕様駆動開発(SDD)とは? 3 つのアプローチ・EARS 記法・Kiro / Spec Kit・TDD との違い
- GitHub Spec Kit とは? 仕様駆動開発のコマンド・constitution と Kiro との違い
前提:SDD は「AI に先に文書を書かせること」ではない
元記事はまず、SDD の定義をはっきりさせます。SDD とは、AI にコードより先に文書を書かせることではありません。変更の意図を、デリバリーが終わるまで明示的かつ検証可能な形で保ち続けること です。
Spec Kit は成果物を整理して作業を速くします。ただし、仕様を書き、レビューし、検証するという実践そのものは、Markdown とチーム内の取り決めだけでも成り立ちます。そのため元記事は「プロセスの問題を解決するコマンドを探さないこと」を勧めています。
組織で SDD が広がらないときに、テンプレートやエージェントを足すのは筋が違います。先に探すべきなのは、どの調整の問題が実践の前進を止めているか です。
6 つの段階の全体像
元記事は SDD の成熟を 6 つの段階で説明します。ただし「厳密な順序でも認定モデルでもなく、実務の目安」だと断っています。各段階の最後には、次へ進んでよいかを判断する 「進化の合図(Sinal de evolução)」 が書かれています。
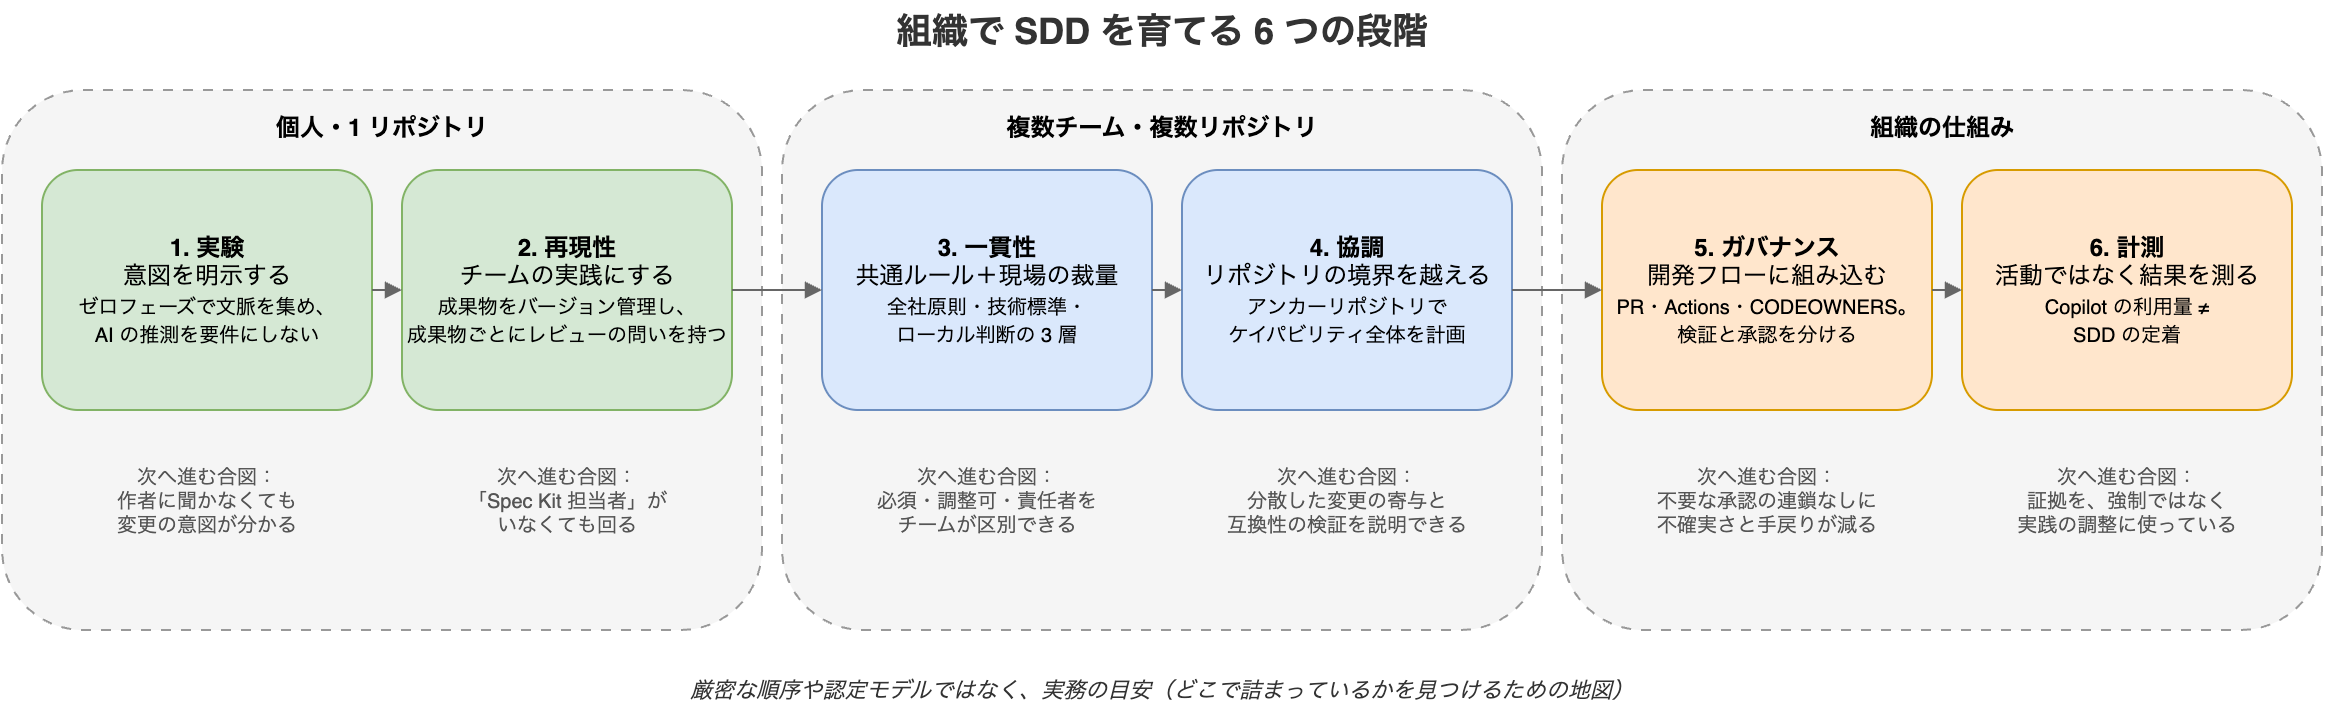
| 段階 | 目的 | 次へ進む合図 |
|---|---|---|
| 1. 実験 | 変更の意図を明示する | 作者と話さなくても、他の人が変更の意図を理解できる |
| 2. 再現性 | 個人の経験をチームの実践にする | 「Spec Kit の専門家」に頼らず、チームが理解して回せる |
| 3. 一貫性 | 共通のガードレールと現場の自律を両立する | 何が必須で、何を調整してよく、誰が決めるかをチームが区別できる |
| 4. 協調 | リポジトリの境界を越えて計画する | 分散した変更が 1 つのデリバリーにどう寄与し、その互換性をどう検証しているかを説明できる |
| 5. ガバナンス | SDD を開発フローに組み込む | 不要な承認の連鎖を作らずに、不確実さと手戻りが減る |
| 6. 計測 | 活動ではなく結果を評価する | 証拠を、遵守の強制ではなく実践の調整に使っている |
以下、段階ごとに要点を見ていきます。
1. 実験:意図を明示する
最初の段階の目的は、作業の定義の質を上げることです。
元記事が勧めるのは、実装の前に 「ゼロフェーズ(文脈の準備)」 を置くことです。ユーザーストーリー、受け入れ基準、プロダクトの文書、既存のコード、テスト、デプロイ上の制約を集めます。とくに既存システムに手を入れるときに効きます。
そのうえで、問題・期待する振る舞い・制約・受け入れ基準を、実装より前に言葉にします。
疑問が出たときの扱いも具体的です。
- まずリポジトリの中に証拠を探す
- 答えをどこから得たかを示す
- 人間の判断が要る点は、未決のまま残す
AI の推測が、黙って要件に化けてはいけない という点が、この段階の肝です。
2. 再現性:チームの実践にする
1 人がうまく回せても、その人がいなくなれば止まります。2 つ目の段階では、それをチームのものにします。
.specifyディレクトリのうち必要なものと、spec・plan をバージョン管理する(秘密情報や個人設定はコミットしない)- 最小限の取り決めを決める:いつ spec が要るか、明確化に誰が参加するか、何をレビューするか、実装が変わったら成果物をどう更新するか
元記事は、成果物ごとに「レビューで問うこと」を 1 つずつ割り当てています。
| 成果物 | レビューで問うこと |
|---|---|
constitution.md | 原則と制約は、このプロジェクトのあるべき作り方を反映しているか |
spec.md | 要件は明確で、漏れがなく、テスト可能か |
plan.md | 方針は実現可能で、依存関係・リスク・検証を考慮しているか |
tasks.md | チームが理解できる順序で作業を実行できるか |
| 分析・チェックリスト | 解決すべき矛盾・抜け・保留事項はどれか |
PR は実装のときではなく、成果物を作った時点から 始めることを勧めています。ただしファイルごとに PR を分ける必要はなく、spec の PR・plan の PR・実装の PR のどこにチェックポイントを置くかは、リスクに応じてチームで決めます。
流れは「原則 → 仕様 → 明確化 → 計画 → タスク → 一貫性の分析 → 実装」で、最後に 仕様と実際にデリバリーしたものが一致しているか(収束) を確かめます。
運用面の準備も見落とせません。承認済みのツール、リポジトリへのアクセス、AI 利用ポリシー、制約に合ったインストール方法を確認します。元記事は、オフラインでインストールできても、エージェントが接続や承認なしで動けるわけではないと注意しています。既存リポジトリに導入するときは、初期化で生じた差分をレビューし、すでに承認済みの指示・パターン・成果物を壊さないようにします。
3. 一貫性:共通のガードレールと現場の自律
チームが増えると、標準化とチームの自律がぶつかります。元記事は、指針を 3 つの層に分けることを提案しています。
- 全社の原則:要件とガードレール
- 技術標準:API・イベント・言語・プラットフォーム
- 現場の判断:ドメインやサービス固有の事情
共有の constitution に共通の原則を書くことはできます。しかし、それだけでは配布と更新の問題は解けません。各リポジトリが新しい版をどう取り込むか、影響を誰が評価するか、例外をどう記録するか。これを決めておかないと、コピーはやがてばらばらになります。
現場で得た学びは、テンプレート・プレイブック・再利用できるパターンとして戻します。共有できるのは spec、本番環境の要件、テスト戦略、IaC、検証基準などです。ただし、機密や特定案件の情報を取り除くキュレーションが必要です。元記事は、再利用とは「コピー」ではなく「適応」だとしています。
4. 協調:リポジトリの境界を越える
ユーザーに届く 1 つの機能(ケイパビリティ)は、API・イベント・非同期処理・UI にまたがります。各リポジトリの計画が個別には正しくても、全体としては噛み合わないことがあります。
ここで元記事が示す選択肢が アンカーリポジトリ です。
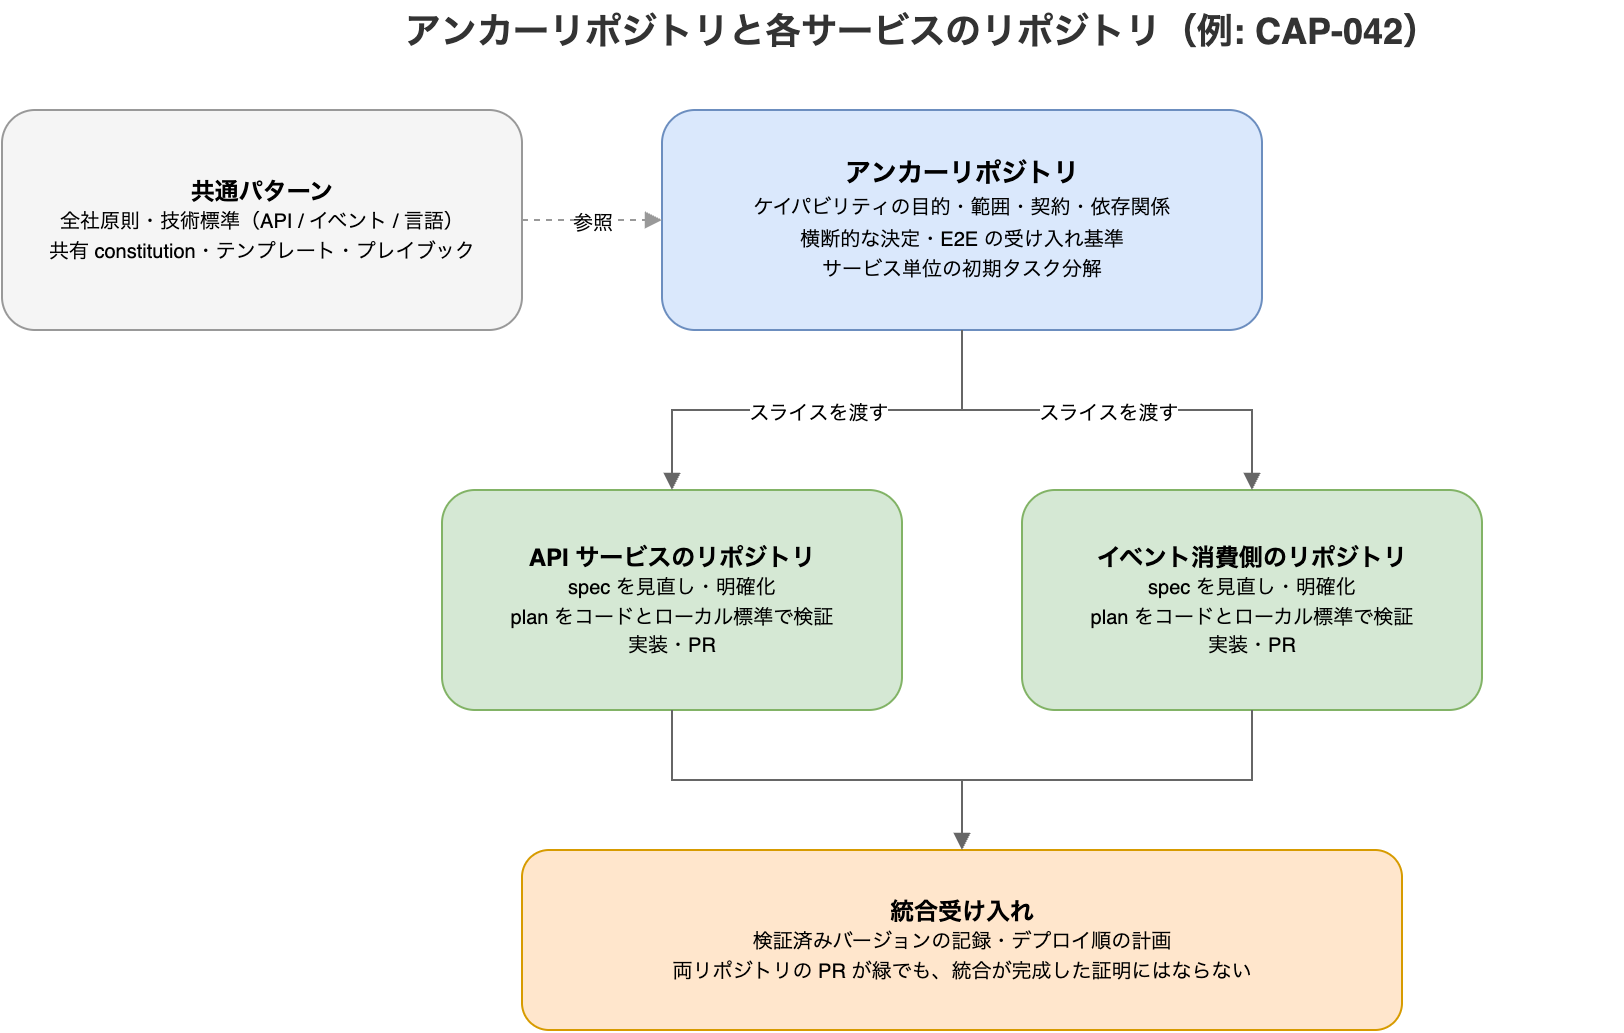
- アンカーリポジトリには、ケイパビリティの共有ビュー(目的・範囲・契約・依存関係・横断的な決定・E2E の受け入れ基準)を置く
- 各サービスのリポジトリには、ローカルの詳細と実装計画を置く
- すべての詳細をアンカーに集めてはいけない
- アンカーリポジトリはアーキテクチャ上の選択であって、SDD の必須要件ではない
元記事はこれを「プロセスはアンカーリポジトリで始まるが、各サービスの文脈で完結する」と表現しています。サービス単位の初期タスク分解はアンカー側で考えてよいものの、その順序を固定してはいけません。各チームは spec を見直して明確化し、plan を自分たちのコード・constitution・ローカル標準と突き合わせて検証します。単純な変更なら、共有の Issue 1 つで足りることもあります。
GitHub の機能との対応にも触れています。
- Issues / Projects:リポジトリをまたぐ依存関係を追跡できる
- 再利用可能なワークフロー:各リポジトリのチェックを標準化できるが、全体のオーケストレーターではない
- 他リポジトリのワークフロー起動:明示的な実装と認証が要る。デフォルトのワークフロートークンが、すべてのプライベートリポジトリにアクセスできると思ってはいけない
もう一つ重要な指摘があります。2 つのリポジトリで PR が緑でも、それだけでは統合されたケイパビリティが完成した証明にはならない という点です。検証済みのバージョンを記録し、デプロイ順を計画します。サービスをまたいだアトミックなマージやロールバックは存在しません。そのため、データ・契約・すでに起きた副作用も考慮に入れる必要があります。
5. ガバナンス:開発フローに組み込む
5 つ目の段階では、SDD を既存のエンジニアリングの仕組みとつなぎます。元記事は、それぞれの仕組みが「何をして、何をしないか」を表にしています。
| 仕組み | すること | しないこと |
|---|---|---|
| GitHub Actions | チェックを実行する | 中身の質は保証しない(ファイルの存在しか確かめられない) |
| CODEOWNERS | パスに応じてレビュー依頼を振り分ける | それだけでは承認を必須にしない |
| Rulesets / ブランチ保護 | チェックや承認を強制する | ビジネス上の妥当性は判断しない(バイパスの管理も要る) |
| Copilot coding agent | スコープが決まった変更を準備する | 人間の承認の代わりにはならない |
| Environments | デプロイを制御する | マージの承認を本番リリースの承認に置き換えない |
段階ごとの責任分担も示されています。
| 工程 | 関わる人 | 責任を持つ人 |
|---|---|---|
| 仕様 | プロダクト・開発・QA | 要件のオーナー(テックリードがレビュー) |
| 計画 | 開発・アーキテクチャ・サービスオーナー | テックリード |
| タスクと実装 | 開発・QA | 技術オーナー+ピアレビュー |
| 統合受け入れ | 各サービスのチーム・QA | ケイパビリティのオーナー+プロダクトの受け入れ |
ここでのキーワードは 「関わる(envolvido)」と「責任を持つ(responsável)」の区別 です。開発者を巻き込んでも、判断を検証する責任が消えるわけではありません。
自動化について元記事が描くのは、4 つの役割が回る「半自動のサイクル」です。
- Action が抜けを検出する
- Issue に作業を記録する
- 人間が推奨内容を確認する
- エージェントがレビュー用の PR を準備してもよい
決定的な計測・AI による提案・人間の判断を分けて扱うのが原則です。チェックは最初は情報提供にとどめ、慣れてからブロッキングにします。ワークフローには最小権限を与え、シークレットを保護し、信頼できない PR のコードを特権付きで実行しないようにします。例外には理由・オーナー・見直し日を付けます。
なお、こうしたスキャナーとそのルールは自分たちで作って保守するものであり、Spec Kit に最初から入っているものではない、と元記事は念を押しています。
6. 計測:活動ではなく結果を測る
最後の段階で元記事が強調するのは、Copilot の利用は SDD の定着と同じではない ということです。文書の数、コマンドの実行回数、インストール数は「どこまで届いたか」を示すだけで、エンジニアリングが良くなったかどうかは示しません。
代わりに提案されている観点は次の 5 つです。
| 観点 | 見るもの |
|---|---|
| トレーサビリティ | 変更が spec → 実装 → 検証とつながっているか |
| 明確さ | 曖昧な要件による手戻り |
| 協調 | サービスをまたぐ依存関係を、実装前に見つけられたか |
| レビュー | レビューにかかる時間と、求められた修正の種類 |
| 持続性 | 一部の人に頼らず実践が続いているか |
指標にはベースラインと文脈が要ります。リードタイムが変わっても、それを自動的に SDD の成果と見なしてはいけません。spec.md・plan.md・tasks.md が揃っていることは「存在」を示すだけで、正しさや安全性を示すものではありません。スコアで定性的な分析を置き換えることもできません。
実際にどう進めるか
2 つの協調モデル
元記事は、今の進め方と比べてみるべきモデルを 2 つ挙げています。
- (a) アンカーリポジトリで横断的に計画する:各サービスが自分のスライスを再検証して詳細化する
- (b) 既存のセレモニー(スプリント計画などの定例の会議体)とバックログで協調する:SDD は各リポジトリの中だけで行う
(b) を選ぶなら、計画の規律、互換性のある契約、要件に紐づいたテストが条件になります。変更は自己完結させて後方互換に保つのが基本です。たとえば、あるサービスが新しい任意属性を「受け取れる」ようにしてから、別のコンポーネントがそれを「送る」ようにします。こうしてデプロイと有効化を分けます。
どちらのモデルでも、要件には安定した ID を振ってテストと結びつけます。元記事の例では「AC-03」という受け入れ基準は、タスクの本文に書かれているだけでは不十分で、検証の証拠が必要です。
2 つのモデルは共存できます。単純な変更はローカルで、横断的なケイパビリティは合同で計画する、という使い分けです。元記事は「中央集権化を強めれば、自動的に成熟度が上がるわけではない」とも書いています。
展開の順序
まず開発フローを明示します(成果物をいつレビューするか、誰がどの判断に責任を持つか、ブランチと PR の使い方、依存関係の記録方法)。自動化と計測はその後です。展開は次の順に進めます。
- 診断:どこで詰まっているかを特定する
- 基盤づくり:フローと責任分担を決める
- パイロット:1 つのサービスで試す
- 段階的な自動化:情報提供のチェックから始める
- 拡大:プレイブック、チャンピオン(各チームの推進役)、成果の追跡
次の段階に進むかどうかは、日付だけで決めず、得られた学びと合意した終了条件で判断します。
詰まっている場所の見分け方
診断のヒントも具体的です。
- 曖昧さが繰り返し出る → spec と明確化の質を見直す
- チーム間で解釈が食い違う → ガードレールと責任分担を見直す
- サービス間の依存で問題が起きる → 横断的な計画とトレーサビリティを見直す
コストの確認
ツールキット自体はオープンソースですが、AI のライセンス、ワークフローの実行時間、ランナー、ストレージには費用がかかることがあります。パイロットを広げる前に、機能の有効化、権限、利用上限、オーナーを確認します。価格やクォータは変わるので、その時点の公式ドキュメントで確かめるよう勧めています。
まとめ
元記事の結論は、SDD を広げるとは すべてのリポジトリに同じファイル構成をコピーすることではない、というものです。意図・判断・実装・検証をつなぐ「共通のやり方」を組織として作ることが目的です。
Spec Kit はその道のりを支える道具です。しかし成熟度を決めるのは、組織がこの実践を自分たちのアーキテクチャと働き方にどう組み込むかです。そうなったとき、仕様は個人の道具ではなくなり、人・チーム・サービスのあいだで共有される「理解の契約」として機能します。
元記事を紹介した X の投稿(参考リンク参照)が勧めるとおり、まずは 1 つのサービスで試す ところから始めるのが現実的でしょう。そのときは全体像の表にある「次へ進む合図」を手元に置き、自分たちがまだ満たしていない合図はどれかを確かめてください。どの段階で詰まっているのかが見えてきます。