概要
Harness²(Harness squared)は、Google Research が公開したエージェントのハーネスをエージェント自身に改善させるフレームワーク。モデルの重みには触れず、正解データも使わずに、タスクごとにハーネスを磨く。論文は「Harness²: Recursive Agent Harnessing for an Open World」(arXiv:2610.14224)、実装は google-research/harness2(Apache-2.0)。
日常の開発にそのまま組み込むツールというより研究用のフレームワークで、利用者はこれを使って作られたハーネスから恩恵を受ける、という受け止め方もある。
詳細
編集対象のハーネス
README はハーネスを「モデルをエージェントとして働かせる周辺一式(prompts, tools, memory, skills, orchestration, and more)」と定義し、それを最適化する作業を Harnessing と呼ぶ。通常のハーネスは人間が一度設計して固定するが、Harness² はタスクごとにエージェントが調整する。編集対象は 8 コンポーネント。
| 役割 | コンポーネント |
|---|---|
| コンテキストの構築 | system prompt、guardrails、memory、skills |
| ツールのインターフェース | tool guidance、scripts |
| 委譲のオーケストレーション | subagents |
| ミドルウェア(ツールループ内の振る舞い) | plugins |
Claude Code でいえば CLAUDE.md、Agent Skills、サブエージェント定義、hooks あたりに当たる。
2 段階の再帰
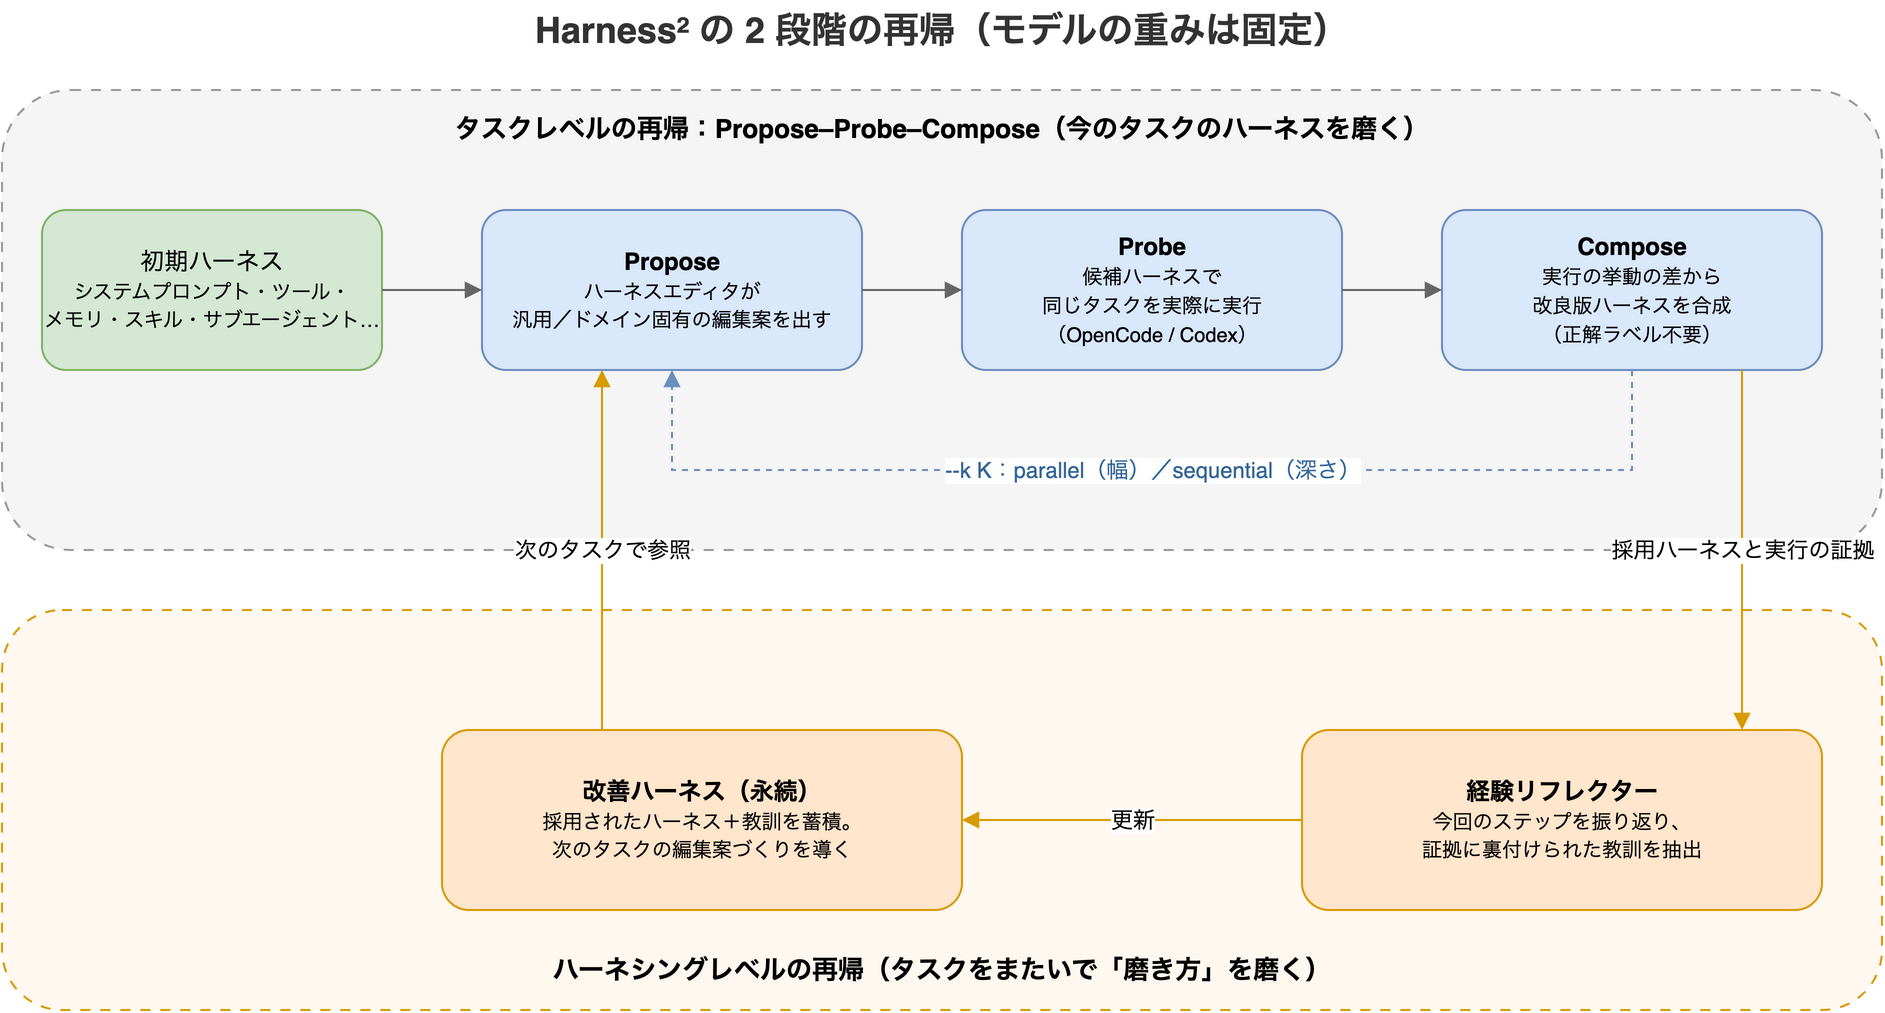
タスクレベル(Propose–Probe–Compose):いま取り組むタスクの実行用ハーネスを磨く。
- Propose — ハーネスエディタが汎用的な編集案とドメイン固有の編集案を出す
- Probe — 編集を入れた候補ハーネスで同じタスクを実際に実行する。executor は OpenCode(既定)か Codex
- Compose — 複数の実行の挙動の違い(behavioral contrasts)を比べ、改良版を合成する
「どちらが正しいか」ではなく「ハーネスを変えたら挙動がどう変わったか」から学ぶので、正解データや採点器が要らず、答えの用意されていない未知のタスク(open world)にも適用できる。
ハーネシングレベル:タスクが 1 件終わるたびに経験リフレクターが振り返り、採用されたハーネスと、複数の実行で裏付けが取れた教訓(evidence-supported lessons)を永続的な「改善ハーネス」に書き戻す。次のタスクはこの蓄積から始まる。1 段目が「ハーネスを磨く」、2 段目が「ハーネスの磨き方を磨く」。
ベンチマーク(README の報告)
3 つの専門業務系ベンチマーク × 4 つのモデル×ハーネス構成で評価し、1 ステップ回しただけで GLM-5 と Gemini 3.5 Flash がいずれも元のハーネスを上回った。--k を増やすとさらに伸びたとされる。
| ベンチマーク | 内容 | 改善幅(最大) |
|---|---|---|
| WorkBuddy-Bench | オフィス・Web・コード | 11.5 ポイント |
| JobBench | 専門職の業務 | 4.5 ポイント |
| LAB | 法務 | partial pass rate で 11.8 パーセントポイント |
試し方
動作環境は Linux・Python 3.12・uv。clone したリポジトリで uv pip install -e '.[render]' の後、harness2-demo --output runs/demo --k 2 を実行すると、モデルを呼ばない決定論的なエディタと実際の Python 実行で両方の再帰を動かせる(認証情報不要)。
モデルを使うベンチマークには Node.js 20 以上と Google Cloud CLI が要り、既定は Vertex AI 前提。LAB には Pandoc と Poppler、WorkBuddy-Bench には Docker が別途必要。harness2-setup → harness2-check → harness2 → harness2-judge → harness2-report の順に流し、judge と report には改善実行と同じベンチマーク・executor・subset・--k・--mode・seed を渡す。--dry-run でタスク選択だけ確認できる。
| オプション | 動作 |
|---|---|
--k 1 | Propose–Probe–Compose を 1 ステップ |
--k K --mode parallel | 汎用・ドメイン固有の候補を K 個ずつ試し K 個の合成を作る(幅) |
--k K --mode sequential | 改良したハーネスと証拠を引き継いで K ステップ磨く(深さ) |
--substrate cx | executor を Codex にする |
結果は runs/ 以下(タスク要約・成果物・採用ハーネス・振り返りメモ・評価結果)に残り、再実行で中断箇所から再開する。
注意点
- executor のネットワークに制限はなく、Codex はサンドボックス無効で動く
- 公開ベンチマークの採点基準はネット上にあるので、評価前にネットワーク制限を設定するよう README が注意している
- Probe は候補ごとにタスクを実際に走らせるので、
--kを増やすほど API 費用が増える - 「not an officially supported Google product」と明記されている
自作ハーネスへの応用
- 正解がなくても比較はできる:同じタスクを 2 通りの指示で走らせて挙動の差を見る Probe の発想は、
CLAUDE.mdやスキルの文言を変えたときの効果確認に使える - 教訓は証拠付きで残す:1 回の成功ではなく複数の実行で再現した差だけを書き戻すと、メモリやルールファイルが思いつきで膨らむのを防げる
- 磨き方を別に持つ:実行用ハーネスと改善用ハーネスを分ける構造は、レビュー用エージェントやルール改善のスキルを本体の指示から切り離す設計と重なる
関連ページ
- 自己改善エージェント — ハーネスを AI 自身が改善するパターン全般
- ハーネスエンジニアリング — 改善対象となるハーネスの構造
- AutoAgent — スコアと失敗トレースで回す同系統の OSS
- 作る役と確かめる役の分離(maker-checker) — 評価を改善主体から切り離す考え方
ソース記事
- Harness²:エージェントが自分のハーネスを磨き続ける Google Research の OSS — 2026-10-30