Claude Code はセッションの全履歴を JSONL で書き出している。ここを直接読めば、/cost や /context では見えないターンごとのトークン推移、ツール呼び出しの傾向、コンパクションの発動位置まで全部取れる。「開発ログを資産化しよう」という記事が増えているのも当然で、実際に有用だ。
ただ、解説記事を 4 本読んで手元のログに当ててみたら、前提のかなりの部分が自分の環境では成り立たなかった。しかも成り立たない箇所の多くが、エラーではなく「出力 0 件で成功する」形で外れる。パーサを書いてから気づくのが一番遅い種類の失敗だ。
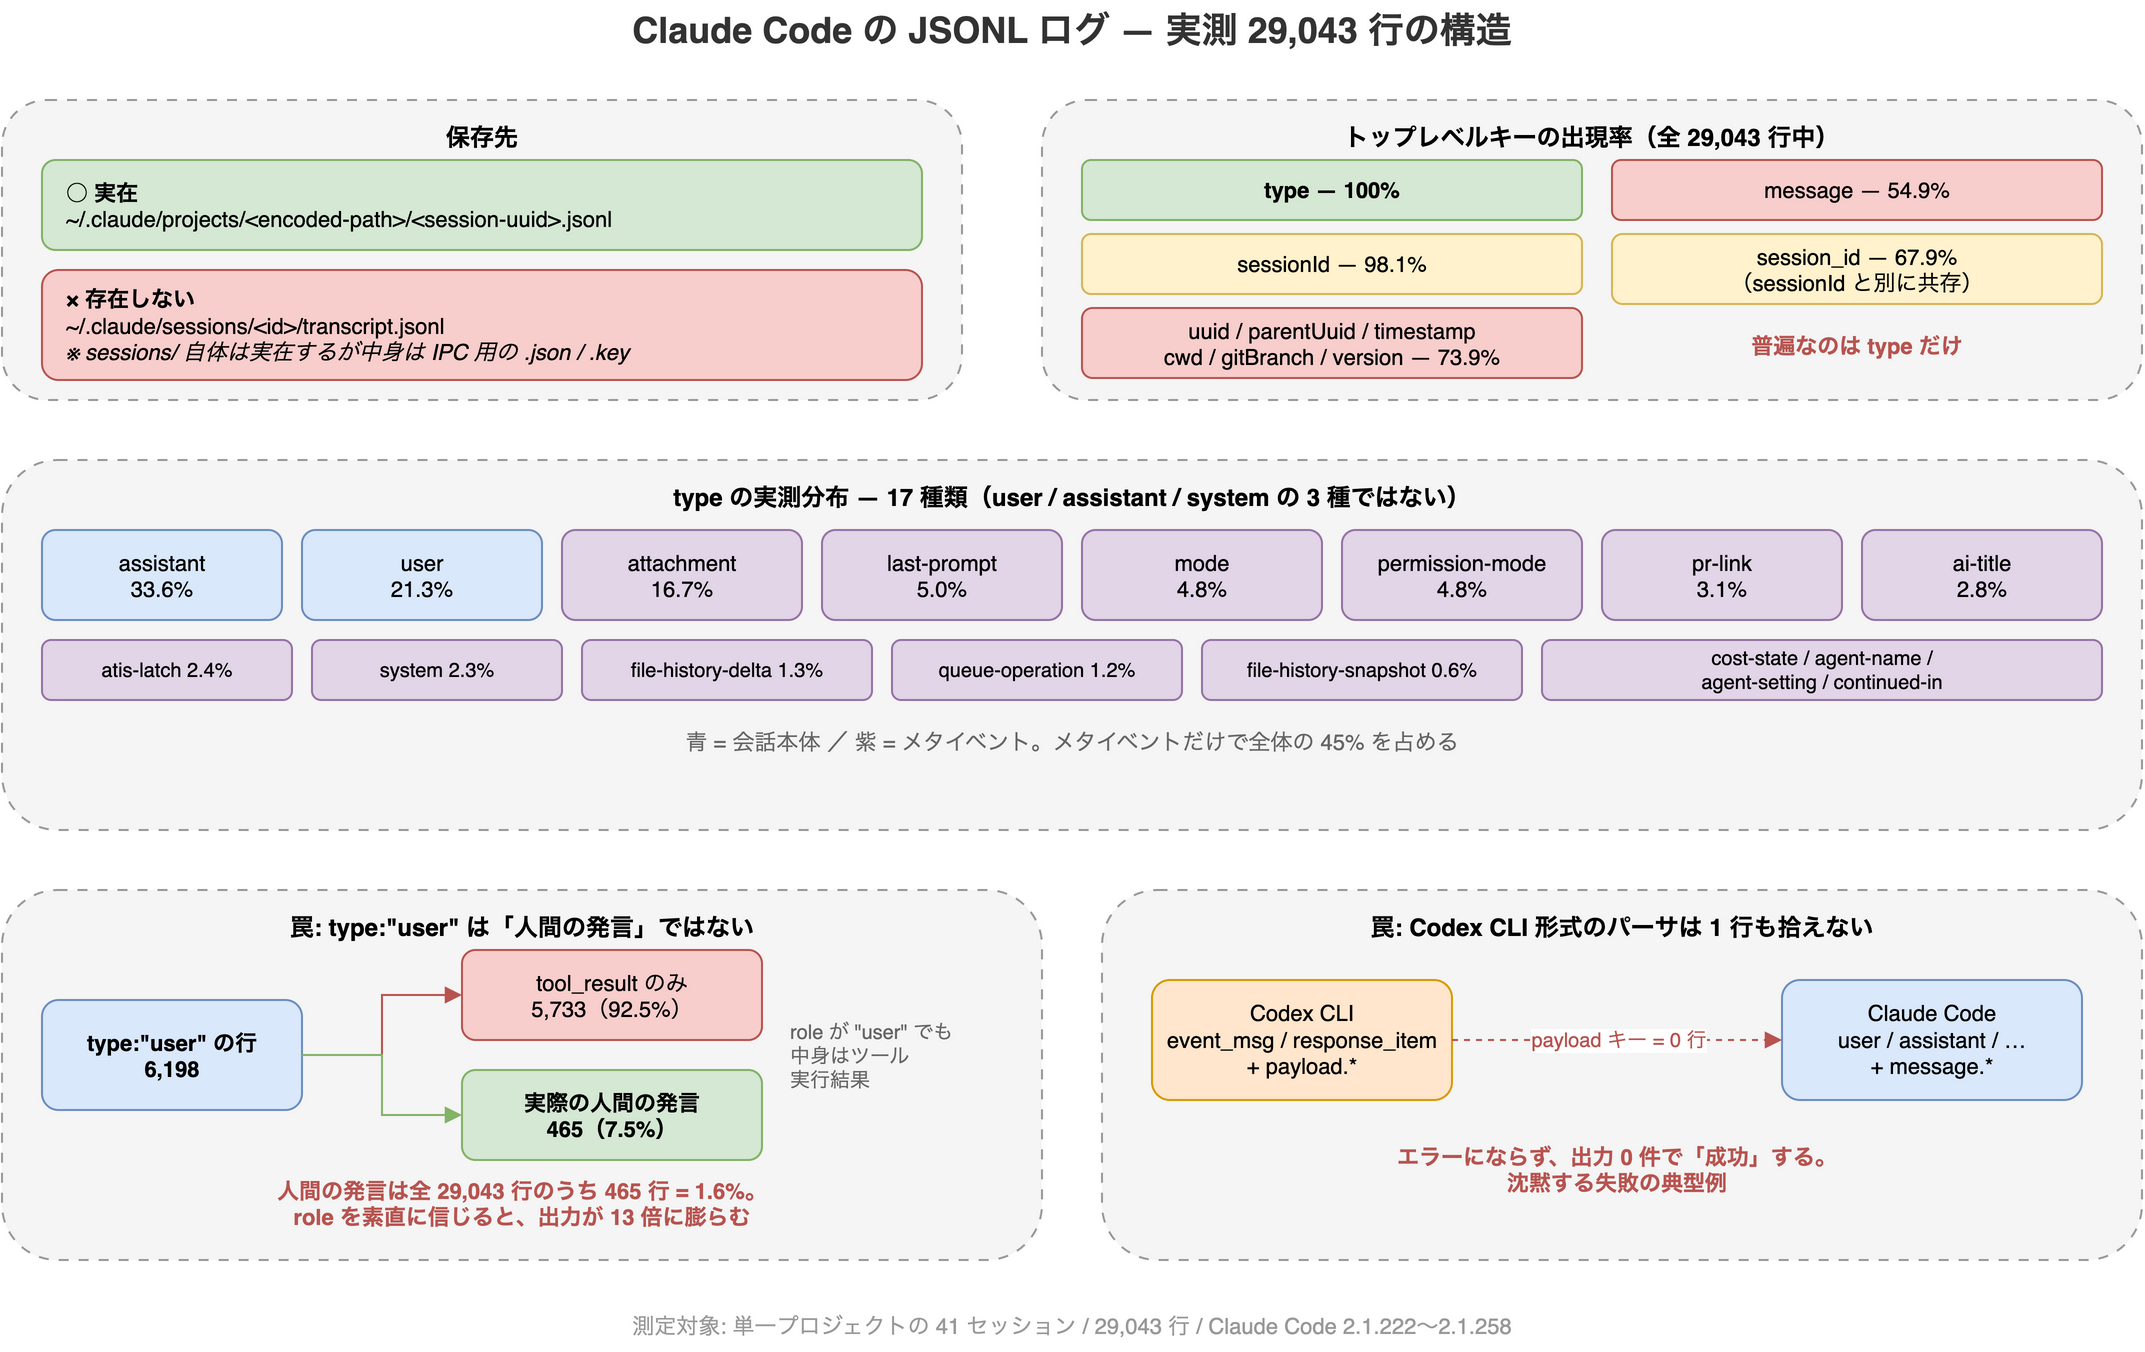
そこで、単一ファイル観察の偏りを避けるため、同一プロジェクトの 41 セッション・29,043 行を母集団として横断集計した。以下はその実測結果と、参照した 4 本の記述との突き合わせである。
この記事でわかること
- 会話ログの保存先は
~/.claude/projects/で、~/.claude/sessions/は別物(しかし実在する) - JSONL が規格化しているのは「1 行 1 JSON」という封筒だけで、行の中のスキーマは規格外
- 全行に存在するトップレベルキーは
typeただ 1 つ typeは 17 種類あり、45% は会話ではないメタイベントtype: "user"の 92.5% は人間ではなくツール実行結果- 他 CLI 向けのパーサは、エラーではなく 0 件で「成功」する
usageによるトークン集計の手法は再現するが、そこで得た定数は再現しない
検証環境
| 項目 | 値 |
|---|---|
| 対象 | 単一プロジェクトの 41 セッション |
| 総行数 | 29,043 行(JSON パース失敗 0 行) |
| Claude Code | 2.1.222 〜 2.1.258 |
| モデル | claude-opus-5(9,502 ターン)、claude-sonnet-5(250 ターン)、<synthetic>(4 ターン) |
| OS | macOS |
数値はすべてこの母集団での実測値である。バージョンによってスキーマは動くので、絶対値ではなく確認の手順として読んでほしい。
なお、集計しているセッション自身もログを書き続けているので、行数は測るたびに増える。上の 29,043 行は単一時点のスナップショットで、本記事の全数値はこの 1 回のパスから取った。異なるタイミングの集計結果を混ぜると、内訳の合計が合わなくなる。「自分を含む母集団」を数えるときは1 パスで全指標を出すのが安全だ。
実際に使った集計スクリプトは、記事中のスニペットを 1 本にまとめたものである。以下では説明のために分割して載せる。
1. Claude Code のログの保存先は ~/.claude/projects/ — sessions/ は罠として実在する
まず保存先。ここが最初の分岐点だ。
正しいのはこちら:
~/.claude/projects/<encoded-project-path>/<session-uuid>.jsonlプロジェクトパスがディレクトリ名にエンコードされる(/Users/you/code/my-app → -Users-you-code-my-app)。1 セッション 1 ファイルで、ファイル名はセッション UUID、追記専用だ。これは claude-devtools のフォーマット解説の記述と一致した。
一方、CayTech Lab の記事は次のパスを挙げていた。
~/.claude/sessions/<セッションID>/transcript.jsonl手元では transcript.jsonl は 1 件も存在しない。にもかかわらず——ここが厄介なところだが——~/.claude/sessions/ 自体は実在する。
ls ~/.claude/sessions/3343.json
3343.<hash>.key
40283.json
40283.<hash>.key
...中身はポート番号を冠した .json と .key で、会話ログではない。つまり、記事のパスを辿った人は「そんなディレクトリはない」とすぐには気づけない。実在するが目的のファイルが無いディレクトリに着地するからだ。find で transcript.jsonl を探して 0 件、という一段深いところまで行かないと判断できない。
.key のほうはパーミッションが 600 で、ファイル名がポート番号+ハッシュという形をしている。用途は公開情報として確認できていないが、名前と権限からしてローカル接続の認証用と見るのが自然で、少なくとも会話ログではない。ログ調査のついでに中身を開いたり貼ったりしないほうがいい。この記事でもファイル名しか見ていない。
自分の環境で確かめるならこれで足りる。
ls -d ~/.claude/projects
find ~/.claude/sessions -name 'transcript.jsonl' | wc -lこれは当該記事の他の内容を否定するものではない。バージョンによって置き場所が変わった可能性も十分ある。要はパスは自分の環境で確認してから使う、というだけの話だ。
2. 全行にあるトップレベルキーは type だけ
前置き: JSONL が規格化しているのは「封筒」だけ
キーの話に入る前に、そもそも何が規格として決まっているのかを押さえておきたい。ここを誤解すると「JSONL の仕様書を読めばスキーマが分かるはず」という期待が生まれる。
JSONL は標準化団体の規格ではない。jsonlines.org にドキュメントがあり、要件は 3 つだけと明記されている。
- UTF-8 エンコーディング(BOM は付けない)
- 各行が valid な JSON value(
nullは有効な行だが、空行は無効) - 行終端は
\n(\r\nも、JSON パース時に前後の空白が無視されるので許容)
同ページは MIME タイプについて「application/jsonl かもしれないがまだ標準化されていない。RFC を書く手伝いをしてくれるならありがたい」と書いている。つまり仕様書の側が自ら「RFC は無い」と言っている状態だ。各行の中身は RFC 8259(JSON 本体)に従うので、「行の中身は IETF 正式規格、行で区切る部分はコミュニティ規約」という二層構造になっている。
紛らわしい隣接フォーマットが 2 つあるので、区別しておく。
| 位置づけ | MIME | 拡張子 | 行区切り | |
|---|---|---|---|---|
| JSON Lines | jsonlines.org のコミュニティ仕様 | application/jsonl(未登録) | .jsonl | \n(\r\n 可) |
| NDJSON | ndjson-spec v1.0.0(2013 年作成、2014-10-19 から更新なし) | application/x-ndjson(未登録) | .ndjson | \n(\r\n 可) |
| JSON text sequences | RFC 7464(IETF 正式 RFC) | application/json-seq(IANA 登録済み) | — | 各レコードの前に RS 0x1E |
RFC 7464 だけが正式規格だが、レコードの前に Record Separator (0x1E) を必ず置くためJSONL とはバイト列として非互換だ。Claude Code のログは RS を使っていないので、これは別物と考えてよい。
NDJSON は JSON Lines と実質同じもので、jsonlines.org 自身が冒頭で「newline-delimited JSON とも呼ばれる」と別名として扱っている。ただし NDJSON 側の仕様書は RFC 2119 の MUST / SHOULD 語法で書かれていて、細部が一致しない。実務で効きうる差は空行の扱いだ。JSON Lines は「空行は無効」と言い切るのに対し、NDJSON は「パーサは空行を黙って無視してもよい(MAY)。ただしその挙動は文書化しなければならず、ユーザーが設定可能であるべき」としている。同じファイルを両者のパーサに通して結果が変わるとしたら、まずここを疑うことになる。
そして肝心なのは、どの仕様も「封筒」しか決めていないという点だ。1 行に JSON が 1 個入っていること以外、行の中の構造は完全にアプリケーション定義である。だから JSONL の仕様書をいくら読んでも、Claude Code の type に 17 種類あることも、role: "user" の 92.5% が tool_result であることも書いてあるはずがない。参照した 4 本の記述が食い違っていたのは、参照すべき共通の権威がそもそも存在しないためだ。以下で数えているのは、規格の隙間にあたる部分ということになる。
実測: 100% なのは type のみ
フォーマット解説の中には「すべてのエントリは少なくとも type / uuid / parentUuid / timestamp / sessionId / cwd / gitBranch / version を持つ」と書いているものがある(前掲の claude-devtools)。実測はこうだった。
| キー | 出現率 |
|---|---|
type | 100.00% |
sessionId | 98.06% |
timestamp | 79.45% |
uuid / parentUuid / cwd / gitBranch / version / isSidechain / userType / entrypoint | 73.88% |
session_id | 67.86% |
message | 54.93% |
普遍なのは type だけだ。uuid や timestamp は 4 分の 1 以上の行に無い。message は半分程度しかない。
これは実務上そのまま効く。o['uuid'] と直接添字を書けば 26% の行で KeyError になる。.get() で逃げていても、parentUuid で会話ツリーを再構成するならそのツリーはログの 74% 分しか張られていない。
もうひとつ地味に効くのが sessionId(98.06%)と session_id(67.86%)の共存だ。キャメルケースとスネークケースが同じログに別キーとして併存している。どちらか片方だけ見ていると取りこぼす。
集計はこれで再現できる。
import json, glob, collections, os

pattern = os.path.expanduser('~/.claude/projects/<encoded-path>/*.jsonl')
files = glob.glob(pattern)
assert files, f'0 ファイル。パスを確認: {pattern}'

top = collections.Counter()
total = 0
for f in files:
    for line in open(f, encoding='utf-8', errors='replace'):
        line = line.strip()
        if not line:
            continue
        try:
            o = json.loads(line)
        except Exception:
            continue
        total += 1
        for k in o:
            top[k] += 1

for k, c in top.most_common(20):
    print(f'{100*c/total:6.2f}%  {k}')
glob.glob('~/...') はチルダを展開しないので、os.path.expanduser を通さないとエラーも出さずに 0 件で終わる。この記事のテーマそのものなので、assert も一緒に入れておく。
3. JSONL の type は 3 種類ではなく 17 種類ある
「user / assistant / system の 3 種」という説明をよく見るが、実測では 17 種類だった。前掲のスクリプトの集計対象を top[o.get('type')] += 1 に変えれば、そのまま下表が出る。
| type | 割合 | 位置づけ |
|---|---|---|
assistant | 33.59% | 会話本体 |
user | 21.34% | 会話本体 |
attachment | 16.69% | メタ |
last-prompt | 5.03% | メタ |
mode | 4.79% | メタ |
permission-mode | 4.79% | メタ |
pr-link | 3.10% | メタ |
ai-title | 2.79% | メタ |
atis-latch | 2.38% | メタ |
system | 2.26% | メタ |
file-history-delta | 1.32% | メタ |
queue-operation | 1.15% | メタ |
file-history-snapshot | 0.62% | メタ |
cost-state | 0.10% | メタ |
agent-name | 0.03% | メタ |
agent-setting | 0.01% | メタ |
continued-in | 0.00%(1 行) | メタ |
会話本体は合わせて 54.93% で、残りの 45.07% はメタイベントだ。attachment だけで 16.69% を占めているのが目を引く。
ここは「知らない type は捨てる」で実装しておくのが正解で、else: raise にしてはいけない。バージョンが上がるたびに新しい type が増える前提の場所だ(実際 agent-name や continued-in は数行しか出ていない新顔に見える)。逆に、メタイベントには使える情報も混ざっている。pr-link には PR 番号・URL・リポジトリが、cost-state にはセッション累計のコストと所要時間が入っていた。
「解説を写経せず自分で数える」という進め方自体は、ECC の agent 定義 68 個を実際に集計した回と同じである。あちらは定義ファイル、こちらは実行ログという違いだけだ。
4. type: "user" は「人間の発言」ではない
これが一番実害の大きい罠だった。type: "user" の行を人間の発言として扱うと、桁が狂う。
| 内訳 | 件数 |
|---|---|
type: "user" の行 | 6,198 |
└ content が tool_result のみ | 5,733(92.5%) |
└ content が文字列 | 371 |
└ content が text ブロックを含む配列 | 94 |
| 実際の人間の発言 | 465(7.5%) |
ツール実行結果はモデルに返すために role: "user" で記録される。だから user 行の 92.5% は人間が書いたものではない。29,043 行のうち人間の発言は 465 行、全体の 1.6% にすぎない。
role を素直に信じて整形すると、出力が 13 倍に膨らんで、その大半が tool_result の巨大な JSON になる。「ログが読めない」の原因の一端はこれだ。
判定はこうなる。
def is_human_utterance(o):
    if o.get('type') != 'user':
        return False
    msg = o.get('message')
    if not isinstance(msg, dict):
        return False
    c = msg.get('content')
    if isinstance(c, str):
        return bool(c.strip())
    if isinstance(c, list):
        return any(i.get('type') == 'text' for i in c if isinstance(i, dict))
    return False
content が文字列の場合と配列の場合の両方ある点に注意。今回の母集団では 371 件が文字列、5,827 件が配列だった。
なお、公開されているエクスポータの中には「配列内に tool_result が 1 つでもあればそのメッセージ全体をスキップ」という実装がある。今回の母集団では text と tool_result が同一配列に混在するケースが 0 件だったので、この実装で人間の発言が失われることはなかった。ただし混在しないことが保証された仕様なのかは確認できていないので、text ブロックだけを抜く上記の書き方のほうが安全だと思う。
promptId は user 行 6,198 のうち 6,192 件に付いていた。ほぼ全行にあるので人間の発言を絞り込む用途には使えないが、同一 promptId でターンをグルーピングする——つまり「1 回の指示に対してどれだけのツール往復が発生したか」を数える——のには使える。人間の発言そのものを拾いたいなら type: "last-prompt"(1,461 行)のほうが素直だ。
5. 他 CLI 向けのパーサを流用すると 0 件で「成功」する
dazoyee 氏の記事は、会話ログ整形スキルの SKILL.md の description に「会話ログ(Codex/Claude)から…」と Claude を明記している。一方で本文の実装は Codex CLI のスキーマ前提だ。
if msg_type == "event_msg" and payload.get("type") == "user_message":
    return {"role": "user", ...}
if msg_type == "response_item" and payload.get("role") == "assistant":
    return {"role": "assistant", ...}
if msg_type == "response_item" and payload.get("type") == "function_call":
    return {"role": "mcp_call", ...}
これを 29,043 行に当ててみた結果:
total_lines             29043
lines_with_payload_key  0
codex_matched           {}
codex_unmatched         29043
payload というキーが1 行も存在しない。元記事が示している Codex CLI のサンプルは event_msg / response_item + payload.* という形をしている。Claude Code の user / assistant + message.* とは階層が丸ごと違う。(Codex 側のスキーマは筆者は未検証で、元記事の記載による。)
問題は落ち方だ。payload = obj.get("payload", {}) で受けているので KeyError にはならず、全行が「該当なし」として静かに捨てられる。スクリプトは正常終了し、出力は空。エラーではなく 0 件成功として返ってくる。
同じ構図は前にも踏んだことがある。Video Use の「沈黙する失敗」では ffmpeg が成功しても動画が壊れていたし、Invidious の公開インスタンスを実測した回では監視サイトの稼働率 97〜100% に対して実到達が 5 件中 0 件だった。終了コードだけ見ていると通ってしまう類の失敗で、対策も同じ——件数をアサーションに入れる。
assert matched > 0, f'0 件しか抽出できていない(総行数 {total})。スキーマ想定を疑うこと'補足: MCP 呼び出しの抽出
Claude Code で MCP 呼び出しを拾うなら、assistant 行の content 配列内の tool_use ブロックを見る。実測では 18 種類・5,734 ブロックだった。
| ツール | 呼び出し数 |
|---|---|
Bash | 3,924 |
Edit | 615 |
Write | 357 |
Read | 202 |
WebSearch | 192 |
WebFetch | 122 |
mcp__aegis__aegis_fetch | 96 |
Agent | 92 |
MCP ツールは mcp__<server>__<tool> という命名なので、name.startswith('mcp__') で選別できる。サーバー名にハイフンが入り得るので、分割は最初と最後の __ を基準にするのが無難だ。
tool_use の id と tool_result の tool_use_id で突き合わせると、ユニークな tool_use が 5,654 件、対応する tool_result が 5,653 件で、結果の無い tool_use が 1 件だけあった。集計時点で実行中だった呼び出しである。ブロック数(5,734)とユニーク ID 数(5,654)が一致しないのは同一 ID の行が複数記録されるケースがあるためで、こちらの理由は未確認。ツール呼び出し回数を数えるなら、ブロック数ではなくユニーク ID 数で数えるほうが安全だ。
6. トークン集計は再現するが、「固定値」は固定ではなかった
手法はそのまま再現する
usage を使ったコンテキスト分析は、参照記事の手法がそのまま再現できた。assistant 行 9,756 件すべてに usage があり、欠損 0 件。
u = o['message']['usage']
ctx = u['input_tokens'] + u['cache_read_input_tokens'] + u['cache_creation_input_tokens']
この ctx がそのターンの実プロンプトサイズになる。集計結果:
| 指標 | 累計(41 セッション) |
|---|---|
| 直接入力トークン | 35,230 |
| 出力トークン | 7,870,802(約 7.9M) |
| キャッシュ書き込み | 35,332,521(約 35.3M) |
| キャッシュ読み込み | 2,068,943,856(約 2.07B) |
| キャッシュヒット率 | 98.32% |
ヒット率は cache_read / (input + cache_read + cache_creation) で算出した。直接入力が出力より 2 桁小さいのは、入力側がほぼ全量キャッシュ経由になるためだ。Claude Code コンテキストガイドの 93.7% と傾向は一致した(ただし定義式が同じかは未確認なので、比較は参考程度に)。手法自体は妥当だと言える。
「固定値」は固定ではなかった
一方、「初回ターンの cache_read_input_tokens は全セッションで 20,281 に一致し、これが Claude Code 固有の固定コストである」という主張は再現しなかった。
| 指標 | 実測 |
|---|---|
初回ターンの cache_read | 40 セッション中 14 通りに散った |
| 最小 / 最大 | 0 / 30,799 |
| 中央値 | 24,167 |
母集団が 41 ではなく 40 なのは、assistant 行を 1 行も含まないセッションが 1 件あるためだ(起動しただけで終わったもの)。最小値 0 は、初回ターンでまだキャッシュが生成されていないケースである。
固定値どころか 0 から 30,799 まで散っている。環境・バージョン・モデルが違えば当然変わる数字で、「全セッションで一致した」のは観測期間中に構成が変わらなかったからだと考えるのが自然だ。手法(初回ターンの cache_read を見る)は有効だが、そこで得た定数は自分の環境の定数にすぎない。筆者も 1 ファイルだけ見ていた段階では「全セッションで一致する」と同じ結論を出していた。母集団を数えて初めて散らばりが見えた。
同じ理由で、コンパクションの発動閾値も鵜呑みにできない。ピークコンテキストをモデル別に出すとこうなった。
| モデル | ピーク ctx | ログから言えること |
|---|---|---|
claude-opus-5 | 765,226 | ウィンドウは 200K ではない(1M 版を使用) |
claude-sonnet-5 | 156,568 | 200K に収まる範囲 |
claude-opus-5 側が 765K に達しているのは異常値ではなく、1M コンテキストの構成で走らせていたからだ。逆に言うと、ログの model 文字列だけではウィンドウ長は決まらない(同じモデル名で 200K 版と 1M 版がある)。だから 200K を前提にした「165K〜170K が実質的な天井」は、そのまま他環境に持ち込めない。閾値を語るときは、モデル名だけでなく実際のウィンドウ長をセットで書く必要がある。ピーク ctx の実測は、その環境が何 K で走っていたかを事後に確認する手段としても使える。
なお model には <synthetic> という値も 4 件あった。API 呼び出しを伴わない内部生成メッセージらしく、コスト集計時にはこれを除外しないと単価計算が壊れる。
トークンを外部から実測して削るという話は CLAUDE.md+SKILL.md の英語化で 37.6% 削減した回、コンテキストが劣化していく側の話は Context Rot を防ぐ 5 つの選択肢にまとめてある。
まとめ
JSONL ログを触るなら、解説記事のスキーマ記述を写経する前に、自分のログを数えたほうが早い。
- 保存先は
~/.claude/projects/<encoded>/<uuid>.jsonl。~/.claude/sessions/は実在するが会話ログはない - 全行にあるトップレベルキーは
typeだけ。uuidやtimestampは 73.88%、messageは 54.93%。sessionIdとsession_idが共存する typeは 17 種類あり、45.07% はメタイベント。知らない type は捨てる実装にするtype: "user"の 92.5% はツール実行結果。人間の発言は全体の 1.6%- 他 CLI 向けのパーサは 0 件成功する。抽出件数をアサーションに入れる
usageによる集計手法は再現するが、そこから得た「固定値」や「閾値」は環境依存。モデルのウィンドウ長とセットで扱う
最初に走らせるべきは整形スクリプトではなく、type の分布とキー出現率を出す 20 行ほどの集計だ。それを見てからパーサを書けば、沈黙する失敗のほとんどは避けられる。
参考
- Claude Code コンテキストガイド(zenn.dev / yokkomystery) — §6 のトークン集計手法と「固定値」の出典
- 会話ログ(JSONL)を整形するスキルを作った(zenn.dev / dazoyee) — §5 の Codex 形式パーサの出典
- Claude Code セッションログを一括 MD 化(CayTech Lab) — §1 の保存先と §4 のフィルタ実装の出典
- Claude Code JSONL transcript format explained(claude-devtools) — §1 の正しい保存先と §2 のキー一覧の出典
フォーマット自体の一次情報:
- JSON Lines — 3 要件と「MIME は未標準化」の記述
- ndjson-spec v1.0.0 — NDJSON 側の仕様(空行の扱いの差異)
- RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format — 各行の中身が従う規格
- RFC 7464: JavaScript Object Notation (JSON) Text Sequences / IANA
application/json-seq— RS 前置の別フォーマット