DuckLake は、DuckDB の開発チームが作ったレイクハウスフォーマットです。データは Parquet ファイルとして S3 などに置き、メタデータはすべて PostgreSQL などの SQL データベースに格納します。2026 年 4 月に v1.0 がリリースされ、本番利用できる段階になりました。
前回の記事 Apache Iceberg 入門:データレイクを「テーブル」にする仕組みと DuckDB との関係 では、Iceberg の仕組みと、DuckDB から Iceberg テーブルを読み書きする方法を整理しました。その最後で「DuckDB だけで完結する構成なら DuckLake も選択肢になる」と簡単に触れています。この記事ではその DuckLake を掘り下げ、設計思想、DuckDB での使い方、v1.0 の主な機能、Iceberg との互換性と使い分けを順に見ていきます。
DuckLake とは
| 項目 | 内容 |
|---|---|
| 発表 | 2025 年 5 月 27 日 |
| v1.0 | 2026 年 4 月 13 日(DuckDB v1.5.2 の ducklake 拡張で利用可能) |
| データ | Parquet ファイル(S3 などのオブジェクトストレージ、ローカルディスク) |
| メタデータ | カタログデータベース(PostgreSQL、SQLite、DuckDB など) |
| ライセンス | MIT(仕様と ducklake 拡張の両方) |
v1.0 のリリースアナウンスによると、v1.0 は本番利用できる仕様として出され、後方互換性が保証されています。次の v1.1 について、公式 FAQ は 2026 年 9 月の予定としていました。その後、リリースカレンダーでは 2026 年 10 月 21 日(暫定)に更新されています。
なぜメタデータを SQL データベースに置くのか
DuckLake の設計思想は、公式サイトの DuckLake Manifesto(以下、Manifesto)にまとまっています。出発点となる主張を要約すると、次のとおりです。
Iceberg や Delta Lake は、データベースを使わずに済むよう設計された。それなのに、結局カタログ層でデータベースを使っている。
前回の記事で見たとおり、Iceberg のカタログは「テーブル名 → 最新のメタデータファイルの位置」を管理するだけで、その裏には何らかのデータベースがあります。データベースがどうせ必要なら、残りのメタデータも全部そこに入れればいい、というのが DuckLake の考え方です。
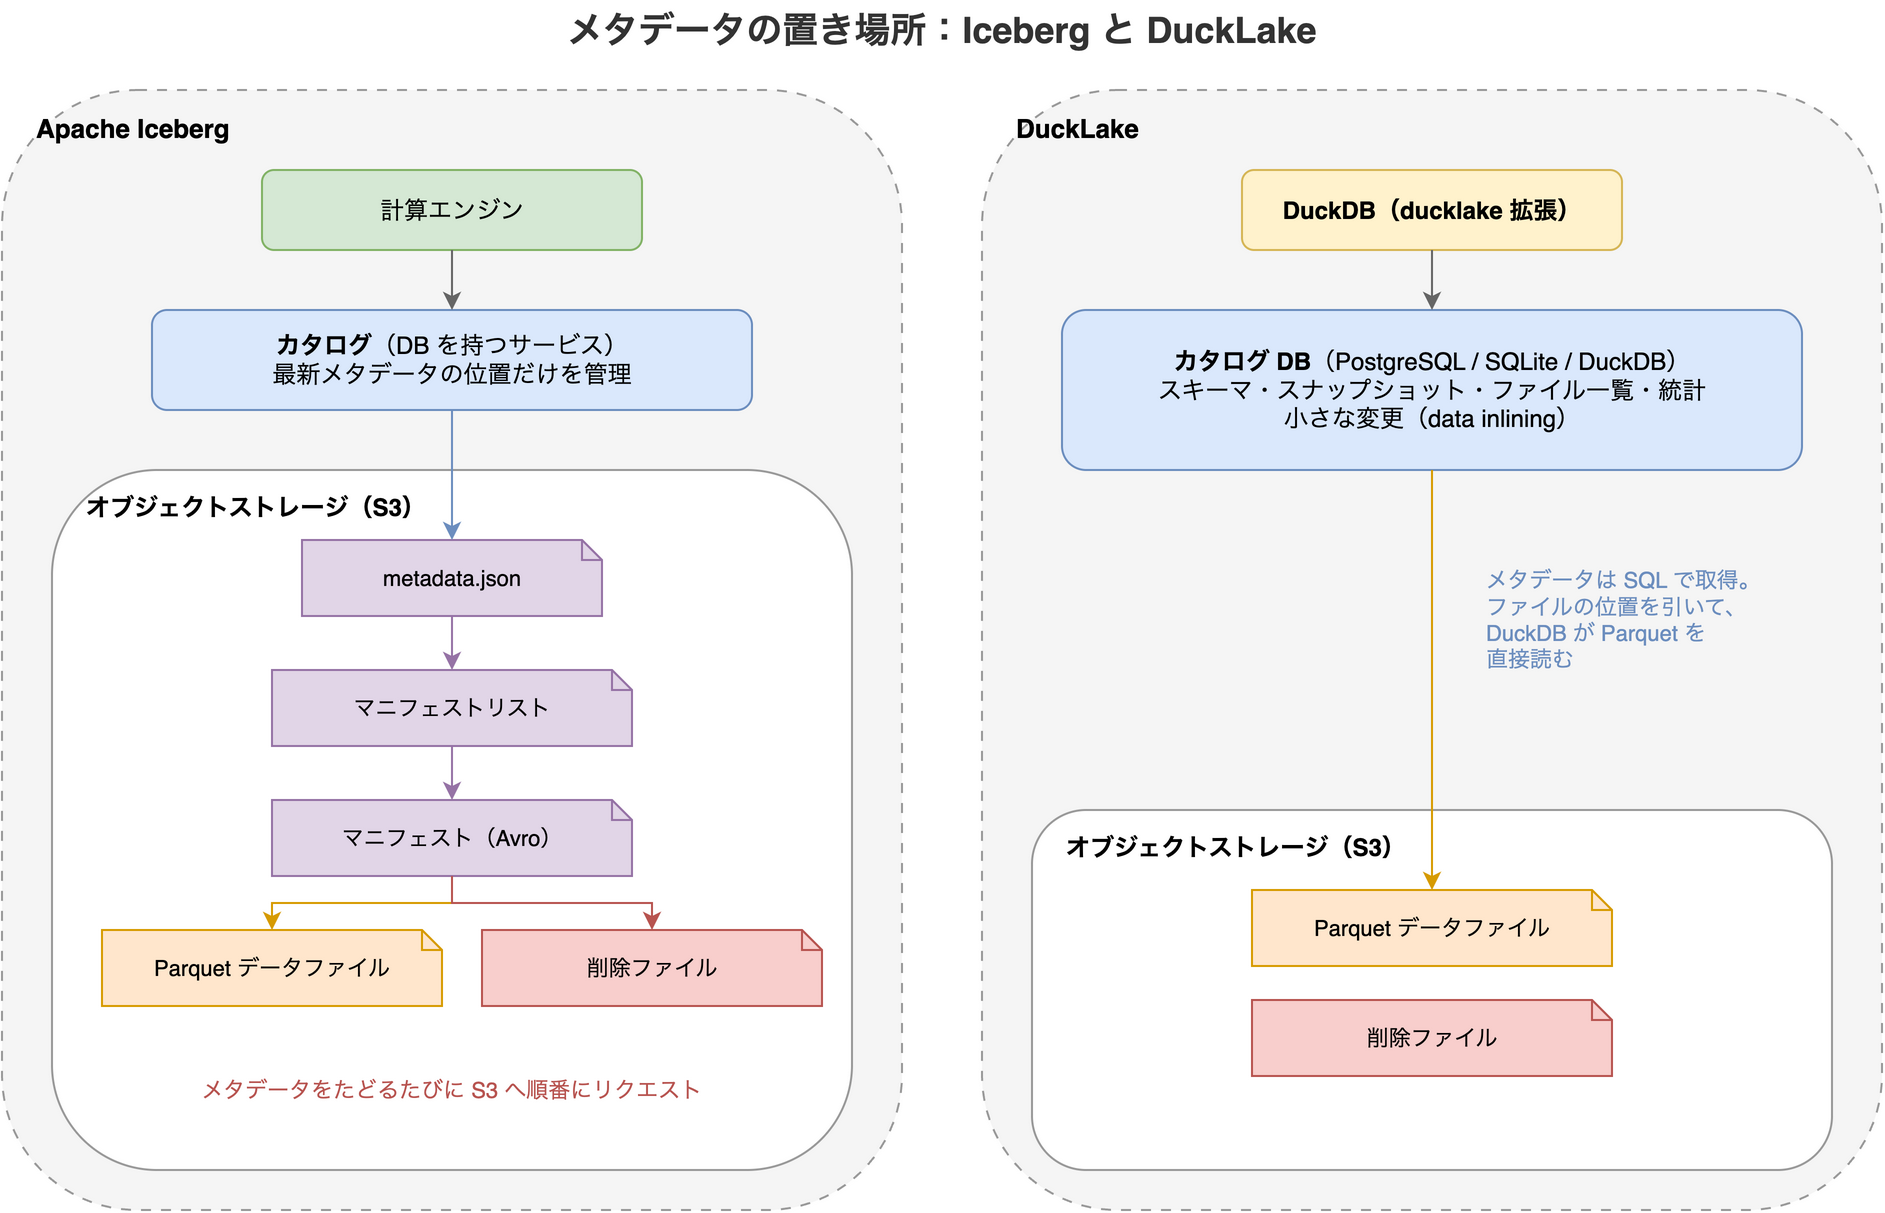
Manifesto は、ファイルベースのメタデータの問題として次の点を挙げています。
- リクエストが直列になる:カタログ → メタデータファイル → マニフェストリスト → マニフェストとたどるには、S3 への HTTP リクエストを順番に何回も投げる必要があります。これが読み取りとトランザクションのレイテンシの下限になります。
- 小さなメタデータファイルが増える:変更のたびに新しいメタデータファイルができます。ルートのメタデータファイルは過去のスナップショットをすべて含むため、履歴が長くなるほど大きくなります。
- コミットが衝突しやすい:コミット処理に時間がかかるため、同時書き込みで衝突が起きやすく、その解決にもコストがかかります。
DuckLake では、メタデータの読み書きは SQL のクエリとトランザクションになります。書き込みは「Parquet ファイルを置く」→「新しいファイル・統計・スナップショットを 1 つの SQL トランザクションで記録する」の 2 段階です。スナップショットもテーブルの行にすぎないので、大量に持っても負担になりにくい、と Manifesto は説明しています。
なお、Manifesto にある「PostgreSQL をカタログにすれば数百 TB・数千ノードまでスケールする」といった数字は、開発チームの設計上の見込みです。第三者のベンチマークではない点に注意してください。
DuckDB で DuckLake を使ってみる
DuckDB から ducklake 拡張を使います(公式ドキュメント)。もっとも簡単なのは、カタログにローカルの DuckDB ファイルを使う方法です。
INSTALL ducklake;

ATTACH 'ducklake:metadata.ducklake' AS my_ducklake;
USE my_ducklake;
ducklake: に続けてカタログの場所を書き、ATTACH するだけです。あとは普通のテーブルと同じように SQL を書けます。
CREATE TABLE nl_train_stations AS
    FROM 'https://blobs.duckdb.org/nl_stations.csv';
スナップショットとタイムトラベル
変更のたびにスナップショットが作られ、過去のバージョンを指定して読めます。データを 1 件更新してから、スナップショットの一覧を見てみます。
UPDATE nl_train_stations
SET name_long = 'Johan Cruijff ArenA'
WHERE code = 'ASB';

-- スナップショットの一覧(テーブル作成・データ投入・更新の 3 つ)
FROM my_ducklake.snapshots();
snapshots() で確認したバージョン番号を AT (VERSION => ...) に指定すると、その時点の状態を読めます。更新前と更新後のバージョンを指定すれば、name_long の値が変わっていることを確かめられます。
SELECT name_long
FROM nl_train_stations AT (VERSION => 1)
WHERE code = 'ASB';

SELECT name_long
FROM nl_train_stations AT (VERSION => 2)
WHERE code = 'ASB';
カタログデータベースの選び方(PostgreSQL / SQLite / DuckDB)
カタログには複数の選択肢があり、用途で選びます。
| カタログ | 向いている用途 | 注意点 |
|---|---|---|
| DuckDB ファイル | 1 人でローカルに使う | クライアントは 1 つに限られる |
| SQLite | ローカルで複数のクライアントから使う | 読み取りと書き込みを同時にはできない |
| PostgreSQL | 複数ユーザー・リモートから使う | PostgreSQL 12 以上 |
| MySQL | — | DuckDB の MySQL コネクタの制約による既知の問題があり、公式には推奨されていない |
チームで共有するなら PostgreSQL が本命です。次のように、カタログを PostgreSQL に、データの置き場所を DATA_PATH で指定します。<...> の部分は自分の環境の値に置き換えてください。
INSTALL ducklake;
INSTALL postgres;

-- PostgreSQL 側に ducklake_catalog データベースを作っておく
ATTACH 'ducklake:postgres:dbname=ducklake_catalog host=<ホスト> user=<ユーザー>' AS my_ducklake
    (DATA_PATH 'data_files/');
USE my_ducklake;
この例の DATA_PATH はローカルのパスです。リモートの複数ユーザーで共有する場合は、s3://<バケット>/<プレフィックス>/ のようにオブジェクトストレージを指定し、認証情報を CREATE SECRET で設定します(前回の記事の S3 Tables の例と同じ要領です)。
この構成では、複数の DuckDB プロセスが同じデータセットを同時に読み書きできます。素の DuckDB ファイルは 1 プロセスしか書き込めないので、DuckLake を使えば DuckDB をマルチユーザーで使えるようになります。
DuckLake v1.0 の主な機能
data inlining:スモールファイル問題を避ける仕組み
ストリーミングのように数行ずつ INSERT が続くと、そのたびに小さな Parquet ファイルとメタデータができてしまいます。いわゆる「スモールファイル問題」です。Iceberg では、定期的なコンパクション(ファイルの結合)で対処するのが一般的です。
DuckLake は、一定行数未満の変更を Parquet に書かず、カタログデータベースに直接格納します。これを data inlining と呼びます。v1.0 では既定で有効で、しきい値は 10 行です。インライン化されたデータも通常のデータと同じようにクエリでき、タイムトラベルも効きます(data inlining の解説記事)。
-- しきい値を変える(0 で無効)
SET ducklake_default_data_inlining_row_limit = 50;

-- テーブル単位で設定する
CREATE TABLE my_ducklake.readings (sensor_id INTEGER, value DOUBLE, ts TIMESTAMP);
ALTER TABLE my_ducklake.readings SET (data_inlining_row_limit = 100);

-- インライン化されたデータを Parquet に書き出す
CALL ducklake_flush_inlined_data('my_ducklake');
CHECKPOINT を実行すると、インライン化されたデータの書き出しに加えて、スナップショットの期限切れ処理やファイルの結合などのメンテナンスもまとめて行われます。
ソート済みテーブル・バケットパーティション・削除ベクター
- ソート済みテーブル:
ALTER TABLE ... SET SORTED BY (id ASC)で並び順を指定できます。コンパクションや書き出しのときにソートされ、範囲検索でファイルを読み飛ばしやすくなります。 - バケットパーティション:
SET PARTITIONED BY (bucket(8, user_name))のように指定します。ハッシュ関数に Iceberg と同じ murmur3 を使っています。 COUNT(*)のメタデータ応答:件数をメタデータから返すので、S3 上のテーブルでも高速です。- 削除ベクター(experimental):削除した行をビットマップで表し、Iceberg v3 仕様と同じく Puffin ファイル(Iceberg が統計や索引を保存するためのファイル形式)に保存できます。既定では、従来の位置指定の削除ファイル(positional delete)が使われます。
Iceberg との互換性と移行
DuckLake は Iceberg と競合するだけのものではなく、データレベルでは Iceberg 互換を意識して作られています。DuckLake が書く Parquet データファイルと位置指定の削除ファイルは Iceberg と互換だと、Manifesto は説明しています。
実際に、DuckDB の iceberg 拡張を使うと、両者の間でデータを移せます。次の例では、前回の記事の要領で Iceberg カタログを iceberg_datalake として ATTACH してあるものとします。
-- Iceberg カタログ(前回の記事の S3 Tables の例と同じ要領)
ATTACH '<S3 テーブルバケットの ARN>' AS iceberg_datalake (
    TYPE ICEBERG,
    ENDPOINT_TYPE s3_tables
);

-- Iceberg → DuckLake(メタデータだけをコピー。データファイルはそのまま)
CALL iceberg_to_ducklake('iceberg_datalake', 'my_ducklake');

-- DuckLake → Iceberg(データごとコピー。Iceberg 側に同名のスキーマを先に作っておく)
COPY FROM DATABASE my_ducklake TO iceberg_datalake;
iceberg_to_ducklake はメタデータだけをコピーするので、既存の Iceberg テーブルを DuckLake のテーブルとして、過去のスナップショットも含めて扱えます。ただし、メタデータだけのコピーは Iceberg → DuckLake の方向にしか対応していません。逆方向は COPY FROM DATABASE によるデータのコピーになります(DuckLake 0.3 のアナウンス)。
この互換性があるので、当面使うエンジンが DuckDB だけなら、まず DuckLake で小さく始めるという選択もできます。あとで Spark や Athena などのエンジンが必要になったら、Iceberg へ移す道が残っています。
Iceberg と DuckLake の使い分け
| 観点 | Apache Iceberg | DuckLake |
|---|---|---|
| メタデータ | S3 上のファイル+カタログ | SQL データベース |
| 対応エンジン | Spark、Trino、Flink、Athena、Snowflake、DuckDB など多数 | DuckDB が中心(Spark・Trino・DataFusion 向けのクライアントも登場) |
| 運用に必要なもの | カタログサービス(Glue、S3 Tables、REST カタログ) | PostgreSQL などの RDB |
| 小さな書き込み | 小さなファイルが増え、コンパクションが必要 | data inlining でカタログに吸収 |
| ガバナンス | Apache Software Foundation | DuckDB チーム(MIT ライセンス) |
前回の記事では「DuckDB 中心なら DuckLake、エンジン横断なら Iceberg」と書きました。今回の内容を踏まえると、判断材料がさらに 2 つ増えます。
- 小さな書き込みの頻度:ストリーミングのように細かい書き込みが続くなら、data inlining を持つ DuckLake が有利です。
- PostgreSQL を運用できるか:DuckLake をチームで使うなら、カタログの PostgreSQL の可用性とバックアップがそのままデータ基盤の信頼性になります。
まとめ
- DuckLake は、メタデータを SQL データベースに、データを Parquet でオブジェクトストレージに置くレイクハウスフォーマットです。2026 年 4 月に v1.0 がリリースされました。
- 「Iceberg もカタログでデータベースを使っているのだから、メタデータを全部そこに入れればいい」という発想で、S3 への直列リクエストや小さなメタデータファイルが増える問題を避けています。
- DuckDB からは
ATTACH 'ducklake:...'だけで使えます。カタログに PostgreSQL を使えば、複数の DuckDB プロセスから同時に読み書きできます。 - data inlining により、小さな書き込みが続いても小さな Parquet ファイルが増えにくくなっています。
- データファイルは Iceberg 互換で、Iceberg から DuckLake へのメタデータだけのコピーもできます。エンジンの多様性が必要なら Iceberg、DuckDB 中心で軽く作るなら DuckLake、という使い分けになります。