AI エージェントに社内のデータを分析させる基盤を作るなら、何から考えればよいでしょうか。結論を先に書くと、データをオープンな形式で S3 などに置くレイクハウスを土台にするのが堅実です。ただし、レイクハウスだけではエージェントは安全にも賢くも動きません。その上に「意味・費用・権限・取り消し」の 4 つの守りを足す必要があります。
この記事は、次の 4 本に続くレイクハウスのシリーズの 5 本目(最終回)です。
- Apache Iceberg 入門:データレイクを「テーブル」にする仕組みと DuckDB との関係(Iceberg の仕組み)
- DuckLake 入門:メタデータを SQL データベースに置くレイクハウスフォーマットと Iceberg との違い(軽量な選択肢の DuckLake)
- Redshift か、S3 + Iceberg のレイクハウスか:DWH とオープンテーブルフォーマットの選び方(DWH との使い分け)
- Iceberg と DuckLake の先へ:2026 年に注目したいレイクハウスの技術とプロダクト(周辺技術の地図)
なぜレイクハウスが土台に向くのか
- エージェントが使うエンジンを選べる:エージェントは、問いに応じて計算エンジンを使い分けます。ちょっとした集計なら DuckDB、大量のデータなら Athena や Spark、定型のダッシュボードなら Redshift、といった具合です。データがオープンな形式で 1 か所にあれば、どのエンジンからも同じデータを読めます。将来エージェントの得意なエンジンが変わっても、データを移す必要はありません。
- 技術の入れ替わりに強い:4 本目で見たとおり、レイクハウスの周辺はカタログもフォーマットもまだ動いています。それでもデータファイルは共通の Parquet で、XTable のようにフォーマット間でメタデータを変換する仕組みもあります。個々の製品を選び直しても、データそのものは残せます。
- 書き込みを取り消せる:エージェントに書き込みを任せると、誤った更新は必ず起きます。Iceberg はスナップショットで過去の状態を持っているので、間違えても元に戻せます。分析を同じ時点のデータで再現できるのも、エージェントの出した数字を検証するうえで大事です。
AI エージェントのデータ基盤に足す 4 つの守り
エージェントは、MCP(Model Context Protocol:AI エージェントが外部のツールやデータを呼び出すための共通の規格)のサーバーを窓口にしてデータにアクセスします。窓口から計算エンジン、カタログ、テーブルまでの各層に 1 つずつ守りを置く、というのがこの記事の整理です。
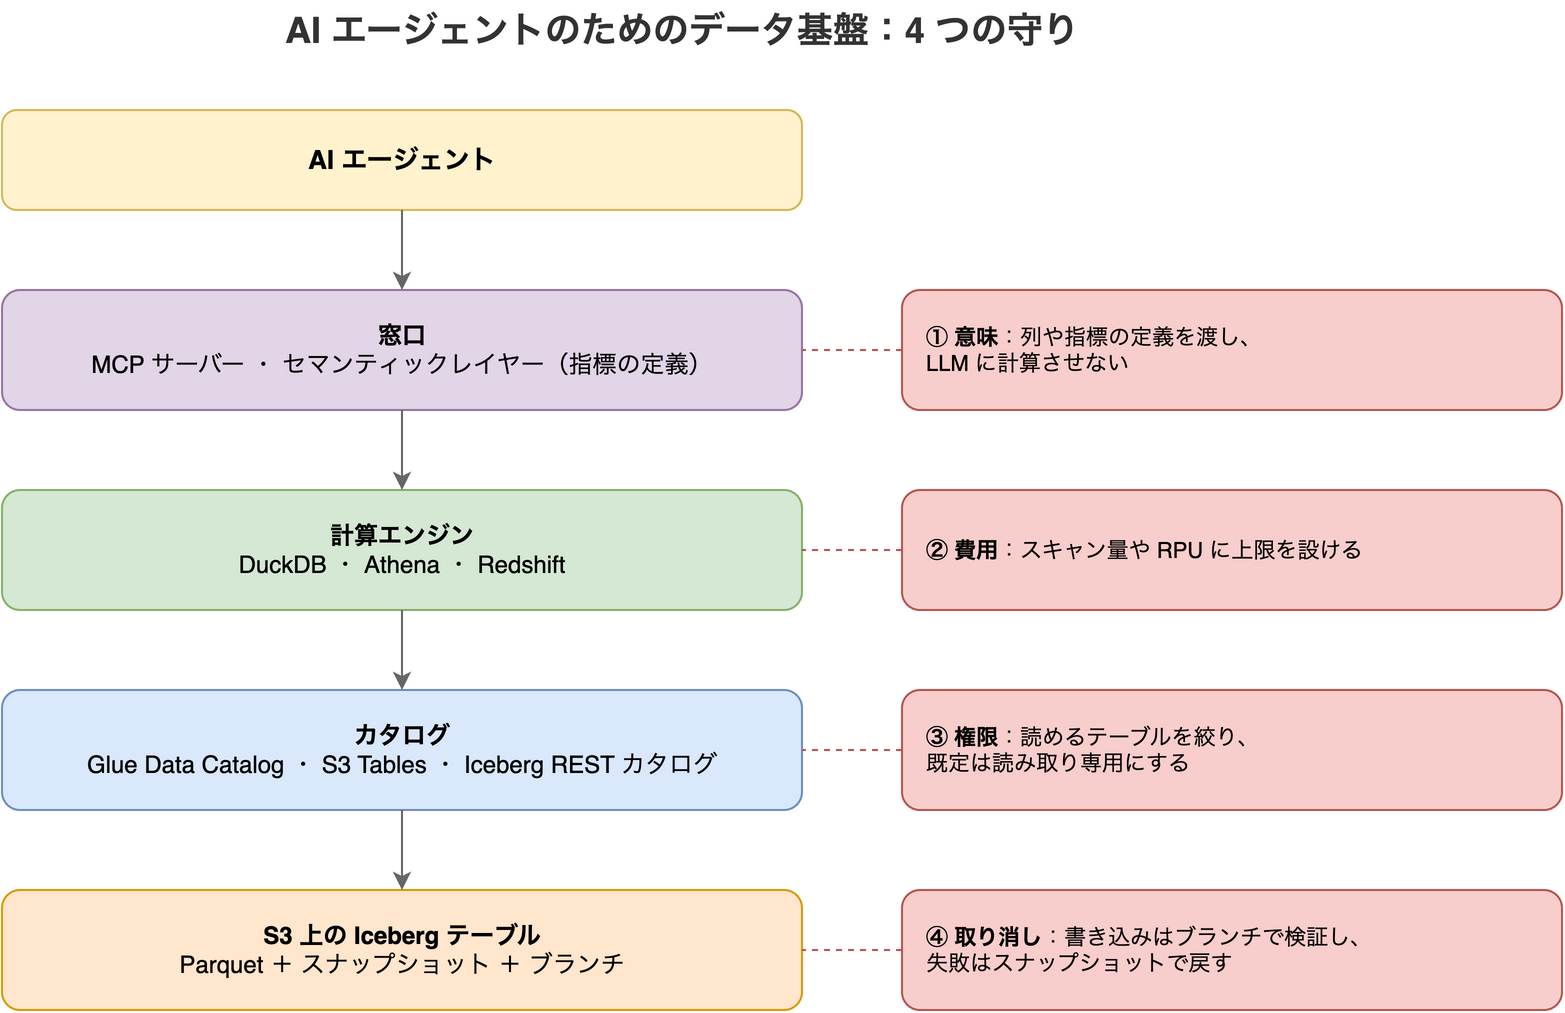
① 意味:セマンティックレイヤーで指標の定義を渡し、LLM に計算させない
エージェントがよく間違えるのは、SQL の文法よりも「この列は何を意味するか」「売上はどう定義するか」です。たとえば「売上」が税込か税抜か、返品を引くかどうかを知らなければ、正しい SQL でも誤った数字を返します。
対策は、指標の定義をセマンティックレイヤーとしてエージェントの外に持つことです。
- 指標を定義しておく:dbt Semantic Layer(指標の定義を 1 か所にまとめ、どのツールからも同じ計算式で集計させる仕組み)などで、「売上」「アクティブユーザー数」といった指標を定義しておきます。エージェントには、指標の名前と集計の切り口(日付・地域など)だけを選ばせます。dbt の MCP サーバーには、定義済みの指標を一覧する
list_metricsや、指標を集計するquery_metricsといったツールがあります。 - LLM に計算させない理由:LLM は、桁の多い四則演算や大量の行の合計で誤りやすいからです。集計はデータベース側で実行し、LLM には条件の指定だけを任せます。デジタル庁の行政手続 MCP サーバーに学ぶ「LLM に計算させない」データ設計で見た考え方で、Wiki の AI-ready データ設計にもまとめています。
② 費用:Athena と Redshift Serverless でクエリに上限を設ける
エージェントは人よりはるかに多くのクエリを投げます。試行錯誤のたびに大きなテーブルを全件スキャンすれば、費用はすぐに膨らみます。エンジンの側で上限を設けておきましょう。
- Athena:ワークグループ(クエリの実行設定や上限をまとめる単位)ごとに、クエリ 1 本あたりのスキャン量の上限を設定できます。上限を超えたクエリはキャンセルされます。ワークグループ全体の 1 時間・1 日あたりのスキャン量にもしきい値を設けられますが、こちらはキャンセルではなく Amazon SNS(AWS の通知サービス)による通知です。
- Redshift Serverless:ワークグループごとに、自動で増える RPU の最大値と、1 日・1 週・1 か月あたりの RPU 時間の上限を設定できます。RPU は Redshift Serverless の処理能力の単位です(料金は 3 本目を参照)。上限に達したときの動作は、「ログに記録」「通知」「クエリの停止」の 3 つから選べます。
エージェント専用のワークグループを作って上限を設定しておけば、人の分析と費用を分けて管理できます。テーブルをパーティションで区切ったり、よく使う集計を事前に作っておいたりして、スキャン量そのものを減らすことも大切です。
③ 権限:カタログと MCP サーバーで、既定は読み取り専用にする
エージェントに渡す権限は、人に渡す権限より狭くするのが基本です。
- カタログで絞る:4 本目で見たように、カタログはテーブル単位の権限管理の中心になりつつあります(たとえば Lakekeeper は OpenFGA による細かな権限管理に対応しています)。エージェント用のロールには、必要なテーブルだけを読める権限を与えます。
- 既定は読み取り専用にする:たとえば AWS Labs の Amazon Redshift MCP サーバーは、クエリを読み取り専用モードで実行し、書き込みを拒否します。そのうえで、ドキュメントは最小権限の読み取り専用ロールを与えることを勧めています。
MCP サーバー側の制限だけに頼らず、データベースやカタログの権限でも二重に守るのが安全です。エージェントの接続に使う認証の仕組みは、MCP のセキュリティが OAuth 2.1 で大幅進化:AI エージェントと社内データを安全に接続する仕組みも参考になります。
④ 取り消し:Iceberg のブランチで検証し、スナップショットで戻す
③ で既定を読み取り専用にしたうえで、どうしても書き込みを任せる場合の守りがこれです。ここでは Iceberg のブランチが役立ちます。ブランチはテーブルのスナップショットに名前を付けた参照で、本番(main)とは別の場所に書き込めます。
Iceberg のドキュメントには、WAP(Write-Audit-Publish:書き込み → 検証 → 公開)の流れが Spark の例で載っています。次のコードは、Iceberg の SQL 拡張を有効にした Spark セッションでの例を、ドキュメントからそのまま引用したものです。
-- テーブルで WAP を有効にする
ALTER TABLE db.table SET TBLPROPERTIES ('write.wap.enabled'='true');

-- 検証用のブランチを作る(スナップショット ID 3 から分岐し、7 日間保持)
ALTER TABLE db.table CREATE BRANCH `audit-branch` AS OF VERSION 3 RETAIN 7 DAYS;

-- 以降の書き込みをブランチに向ける
SET spark.wap.branch = audit-branch;
INSERT INTO prod.db.table VALUES (3, 'c');

-- 検証が済んだら main をブランチの先頭まで進める
CALL catalog_name.system.fast_forward('prod.db.table', 'main', 'audit-branch');
エージェントはブランチにだけ書き込み、件数や値の範囲のチェックに通ったものだけを本番に反映します。チェックに通らなければ、ブランチを捨てれば済みます。万一本番に誤った書き込みが入っても、Spark なら rollback_to_snapshot プロシージャで過去のスナップショットに戻せます。ブランチへの対応状況はエンジンによって違うので、使うエンジンのドキュメントで確認してください。
規模別の構成:DuckDB から S3 + Iceberg、Redshift へ
最初から全部をそろえる必要はありません。規模に合わせて段階的に進めるのが現実的です。
| 段階 | 構成 | 守りの重点 |
|---|---|---|
| 試行 | DuckDB(+ DuckLake)を手元で使い、エージェントに読ませる | 意味(列の説明を渡す) |
| チームでの利用 | S3 + Iceberg(S3 Tables など)に置き、Athena や DuckDB から読む | 費用(Athena の上限)、権限(読み取り専用のロール) |
| 業務への組み込み | セマンティックレイヤーを用意し、定型の集計は Redshift にも持つ | 意味(指標の定義)、取り消し(ブランチでの検証) |
守りは段階が進むごとに積み重ねていきます。前の段階の守りは外しません。どの段階でも、データはオープンな形式で持っておきます。そうすれば、次の段階に進むときにデータを作り直さずに済みます。RAG のために埋め込みベクトルも扱うなら、4 本目で紹介した Lance も候補になります。
まとめ
- AI エージェントのためのデータ基盤は、データをオープンな形式で S3 などに置くレイクハウスを土台にするのが堅実です。エンジンを選べて、技術の入れ替わりに強く、書き込みを取り消せます。
- ただしレイクハウスだけでは足りず、次の 4 つの守りを足します。
- 意味:セマンティックレイヤーで指標を定義し、LLM には条件の指定だけを任せる
- 費用:Athena のスキャン量や Redshift Serverless の RPU に上限を設ける
- 権限:カタログで読めるテーブルを絞り、既定は読み取り専用にする
- 取り消し:Iceberg のブランチで検証してから反映し、失敗はスナップショットで戻す
- 個々の製品は差し替えられるように選び、規模に合わせて段階的に進めます。
シリーズを振り返って
1 本目で Iceberg の仕組み、2 本目で軽量な選択肢の DuckLake、3 本目で DWH(Redshift)との使い分け、4 本目で周辺技術の地図を見てきました。どの回でも結論は「データをオープンな形式で持ち、エンジンやカタログは差し替えられるように選ぶ」でした。AI エージェントは、この方針の恩恵をもっとも受ける利用者の 1 つです。