パーセプトロンは「機械学習の元祖」と呼ばれることのある、もっとも基本的なニューラルネットワークのモデルです。今のディープラーニングも、LLM の内部にある全結合層も、根っこをたどるとこのモデルに行き着きます。
この記事では、パーセプトロンを解説した日本語の記事 4 本を読み比べながら、次の 3 点を整理します。
- 単純パーセプトロンは何を計算し、どう学習するのか
- なぜ単純パーセプトロンには解けない問題があるのか
- 多層パーセプトロン(MLP)はその限界をどう越え、今どこで使われているのか
あわせて、NumPy だけで書いた短いコードを実際に動かし、「AND と OR は学習できるが XOR はできない」「層を 1 つ足すと XOR も解ける」ことを確かめます。
参考にした記事は次の 4 本です。
- AVILEN「パーセプトロンの仕組みや用語について解説」 — 2 入力のパーセプトロンを式で説明
- IT 用語辞典 e-Words「パーセプトロン」 — 歴史と、単純・多層の分類
- SHIFT「MLP(多層パーセプトロン)とは?仕組みや機械学習との関係を解説」 — MLP の仕組みと実務での使いどころ
- ライトコード「機械学習の元祖「パーセプトロン」とは?」 — 学習則の導出と Python 実装
なお、Microsoft の教材 AI-For-Beginners に沿ってパーセプトロンを扱った記事も以前に書いています。教材のノートブックを動かした結果はそちらにまとめています。
パーセプトロンの歴史
パーセプトロンに至るまでの流れは、おおよそ次のとおりです。
- 1943 年: 形式ニューロン — ウォーレン・マカロックとウォルター・ピッツが、神経細胞を「入力の重み付き和がしきい値を超えたら 1 を出す素子」として数式にしました。これが世界初の神経細胞モデルとされます
- 1957〜1958 年: パーセプトロン — コーネル航空研究所のフランク・ローゼンブラットが、形式ニューロンに「データから重みを学習する仕組み」を加えたパーセプトロンを提唱しました。1957 年に研究所の文書(提案書)を出し、1958 年に論文を発表しています
- 専用ハードウェア「Mark I Perceptron」も作られ、20×20 の光センサーで簡単な図形を見分けました
- 1969 年: 限界の指摘 — マービン・ミンスキーとシーモア・パパートが著書『Perceptrons』で、単純パーセプトロンでは解けない問題があることを数学的に示しました。これをきっかけに研究は下火になります
- 1986 年: 誤差逆伝播法の普及 — デビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズの論文で、多層のネットワークを学習させる誤差逆伝播法が広く知られるようになり、多層パーセプトロンが実用の道具になりました
参考記事のあいだでも、年代の書き方には揺れがあります。ライトコードは「1958 年に発表」、e-Words は「1957 年に提唱、Mark I は 1958 年に試作」としています。提案書・論文・ハードウェアのどれを基準にするかで、書かれる年が変わるようです。Mark I についても、1958 年に試作されたとする資料と、1959 年に組み立てと試験が行われたとする資料があります。
単純パーセプトロンの仕組み
何を計算するのか
単純パーセプトロンは、入力を受け取って 0 か 1 の 1 つの値を出力するモデルです。2 つの入力 x₁、x₂ を持つ場合、計算は次の 2 段階です。
- 入力に重みを掛けて足し、バイアスを加える: z = w₀ + w₁x₁ + w₂x₂
- z をステップ関数に通す: z が 0 以上なら 1、0 未満なら 0 を出力する
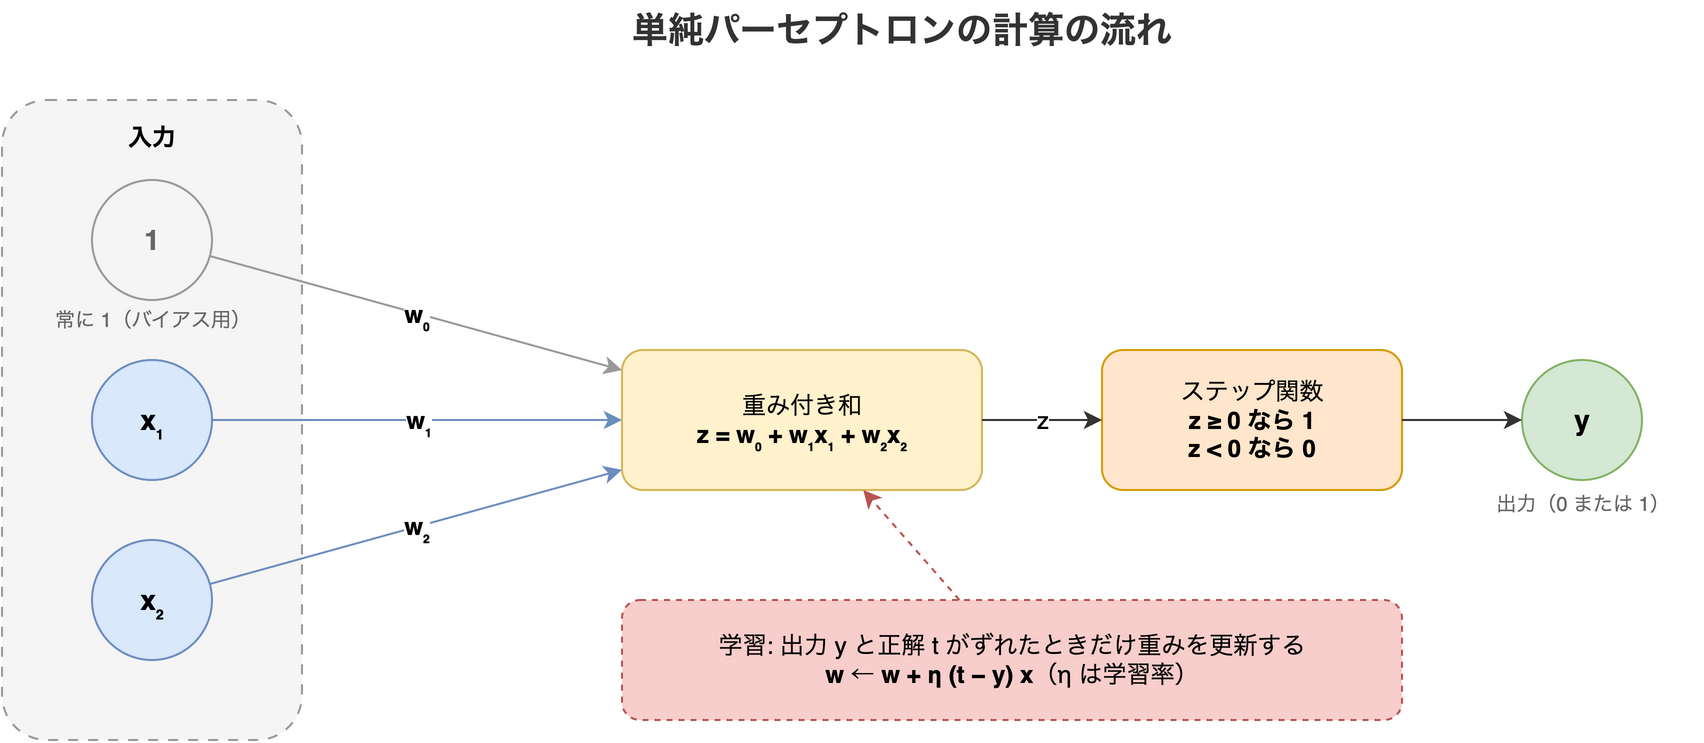
重み w₁、w₂ は、それぞれの入力をどれだけ重視するかを表します。バイアス w₀ は「どれだけ 1 を出しやすいか」を調整する値です。AVILEN の記事では、z が 0 を超えて 1 を出すことを「ニューロンの発火」と呼び、発火のしやすさをバイアスが決めると説明しています。
図のように、バイアスは「常に 1 を出す入力」に掛かる重みとして扱うのが定番です。こうするとバイアスも他の重みと同じ式で学習できます。
決定境界は直線になる
z = 0 になる点の集まり、つまり w₀ + w₁x₁ + w₂x₂ = 0 は、x₁-x₂ 平面上の 1 本の直線です。パーセプトロンは、この直線の片側を 1、反対側を 0 と判定します。この境界線を 決定境界 と呼びます。
ライトコードの記事では、アヤメ(Iris)データセットの setosa と versicolor の 2 品種を例に、特徴量を 2 次元にプロットして直線で分ける様子を図で示しています。学習とは、データをうまく分けられる位置にこの直線を動かしていくことです。入力が 3 次元なら平面、それ以上なら超平面(高次元の空間で平面にあたる境界)になりますが、「まっすぐな境界で 2 つに分ける」という本質は変わりません。
どう学習するのか
学習データは、入力 x と正解ラベル t(0 か 1)の組です。パーセプトロンは、データを 1 件ずつ見ながら次の規則で重みを直します。
- 出力 y が正解 t と一致した: 何もしない
- 出力が 0 なのに正解が 1(t − y = 1): その入力の方向へ重みを増やす
- 出力が 1 なのに正解が 0(t − y = −1): その入力の方向へ重みを減らす
これをまとめた式が、パーセプトロンの学習則です。
w ← w + η (t − y) xη(イータ)は 学習率 と呼ばれる小さな正の数で、1 回の修正の大きさを決めます。ライトコードの記事では 0.1〜0.0001 程度の値がよく使われると紹介しています。
データが直線で分けられる(線形分離可能 な)場合、この学習則は有限回の更新で必ず全件を正しく分けられるようになります。これはパーセプトロンの収束定理として証明されています。逆に言えば、直線で分けられないデータでは、いつまでも収束しません。
記事によって表記が違う点
4 本を読み比べると、同じパーセプトロンでも表記の流儀が少しずつ違います。別の資料を読むときに戸惑いやすいので、まとめておきます。
| 項目 | よくある書き方 | 別の書き方 |
|---|---|---|
| 出力の値 | 0 と 1(AVILEN、ライトコード) | −1 と +1(AI-For-Beginners など) |
| バイアス | 常に 1 の入力に掛かる重み w₀ を足す(AVILEN) | しきい値 θ として、常に −1 の入力に掛かる重みにする(ライトコード) |
| 発火の条件 | z ≥ 0 で 1(AVILEN) | z > 0 で 1(ライトコード) |
| 層の数え方 | 入力層と出力層で「2 層」(e-Words、ライトコード) | 重みを持つ層だけ数えて「1 層」(英語の single-layer perceptron) |
どれも本質は同じで、境界上の点をどちらに入れるか、符号をどちらに付けるかといった約束事の違いです。特に層の数え方は、日本語では「2 層」と書かれることがあるのに英語名は single-layer(1 層)なので、混乱しやすいところです。資料を読むときは、入力層を数えているかどうかを確かめるのが安全です。
Python で AND・OR・XOR を学習させる
ここまでの内容を、NumPy だけで書いたコードで確かめます。AND、OR、XOR の 3 つの論理演算を、同じパーセプトロンに学習させます。
import numpy as np

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
TARGETS = {
    "AND": np.array([0, 0, 0, 1]),
    "OR":  np.array([0, 1, 1, 1]),
    "XOR": np.array([0, 1, 1, 0]),
}
EPOCHS = 20


def add_bias(X):
    return np.hstack([np.ones((len(X), 1)), X])  # 先頭に常に 1 の入力(バイアス用)


def step(z):
    return np.where(z >= 0, 1, 0)


def train_perceptron(X, t, eta=1.0, epochs=EPOCHS):
    Xb = add_bias(X)
    w = np.zeros(Xb.shape[1])
    for epoch in range(1, epochs + 1):
        errors = 0
        for x, target in zip(Xb, t):
            y = step(x @ w)
            w += eta * (target - y) * x  # Δw = η (t − y) x
            errors += int(target != y)
        if errors == 0:
            return w, epoch
    return w, None


for name, t in TARGETS.items():
    w, epoch = train_perceptron(X, t)
    pred = step(add_bias(X) @ w)
    status = f"{epoch} エポックで収束" if epoch else f"{EPOCHS} エポックで収束せず"
    print(f"{name}: {status}  w={w}  予測={pred}  正解={t}")
Python 3.14.7 と NumPy 2.5.3 で実行した結果です。
AND: 6 エポックで収束  w=[-3.  2.  1.]  予測=[0 0 0 1]  正解=[0 0 0 1]
OR: 4 エポックで収束  w=[-1.  1.  1.]  予測=[0 1 1 1]  正解=[0 1 1 1]
XOR: 20 エポックで収束せず  w=[ 0. -1.  0.]  予測=[1 1 0 0]  正解=[0 1 1 0]
AND は 6 エポック(データ全体を 6 周)、OR は 4 エポックで全件正解になりました。AND の重みは w₀ = −3、w₁ = 2、w₂ = 1 です。z を計算すると (0, 0) は −3、(0, 1) は −2、(1, 0) は −1、(1, 1) は 0 になり、x₁ と x₂ がどちらも 1 のときだけ 0 以上になります。
学習率を 1.0 にしているのは、重みを 0 から始める場合、学習率を変えても重みの大きさが比例して変わるだけで、決定境界は同じになるからです。1.0 にしておくと重みが整数のままになり、上のように手で検算できます。0.1 にすると 0.1 の足し算の丸め誤差が出て、z がちょうど 0 になるはずの点がわずかに負になり、判定が変わることがあります。
一方、XOR は 20 エポック回しても収束せず、予測は 4 件中 2 件しか合っていません。エポック数を増やしても結果は変わりません。
単純パーセプトロンの限界 — XOR が解けない理由
XOR は「2 つの入力のうち片方だけが 1 のときに 1」を返す演算です。4 つの点を平面に置くと、1 になるのは (0, 1) と (1, 0)、0 になるのは (0, 0) と (1, 1) で、対角線上に同じ答えの点が並びます。これを直線 1 本で 2 つに分けることはできません。
単純パーセプトロンの決定境界は必ず直線なので、どれだけ学習しても XOR は解けません。学習の工夫が足りないのではなく、モデルの形そのものの限界です。ミンスキーとパパートが 1969 年に指摘したのは、まさにこの点でした。
ライトコードの記事では、アヤメの versicolor と virginica のように 2 つのクラスが入り混じったデータでも、同じ理由できれいな決定境界が引けないことを示しています。現実のデータは、直線できれいに分かれないことのほうが普通です。
多層パーセプトロン(MLP)
層を重ねると曲がった境界が作れる
単純パーセプトロンの限界を越える方法が、入力層と出力層の間に 隠れ層(中間層)をはさむことです。これを 多層パーセプトロン(MLP: Multi-Layer Perceptron)と呼びます。e-Words では、隠れ層を持つ 3 層以上のものを多層パーセプトロンと呼んでいます。隠れ層が複数ある 4 層以上のものは、ディープニューラルネットワーク(DNN)です。
SHIFT の記事は、MLP の構成要素を次のように整理しています。
- 入力層: 分析したいデータを受け取る
- 隠れ層: 入力を何段階かに分けて変換し、特徴を取り出す
- 出力層: 分類結果や予測値を出す
- 各層で「入力 × 重み + バイアス」を計算し、活性化関数 で変換して次の層に渡す
隠れ層の各ニューロンは、それぞれ 1 本の直線(超平面)で入力空間を切り分けます。出力層がそれらの結果を組み合わせることで、全体としては曲がった境界や、いくつかの領域に分かれた境界が作れます。XOR なら、「OR だが AND ではない」という組み合わせで表せます。
誤差逆伝播法と微分できる活性化関数
層を重ねると、「出力の誤差を減らすには、どの層のどの重みをどれだけ直せばよいか」を求める必要があります。これを効率よく計算するのが 誤差逆伝播法(バックプロパゲーション)です。
SHIFT の記事に沿って流れをまとめると、次のとおりです。
- 順伝播: 入力から出力層まで計算を進め、予測値を出す
- 損失の計算: 予測値と正解のずれを 損失関数 で数値にする
- 誤差逆伝播: 損失を出力側から入力側へさかのぼり、各重みが損失にどれだけ影響したか(勾配)を求める
- 勾配降下法: 損失が小さくなる方向へ、重みとバイアスを少しずつ動かす
ここで 1 つ注意点があります。誤差逆伝播法は微分を使うので、単純パーセプトロンのステップ関数(0 か 1 に跳ぶ関数)はそのままでは使えません。ステップ関数は、ほとんどの場所で傾きが 0 になり、重みをどちらに動かせばよいかの手がかりが得られないからです。そのため MLP では、シグモイド関数や ReLU のような、傾きが意味を持つ活性化関数を使います。
「多層パーセプトロン」という名前でも、中身のニューロンは元祖パーセプトロンとは活性化関数が違う、という点は押さえておくとよいでしょう。
隠れ層 1 つで XOR を解く
隠れ層を 1 つ足し、シグモイド関数と誤差逆伝播法で学習させると、XOR も解けます。
import numpy as np

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
t = np.array([[0], [1], [1], [0]], dtype=float)

rng = np.random.default_rng(0)
W1 = rng.normal(size=(2, 4))  # 入力 2 → 隠れ層 4
b1 = np.zeros(4)
W2 = rng.normal(size=(4, 1))  # 隠れ層 4 → 出力 1
b2 = np.zeros(1)


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


eta = 1.0
for epoch in range(5000):
    # 順伝播
    h = sigmoid(X @ W1 + b1)
    y = sigmoid(h @ W2 + b2)
    # 誤差逆伝播(損失は二乗誤差の 1/2)
    dy = (y - t) * y * (1 - y)
    dh = (dy @ W2.T) * h * (1 - h)
    W2 -= eta * h.T @ dy
    b2 -= eta * dy.sum(axis=0)
    W1 -= eta * X.T @ dh
    b1 -= eta * dh.sum(axis=0)

print("出力:", y.ravel().round(3))
print("予測:", (y.ravel() >= 0.5).astype(int), " 正解:", t.ravel().astype(int))
同じ環境で実行した結果です。重みの初期値は乱数ですが、シードを 0 に固定しているので毎回同じ結果になります。
出力: [0.007 0.981 0.981 0.024]
予測: [0 1 1 0]  正解: [0 1 1 0]
出力は 0〜1 の連続値になり、0.5 を境に 0 と 1 に読み替えると、4 件すべて正解しています。単純パーセプトロンでは形のうえで不可能だった問題が、層を 1 つ足すだけで解けるようになりました。
実務でこれを手で書くことはまずありません。PyTorch などのフレームワークが勾配の計算を自動でしてくれます。それでも一度手で書いてみると、「順伝播で予測し、逆伝播で勾配を求め、勾配降下法で重みを直す」という流れが具体的に見えてきます。
MLP の課題と今の使いどころ
SHIFT の記事は、MLP の課題として次の 3 つを挙げています。
- 勾配消失と過学習: 層を深くしすぎると、逆伝播の途中で勾配が小さくなりすぎて学習が進まなくなります(勾配消失問題)。また、パラメータが多いぶん学習データに過剰に合わせてしまい、新しいデータに弱くなりがちです(過学習)。対策として正則化(L2 正則化、ドロップアウトなど)やデータ量の確保が挙げられています
- 計算コスト: 層やニューロンを増やすと、パラメータ数が急激に増えます
- 説明しにくさ: なぜその結果になったのかを説明しにくく、金融の審査や医療診断支援のように説明責任が求められる場面では注意が必要です
一方で、SHIFT の記事は MLP の今の価値として、次の点を挙げています。
- 実装しやすさ: 構造が単純で、開発の手間や計算コストを抑えやすい
- 軽さと安定性: 特徴量が整理された入力があるタスクなら、軽くて安定した選択肢になる
- エッジ AI との相性: 計算資源やメモリが限られた機器でも動かしやすい
さらに付け加えると、MLP は大規模モデルの中でも部品として生きています。Transformer の各層には、アテンションの後に全結合層を 2 つ重ねたネットワーク(フィードフォワード層)があり、これは MLP そのものです。CNN や RNN、Transformer といったより新しいモデルも、「重み付き和を活性化関数に通す」というパーセプトロンの基本単位を積み上げてできています。
参考記事についての補足
4 本の記事はどれも入門として読みやすいものですが、読み比べると気になる点が 2 つありました。
- 誤差逆伝播法の時期: e-Words は誤差逆伝播法が「1990 年代に考案され」たと書いていますが、多層ネットワークの学習法として広く知られるきっかけになったラメルハートらの論文は 1986 年です。アイデア自体はそれ以前から複数の研究者が提案していました
- LSTM の訳語: SHIFT の記事には「LSTM(超短期記憶)」という表記がありますが、LSTM は Long Short-Term Memory の略で、日本語では「長・短期記憶」です。同じ記事の関連リンクのほうは「長・短期記憶」になっています
まとめ
- 単純パーセプトロンは、入力の重み付き和をステップ関数に通して 0 か 1 を出すモデルで、決定境界は直線(超平面)になる
- 学習則は w ← w + η(t − y)x で、間違えたときだけ重みを正解の方向へ動かす。線形分離可能なデータなら必ず収束する
- 直線で分けられない XOR は、単純パーセプトロンではどう学習しても解けない。これが 1969 年に指摘された限界で、研究が一時停滞する原因になった
- 隠れ層を加えた多層パーセプトロン(MLP)は曲がった境界を作れる。微分できる活性化関数と誤差逆伝播法を組み合わせて学習させる
- MLP は今も、軽量なモデルとして単体で使われるほか、Transformer のフィードフォワード層のように大規模モデルの部品にもなっている
LLM の仕組みを理解したいときも、出発点はこの「重み付き和と活性化関数」です。ニューラルネットワーク全体の基礎知識は、Wiki の ニューラルネットワークの基礎 にもまとめています。