Microsoft の無料カリキュラム AI-For-Beginners のパート「III. ニューラルネットワーク」を解説します。レッスン 03「パーセプトロン」、04「多層パーセプトロンと自作フレームワーク」、05「フレームワークと過学習」の 3 本です。
シリーズのほかの記事は次のとおりです。
- 全体の構成: Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う
- レッスン 01: AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01
- レッスン 02: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02
レッスン 01 で紹介された 2 つのアプローチのうち、前回のトップダウン(記号的推論)に続いて、今回はボトムアップ(ニューラルネットワーク)側に入ります。3 つのレッスンは、「限界があった → 乗り越えた → 道具で手軽になったが、注意点もある」という 1 本の話になっています。
- 最初のニューラルネットワークには、形のうえで解けない問題があった(レッスン 03)。1 層のパーセプトロンは、データを直線 1 本で 2 つに分けるだけのモデルです。そのため、XOR のように直線 1 本では分けられない問題は、どう学習させても解けません。この限界の指摘で、研究は一度止まりました
- 層を重ねることと、それを学習させる計算方法がそろって、限界を乗り越えた(レッスン 04)。層とは、同じ入力を受け取ってそれぞれ重み付きの和を計算するニューロンの集まりで、前の層の出力が次の層の入力になります。層の間に、境界を曲げる働きの関数(活性化関数)をはさんで重ねると、曲がった境界が作れるようになり、XOR も解けます。層が増えると「どの重みをどれだけ直すか」の計算が複雑になりますが、出力の誤差から入力側へ順にさかのぼって効率よく計算する 誤差逆伝播法 がそれを解決しました
- 道具で強いモデルを手軽に作れるようになったが、強ければよいわけではない(レッスン 05)。レッスン 04 では誤差逆伝播の計算を手で書きますが、PyTorch や TensorFlow はそれを自動でやり(自動微分)、GPU で速く回せるようにします。ただし、強力なモデルほど学習データを丸暗記して新しいデータに弱くなる 過学習 に注意が必要です
3 レッスン合わせて、ノートブックはラボを含めて 8 本あります。この記事では主要なノートブックを 2026 年 9 月時点のライブラリで実際に動かし、その結果も載せます。動かしてみると、教材の公開後にライブラリやデータが変わったことで そのままでは動かないセル がいくつもありました。対処法は「ノートブックを今の環境で動かすときの注意」に、教材そのものの誤りは「教材を読むときの補足」にまとめています。
教材の場所は次のとおりです。
筆者の実行環境は、Apple Silicon の Mac 上の Python 3.12.8 です。主なライブラリは NumPy 2.5.3、scikit-learn 1.9.1、Matplotlib 3.11.2、PyTorch 2.14.0、Lightning 2.6.6、TensorFlow 2.21.0、Keras 3.15.1 です。
パート III の導入 — 機械学習とニューロンのモデル
パートの冒頭では、前提となる用語を整理します。
ニューラルネットワークは 機械学習 の一分野です。機械学習では、例となるデータ X と、それぞれに対応する出力 Y を使ってモデルを訓練します。X の各要素は 特徴量 を並べた N 次元のベクトルで、Y は ラベル と呼ばれます。代表的な問題は次の 2 つです。
- 分類: 入力を 2 つ以上のクラスのどれかに振り分ける
- 回帰: 入力ごとに数値を予測する
モデルの元になるのは、脳の神経細胞(ニューロン)です。ニューロンは複数の入力(樹状突起)と 1 つの出力(軸索)を持ち、つなぎ目(シナプス)の伝わりやすさが変わります。これをいちばん単純に数式にすると、入力 x₁…xₙ にそれぞれ重み w₁…wₙ を掛けて足し合わせ、活性化関数 f に通したものが出力 Y になります(Y = f(Σ xᵢwᵢ))。
このモデルの原型は、1943 年のウォーレン・マカロックとウォルター・ピッツの論文にさかのぼります。ネットワークの学習方法は、ドナルド・ヘッブが著書『The Organization of Behavior』で提案しました。
レッスン 03: パーセプトロン
Mark I パーセプトロン
現代のニューラルネットワークに近いものを最初に作ったのは、コーネル航空研究所のフランク・ローゼンブラットです。1957 年、三角形・四角形・円のような単純な図形を見分ける「Mark I」をハードウェアとして作りました。入力は 20×20 の光電セルなので、入力は 400 個、出力は 2 値の 1 個です。重みはポテンショメータ(可変抵抗)で表され、学習のたびに手で調整していました。
当時のニューヨーク・タイムズは、パーセプトロンを「(海軍が)歩き、話し、見て、書き、自己複製し、自分の存在を意識できるようになると期待している電子計算機の胚」と報じたそうです。期待の大きさは、今の LLM を巡る報道とよく似ています。
モデルと学習
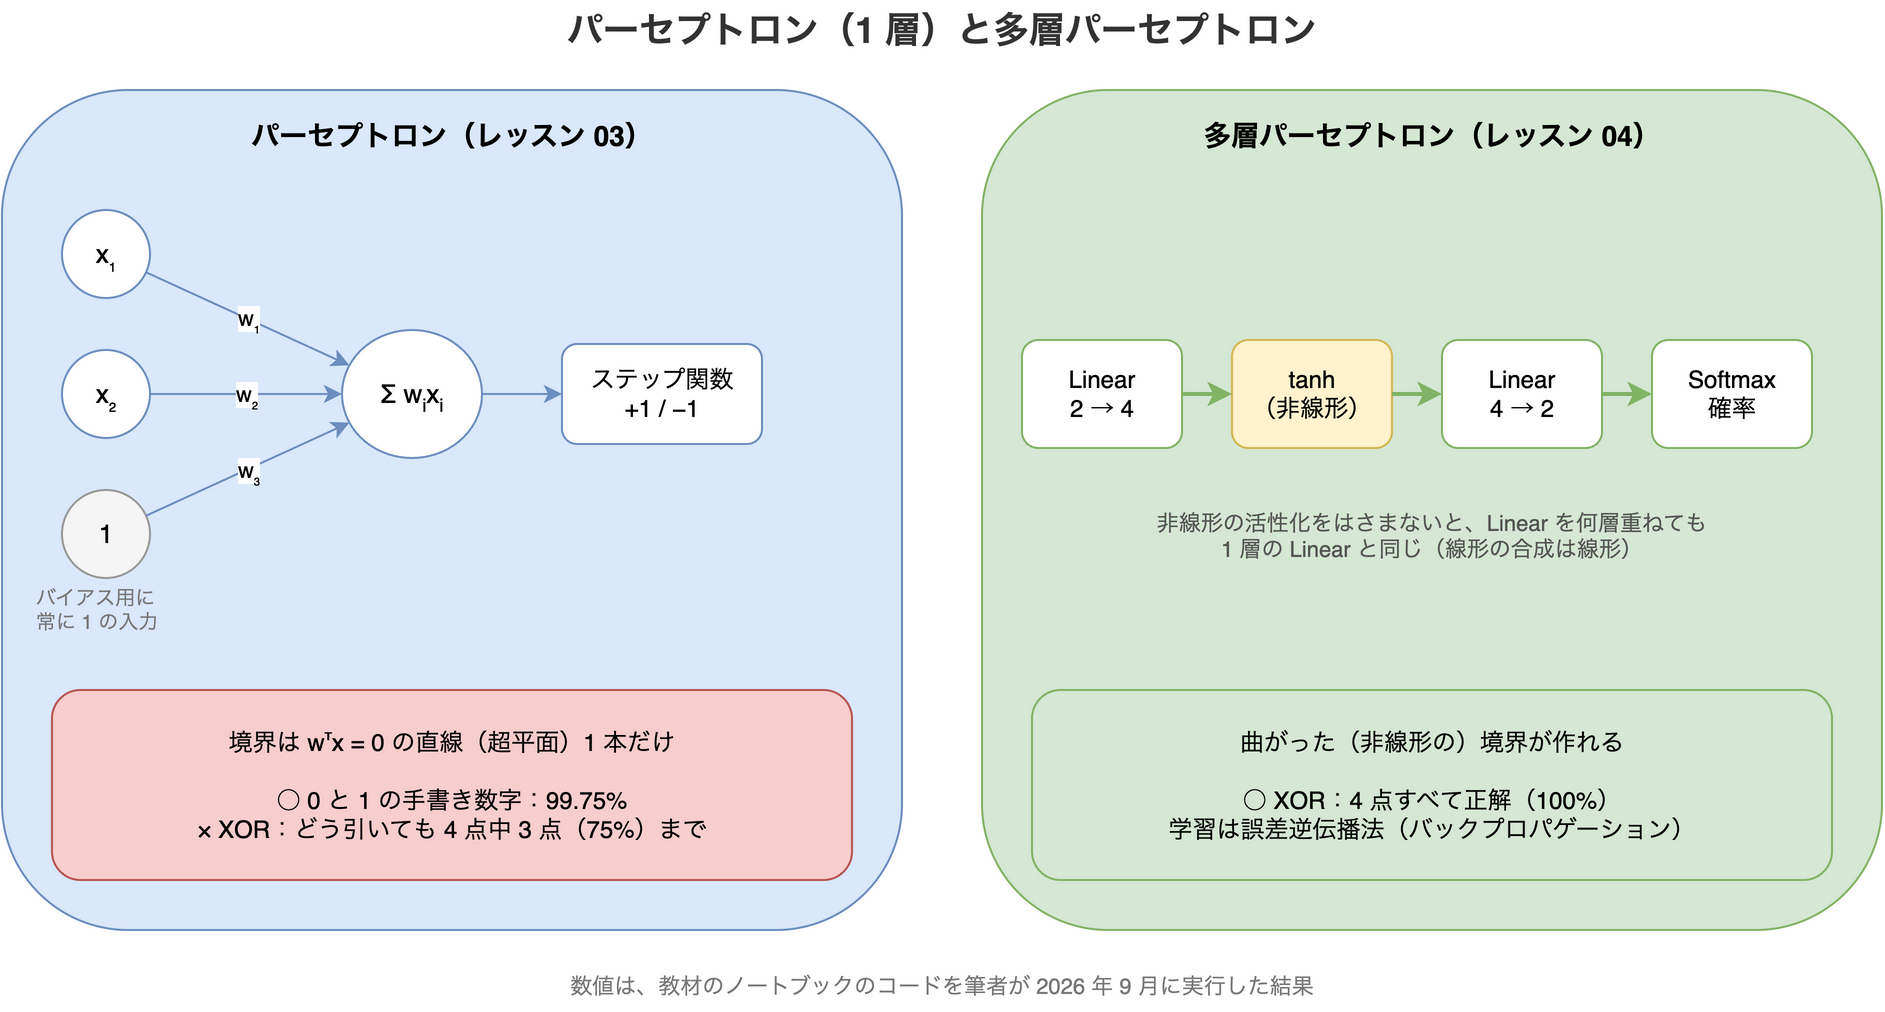
パーセプトロンは 2 値分類 のモデルです。入力ベクトル x に対して、出力 y(x) = f(wᵀx) は +1 か −1 になります。f はステップ関数で、wᵀx が 0 以上なら +1、負なら −1 を返します。
本来の線形モデルにはバイアス b も必要ですが(y = f(wᵀx + b))、ノートブックは「常に 1 の入力」を 1 次元追加することで、バイアスを重みの 1 つとして扱っています。
学習では、誤分類した例だけを足し合わせた パーセプトロン基準 E(w) = −Σ wᵀxₙtₙ を最小にします(tₙ は正例なら +1、負例なら −1)。その勾配を使った 勾配降下法 の更新式は w ← w + η Σ xₙtₙ になります。η は 学習率 です。
ノートブックの実装は、毎回ランダムに正例と負例を 1 つずつ選び、誤分類していたら重みをその方向に動かす、というシンプルなものです。
# train() 関数の中のループ部分(抜粋)
    for i in range(num_iterations):
        # Pick one positive and one negative example
        pos = random.choice(positive_examples)
        neg = random.choice(negative_examples)

        z = np.dot(pos, weights)
        if z < 0: # positive example was classified as negative
            weights = weights + learning_rate * pos.reshape(weights.shape)

        z  = np.dot(neg, weights)
        if z >= 0: # negative example was classified as positive
            weights = weights - learning_rate * neg.reshape(weights.shape)
2 特徴量の人工データ(make_classification で 50 点を作り、8 割を学習用)で訓練すると、テストデータの正解率は 1.0 になりました。
パーセプトロンは XOR が解けない
パーセプトロンの決定境界は wᵀx = 0、つまり直線(高次元では超平面)1 本です。直線で分けられる(線形分離可能 な)データしか正しく分類できません。
典型的な反例が XOR です。(0,1) と (1,0) が正例、(0,0) と (1,1) が負例の 4 点は、どう直線を引いても分けられません。ノートブックの学習関数で 1,000 回更新しても、正解率は 4 点中 3 点、つまり 0.75 が上限でした。
この限界は、1969 年にマービン・ミンスキーとシーモア・パパートが著書『Perceptrons』で指摘しました。教材によれば、これによってニューラルネットワークの研究はおよそ 10 年停滞しました。次のレッスンで見るように、層を重ねれば XOR は簡単に解けます。
手書き数字 MNIST で試す
XOR は解けなくても、パーセプトロンは手書き数字の認識のような実用的な問題を解けます。ノートブックは MNIST(28×28 ピクセルの手書き数字画像)を使い、2 つの数字を見分ける 2 値分類を試します。
ただし、リポジトリの data/mnist.pkl.gz は 2025 年 6 月に形式の違うファイルに差し替わっていて、ノートブックの読み込みコードはそのままでは動きません(詳しくは「ノートブックを今の環境で動かすときの注意」を参照)。筆者は、ノートブックの読み込みセルを次のように書き換えて実行しました(gzip・pickle・numpy はノートブックの冒頭で import 済みです)。
with gzip.open('../../../data/mnist.pkl.gz', 'rb') as f:
    (tr_x, tr_y), _, _ = pickle.load(f, encoding='latin1')
MNIST = {'Train': {'Features': (tr_x * 256).round().astype(np.int32), 'Labels': tr_y}}
この読み替えで、ノートブックの残りのセルはすべて最後まで動きました。1,000 回更新した後の学習データでの正解率は次のとおりです。
| 分類 | 正解率 |
|---|---|
| 1 と 0 | 0.9975 |
| 2 と 5 | 0.9722 |
1 と 0 はほぼ完全に分けられます。ノートブックでは、学習後の重みを 28×28 の画像として表示できます。中央(1 の縦線が通る位置)には大きな正の重みが、その両脇(0 の輪が通る位置)には負の重みが付いています。パーセプトロンが何を見ているかが、画像からそのまま読み取れます。
裏を返すと、パーセプトロンは「どの画素に線があるか」だけで判断しています。教材も、1 を少し横にずらして 0 の縦線の位置に重なると誤分類しうる、と注意しています。MNIST の数字は中央にそろえてあるので、この弱点が表に出にくいだけです。
2 と 5 は分けにくい組み合わせです。ノートブックは、784 次元の画像を 主成分分析(PCA)で 2 次元に落としてこれを確かめます。1 と 0 は 2 次元でもはっきり分かれますが、2 と 5 は重なり合います。
レッスン 04: 多層パーセプトロンと自作フレームワーク
レッスン 04 では、パーセプトロンを 3 つの方向に拡張します。多クラス分類、回帰、そして線形分離できないデータの分類です。ノートブックでは、そのための小さなニューラルネットワークのフレームワークを NumPy だけで自作します。
損失関数・Softmax・交差エントロピー
まず機械学習の問題を定式化します。モデル f のパラメータ θ を、予測の悪さを表す 損失関数 L が最小になるように決めるのが学習です。
- 回帰の損失: 絶対誤差 Σ|f(x) − y|、二乗誤差 Σ(f(x) − y)²
- 分類の損失: 0-1 損失、ロジスティック損失
0-1 損失について、教材は「正解率とほぼ同じ」と説明しています。式の上では、誤分類した例を 1、正しく分類した例を 0 として数えるものです。ただし 0-1 損失は、正解にどれだけ近かったかを表せません。そのため、確率のずれの大きさまで反映するロジスティック損失のほうがよく使われます。
分類では、出力を各クラスの確率として得たいことがよくあります。そのために使うのが Softmax で、任意の数値の組を、合計 1 の確率分布に変換します。確率を出力するネットワークの損失には、ロジスティック損失を多クラスに一般化した 交差エントロピー損失 を使います。正解クラス c の予測確率を p_c とすると、損失は −log p_c です。正解に確率 1 を付ければ 0、確率が 0 に近づくほど無限大に大きくなります。
勾配降下法とミニバッチ
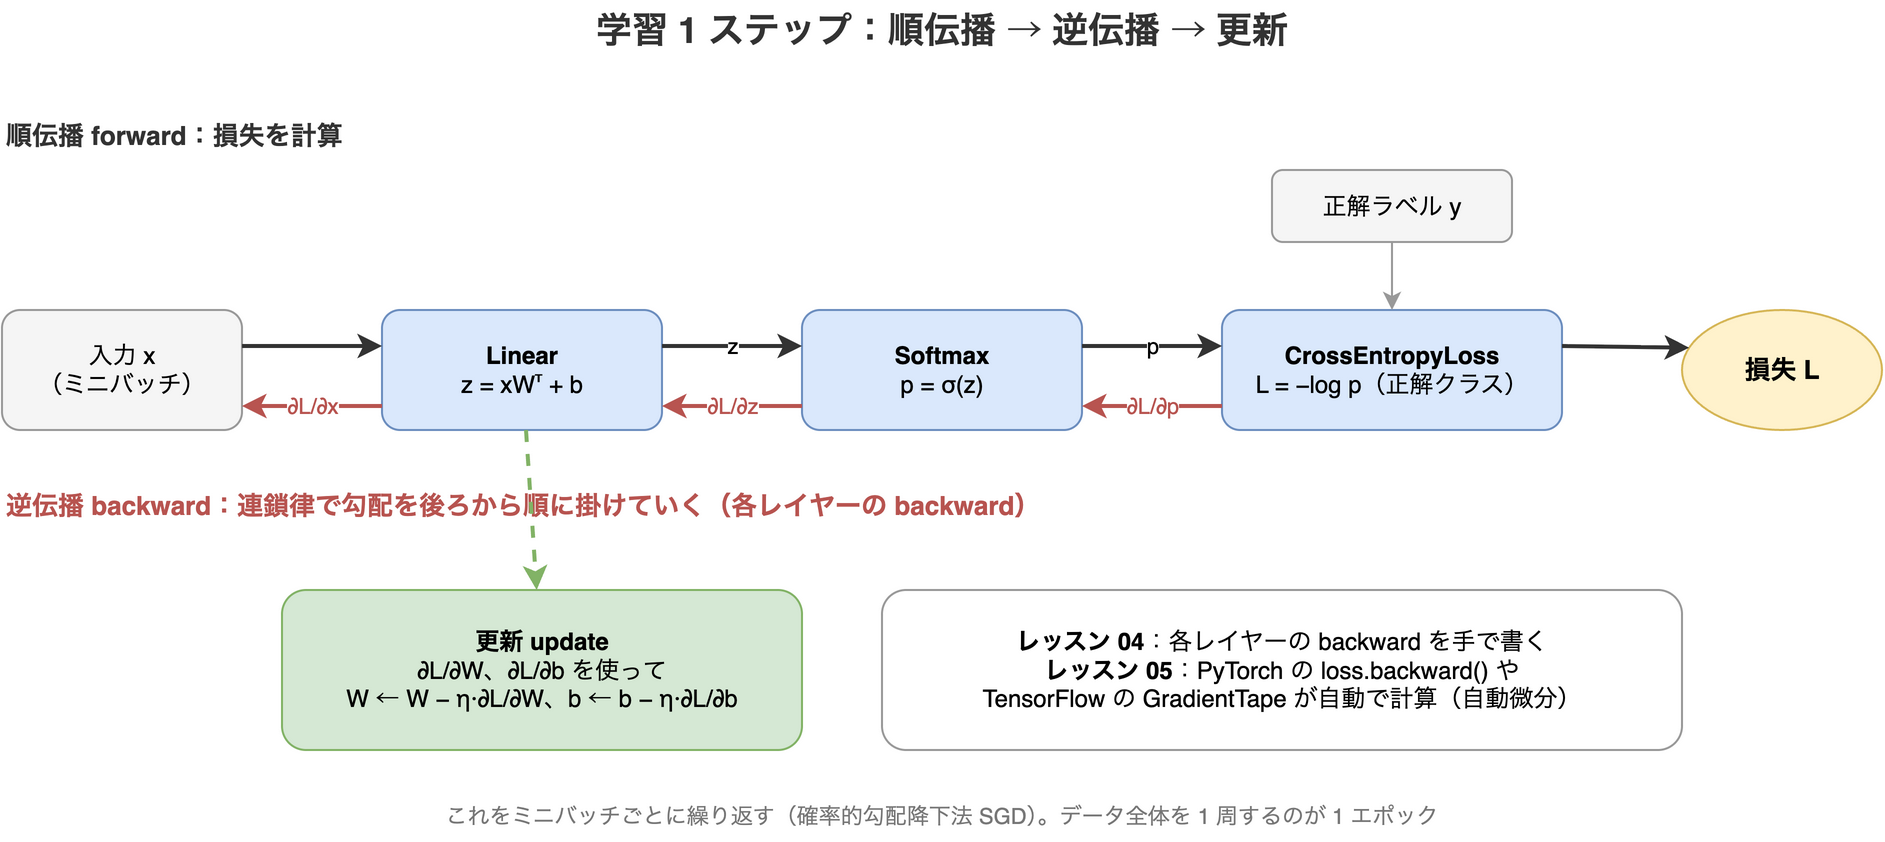
損失をパラメータで微分した 勾配 を計算し、損失が減る方向にパラメータを少しずつ動かすのが勾配降下法です(W ← W − η∂L/∂W)。本来はデータ全体で損失を計算すべきですが、実際にはランダムに取り出した小さな部分(ミニバッチ)ごとに勾配を計算して更新します。これが 確率的勾配降下法(SGD)です。データ全体を 1 周することを 1 エポック と呼びます。
誤差逆伝播法
層を重ねたネットワークは、z₁ = W₁x + b₁、z₂ = W₂α(z₁) + b₂、f = σ(z₂) のように段階的に計算します(α は非線形の活性化関数、σ は Softmax)。各パラメータの勾配は、微分の 連鎖律 で求められます。
- ∂L/∂W₂ = (∂L/∂σ)(∂σ/∂z₂)(∂z₂/∂W₂)
- ∂L/∂W₁ = (∂L/∂σ)(∂σ/∂z₂)(∂z₂/∂α)(∂α/∂z₁)(∂z₁/∂W₁)
どちらの式も先頭部分は共通です。そのため、計算の手順をノードとエッジで表した 計算グラフ を、損失の側から 逆向き にたどれば、共通部分を使い回して効率よく計算できます。これが 誤差逆伝播法(バックプロパゲーション)です。
NumPy で書くフレームワーク
ノートブックでは、各レイヤーを forward(順伝播)と backward(逆伝播)を持つクラスとして書きます。線形層は次のとおりです。
class Linear:
    def __init__(self,nin,nout):
        self.W = np.random.normal(0, 1.0/np.sqrt(nin), (nout, nin))
        self.b = np.zeros((1,nout))
        self.dW = np.zeros_like(self.W)
        self.db = np.zeros_like(self.b)

    def forward(self, x):
        self.x=x
        return np.dot(x, self.W.T) + self.b

    def backward(self, dz):
        dx = np.dot(dz, self.W)
        dW = np.dot(dz.T, self.x)
        db = dz.sum(axis=0)
        self.dW = dW
        self.db = db
        return dx

    def update(self,lr):
        self.W -= lr*self.dW
        self.b -= lr*self.db
backward は、出力側から受け取った勾配 dz から、重みの勾配 dW・db と、入力側へ渡す勾配 dx を計算します。Softmax と CrossEntropyLoss も同じ形で書き、レイヤーを並べて順番に呼ぶ Net クラスでまとめます。1 ミニバッチの学習は、次の 3 段階です。
# train_epoch() 関数の中の、1 ミニバッチ分の処理(抜粋)
        p = net.forward(xb)        # 順伝播
        l = loss.forward(p,yb)
        dp = loss.backward(l)      # 逆伝播
        dx = net.backward(dp)
        net.update(lr)             # 更新
2 特徴量・2 クラスの人工データでは、1 エポックで学習データの正解率が 0.725 から 0.825 に上がりました。ノートブックに記録された値と同じです。
多層にすると XOR が解ける
線形層の間に tanh のような非線形の活性化関数をはさむと、多層パーセプトロンになります。非線形の関数をはさまないと、線形層を何層重ねても 1 層と同じ表現力しかありません。線形関数の合成は線形だからです。
教材のフレームワークのクラスをそのまま使い、レッスン 03 で解けなかった XOR を学習させてみました。構成は、冒頭の図の右側と同じです。次のコードは、ノートブックで Linear・Tanh・Softmax・CrossEntropyLoss・Net・train_epoch を定義したあとに実行します。
xor_x = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=np.float32)
xor_y = np.array([0, 1, 1, 0])

net = Net()
net.add(Linear(2, 4))
net.add(Tanh())
net.add(Linear(4, 2))
net.add(Softmax())
for _ in range(2000):
    train_epoch(net, xor_x, xor_y, CrossEntropyLoss(), batch_size=4, lr=0.5)
結果は次のとおりです。
表の数値は、入力ごとの「クラス 1(XOR が 1)」の予測確率です。
| モデル | (0,0) | (0,1) | (1,0) | (1,1) | 結果 |
|---|---|---|---|---|---|
| 1 層(Linear → Softmax) | 0.5 | 0.5 | 0.5 | 0.5 | 判断できない |
| 2 層(Linear → tanh → Linear → Softmax) | 0.000 | 0.999 | 0.999 | 0.001 | 4 点すべて正解 |
1 層では、4 点すべての予測確率が 0.5 のままで、どちらのクラスとも判断できません。2 層にすると、4 点すべてを正しく、しかも確信を持って分類できました。
教材は、十分なニューロンがあれば 2 層のネットワークで任意の凸な集合(へこみのない形の領域)を、3 層でほぼ任意の集合を分類できる、と説明しています。
なぜいつも多層にしないのか
表現力の高いモデルほど学習データにぴったり合わせられますが、そのぶん新しいデータへの汎化に多くのデータを必要とします。これが次のレッスンで扱う 過学習 の問題です。ノートブックのまとめは、層やニューロンの少ない単純なモデルは過学習しにくく、複雑なモデルは検証誤差を見張る必要がある、というものです。
レッスン 05: フレームワークと過学習
フレームワークに求めるもの
ニューラルネットワークを効率よく訓練するには、テンソル(多次元配列)の演算と、あらゆる式の勾配計算が必要です。NumPy は前者はできますが、後者はできません。レッスン 04 の自作フレームワークでは、backward を手で書く必要がありました。フレームワークに期待するのは、定義した 任意の式の勾配を自動で計算 できることと、GPU や TPU で計算を並列化できることです。
教材は、代表的なフレームワークを低レベル API と高レベル API で整理しています。
| TensorFlow | PyTorch | |
|---|---|---|
| 低レベル API | TensorFlow | PyTorch |
| 高レベル API | Keras | PyTorch Lightning |
低レベル API はテンソルと計算グラフを直接扱えるので、新しいアーキテクチャを試す研究で使われます。高レベル API はネットワークを「レイヤーの並び」として扱い、データを用意して fit を呼ぶだけで訓練できます。両者は組み合わせて使えます。
教材はほとんどの内容を PyTorch 版と TensorFlow 版の両方で用意しています。どちらか好きな方だけを進めて構いません。
PyTorch の自動微分
requires_grad=True を付けたテンソルは、演算が記録されて計算グラフが作られます。backward() を呼ぶと、勾配が grad 属性に入ります。ノートブックの最初の例は、f(x₁, x₂) = (x₁ − 3)² + (x₂ + 2)² の最小値を勾配降下法で探すものです。
x = torch.zeros(2,requires_grad=True)
f = lambda x : (x-torch.tensor([3,-2])).pow(2).sum()
lr = 0.1

for i in range(15):
    y = f(x)
    y.backward()
    gr = x.grad
    x.data.add_(-lr*gr)
    x.grad.zero_()
    print("Step {}: x[0]={}, x[1]={}".format(i,x[0],x[1]))
Step 0: x[0]=0.6000000238418579, x[1]=-0.4000000059604645
Step 1: x[0]=1.0800000429153442, x[1]=-0.7200000286102295
...
Step 14: x[0]=2.894446849822998, x[1]=-1.929631233215332微分の式を一度も書いていないのに、最小点 (3, −2) に近づいていきます。PyTorch は勾配を 加算して蓄積 するので、ステップごとに x.grad.zero_() でリセットしている点にも注意してください。
次の線形回帰の例(y = 2x + 0.9 にノイズを加えたデータ)では、10 エポックで W = 1.8617、b = 1.0711 が得られました。こちらもノートブックの記録と同じ値です。
nn.Module とオプティマイザ
実際のネットワークは torch.nn で組み立てます。レイヤーを並べるだけなら Sequential、自由な計算をしたいなら torch.nn.Module を継承したクラスで書きます。勾配降下法そのものも torch.optim に用意されています。
# ノートブックのセルから抜粋(train の後半の検証部分は省略)
net = torch.nn.Sequential(torch.nn.Linear(2,5),torch.nn.Sigmoid(),torch.nn.Linear(5,1))

def train(net, dataloader, val_x, val_lab, epochs=10, lr=0.05):
  optim = torch.optim.Adam(net.parameters(),lr=lr)
  for ep in range(epochs):
    for (x,y) in dataloader:
      z = net(x).flatten()
      loss = torch.nn.functional.binary_cross_entropy_with_logits(z,y)
      optim.zero_grad()
      loss.backward()
optim.step()optim.zero_grad()(勾配のリセット)→ loss.backward()(逆伝播)→ optim.step()(更新)という 3 行が、レッスン 04 で手書きした処理にそのまま対応しています。2 クラスの人工データでは、どのモデルも検証データの正解率が 0.8〜0.87 程度になりました。
ノートブックの最後では、同じモデルを PyTorch Lightning の LightningModule に書き換え、Trainer で訓練します。accelerator='gpu' の指定は、筆者の Apple Silicon の Mac では MPS(Mac の GPU)が選ばれ、そのまま動きました。
Keras
TensorFlow 版の IntroKerasTF.ipynb は、tf.GradientTape による自動微分から始めて、Keras の compile と fit で訓練するところまで進みます。IntroKeras.ipynb は Keras だけで完結する入門で、2 値分類・多クラス分類・マルチラベル分類で、出力層の活性化関数と損失関数をどう組み合わせるかを整理しています。
過学習とバイアス・バリアンスのトレードオフ
レッスン 05 の後半は 過学習 です。教材は 5 つの点を近似する例で説明します。
| モデル | パラメータ数 | 学習誤差 | 検証誤差 |
|---|---|---|---|
| 直線(線形モデル) | 2 | 5.3 | 5.1 |
| 非線形モデル | 7 | 0 | 20 |
点が 5 つしかないのに、パラメータが 7 つあるモデルは全点を通る曲線を作れます。学習誤差は 0 になりますが、データの背後にある傾向をつかめていないので、検証誤差が大きくなります。モデルの豊かさ(パラメータ数)と学習データの量のバランスが大切です。
- 原因: 学習データが少ない、モデルが強力すぎる、入力データのノイズが多い
- 見分け方: 学習誤差がとても低いのに、検証誤差が高い。学習中は両方が下がり始めるが、ある時点で検証誤差が下げ止まって上がり始める。その時点で学習を止める(少なくともモデルを保存する)のが目安
- 対策: 学習データを増やす、モデルを単純にする、Dropout などの 正則化(モデルが学習データに合わせすぎないよう制約をかける手法)を使う
過学習は、統計学の バイアス・バリアンスのトレードオフ の一例です。モデルの力不足でデータの関係をつかめない誤差(バイアス、未学習)と、ノイズまで覚えてしまう誤差(バリアンス、過学習)のバランスを取る必要があります。
ノートブックを今の環境で動かすときの注意
ノートブックの多くは 2021〜2022 年のライブラリで実行されたままです(出力に PyTorch 1.11、TensorFlow 2.7 の表示が残っています)。2026 年 9 月時点のライブラリで動かすと、次の箇所で止まりました。
MNIST のデータ形式が変わっている(レッスン 03)
レッスン 03 の Perceptron.ipynb は、MNIST を MNIST['Train']['Features'] のように辞書として読みます。しかし、今のリポジトリの data/mnist.pkl.gz は、(学習, 検証, テスト) の 3 組のタプルです(それぞれ 50,000・10,000・10,000 枚、画素値は 0〜1 の小数)。そのため、MNIST を使うセルがすべて次のエラーで止まります。
TypeError: tuple indices must be integers or slices, not strリポジトリの履歴を見ると、元の data/mnist.pkl.gz は 2022 年 4 月のリポジトリ再編で削除され、2025 年 6 月に別の形式のファイルとして追加し直されていました。削除前のファイルは、Train だけを持つ辞書(42,000 枚、画素値は 0〜255 の整数)でした。前述の読み替えコードを使えば、ノートブックの残りはそのまま動きます。
NumPy 2 と Matplotlib の変更(レッスン 04)
レッスン 04 の OwnFramework.ipynb は、学習の様子をグラフで描く train_and_plot で止まります。原因は 2 つあります。
AttributeError: module 'numpy' has no attribute 'NAN'
AttributeError: 'ArtistList' object has no attribute 'pop'
1 つ目は、NumPy 2.0 で np.NAN という別名が削除されたためです。2 つ目は、Matplotlib で ax.lines や ax.collections がリストではなくなり、pop() が使えなくなったためです。次のように置き換えると、最後まで動きました。
np.NAN→np.nanax.lines.pop()→ax.lines[-1].remove()ax.collections.pop()→ax.collections[-1].remove()
なお、このノートブックは %matplotlib nbagg でグラフをアニメーション表示します。VS Code などの Jupyter 環境では、この表示方式に対応していないことがあります。
Keras 3 で compile の引数の順番が変わった(レッスン 05)
Keras のノートブックでは、model.compile(optimizer, 'binary_crossentropy', ['accuracy']) のように引数を位置で渡している箇所が、次のエラーで止まります。
ValueError: dtype='string' is not a valid dtype for Keras type promotion.Keras 3 では compile の引数が optimizer, loss, loss_weights, metrics, ... の順になり、3 番目の位置引数が metrics ではなく loss_weights として解釈されるためです。metrics=['accuracy'] とキーワードで渡せば動きます。TensorFlow 2.16 以降は、pip install tensorflow で入る Keras が Keras 3 になっています。
PyTorch Lightning のパッケージ名と accelerator(レッスン 05)
ノートブックは pip install pytorch-lightning と import pytorch_lightning as pl を使っています。今は lightning パッケージ(import lightning.pytorch as pl)が中心ですが、pytorch-lightning も同じバージョンで配布されていて、筆者の環境ではどちらでも動きました。
Trainer(accelerator='gpu', devices=1) は GPU を前提にした指定です。筆者の Mac では MPS が選ばれましたが、同じ Mac で accelerator='cuda' を指定すると MisconfigurationException で止まりました。環境に依存させたくなければ、accelerator='auto' にしておくのが無難です。
教材を読むときの補足
教材そのものの誤りをまとめます。日本語版は、この 3 レッスンでは本文の欠落がなく、英語版の誤りもそのまま翻訳されています。そのため、以下は特に断りがなければ英語版・日本語版に共通です。
コードの誤り
- レッスン 03 の README のサンプルコードは動かない: 重みの更新が
weights = weights + eta*weights.shapeになっていて、weights = [0,0,0]もリストなので、実行するとAttributeError: 'list' object has no attribute 'shape'になります。正しくは、ノートブック側のように、誤分類した例のベクトルを足し引きします(weights + eta*posなど)。README のコードは読み流して、ノートブックのコードを参照してください - PyTorch 版の手書き
Networkクラスが、勾配ではなく重みを 0 にしている: IntroPyTorch.ipynb の 1 層パーセプトロンの例では、zero_gradがself.W.data.zero_()、つまり重みそのものを 0 にしています。さらにupdateでは、バイアスをself.b.gradではなくself.bで更新しています。その結果、バイアスはずっと 0 のままで、重みは毎回 0 に戻されてから「これまでの勾配の合計」で置き換えられます。筆者の実行では、修正前も修正後も検証データの正解率は 0.8 で、結果だけを見ても気づきません。正しくはself.W.grad.zero_()(またはself.W.grad = None)とself.b.data.sub_(lr*self.b.grad)です。後半のtorch.optimを使う例は正しく書かれています - TensorFlow 版で
binary_crossentropyの引数が逆: IntroKerasTF.ipynb の「Using TensorFlow/Keras Optimizers」のセルは、tf.keras.losses.binary_crossentropy(z, y)と、予測値・正解の順に渡しています。正しい順番は(y_true, y_pred)です。同じ予測で比べると、正しい順番の損失 0.164 に対して、逆順では 2.40 になりました。ノートブックに残っている出力でも、損失が 4.78 から 8.43 へと 増えて います。binary_crossentropy(y, z)に直してください - レッスン 03 のラボのノートブックは最初のセルから動かない: PerceptronMultiClass.ipynb は、
import randomがないままrandom.choiceを使っています。未定義のwtsやtest_xで正解率を計算するセルがあり、データを取得するセルには URL がコードとして貼り付けられています。ラボは、本編のノートブックから関数を持ってきて書き直すつもりで取り組むのが現実的です - レッスン 04 の 0-1 損失の式が崩れている: ノートブックの式では、損失が 0 になる条件が「(f(x) < 0.5 かつ y = 0) または (f(x) < 0.5 かつ y = 1)」になっています。後半は f(x) ≥ 0.5 かつ y = 1 の誤りです
記述と表示の誤り
- MNIST の説明: Perceptron.ipynb は、MNIST を「Modified National Institute of Standards and Technology が作った」と書いていますが、MNIST は「修正版 NIST データセット(Modified NIST)」の略です。米国標準技術研究所(NIST)の 2 つの手書き文字データベースを、ヤン・ルカンらが組み直して作りました。また、MNIST 本来の学習データは 60,000 枚ですが、このコースの
mnist.pkl.gzに入っている学習データは、前述のとおり 42,000 枚(旧ファイル)または 50,000 枚(現ファイル)です - Keras は TensorFlow 専用ではなくなった: 教材は Keras を TensorFlow の高レベル API として紹介しています。しかし、2023 年の Keras 3 から、Keras は TensorFlow・JAX・PyTorch のどれでも動くマルチバックエンドのライブラリになっています
- 人名の綴り: パートの README の「Warren McCullock」は、正しくは McCulloch です(リンク先の PDF のファイル名は正しい綴りです)
- リンク切れ: PyTorch Lightning のリンク先
pytorchlightning.aiは 404 を返します。現在の公式サイトは lightning.ai です - 英語版のノートブックで画像が表示されない: 英語版の OwnFramework.ipynb は
images/Cross-Entropy-Loss.PNGとimages/ComputeGraphGrad.PNGを参照していますが、実際のファイル名は拡張子が小文字の.pngです。大文字小文字を区別する GitHub 上では 404 になります(macOS のように区別しない環境でローカル実行すると表示されます)。日本語版は画像が翻訳版のファイルに差し替えられていて、この問題はありません - README に「TODO: image citation」が残っている: レッスン 04 の README に、画像の出典を書く予定だった TODO がそのまま残っています。日本語版も「TODO: 画像の引用元」と翻訳されています
レッスンの進め方
レッスン 03〜05 はノートブックを動かすのが中心です。各レッスンに講義前・講義後のクイズとラボが付いています。
| レッスン | クイズ | ラボ |
|---|---|---|
| 03 パーセプトロン | 講義前 / 講義後 | パーセプトロンを 10 個(数字ごとに「その数字か、それ以外か」)作り、0〜9 の多クラス分類をする。正解率と混同行列(正解と予測の組み合わせごとに件数を数えた表)を出す |
| 04 多層パーセプトロン | 講義前 / 講義後 | 自作フレームワークで、1〜3 層のネットワークを使って MNIST を分類する |
| 05 フレームワーク | 講義前 / 講義後 | PyTorch か TensorFlow で、アヤメ(Iris)の 3 クラス分類と MNIST を、1 層・多層の全結合ネットワークで解く |
レッスン 03 のラボには、「10 個のパーセプトロンの重みを 1 つの行列にまとめれば、行列の掛け算 1 回と argmax で分類できる」というヒントがあります。これは、レッスン 04 の Linear 層と Softmax による多クラス分類そのものです。ラボを解くと、2 つのレッスンのつながりが実感できます。
レッスン 04 のラボの問いも示唆に富んでいます。「層の間の活性化関数は性能に影響するか」「層を増やしたときに学習で問題が起きたか」「学習中に重みの絶対値の最大値はどう変わるか」。層を深くしたときの学習の難しさは、この先のコンピュータビジョンのパートで扱う話題につながっています。
まとめ
- パーセプトロンは、重み付きの和をステップ関数に通す 2 値分類のモデルで、境界は直線(超平面)1 本。0 と 1 の手書き数字は 99.75% で分けられるが、XOR は 75% が上限
- 線形層の間に非線形の活性化関数をはさんだ多層パーセプトロンは、XOR も解ける。その学習は、連鎖律で勾配を後ろから計算する誤差逆伝播法による
- レッスン 04 で手書きした
backwardを自動化し、GPU で回すのがフレームワークの役割。PyTorch ではzero_grad→backward→stepの 3 行が、手書きの処理にそのまま対応する - 強力なモデルほど過学習しやすい。学習誤差と検証誤差の両方を見張り、データ量・モデルの複雑さ・正則化で調整する
- ノートブックは、MNIST のデータ形式、NumPy 2、Matplotlib、Keras 3 の変更で、そのままでは動かないセルがある
- 教材のコードの誤りもいくつかあるので、「今の環境で動かすときの注意」と「教材を読むときの補足」を手元に置いて進めるとよい
次のパート「IV. コンピュータビジョン」では、畳み込みニューラルネットワーク(CNN)で画像を扱います。レッスン 03 で見た「数字の位置がずれると誤分類する」というパーセプトロンの弱点を、CNN がどう克服するのかが見どころです(解説: コンピュータビジョンの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 06〜12)。