「あのアプリのこの機能、どうやって動いているんだろう?」——ソースコードが公開されていないアプリについて、この疑問を AI コーディングエージェントに調べさせるツールが REA(Reverse Engineer Anything)です。2026 年 10 月に GitHub で急速にスターを集め、国内でも note やニュースサイトで相次いで紹介されました。
この記事では、REA が何をするツールなのか、どう導入して使うのか、そして使う前に押さえておくべき法的・セキュリティ上の注意点を整理します。
REA とは
REA は、AI エージェントにリバースエンジニアリングの道具を持たせる MCP サーバー兼 CLI です。
| 項目 | 内容 |
|---|---|
| リポジトリ | morluto/rea |
| 公式サイト | rea.tools |
| npm パッケージ | rea-agents(執筆時点の最新は 6.4.0) |
| ライセンス | MIT |
| 実装言語 | TypeScript |
| 必要な Node.js | 22.x(22.19 以上)、24.x(24.11 以上)、または 26 以上 |
README のキャッチコピーは「See a feature you like. Understand how it works, down to the binary level.(気に入った機能を見つけたら、バイナリレベルまでその仕組みを理解する)」です。エージェントがアプリをソースコードなしで検査し、機能の仕組みを根拠つきで説明し、自分のプロジェクト向けに同等の機能を作る——という流れです。
人気の勢いはすさまじく、GitHub API で確認したスター数は執筆時点(2026-10-13)で約 19 万です。ただし紹介記事ごとに書かれている数字は数千から十数万まで大きくばらついています。急増中のプロジェクトなので、記事中の数字は執筆時点のスナップショットと考えたほうがよいでしょう。
仕組み:エージェントと解析エンジンの間に立つ
REA 自身が逆コンパイラを持っているわけではありません。エージェントと既存の解析ツールの間に入り、エージェントが各ツールの使い方を知らなくても解析を依頼できるようにするのが役割です。
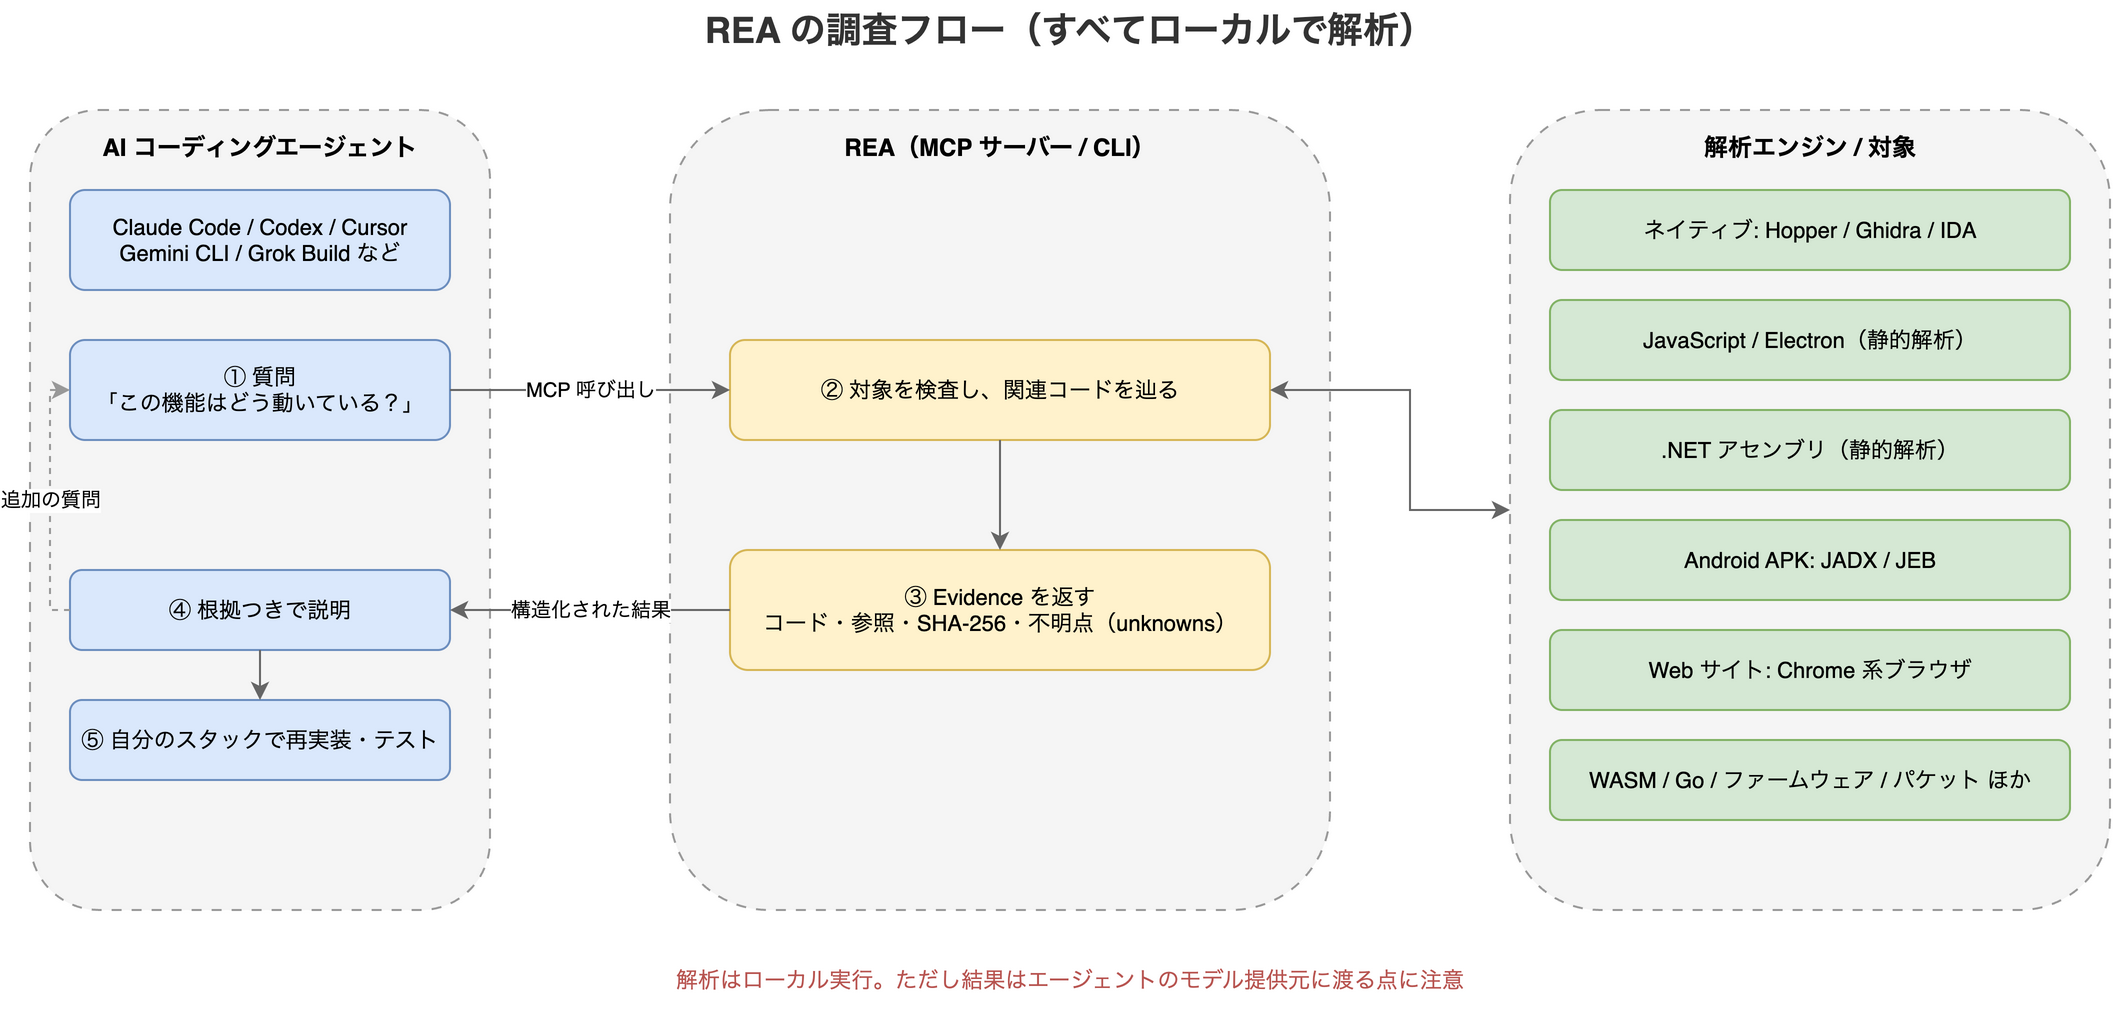
- エージェントが「この機能はどう動いている?」と REA に問い合わせる
- REA が対象を検査し、関連するコードを辿る
- 結果を Evidence(証拠)として構造化して返す
- エージェントが Evidence をもとに説明し、必要なら追加で質問する
- 最後に自分のスタックで同等の機能を実装・テストする
紹介記事では、この流れを「逆コンパイル → 理解 → 再構築」の 3 ステップとして紹介しています。
解析できる対象
README の対応表は 20 種類以上に及びます。主なものは次のとおりです。
| 対象 | 返ってくるもの | 必要なもの |
|---|---|---|
| ネイティブバイナリ | 疑似コード、アセンブリ、文字列、シンボル、呼び出し・参照関係 | Hopper / Ghidra / IDA のいずれか |
| JavaScript / Electron | モジュール、import、ソースマップ、ルート、IPC | Node.js と npm のみ |
| .NET アセンブリ | メタデータ、CIL 命令、ネイティブ依存 | 不要(静的解析のみ) |
| Android APK | マニフェスト、クラス、逆コンパイルしたメソッド | ヘッドレス JADX と JDK |
| Web サイト | ページ構造、スクリプト、ネットワーク観測、スクリーンショット | Chrome 系ブラウザ |
| その他 | Go バイナリ、WASM、EVM バイトコード、ファームウェア、パケットキャプチャなど | 対象ごとに異なる |
JavaScript と .NET の静的解析は、対象ファイルを実行せずに読むだけです。一方、ランタイムキャプチャ系の機能は、自分のユーザー権限で対象を実際に動かします。
Evidence:結論ごとに根拠を付ける
REA の特徴は、解析結果を Evidence という構造化レコードで返す点です。AI Heartland の検証記事によると、Evidence には次のような項目が含まれます。
evidence_id:SHA-256 ベースのコンテンツアドレス IDsubject.digest.sha256:解析対象ファイルのハッシュpredicate_type: rea.analysis:in-toto 風の型名provider/parameters:使用した解析エンジンと解析パラメータintegrity_policy:整合性ポリシー。既定はfailで、対象の整合性が確認できなければ処理を止める
根拠が見つからない点は推測で埋めず「不明(unknowns)」として返す設計です。エージェントの説明が「それらしい作り話」になるのを抑える狙いがあります。
導入と基本的な使い方
セットアップ
npx rea-agents setup対話形式で連携するエージェントを選び、変更内容を確認して承認します。MCP サーバーの登録とワークフロー用の指示(Agent Skill)が追加され、既存の設定はバックアップされます。終わったらエージェントを再起動してください。 再起動しないと MCP の設定が反映されません。
セットアップが対応するエージェントは Claude Code、Codex、Cursor、Gemini CLI、Grok Build などです。それ以外でもローカル MCP サーバーに対応したクライアントなら、手動登録で使えます。
エージェントへの頼み方
使い方は自然言語で頼むだけです。README の例を訳すと次のようになります。
Notes アプリの検索がどう動いているか理解して、根拠を見せて、
自分のプロジェクトに同様の機能を作ってください。
ターミナルから直接使う
エージェントを介さず CLI でも同じ処理ができます。たとえば展開済みの Electron アプリや ASAR を静的解析するには次のようにします(/absolute/path/to/app は解析したいアプリの絶対パスに置き換えてください)。
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json常用するならグローバルにインストールします。
npm install --global rea-agents
rea --help
更新が非常に速いプロジェクトなので、README はこまめなアップデートを勧めています。
rea updateネイティブ解析にはエンジンが別途必要
ネイティブバイナリの深い解析には Hopper・Ghidra・IDA のいずれかが必要です。Ghidra を使う場合は、公式ドキュメント(docs/installation.md)にあるとおり JDK 21 以上を入れ、環境変数 GHIDRA_INSTALL_DIR を設定します。エンジンの状態は rea doctor で診断できます。
rea doctor --provider ghidra --json引数なしで rea doctor を実行すると全エンジンを点検します。そのため、使わないエンジンが入っていないだけでも healthy: false になります。調べたいエンジンを --provider で絞ると結果が読みやすくなります。
事例:何ができるのか
公式サイトと README では、次のようなショーケースが紹介されています。
- DX-Ball:古いゲームのサウンドのパン(左右定位)計算を x86 命令から追い、C で再構築した。元の x86 実装に対する 3,205 件のテストケースを通過し、コンパイル後の関数 63 バイトも完全に再現した
- Notion:Electron アプリのクリップボード API を、レンダラーから preload、IPC を経てメインプロセスまで追跡した
- TH04:PC-98 版ゲームの 16 ビット命令から弾幕のリング状配置の計算を復元し、C++ で再構築した
国内の事例では、ソースコードが失われた約 20 年前の VB.NET 製業務アプリ(物件管理システム)を Web アプリに作り直した報告があります(note の記事)。この事例では Ghidra を使っていません。.NET アセンブリに同梱された XML ドキュメントから DataTable のクラス名を拾い、約 30 のテーブル構成を推定しています。.NET アプリはクラス名やプロパティ名が残りやすいため、逆コンパイラなしでもかなりのことが分かる好例です。
使う前に押さえておきたい注意点
リバースエンジニアリングが「専門家の技能」から「プロンプト一つ」になったことで、考えるべきことが増えました。1・2 は法的な注意、3〜6 はセキュリティ上の注意です。
1. 解析対象のライセンス(EULA)を確認する
REA 自体は MIT ライセンスですが、解析対象のソフトウェアの利用規約は別問題です。商用ソフトの EULA には、リバースエンジニアリング・逆コンパイル・逆アセンブルを明示的に禁じているものが少なくありません。
REA の README も、用途を「合法的な研究、教育、相互運用性の確保、ソフトウェアの保存、自分が所有するか解析を許可されたソフトウェアの解析」に限定しています。また「仕組みを理解できること」と「それを複製してよいこと」は別の話です。誰のソフトウェアを、何のために解析するのかを説明できる状態で使いましょう。
2. 商用解析エンジンのライセンスは別途必要
IDA Pro や Hopper、JEB といった商用エンジンは、利用者が正規にライセンスを取得する必要があります。REA はツールのライセンスやアクティベーションを一切提供しません。
3. 「ローカル解析」でも結果はモデル提供元に渡る
解析そのものはローカルで実行され、REA が対象ファイルをアップロードすることはありません。ただし、解析結果はエージェントを経由してモデル提供元に送られます。README の FAQ にも「エージェントのモデル提供元には、それぞれのデータポリシーがある」と明記されています。顧客から預かったバイナリを解析する場合は、使うモデルのデータ取り扱い方針を確認しておく必要があります。
4. エージェントに与える権限を絞る
AI Heartland の記事では、rea capabilities --json で各機能が副作用を宣言している点が評価されています。宣言されるのは、プロセス起動・ファイル書き込み・UI 表示・ネットワークアクセスなどの有無です。同記事の計測(v4.0.1 時点)では、16 機能のうち 10 機能がプロセスを起動していました。機能の数は版ごとに変わるので、導入した版で一度確認しておきましょう(グローバルインストール済みの場合)。
rea capabilities --jsonそのうえで、エージェントに無制限の実行権限を与えたまま使うのは避けたほうが無難です。
5. バイナリ側からのプロンプトインジェクション
解析対象のバイナリに細工した文字列を仕込み、それを読んだ AI を誤誘導する攻撃も懸念されています。エージェントのレポートを鵜呑みにせず、Evidence の中身を人が確認する前提で使いましょう。抽出された文字列に命令文のようなものが混ざっていないかを見る、解析セッションではエージェントのファイル書き込みやネットワーク権限を外す、といった対策が考えられます。
6. ツール自体の信頼性
人気があることは安全性の保証になりません。急成長中でリリースも頻繁なプロジェクトだけに、導入するバージョンや権限の範囲は慎重に判断したいところです。業務で使うなら npx -y rea-agents@6.4.0 ... のようにバージョンを固定し、更新前にリリースノートを確認する運用が安心です。
開発者・企業にとっての意味
REA のようなツールが当たり前になると、「ソースコードを非公開にしていれば機能は真似されない」という前提は成り立たなくなります。特に Electron アプリや Android アプリは中身を読まれやすく、クライアントアプリに API キーや秘密のロジックを埋め込む設計は、これまで以上に危険です。
一方で、ベンダーが撤退して保守できなくなったレガシーシステムを読み解き、作り直す道が開けるという前向きな面もあります。ソースコードが失われた社内システムの移行は、まさに REA が力を発揮する場面でしょう。
まとめ
- REA は、AI エージェントにリバースエンジニアリングの道具を持たせる MIT ライセンスの MCP サーバー兼 CLI
npx rea-agents setupでエージェントに登録し、あとは自然言語で「この機能の仕組みを調べて」と頼むだけ- ネイティブバイナリには Hopper / Ghidra / IDA が必要だが、JavaScript / Electron や .NET はエンジンなしでも静的解析できる
- 結論ごとに Evidence(根拠)を返し、分からない点は「不明」として返す設計
- 使う前に、特に解析対象の EULA、商用エンジンのライセンス、モデル提供元への送信、エージェントの権限の 4 点を確認する
- 守る側としては、クライアントアプリに秘密情報やロジックを埋め込む設計がこれまで以上に危険になる
道具そのものは中立です。強力になったぶん、「誰の、何を、なぜ解析するのか」を説明できることが、使う側の最低条件になったと言えるでしょう。