この記事は、次の 3 本に続くレイクハウスのシリーズの 4 本目です。
- Apache Iceberg 入門:データレイクを「テーブル」にする仕組みと DuckDB との関係
- DuckLake 入門:メタデータを SQL データベースに置くレイクハウスフォーマットと Iceberg との違い
- Redshift か、S3 + Iceberg のレイクハウスか:DWH とオープンテーブルフォーマットの選び方
レイクハウスの世界は Iceberg と DuckLake だけではありません。Delta Lake・Hudi・Paimon といったほかのテーブルフォーマットや、XTable などフォーマット同士をつなぐ変換ツールがあります。ほかにも、Polaris や Unity Catalog などのカタログ、ストリーミングの Fluss、Lance などの AI 向けフォーマットと、周辺の動きはたくさんあります。
結論を先に書くと、Iceberg を共通の土台にしつつ、用途に応じて周辺の技術を組み合わせる方向に進んでいます。この記事では、その全体像を層ごとに整理します。
2026 年のレイクハウス技術マップ
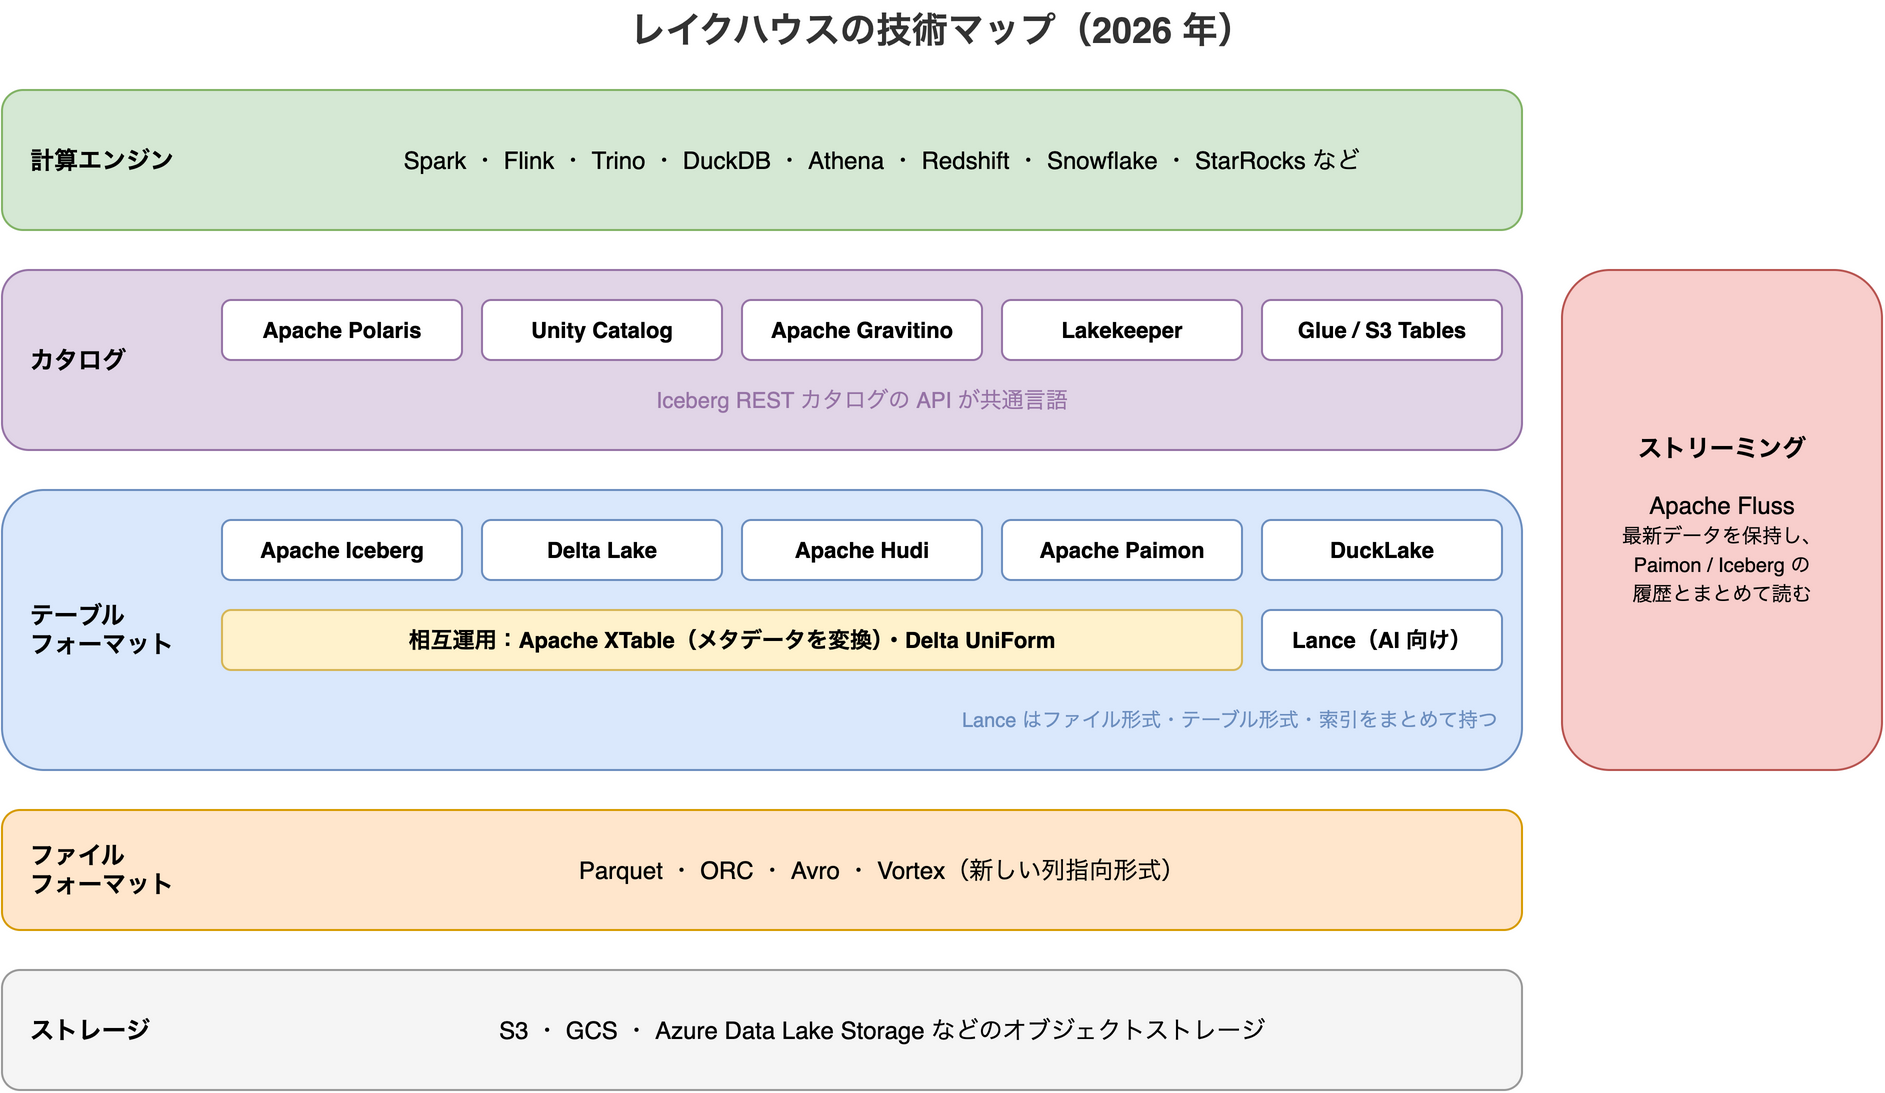
1 本目の記事では、データ基盤を「分散ストレージ/計算エンジン/テーブル化技術」の 3 層で捉えました。この図は、そのうちのテーブル化技術を、ファイルフォーマット・テーブルフォーマット・カタログの 3 つに分けたものです。
この記事では、中心にある Iceberg 自体の進化から始めて、ほかのテーブルフォーマット、相互運用、カタログ、ストリーミング、AI 向けフォーマットの順に、外側へ広げていきます。
Iceberg v3 の新機能と、その先
まず土台の Iceberg 自体も進化しています。Iceberg v3 の主な機能は次のとおりです。
- 削除ベクター:削除した行をビットマップで持ち、Puffin ファイル(Iceberg が統計や索引を保存するためのファイル形式)に保存します。2 本目の記事で見た DuckLake の削除ベクターと同じ考え方です。
- 行の系譜(row lineage):各行に ID と更新された時点を持たせ、変更の追跡をしやすくします。
- Variant 型:JSON のような半構造化データを効率よく扱います。
- 列の既定値:列にデフォルト値を設定できます。
3 本目の記事で見たとおり、Redshift は 2026 年 8 月に Iceberg v3 テーブルに対応しました。ほかの主要なサービスでも v3 への対応が進んでいます。次の v4 についても、メタデータの効率化などをテーマにした提案が出始めています(Dremio による解説)。ただし、まだ仕様として確定した段階ではありません。
Iceberg 以外のテーブルフォーマット:Delta Lake・Hudi・Paimon
Delta Lake:Databricks と Spark の世界の標準
Delta Lake は Databricks が開発したテーブルフォーマットで、現在は Linux Foundation のプロジェクトです。Databricks や Spark を中心にしたデータ基盤では、事実上の標準になっています。
Delta Lake 4 系では、半構造化データを扱う Variant 型が加わりました。4.2.0 では、Delta Kernel(エンジンから Delta テーブルを読み書きするためのライブラリ)のテーブル機能として、Variant が GA(一般提供)になっています。
Iceberg との関係では、後述する UniForm が重要です。Delta テーブルに Iceberg のメタデータも書き出すことで、Iceberg に対応したエンジンから Delta テーブルを読めるようにします。
Apache Hudi:更新とインデックスに強い
Apache Hudi は、データレイク上での更新・挿入(upsert)や削除を効率よく行うことを得意とするフォーマットです。Hudi 1.0 は 2024 年 12 月にリリースされ、その後 1.1 が 2025 年 11 月に出ています。
特徴はインデックスです。特定のキーのレコードを探すときに全ファイルを読まずに済むので、CDC(変更データの取り込み)のように細かい更新が多い処理や、キーを指定した検索に向いています。
Apache Paimon:ストリーミングのためのテーブル
Apache Paimon は、もともと Flink のコミュニティで「Flink Table Store」として作られたフォーマットです。2024 年に Apache のトップレベルプロジェクトになりました(ASF の発表)。
データを LSM ツリー(書き込みを溜めて後からまとめる構造)で持つのが特徴で、Flink から次々と流れてくる更新を取り込み続ける用途に向いています。Iceberg は、バッチで作ったテーブルを多くのエンジンで共有するのが得意です。一方 Paimon は、ストリーミングで常に更新され続けるテーブルを得意とします。
Iceberg・Delta Lake・Hudi・Paimon・DuckLake の比較
Iceberg と DuckLake の詳細は、シリーズの 1 本目と 2 本目を参照してください。
| フォーマット | 主な推進役 | 得意なこと |
|---|---|---|
| Apache Iceberg | Apache(多数の企業) | 多数のエンジンでの共有。対応製品が最も多い |
| Delta Lake | Databricks(Linux Foundation) | Databricks / Spark との統合 |
| Apache Hudi | Apache | 更新・削除とインデックス |
| Apache Paimon | Apache(Flink コミュニティ発) | ストリーミングでの継続的な更新 |
| DuckLake | DuckDB チーム | メタデータを SQL データベースに置く軽量な構成 |
フォーマット同士をつなぐ:XTable と UniForm
フォーマットが複数あると、「部署 A は Delta、部署 B は Iceberg を使っている」という状況が起きます。データファイル(Parquet)は共通なので、メタデータだけを変換すれば、データをコピーせずに別のフォーマットとして読めます。この考え方で作られているのが次の 2 つです。
- Apache XTable:Hudi・Iceberg・Delta Lake の間で、データファイルを書き直さずにメタデータを変換します。2026 年 8 月の 0.4.0 では、変換元として Paimon とプレーンな Parquet にも対応しました。まだ Apache のインキュベーション段階(正式なプロジェクトになる前の育成段階)です。
- Delta UniForm:Delta Lake 側の機能で、Delta テーブルに Iceberg などのメタデータも書き出します。XTable のサイトの FAQ では、UniForm は Delta から他のフォーマットへの一方向の変換で、XTable はどの方向にも変換できる、と説明されています。
どちらも、あるフォーマットで作ったテーブルを、別のフォーマットに対応したエンジンからも読めるようにする仕組みです。ただし、変換先のフォーマットに固有の書き込み機能まで使えるわけではありません。変換先のフォーマットでは、基本的に読み取りに使うと考えておくのが安全です。
カタログ:Iceberg REST が共通言語に(Polaris・Unity Catalog・Gravitino・Lakekeeper)
1 本目の記事で見たとおり、Iceberg のカタログは「テーブル名 → 最新のメタデータの位置」を管理します。この分野ではいま、Iceberg REST カタログの API を実装したカタログが次々に登場しています。API が共通なので、エンジンはカタログの実装を問わずに接続できます。
| カタログ | 概要 |
|---|---|
| Apache Polaris | Snowflake と Dremio が始めた Iceberg REST カタログ。2026 年 2 月に Apache のトップレベルプロジェクトに昇格 |
| Unity Catalog(OSS 版) | Databricks が 2024 年 6 月にオープンソース化し、LF AI & Data Foundation(Linux Foundation 傘下の財団)に寄贈。Iceberg REST カタログの API にも対応 |
| Apache Gravitino | Iceberg、Hive、Kafka、MySQL など複数種類のデータソースのメタデータをまとめて管理する。2025 年 6 月にトップレベルプロジェクトに昇格 |
| Lakekeeper | Rust で書かれた Iceberg REST カタログ。OpenFGA(OSS の認可エンジン)による細かな権限管理に対応 |
| AWS Glue Data Catalog / S3 Tables | AWS のマネージドなカタログ(シリーズの 1 本目と 3 本目で紹介) |
カタログは、単にテーブルの場所を教えるだけでなく、誰がどのテーブルを読めるかというガバナンスの中心にもなりつつあります。複数のエンジンで同じデータを共有するなら、どのカタログを使うかは、どのフォーマットを使うかと同じくらい大事な選択です。
選ぶときの軸としては、AWS の中で完結するなら 3 本目で見た Glue Data Catalog や S3 Tables が手軽です。複数のクラウドやエンジンにまたがって共有するなら、Polaris や Lakekeeper のような OSS の REST カタログが候補になります。
ストリーミングストレージ Apache Fluss:レイクハウスをリアルタイムに
レイクハウスは、もともと鮮度の高いデータを扱うのが苦手でした。2 本目の記事で見たように、細かい書き込みを繰り返すと小さなファイルが増えてしまうので、ある程度まとめてから書き込むのが普通だからです。
Apache Fluss は、この弱点を補うためのリアルタイム分析向けのストリーミングストレージです。2026 年 8 月に Apache のトップレベルプロジェクトになったばかりで、名前は「Flink Unified Streaming Storage」に由来します(Fluss のブログ)。
Fluss は最新のデータを保持し、長期の履歴は Paimon や Iceberg のテーブルに置きます。Union Read(Fluss の最新データとレイクの履歴を 1 回のクエリでまとめて読む機能)を使うと、両者を 1 つのテーブルとして扱えます。
AI 向けのフォーマット:Lance と Vortex
Lance:AI 向けのレイクハウスフォーマット
Lance は LanceDB チームが開発する、AI・機械学習のワークロード向けのレイクハウスフォーマットです。ファイルフォーマット、テーブルフォーマット、軽量なカタログ仕様を兼ね、埋め込みベクトル、テキスト、画像、音声をまとめて保存できます。Parquet が苦手なランダムアクセスを速くする設計で、ベクトル検索や全文検索の索引も持てます。
DuckDB からも lance 拡張で読み書きできます(DuckDB の検証記事)。<...> の部分は自分の環境の値に置き換えてください。
INSTALL lance;
LOAD lance;

SELECT *
FROM '<データセットのパス>.lance'
LIMIT 10;
ただし DuckDB の検証記事では、Lance が常に Parquet より速いわけではなく、処理の種類によって結果が分かれています。RAG や機械学習のデータ基盤を作るときの選択肢の 1 つ、と捉えておくのがよいでしょう。
Vortex:Parquet の次を狙う列指向フォーマット
Vortex は、圧縮した Apache Arrow(メモリ上で列指向データを扱う標準形式)の配列を扱う、拡張可能な列指向のファイルフォーマットです。LF AI & Data Foundation でインキュベーション段階のプロジェクトになっています。Parquet の次の世代を狙うフォーマットの 1 つです。
まとめ
- 土台の Iceberg も v3 で削除ベクターや行の系譜が加わり、Redshift など主要なサービスで対応が進んでいます。
- テーブルフォーマットは Iceberg だけでなく、Databricks 中心の Delta Lake、更新に強い Hudi、ストリーミング向けの Paimon、軽量な DuckLake があり、それぞれ得意分野が違います。
- XTable や UniForm を使えば、データをコピーせずにフォーマット間でメタデータを変換し、別のエンジンからも読めるようにできます。
- カタログは Iceberg REST の API が共通言語になり、Polaris、Unity Catalog、Gravitino、Lakekeeper などが競っています。ガバナンスの中心としての役割も大きくなっています。
- Fluss はレイクハウスにリアルタイム性を、Lance と Vortex は AI ワークロードへの最適化を持ち込もうとしています。
- シリーズ全体では、まず Iceberg(小規模で DuckDB 中心なら DuckLake)を土台に選び、BI からの同時アクセスが多い集計は Redshift に持ちます。そのうえで、必要に応じてカタログ、ストリーミング、AI 向けフォーマットを足していく、という整理になります。