はじめに
PKSHA Technology のテックブログに掲載された「AI ネイティブなデータ分析基盤を作った話」(2026 年 9 月公開)が、X で「すごい」と話題になっていました。
PKSHA VoiceAgent の SRE が、社内向けのデータ分析基盤「Laplace」を ほぼ 1 人で、しかもコードをほとんど自分で書かずに 立ち上げた記録です。BigQuery・dbt・Lightdash という構成自体は珍しくありません。読みどころは、人間と AI の両方が同じ指標定義を使ってセルフサービス分析できる ように、定義・権限・PII の扱いを設計しているところです。
この記事では、元記事の設計判断を整理し、自分たちの基盤に持ち帰れるポイントをまとめます。数字や固有名詞は元記事の記述に基づいています。
前提:登場するプロダクトと用語
本文に入る前に、この記事に出てくるプロダクトと用語を簡単に説明します。
プロダクト
| プロダクト | 種類 | この基盤での役割 |
|---|---|---|
| Amazon Aurora | AWS のマネージド RDB(MySQL / PostgreSQL 互換) | 分析対象のデータを持つプロダクトの本番 DB |
| Redash | OSS の BI・クエリツール | 以前の分析環境。SQL を書いてグラフを作る |
| BigQuery | Google Cloud のサーバーレス DWH(データウェアハウス) | 分析用データの置き場所。オンデマンド課金では、クエリがスキャンしたデータ量で課金される |
| Datastream | Google Cloud の CDC サービス | Aurora の変更を BigQuery に流し込む |
| Cloud Storage(GCS) | Google Cloud のオブジェクトストレージ | ファイルで渡すデータの受け口 |
| AWS Glue | AWS のサーバーレス ETL サービス | 一部の列を定期的に BigQuery へ転送する |
| dbt | SQL でデータ変換を書くツール | 生データを分析しやすい形に整え、指標の定義も持つ |
| Lightdash | dbt と連携する BI ツール(コアは OSS、一部の企業向け機能は別ライセンス) | ダッシュボードと探索画面を提供し、権限も制御する |
| GKE Autopilot | Google Cloud のマネージド Kubernetes | Lightdash や dbt を動かす実行基盤 |
| Terraform | インフラをコードで管理するツール | クラウドの構成をまとめて定義する |
| Claude Code | Anthropic の AI コーディングエージェント | 基盤のコードを書き、分析の窓口にもなる |
用語
| 用語 | 意味 |
|---|---|
| DWH(データウェアハウス) | 分析用にデータを集めて保管するデータベース。本番 DB とは分けて置くことで、重い集計が本番に影響しない |
| CDC(Change Data Capture) | DB の変更(INSERT / UPDATE / DELETE)を差分として拾い、別の場所に反映する方式 |
| binlog | MySQL 系 DB が書き出す変更ログ。CDC の情報源になる |
| スナップショット | ある時点のテーブルを丸ごとコピーする方式。CDC と対になる |
| raw / staging / mart | dbt でよく使う層構成。raw は取り込んだまま、staging は型や名前を整えたもの、mart は分析用に集計・結合したもの |
| セマンティックレイヤー | 「売上」「アクティブユーザー」などの指標の定義を 1 か所にまとめる層。ツールや人によって数字がずれるのを防ぐ |
schema.yml | dbt でモデルの列・説明・テストなどを書く YAML ファイル。Lightdash は、ここに書いた meta から指標の定義を読む |
| Explore | Lightdash で分析の起点になる単位。YAML に定義した dbt モデルが、原則として 1 つの Explore になる |
| セルフサービス分析 | エンジニアに頼まず、ビジネス側の人が自分でデータを見て分析すること |
| PII(個人識別情報) | 氏名・電話番号・メールアドレスなど、個人を特定できる情報 |
| 決定的ハッシュ | 同じ入力からは常に同じ値になるハッシュ。元の値を隠したまま、同じ人かどうかは判別できる |
| ソルト | ハッシュをかける前に足す秘密の値。総当たりで元の値を推測されるのを防ぐ |
| 行レベルセキュリティ | 同じテーブルでも、ユーザーごとに見える行を絞る仕組み |
| MCP(Model Context Protocol) | AI エージェントが外部のツールやデータにつなぐための共通プロトコル。MCP サーバーがツールを提供し、AI クライアントがそれを呼び出す |
| OAuth | パスワードを渡さずに、ほかのアプリへ権限を委譲する認可の仕組み |
以前の状態と 3 つの課題
もともとの分析は、Redash から Aurora のリードレプリカに直接 SQL を投げる形でした。分析用のレイヤーはなく、最大のログテーブルは約 2.5 TB あります。元記事は課題を 3 つ挙げています。
- 重いクエリが返ってこない
- ダッシュボードを 1 枚作るたびにエンジニアの手が要る
- PII(個人情報)があるため、PII を使わない分析でも権限を絞らざるを得ない
元記事は課題 3 について「『権限を絞る』という対処が課題 2 を悪化させます」と書いています。PII を守るために権限を絞るほど、エンジニア待ちが増えるという構造です。セルフサービス化とガバナンスを 同時に 解かないと前に進まない、というのが出発点になっています。
「AI ネイティブ」が意味するもの
元記事は DIKW(Data / Information / Knowledge / Wisdom)モデルを拡張し、Wisdom を Insight と Narrative に分けて、最後に Action を加えた 6 層で整理しています。
- Insight:AI が担う
- Narrative:AI が下書きし、人間が判断する
- Action:定型的なものは自動化する
元記事は、AI 以後の最大の変化を「Insight 層の民主化」、つまり誰もが AI を通じて洞察にたどり着けることだとしています。そのためには、AI が迷わないように 指標の定義(セマンティックレイヤー)が明確であること が以前よりずっと重要になります。
Laplace が現在担うのは、Data・Information・Knowledge の層と、AI からの入口(MCP)、そしてガバナンスです。Narrative と Action の支援は今後の予定です。
全体アーキテクチャ:BigQuery・dbt・Lightdash・MCP
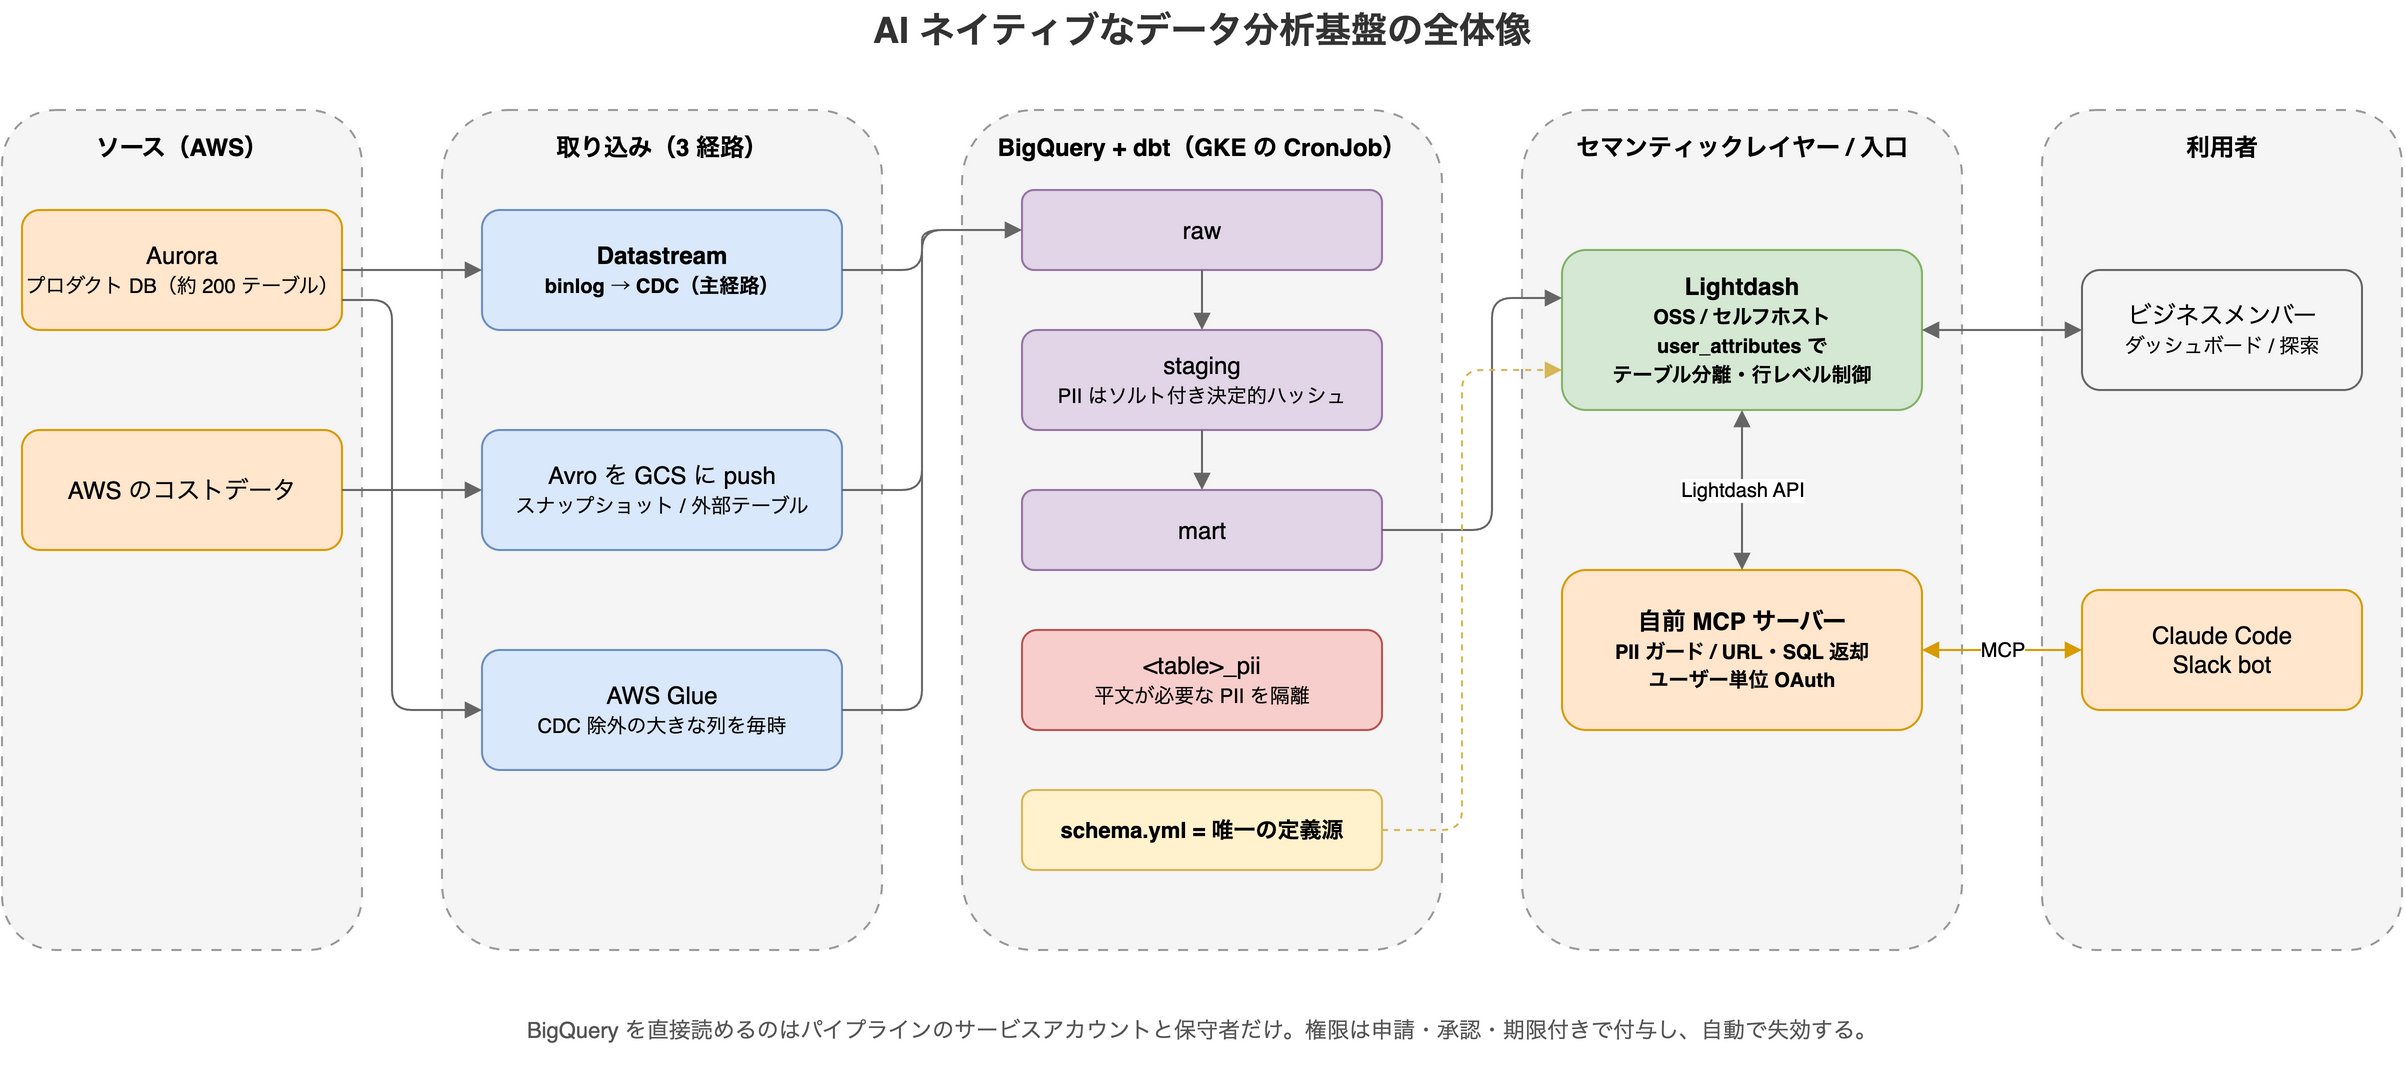
構成要素を層ごとに並べると次のとおりです。
| 層 | 採用技術 | 役割 |
|---|---|---|
| 取り込み | Datastream / GCS(Avro)/ AWS Glue | データを BigQuery に取り込む(3 経路、後述) |
| DWH・変換 | BigQuery + dbt | raw → staging → mart の層構成で変換 |
| セマンティック・BI | Lightdash(OSS をセルフホスト) | dbt の schema.yml から Explore を生成 |
| AI の入口 | 自前の MCP サーバー | PII ガード、Lightdash URL と SQL の返却、ユーザー単位 OAuth |
| 実行基盤 | GKE Autopilot + Terraform | Lightdash・dbt の CronJob・MCP サーバー・社内ツールを 1 クラスタに集約 |
BigQuery への取り込みは 3 経路です。
- Datastream:Aurora の binlog を読み、CDC で BigQuery に直接書き込みます。Aurora の 200 テーブル弱はすべてこの経路で、主経路です。
- AWS Glue:CDC から除外した幅の広い列を、毎時 BigQuery に書き込みます。
- GCS 経由の push:Avro ファイルを GCS に push し、BigQuery の外部テーブルとして読むスナップショット経路です。認証はキーレスの Workload Identity Federation です。現在は AWS のコスト集約データで使われています。
Aurora の全テーブルを mart まで出すために作った dbt モデルは、staging と mart を合わせて 577 本にのぼります。
新しいプロダクトは products/<product>/config.yaml を 1 つ足すだけで追加できます。dbt プロジェクトはプロダクトごとに分けています。dbt のモデル名はプロジェクト内で一意でなければならないので、プロジェクトの境界を名前空間の境界にして、プロダクト間の衝突を仕組みで防いでいるわけです。
設計の核心:意味の定義を 1 か所に集める
元記事が「最も効果的だった指針」として挙げているのが、意味の定義を 1 か所に集める ことです。
BI ツールに Lightdash を選んだ理由もここにあります。Lightdash は dbt の schema.yml に書いたメトリクスやディメンションをそのまま Explore にするので、定義を二重に持たずに済みます。比較した候補と見送った理由は次のとおりです。
| 候補 | 見送った理由 |
|---|---|
| Lightdash Cloud | 現段階では費用対効果が合わない(将来の移行先としては残す) |
| Looker | エンタープライズ契約が必須で高コスト |
| Cube + Metabase | 定義が dbt と Cube に二重化する |
定義が 1 か所にあると、AI は定義済みの指標だけを使って分析できます。後述する PII の制御も「命名とラベルの契約」に落とし込めます。BI の選定から AI の挙動、ガバナンスまで、この 1 つの判断が効いているわけです。
データガバナンス:読んでよいデータを制御する
BigQuery を直接読ませない
BigQuery を直接読めるのは、パイプラインのサービスアカウントと保守担当者だけです。利用者はすべて Lightdash を通してアクセスし、アクセス制御も BI 層で行います。
- テーブル単位の分離:dbt の meta に
required_attributesを宣言し、属性を持たないユーザーにはそのテーブルを見せない - 行レベルの制御:ユーザーの
user_attributesの値を、生成される SQL のフィルタに差し込む
PII は 3 段構え
- ソルト付きの決定的ハッシュ:staging でハッシュをかけます。同じ値は同じハッシュになるため、同じ連絡先からの複数回の利用を同じ主体として集計できます。ソルトは基盤側だけが持ち、ハッシュ値から元の値は復元できません。
<table>_piiへの隔離:平文が必要な PII 列は、別テーブルに切り出します。- クエリ履歴の監査:
INFORMATION_SCHEMA.JOBS(BigQuery のジョブ履歴)を dbt で監査します。
列レベルで制御する BigQuery の Policy Tags は、タクソノミーと IAM の運用が重すぎるとして採用していません。
権限は申請して期限付きでもらう
PII テーブルへのアクセスは、小さな社内ツールで管理しています。申請 → 承認 → 期限付きで user_attributes を付与 → 期限が来たら自動で剥奪、という流れです。「絞る」のではなく「必要な人が必要な期間だけ持つ」形にして、課題 2 と課題 3 の板挟みをほどいています。
AI からのセルフサービス分析:MCP サーバー
元記事によると、Lightdash 組み込みの MCP は Enterprise Edition の機能です(セルフホストの場合は Enterprise ライセンスが必要)。そこで、OSS の @lightdash-tools/mcp をベースに自前の MCP サーバーを用意し、PII ガード、根拠となる URL の返却、社内ツールとの連携を足しています。AI クライアント(Claude Code や Slack bot)は、この MCP サーバーを通して Lightdash を操作します。
認証はユーザー単位の OAuth です。そのため、AI が見られる範囲は、その人が Lightdash で見られる範囲と同じになります。
AI に PII を読ませない
コンパイル後の SQL の FROM / JOIN が *_pii テーブルを参照している場合、クエリ自体は実行しますが 行の値は返しません。代わりに成否、行数、Lightdash で開ける URL、SQL を返します。AI は「何件あるか」までは分かり、中身を見る必要がある人は URL から自分の権限で確認する、という分担です。
この判定が単純な名前マッチで成り立つのは、次の 3 つを dbt の CI で強制しているからです。
- PII テーブルの命名が
*_piiであること data_class: piiラベルが付いていることrequired_attributesが宣言されていること
ルールを人に覚えてもらうのではなく、CI で落ちる契約にしているのがポイントです。
LLM が妥当なチャートを作れるようにする工夫
クライアント側のプロンプトに頼らず、サーバー側で品質を担保する 方針で、次の 4 つの工夫をしています。
- チャート種別のガイドを返すツール:Lightdash の 10 種類のチャートについて、分析上の使いどころを一覧で返す
- 設定キーの抽出:公開ドキュメントが手薄だったため、デプロイ中の Lightdash のソースからチャート設定のキーと enum 値を抜き出して渡す
- URL と SQL を必ず返す:LLM が URL を自作して間違えることがあったため、チャートやダッシュボードを作るツールは必ず正しい Lightdash URL とコンパイル済み SQL を返す
- レスポンスの整形:大きな Explore では 1 回の応答が 256 KB に達していたため、REST の応答を LLM 向けに絞る。存在しないフィールドを指定したときは候補を返し、1 往復で自己修正できるようにする
「AI が間違えたらプロンプトを直す」のではなく「間違えようのないツールにする」という発想は、MCP サーバーを作るときにそのまま使えます。
1 人で作る:コードはほぼ全部 LLM が書いた
元記事の筆者は「コードは SQL を含めほぼ全て Claude Code に任せ、私自身はコードを書いていません」と書いています。テーブル定義の調査も、Claude Code にプロダクトのリポジトリと Notion を探索させて進めたそうです。
ただし任せきりではなく、LLM が書いたコードを縛るガードレールを用意しています。
- PII の命名規則を検査する CI の lint
- Terraform のユニットテスト
- MCP サーバーの差分に対するスモークテスト
- 理由と計測値を残すコミットメッセージ
- 計画ファイルの決定ログ(撤回した決定も含めて 100 件超)
元記事の結論にある「LLM に任せるルールは、CI とテストで強制する」という考え方は、AI にコードを書かせるあらゆる現場に通じます。
結果
着手から約 1 か月で利用を開始し、元記事の時点で 2 か月運用しています。
| 指標 | 値 |
|---|---|
| 社内ユーザー | 29 人 |
| ダッシュボード | 32 枚 |
| コンテンツ閲覧 | 2 か月で 4,500 回超 |
| 月額コスト | 約 1,150〜1,250 USD |
失敗談:CDC で 1 日 330 USD を払った
元記事のおまけとして、コストの失敗談が率直に書かれています。
スナップショットから CDC へ
当初は日次スナップショットを想定していました。しかし Aurora のスナップショットエクスポートは インスタンス全体のデータ量 で課金されます。数 MB のテーブルを 1 つ出すだけでも数 TB 分を毎回払うことになり、日次で回すと月 1,000 USD を超えます。一方、Datastream は ソース側で処理した量 で課金されます。
加えて、INSERT 後の UPDATE も含め 30 分以内の鮮度が求められていました。この 2 点から CDC に切り替えています。
見落とし 1:BigQuery の CDC は適用のたびにテーブル全体を読む
CDC を有効にした後、BigQuery の課金が 1 日約 330 USD に跳ね上がりました。ピークの日は 43.5 TiB を読み込み、その 95% が上位 5 テーブルでした。BigQuery の CDC は変更を適用するたびにテーブル全体を読み、パーティションでは削減できません。オンデマンド課金では、この読み込みがそのまま請求に乗ります。この挙動は BigQuery の CDC ドキュメントに明記されており、元記事は自身の設計上の見落としだったと認めています。
max_staleness(変更の反映をどこまで遅らせてよいか)を緩めた結果、読み込み量は 1 日約 0.3 TiB(ピークの 1/100〜1/150)に落ち着きました。
見落とし 2:Datastream の量の大半が 1 テーブルの JSON 列だった
Datastream の量の 86% が 1 つのテーブルから来ており、そのテーブルの行サイズの 60% は 2 つの JSON 列でした。この 2 列を含む 7 列は、もともと PII が混入するとして staging に持ち込まないと決めていた列です。ソース側でこれらを除外し、月約 400 USD を削減しています。
2 つの対策を合わせて、ピークの水準が続けば月 1 万 USD 近くになる計算だった BigQuery の読み込みコストが、月 70 USD 前後に収まりました。予算アラートは全体・BigQuery・Datastream・GKE の 4 つの単位で設定しています。
教訓は「パイプラインのツール単価だけでなく、ソース側の課金ルールまで含めて コストを見積もる」ことです。
持ち帰れるポイント
元記事から、自分たちの基盤にも当てはまりそうな点をまとめます。
- 定義は 1 か所:dbt の
schema.ymlを唯一の定義源にし、BI と AI の両方がそこを見る。AI 時代のセマンティックレイヤーは「あると便利」ではなく前提条件になる - ガバナンスは CI で守る契約にする:命名・ラベル・属性を CI で強制すれば、PII ガードのような仕組みを単純な実装で済ませられる
- AI の品質はサーバー側で担保する:URL や SQL のような「間違えると困るもの」は、LLM に作らせずツールが返す
- 権限は期限付きで渡す:絞るのではなく、申請・承認・自動失効で回す
- コストはソース側の課金まで見る:CDC の適用コストのように、ドキュメントにあっても見落としやすい罠がある
まとめ
Laplace の設計は、「AI に分析させる」ための特別な仕組みを足したというより、意味の定義・権限・PII の扱いを、人間にも AI にも同じ規則で効くように整理した 結果だと読めます。その上で、AI 向けの入口(MCP サーバー)には「間違えにくいツール」という工夫を重ねています。
LLM にコードを書かせて 1 人で基盤を作るという点も含め、これから分析基盤を作る・作り直すチームにとって参考になる事例です。詳細はぜひ元記事を読んでみてください。
関連記事
- AWS だけで作る AI ネイティブなデータ分析基盤:Aurora zero-ETL × Redshift × dbt 構成案:この事例の設計を、Google Cloud を使わず AWS だけで実現する場合の構成案
- データ照会チャットボットはデータ分析基盤を作ってから?ツール呼び出し・Text-to-SQL・セマンティックレイヤーの関係と進め方:業務システムのデータ照会チャットボットと、このような分析基盤をどう組み合わせ、どの順番で作るか