はじめに
このブログでは最近、AI でデータに答えさせる仕組みを 2 つの方向から取り上げました。
- データ照会チャットボット:Text-to-SQL vs ツール呼び出し — 権限管理のある業務システムに AI データ照会を組み込む(以下「チャットボットの記事」)。業務システムの既存ロジックを照会ツールとして LLM に呼ばせ、監査担当など一部の役割にだけ Text-to-SQL を開放する構成です。
- データ分析基盤:PKSHA Technology の事例を紹介したBigQuery × dbt × Lightdash × MCP で作る AI ネイティブなデータ分析基盤(以下「PKSHA の事例」)と、それをAWS だけで作る構成案。DWH に dbt で指標の定義を集め、BI と AI が同じ定義で分析する構成です。
どちらも「AI がデータを調べて答える」仕組みなので、チャットボットは分析基盤を作ってから実装したほうがよいのか、という疑問が出てきます。
結論から言うと、分析基盤の完成を待つ必要はありません。2 つは答える質問の種類が違い、チャットボットの中核(ツール呼び出し)は分析基盤なしで作れるからです。
ただし、分析基盤があると良くなる部分もあります。チャットボットの一部である Text-to-SQL と、これから増える分析系の質問です。最適なのは、チャットボットから小さく始め、そのログを根拠に分析基盤を育て、最後に両者を 1 つの窓口にまとめる 進め方です。
この記事では、2 つのシステムの関係を整理したうえで、その進め方を説明します。
前提:登場するプロダクトと用語
用語
| 用語 | 意味 |
|---|---|
| 業務 DB | 業務システムが日々の登録・更新に使うデータベース。常に最新の値を持つ |
| DWH(データウェアハウス) | 分析用にデータを集めて保管するデータベース。複数のシステムのデータや過去の履歴をまとめて持つ |
| CDC(Change Data Capture) | DB の変更を差分として拾い、別の場所に反映する方式。業務 DB から DWH へのコピーに使う |
| 読み取り専用レプリカ | 業務 DB の複製で、読み取りだけを受け付けるもの。本番の負荷を避けて照会に使う |
| ツール呼び出し(Function Calling / Tool Use) | アプリが用意した関数を LLM に選ばせて実行する方式。LLM は「どの関数をどの引数で呼ぶか」だけを決める |
| Text-to-SQL | 自然文の質問から LLM が SQL を生成し、DB に実行する方式 |
| 決定論的 | 同じ入力には常に同じ処理・同じ結果になること。ツール呼び出しの先にある業務ロジックは決定論的で、LLM が生成する SQL はそうではない |
| セマンティックレイヤー | 「売上」「原価」などの指標の定義(計算式・集計の粒度・結合)を 1 か所にまとめた層 |
| staging / mart | dbt の層構成。staging は生データの型や名前を整えた層、mart は分析用に集計・結合したテーブル群 |
| PII(個人識別情報) | 氏名・電話番号・メールアドレスなど、個人を特定できる情報 |
| 正本 | その数字の正式な出どころ。業務システムでは、帳票や画面を計算するアプリのコードが正本になることが多い |
| オントロジー | 業務用語の定義と同義語、用語どうしの関係をまとめたもの |
| MCP(Model Context Protocol) | AI エージェントが外部のツールやデータにつなぐための共通プロトコル |
プロダクト
| プロダクト | 種類 | この記事での役割 |
|---|---|---|
| dbt | SQL でデータ変換を書くツール | DWH 上で mart を作り、指標の定義(schema.yml)を持つ |
| Lightdash | dbt と連携する BI ツール(コアは OSS) | セマンティックレイヤーの指標でダッシュボードと探索を提供し、権限も制御する |
| dbt MCP サーバー | dbt Labs が公開している MCP サーバー(dbt-labs/dbt-mcp) | AI エージェントから dbt のモデルや指標の情報を使えるようにする |
| NVIDIA Auto Ontology | DB のメタデータからオントロジーを作り、Text-to-SQL の精度を上げる OSS(紹介記事) | チャットボットの記事で、Text-to-SQL 部分の候補として取り上げたもの |
2 つのシステムは何が違うのか
データ照会チャットボットとデータ分析基盤は、どちらも「データについての質問に答える」ものですが、答える質問の種類 が違います。
| 観点 | データ照会チャットボット(ツール呼び出し) | データ分析基盤(DWH + セマンティックレイヤー) |
|---|---|---|
| 典型的な質問 | 「この案件の今月の原価は?」「先月の入金はいくら?」 | 「事業所別の原価率の推移は?」「受注から入金までの日数の傾向は?」 |
| 質問の性質 | 特定のレコードについての、今の値 | 多数のレコードをまたいだ集計・推移・比較 |
| データの鮮度 | リアルタイム(業務 DB を直接見る) | CDC の分だけ遅れる(設定次第で数分〜数十分。PKSHA の事例は 30 分以内を要件にした) |
| データの範囲 | 1 つの業務システム | 複数のシステムと過去の履歴をまとめて扱える |
| 権限の判定 | 業務システムの行単位の権限(ログイン中の利用者として実行) | BI 層の権限(ユーザー属性によるテーブル・行の制御) |
| 数字の正本 | 業務システムのコード(画面・帳票と同じ計算) | dbt の指標定義 |
| 重いクエリの影響 | 業務システムに負荷がかかる | DWH で処理するので業務システムに影響しない |
チャットボットの記事では、ツール呼び出しを中核にすると結論づけました。業務システムでは、権限と計算の正本がアプリのコードにあるからです。この性質は、分析基盤を作っても変わりません。DWH にコピーしたデータは、アプリの行単位の権限も、画面と同じ計算ロジックも通らないからです。
一方、分析基盤が得意なのは、業務システムが苦手な質問です。期間や部門をまたいだ集計、複数システムの突き合わせ、過去の推移などは、業務 DB に直接投げると重く、画面のロジックにも用意されていないことが多いはずです。
つまり 2 つは 代替関係ではなく、得意な質問が違う補完関係 にあります。
チャットボットと分析基盤の関係:完成形は「3 つの経路を持つ 1 つの窓口」
両方がそろった完成形を図にすると、次のようになります。
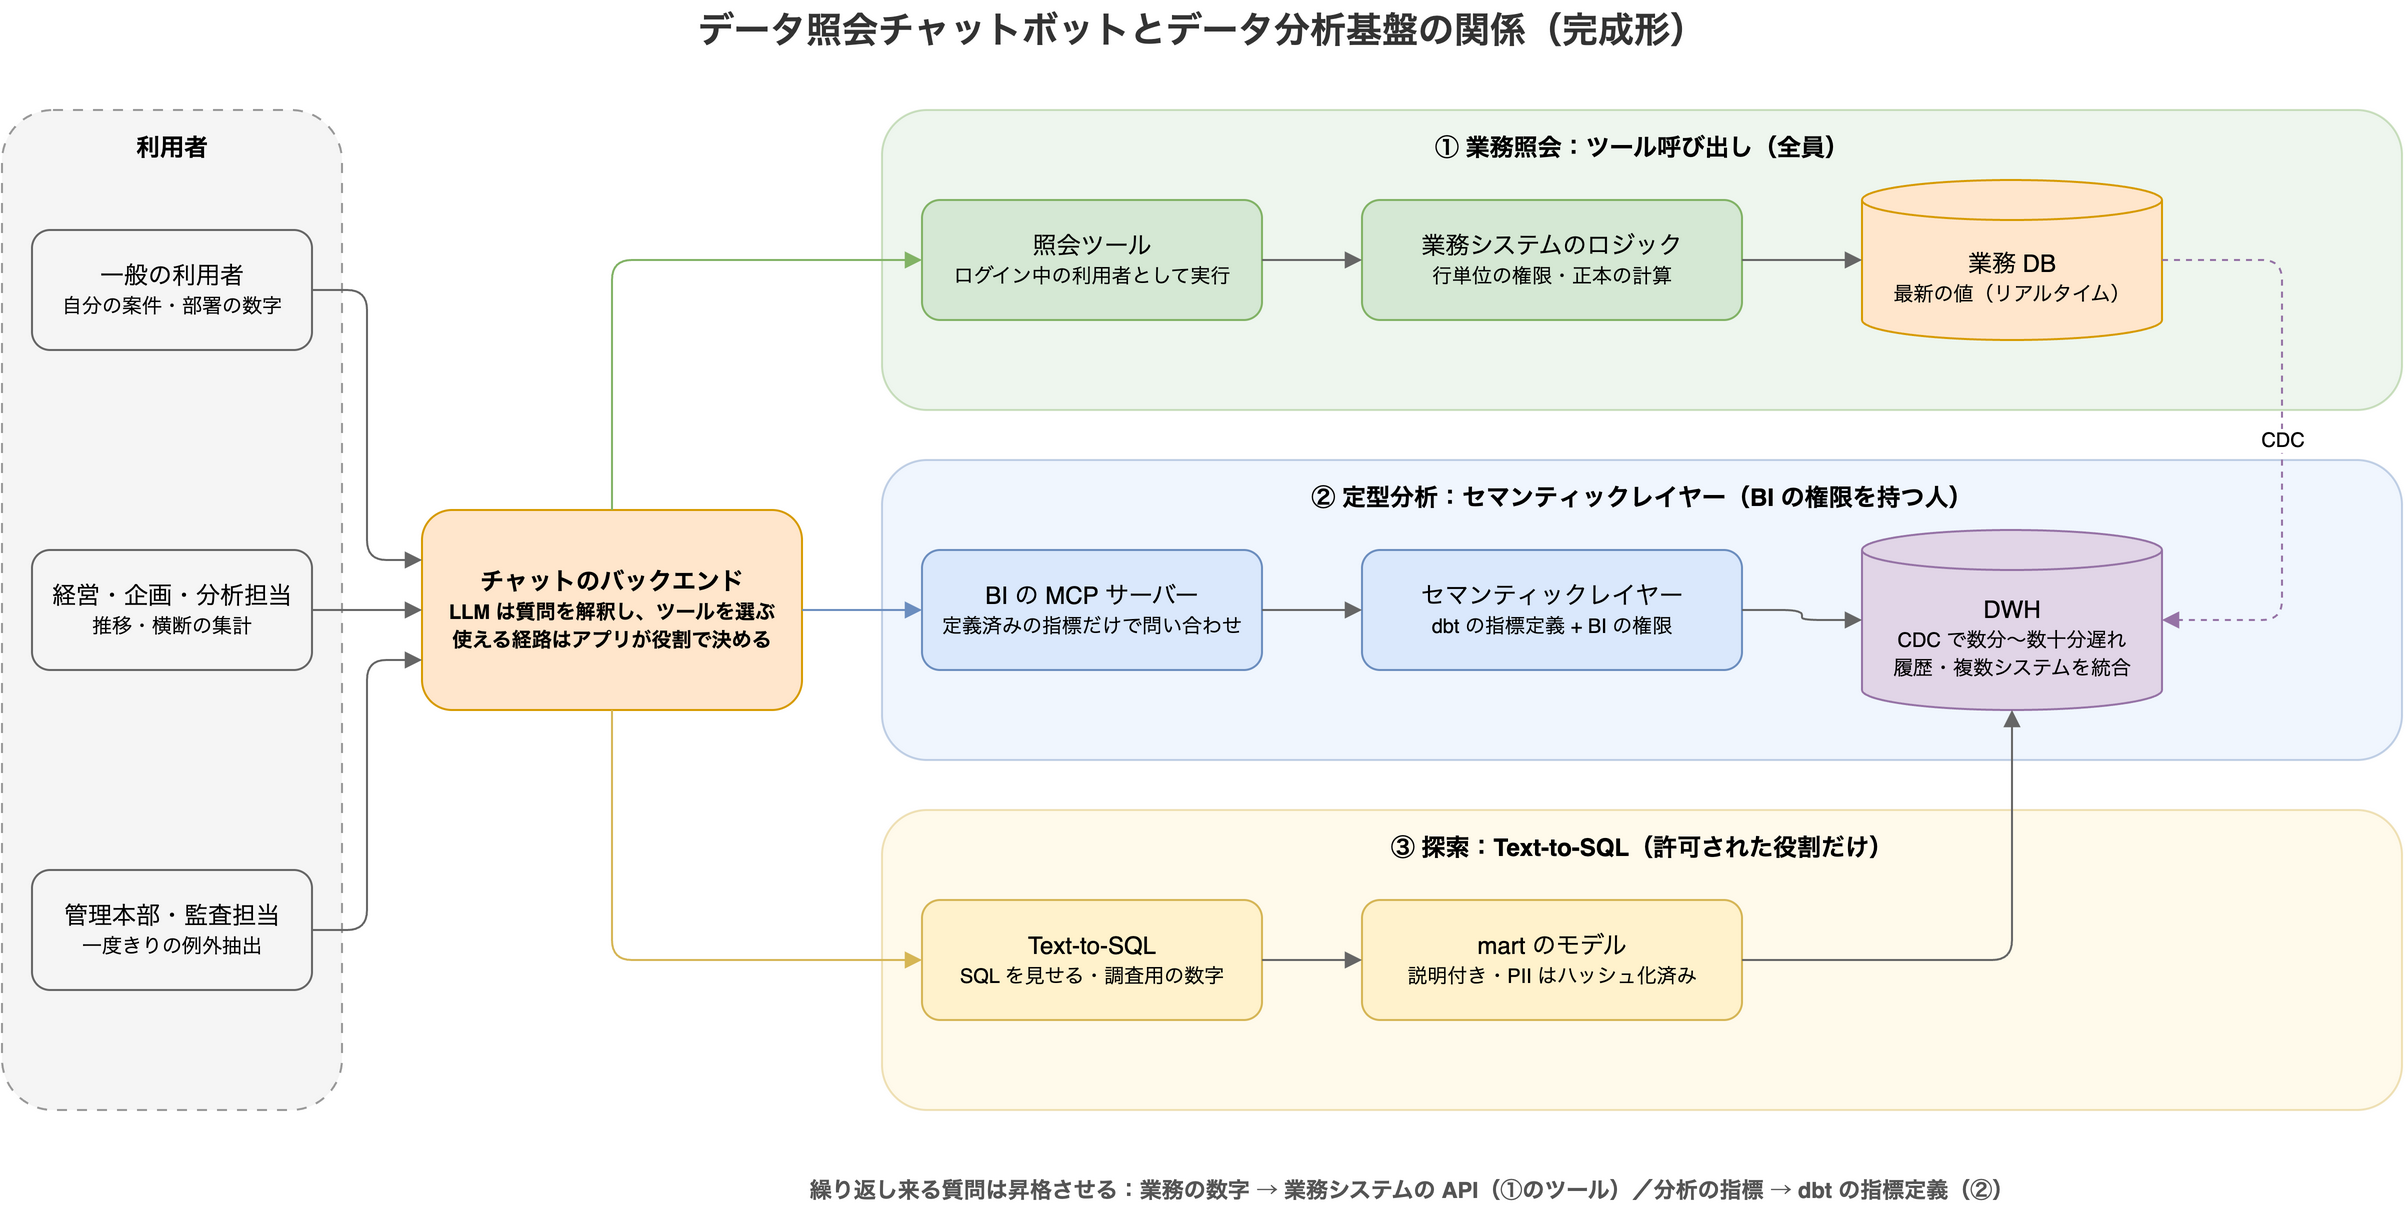
| 経路 | 答える質問 | 使える人 | 問い合わせ先 | 数字の扱い |
|---|---|---|---|---|
| ① 業務照会(ツール呼び出し) | 特定の案件・伝票の今の値 | 全員 | 業務システムのロジック → 業務 DB | 正本(画面・帳票と同じ) |
| ② 定型分析(セマンティックレイヤー) | 定義済みの指標の集計・推移 | BI の権限を持つ人 | BI の MCP サーバー → セマンティックレイヤー → DWH | 分析用の公式指標 |
| ③ 探索(Text-to-SQL) | 一度きりの例外抽出・突き合わせ | 許可された役割だけ | DWH の mart(または読み取り専用レプリカ) | 調査用の数字 |
ポイントは 3 つです。
- 窓口は 1 つ、経路は役割で決める:利用者から見ればチャットは 1 つです。どの経路を使えるかは、チャットボットの記事と同じく アプリがログイン中の利用者の役割で決め、LLM には権限を広げさせません。
- 優先順位は ① → ② → ③:答えられる経路のうち、より決定論的なものを優先します。どのツールを呼ぶかは LLM が選ぶので、優先順位はツールの説明文とシステムプロンプトで指示します。さらに ③ は、アプリ側で「① と ② のツールでは答えられなかった」と判定したときだけ呼べるようにしておくと確実です。
- ③ の接続先は、分析基盤ができたら DWH の mart に移す:チャットボットの記事では、Text-to-SQL の接続先を読み取り専用レプリカか分析用 DB としていました。分析基盤があれば、その「分析用 DB」が DWH の mart になります。
ただし、この完成形を一度に作る必要はありません。
導入の進め方:分析基盤を待たずにチャットボットから始める 4 段階
おすすめは次の 4 段階です。
| 段階 | 作るもの | 分析基盤 | 次へ進む合図 |
|---|---|---|---|
| 1 | ① ツール呼び出しのチャットボット | 不要 | ツールで答えられない質問がログにたまってくる |
| 2 | ③ Text-to-SQL を許可された役割に開放(読み取り専用レプリカ) | 不要 | 横断・推移の質問が増え、レプリカでは重い・遅い |
| 3 | データ分析基盤(DWH + dbt + BI) | ここで作る | 定型の分析質問の指標が固まってくる |
| 4 | ② を追加し、③ の接続先を DWH の mart に移す | 活用する | (改善サイクルを回し続ける) |
段階 1:ツール呼び出しは分析基盤なしで作れる
① の経路は、業務システムの既存ロジックを呼ぶだけなので、DWH も dbt も要りません。一般の利用者がいちばんよく聞く「自分の案件の数字」に、画面と同じ権限・同じ計算で答えられます。最初に価値を出せるのはここです。
先に分析基盤を作ろうとすると、データの取り込み、dbt のモデル、権限の設計と、利用者に価値が届くまでの準備が長くなります。しかも、どの指標を作り込むべきかがまだ分かっていない 段階で作ることになります。
段階 2:Text-to-SQL は読み取り専用レプリカで小さく始める
監査担当のような一度きりの複雑な問い合わせには、チャットボットの記事のとおり、許可された役割にだけ Text-to-SQL を開放します。この段階の接続先は、業務 DB の読み取り専用レプリカで十分です。
後で述べるように、Text-to-SQL は DWH の mart に向けたほうが正確になります。それでもこの段階でレプリカから始めてよいのは、次の理由からです。
- 使うのは、SQL を読んで結果を検証できる、許可された役割の人に限っている
- 生成された SQL を必ず見せ、結果は調査用の数字として扱う
- この段階のいちばんの目的は、精度よりも 問い合わせのログを集めること にある
ツールで答えられなかった質問と、Text-to-SQL が生成した SQL がたまっていくと、「利用者が本当に知りたい集計」が見えてきます。これは、分析基盤で何を作るべきかの要求一覧そのものです。
段階 3:データ分析基盤を作るタイミング
次のような合図が出てきたら、分析基盤を作る時期です。
- レプリカへのクエリが重い:期間や部門をまたいだ集計で、タイムアウトや待ち時間が目立つ
- 複数のシステムをまたぐ質問が増えた:チャットボットの記事では「DB をまたいだ結合をどこまで扱えるか」を懸念点に挙げました。DWH に集めれば、この問題そのものがなくなります
- 過去の時点の値が必要になった:業務 DB は今の値しか持たないことが多く、「先月末時点の残高」のような質問に答えにくい
- 同じ集計が何度も Text-to-SQL に回ってくる:業務システムの API にするより、分析の指標として定義したほうが自然な集計が繰り返し来る
- 経営・企画の担当者がダッシュボードを求め始めた
段階 2 のログがあれば、分析基盤の最初の mart と指標を「実際に聞かれた質問」から決められます。PKSHA の事例のように、少人数で短期間に立ち上げる場合でも、作る対象が絞れていることは大きな助けになります。
段階 4:② を足し、③ を DWH に移す
分析基盤ができたら、チャットボットに ② の経路を追加します。Lightdash の MCP サーバー(PKSHA の事例では OSS をベースに自前で拡張したもの)や dbt MCP サーバーを通して、定義済みの指標だけを使って 問い合わせる経路です。これで経営・企画の担当者は、ダッシュボードと同じ指標の数字を、チャットで聞けるようになります。
あわせて、③ Text-to-SQL の接続先をレプリカから DWH の mart に移します。
例外:分析基盤を先に作ったほうがよい場合
次のような場合は、段階 3 から始める(分析基盤を先に作る)ほうが合っています。
- 最初から主な要求が経営・企画のダッシュボードや推移の分析で、「特定の案件の今の値」を聞く利用者が少ない
- 質問の大半が複数のシステムをまたぐため、1 つの業務システムのツールではほとんど答えられない
- 読み取り専用レプリカを用意できないなど、業務 DB に Text-to-SQL を向けられない事情がある
この場合も、指標を作り込む前に、利用者が実際に聞きたい質問を集めてから mart を設計するという順序は変わりません。
分析基盤があると Text-to-SQL が良くなる理由
段階 4 で ③ の接続先を mart に移すのには、はっきりした理由があります。
| 観点 | 業務 DB のレプリカ | DWH の mart |
|---|---|---|
| テーブルの意味 | 業務の都合で正規化されていて、列名だけでは意味が分かりにくい | 分析用に結合・整形済みで、dbt の説明が付いている |
| 指標の定義 | ないので、LLM が毎回計算式を推測する | dbt の指標定義があり、それに沿って計算できる |
| PII | 生の値のまま | staging でハッシュ化済み(PKSHA の事例の設計。平文が必要な列は <table>_pii に隔離) |
| 複数 DB・複数システム | 結合しにくい | まとめて持っている |
| 負荷 | 本番の複製に負荷がかかる | DWH で処理する |
特に効くのが、指標の定義です。dbt Labs は 2026 年 4 月にベンチマークを公開しています。セマンティックレイヤーを使った場合と、生のテーブルに Text-to-SQL を当てた場合の正答率を比べたものです。
- 全体の正答率は、セマンティックレイヤーが 72.7%、Text-to-SQL が 64.5% でした
- セマンティックレイヤーの指標で扱える範囲の質問に限ると、セマンティックレイヤーは 100%、Text-to-SQL は 5 割台〜6 割台でした
ただし、この結果には注意が要ります。
- ベンチマークを行ったのは、セマンティックレイヤーの製品を提供している dbt Labs 自身 で、元記事もその点を断っています。質問は 11 問、データセットも 1 つの小規模な評価です。
- セマンティックレイヤーで答えられるのは、定義済みの指標の範囲だけ です。定義していない集計や、複雑な結合が要る質問には答えられません。全体の正答率の差が小さいのはそのためです。
だからこそ、完成形では ② と ③ を両方持ちます。定義済みの指標で答えられる質問は ② で正確に、定義の外にある一度きりの質問は ③ で探索的に答える、という分担です。
改善サイクル:繰り返す質問を業務 API と dbt 指標のどちらに昇格させるか
チャットボットの記事では、Text-to-SQL に何度も回ってくる質問を、開発者が決定論的な API にして ① のツールに昇格させる改善サイクルを紹介しました。分析基盤があると、昇格先がもう 1 つ増えます。
| 繰り返し来る質問の性質 | 昇格先 | 例 |
|---|---|---|
| 特定のレコードの今の値で、帳票と一致する必要がある | 業務システムの API(① のツール) | 「案件ごとの受注・請求・入金の差額」 |
| 多数のレコードをまたぐ集計・推移で、分析用の指標でよい | dbt の指標定義(② のセマンティックレイヤー) | 「事業所別の月次原価率の推移」 |
| どちらにも当てはまらない一度きりの問い合わせ | 昇格させない(③ のまま) | 「起票者と承認者が同じ伝票の抽出」 |
判断の基準は、誰が・どの精度で・どれくらいの鮮度で その数字を必要とするかです。帳票と同じ精度・リアルタイムが必要なら業務システムに、分析用の精度・数十分遅れで足りるなら dbt に置きます。
分析基盤を追加するときの注意:数字の正本・権限・用語を二重にしない
分析基盤を足すと、チャットボットの記事で Text-to-SQL について指摘した問題が、形を変えて戻ってきます。
数字の正本が 2 つになる
業務システムの帳票の数字は、アプリのコードで計算されています。分析基盤で同じ指標を dbt で定義すると、同じ数字の計算が 2 か所に存在する ことになります。締め処理、端数処理、取消・訂正の扱いなどが少しずれれば、チャットの ① と ② で答えが食い違います。
対策は次のとおりです。
- 正式な数字は ① で答える:帳票と同じ数字が必要な質問(「今月の確定原価は?」)は、業務システムのツールで答えます。② の指標は「分析用の数字」と位置づけ、回答にもそう明示します
- dbt の指標と業務システムの値を突き合わせるテストを置く:代表的な案件・月について、業務システムの API が返す値と dbt の mart の値を比べるテストを定期的に回し、ずれを早く見つけます
- 計算ルールの仕様を 1 つにする:コードは 2 つになっても、「何をどう数えるか」の仕様書は 1 つにし、両方がそれを参照します
権限の定義が 2 つになる
① は業務システムの権限で、② は BI 層のユーザー属性で制御します。業務システムで「事業所 X の担当者」になっている人が、BI では事業所 Y のデータも見られる、という状態になれば情報漏えいです。
- BI の属性は業務システムから同期する:PKSHA の事例では、申請・承認・期限付きで BI のユーザー属性を付与していました。業務システムの所属や役割から BI の属性を自動で作り、手で二重に管理しないようにします
- ② の権限を ① より広くしない:分析基盤の都合で、業務システムより広い範囲を見せないことを原則にします。広く見せる役割(経営・監査)は、明示的に決めて付与します
用語の定義が 2 つになる
チャットボットの記事では、業務用語のオントロジーをリポジトリの YAML などで持つことを勧めました(Text-to-SQL に NVIDIA Auto Ontology を使う場合は、その定義も加わります)。分析基盤を作ると、dbt の schema.yml にも指標や列の説明が書かれます。ここも二重にしないのが理想です。
- 分析の指標と列の説明は dbt の
schema.ymlを正にする:Lightdash も AI も、ここを読みます - ツールの説明文(
description)は、同じ用語集を参照して書く:「原価」という言葉が、① のツールと ② の指標で違う意味にならないようにします
まとめ
一言でいえば、チャットボットはそのまま、分析の需要が見えたら DWH の経路を足し、Text-to-SQL もそちらに移す。ただし数字の正本・権限・用語は 1 つに保つ ということです。
- 結論:分析基盤の完成を待たずに、チャットボットから始める。ツール呼び出しは業務システムだけで作れ、最初に価値を出せる
- データ照会チャットボットと分析基盤は、答える質問の種類が違う補完関係。前者は特定のレコードの今の値を、後者は多数のレコードをまたぐ集計・推移を答える
- Text-to-SQL は読み取り専用レプリカで小さく始め、そのログを 分析基盤で何を作るかの要求一覧 として使う
- レプリカが重い、複数システムをまたぐ、過去の時点の値が要る、といった合図が出たら分析基盤を作る。完成後はセマンティックレイヤーの経路を足し、Text-to-SQL の接続先を DWH の mart に移す
- 完成形は「3 つの経路を持つ 1 つの窓口」。経路はアプリが役割で決め、優先順位は 業務照会 → 定型分析 → 探索
- 繰り返し来る質問は、帳票と一致すべきものは業務システムの API に、分析用で足りるものは dbt の指標定義に昇格させる
- 分析基盤を足すときは、数字の正本・権限・用語の定義を二重にしない