はじめに
前回の記事「BigQuery × dbt × Lightdash × MCP で作る AI ネイティブなデータ分析基盤:PKSHA の事例に学ぶ設計」では、PKSHA の事例を紹介しました。AWS の Aurora にあるデータを Google Cloud の BigQuery に運び、dbt・Lightdash・自前の MCP サーバーで「人間と AI が同じ指標定義で分析できる」基盤を作った事例です。
ただ、本番環境が AWS にある会社にとって、分析のためだけに Google Cloud の環境を持つのは負担です。アカウントや権限の管理、ネットワーク、請求、監査が 2 つのクラウドに分かれてしまいます。
この記事では、同じ設計思想を AWS だけで完結させる 構成案を考えます。結論から言うと、元記事の核となる次の 3 つは DWH に依存しないので、そのまま使えます。
- 指標の定義は 1 か所(dbt の
schema.yml)に集める - 権限は BI 層(Lightdash)で制御する
- AI には PII を読ませない
変わるのは取り込みと DWH の部分で、そこに AWS 特有の注意点があります。
なお、これは公開情報をもとにした構成案で、筆者が本番で運用した結果ではありません。採用する前に PoC で費用と挙動を確かめてください。
前提:登場するプロダクトと用語
用語やプロダクトをご存じの方は、次の「推奨構成」まで読み飛ばしてください。
用語
| 用語 | 意味 |
|---|---|
| DWH(データウェアハウス) | 分析用にデータを集めて保管するデータベース。本番 DB と分けることで、重い集計が本番に影響しない |
| CDC(Change Data Capture) | DB の変更(INSERT / UPDATE / DELETE)を差分として拾い、別の場所に反映する方式 |
| スナップショット | ある時点のテーブルを丸ごとコピーする方式。CDC と対になる |
| raw / staging / mart | dbt でよく使う層構成。raw は取り込んだまま、staging は型や名前を整えたもの、mart は分析用に集計・結合したもの |
| セマンティックレイヤー | 「売上」「アクティブユーザー」などの指標の定義を 1 か所にまとめる層 |
| PII(個人識別情報) | 氏名・電話番号・メールアドレスなど、個人を特定できる情報 |
| 決定的ハッシュ | 同じ値からは常に同じ値になるハッシュ。元の値には戻せないが、結合や「同じ人か」の集計には使える |
required_attributes / user_attributes | Lightdash のユーザー属性を使った権限制御。前者はテーブル単位で見せるかどうか、後者は行の絞り込みに使う |
| RPU(Redshift Processing Unit) | Redshift Serverless の計算能力の単位。使った RPU 時間で課金される |
| Iceberg | S3 などに置いたファイル群を、更新や削除ができるテーブルとして扱うためのオープンなテーブル形式 |
| MCP(Model Context Protocol) | AI エージェントが外部のツールやデータにつなぐための共通プロトコル |
| CUR(Cost and Usage Report) | AWS の利用料金の明細データ。S3 に出力して分析できる |
| PoC(概念実証) | 本格導入の前に小さく試し、実現性や費用を確かめること |
元記事(Google Cloud 側)のプロダクト
| プロダクト | 種類 |
|---|---|
| BigQuery | Google Cloud のサーバーレス DWH。オンデマンド課金では、クエリがスキャンしたデータ量で課金される |
| Datastream | Google Cloud の CDC サービス。Aurora の変更を BigQuery に流す |
| Cloud Storage(GCS) | Google Cloud のオブジェクトストレージ |
| GKE Autopilot | Google Cloud のマネージド Kubernetes |
| Policy Tags | BigQuery で列単位にアクセスを制御する仕組み |
AWS のプロダクト
| プロダクト | 種類 | この構成での役割 |
|---|---|---|
| Amazon Aurora | マネージド RDB(MySQL / PostgreSQL 互換) | 分析対象のデータを持つプロダクトの本番 DB |
| Aurora zero-ETL 連携 | Aurora から Redshift へデータを自動で複製し続ける機能 | パイプラインを自作せずに CDC を実現する主経路 |
| Amazon Redshift | AWS の DWH | 分析用データの置き場所 |
| Redshift Serverless / プロビジョンド | Redshift の 2 つの利用形態 | Serverless は使った RPU 時間だけ課金。プロビジョンドはノードを常時起動して契約する従来型 |
| AWS DMS(Database Migration Service) | DB 間のデータ移行・CDC のサービス | 列を落として取り込みたいテーブル用の補助経路 |
| Amazon S3 | オブジェクトストレージ | コストデータなどファイルで受け取るデータの置き場所 |
| Amazon Athena | S3 上のデータを SQL で読むサーバーレスのクエリサービス | 別案(S3 + Athena 構成)の DWH |
| Amazon ECS / AWS Fargate | コンテナの実行基盤(Fargate はサーバー管理が不要な実行方式) | Lightdash・dbt・MCP サーバーを動かす |
| Amazon RDS for PostgreSQL | マネージドの PostgreSQL | Lightdash 自身の設定やユーザー情報を保存する |
| Amazon Bedrock | AWS 上で Claude などの生成 AI モデルを使えるサービス | Slack bot の LLM を AWS の中で呼ぶ場合に使う |
| AWS CloudTrail | AWS の API 操作の記録 | 誰がどのリソースを操作したかの監査 |
| AWS Budgets / Cost Anomaly Detection | 予算アラートと、機械学習による異常な支出の検知 | 費用の急増を早く見つける |
AWS 以外のプロダクト
| プロダクト | 種類 | この構成での役割 |
|---|---|---|
| dbt | SQL でデータ変換を書くツール。DWH ごとにアダプタ(dbt-redshift、dbt-athena など)がある | 生データを分析しやすい形に整え、指標の定義も持つ |
| Lightdash | dbt と連携する BI ツール(コアは OSS) | ダッシュボードと探索画面を提供し、権限も制御する |
| Claude Code | Anthropic の AI コーディングエージェント | 利用者が自然言語で分析を頼むと、Claude Code が MCP サーバーを呼び出す |
推奨構成:Aurora zero-ETL → Redshift
全体像は次の図のとおりです。
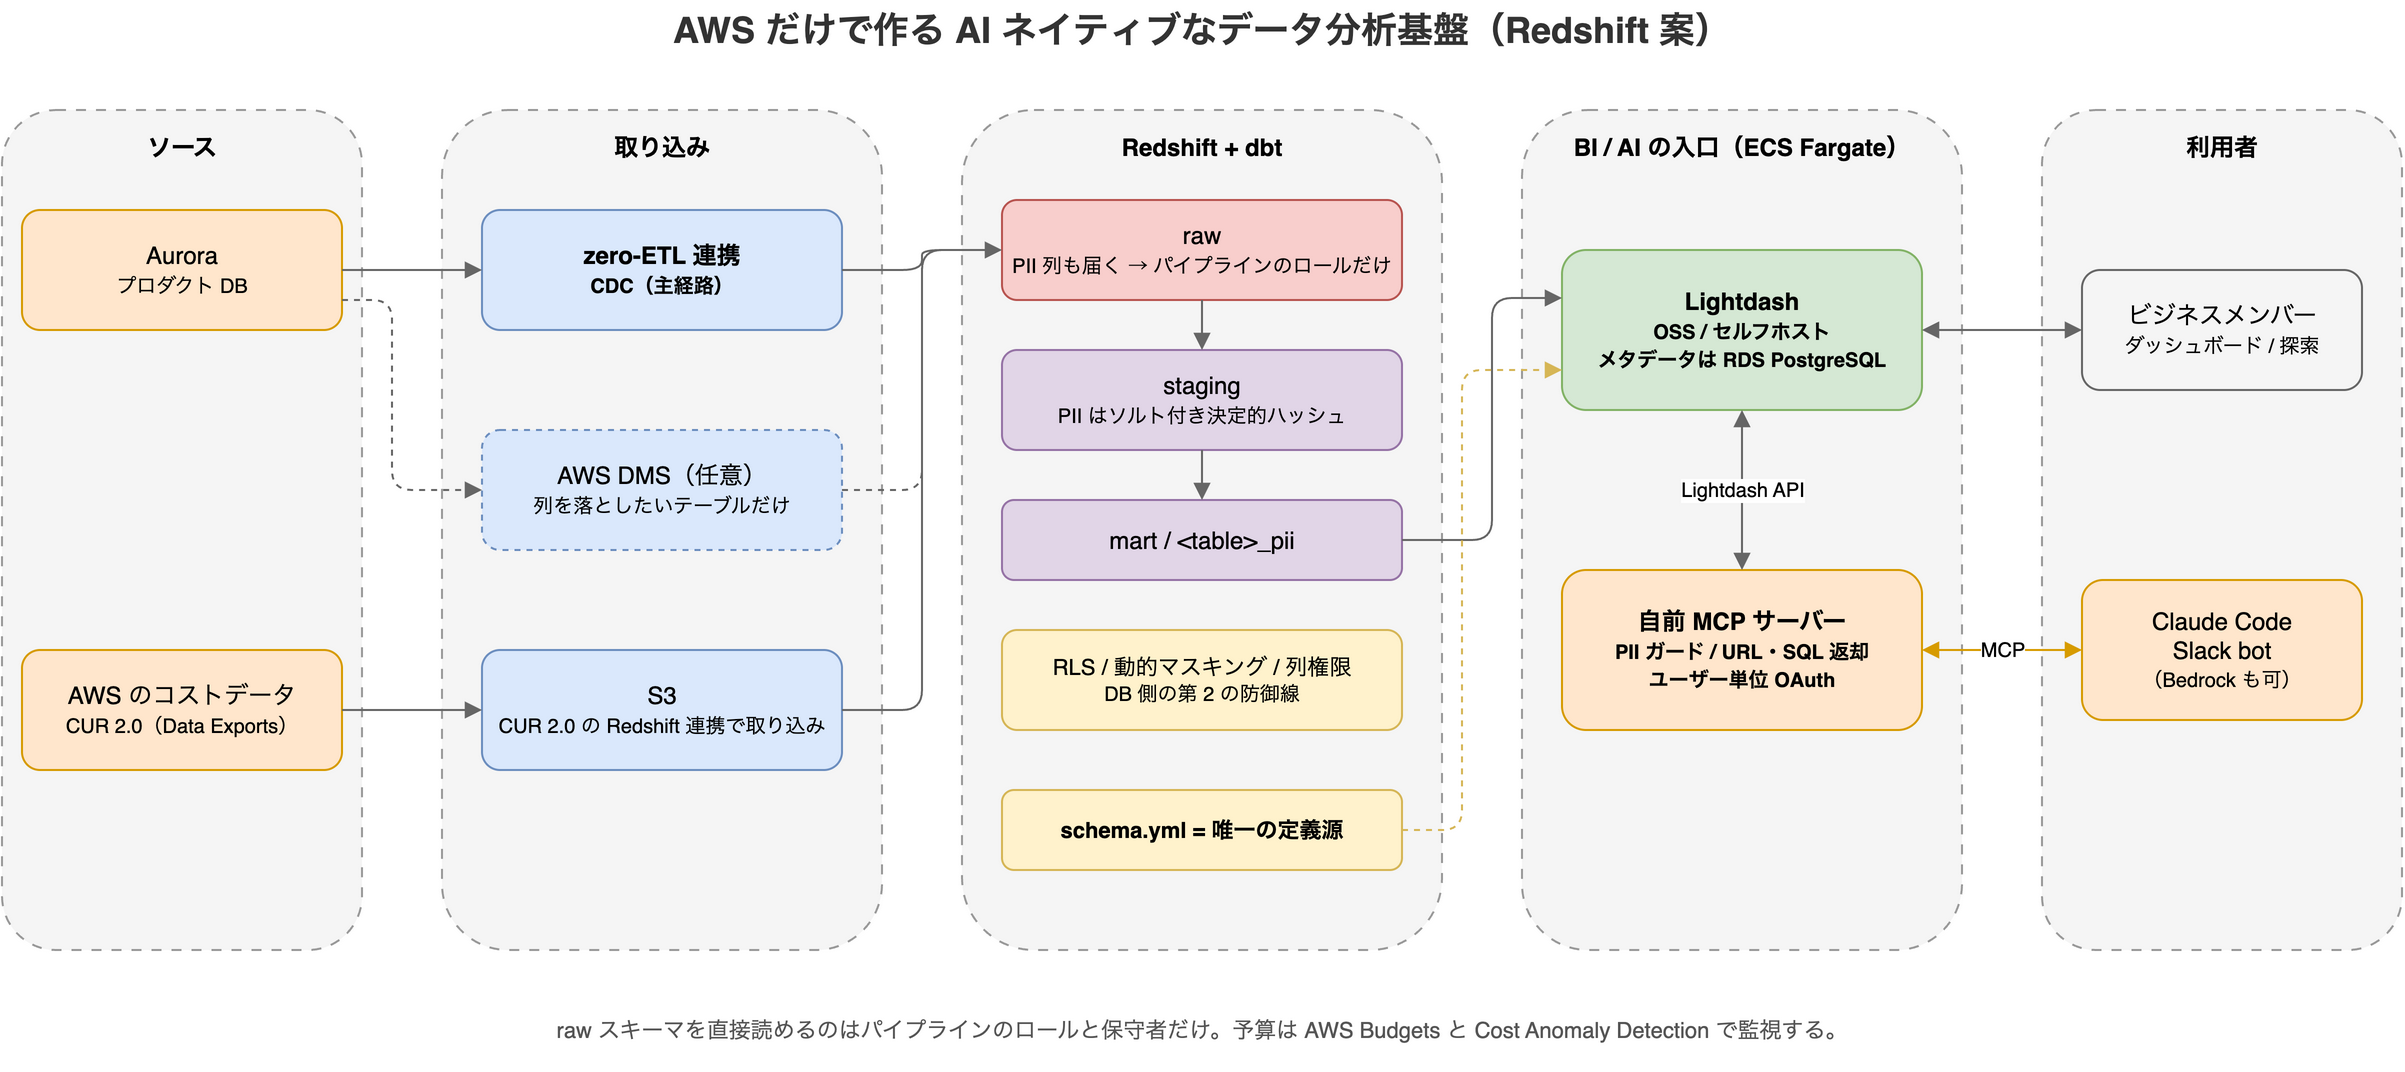
各層を元記事と対応させると、次のようになります。
| 層 | 元記事(Google Cloud) | AWS だけで作る場合 |
|---|---|---|
| CDC の取り込み | Datastream → BigQuery | Aurora zero-ETL 連携 → Redshift |
| CDC から外した列 | Datastream の除外設定で外し、太い列は AWS Glue で別に運ぶ | 必要なテーブルだけ AWS DMS で列を落とす |
| コストデータ | Avro ファイルを GCS に送る | CUR 2.0 を S3 に出力し、Redshift に取り込む |
| DWH | BigQuery | Redshift Serverless(または小さめのプロビジョンド) |
| 変換 | dbt(GKE の CronJob) | dbt-redshift を ECS Fargate のスケジュールタスクで実行 |
| セマンティックレイヤー・BI | Lightdash(GKE) | Lightdash を ECS Fargate で実行。メタデータは RDS for PostgreSQL |
| AI の入口 | 自前の MCP サーバー | 同じもの(ECS で実行)。Slack bot の LLM は Bedrock でも呼べる |
| 監査 | INFORMATION_SCHEMA.JOBS | Redshift のクエリ履歴(SYS_QUERY_HISTORY)と CloudTrail |
| 費用の監視 | Cloud Billing の予算アラート | AWS Budgets と Cost Anomaly Detection |
| IaC・実行基盤 | Terraform + GKE Autopilot | Terraform + ECS Fargate |
Redshift を推す理由は、取り込みを自作しなくてよい ことです。元記事の筆者は 1 人で約 1 か月で基盤を立ち上げました。そのスピードを AWS で再現するなら、Aurora の変更を Redshift に流し続ける zero-ETL 連携が、Datastream にいちばん近い役割を果たします。Lightdash も Redshift への接続に公式に対応しています。
コストデータは、CUR 2.0 の Data Exports で S3 に出力します。CUR 2.0 には Redshift と連携するための出力形式とセットアップ用スクリプトが用意されているので、それを使って Redshift に取り込むのが手軽です。
元の GCP 構成とのプロダクト比較
上の表は層ごとの対応でした。ここではプロダクト単位で、元記事の構成(Aurora 以外は Google Cloud が中心)と AWS だけの構成を並べます。「クラウド」列で、どちらのクラウドで動くかを示しています。
| 役割 | 元の構成 | クラウド | AWS だけの構成 | 変わる点 |
|---|---|---|---|---|
| 本番 DB(ソース) | Amazon Aurora | AWS | Amazon Aurora | 変わらない |
| CDC の取り込み | Datastream | GCP | Aurora zero-ETL 連携 | 列単位の除外ができない。取り込み自体の追加料金はない |
| CDC から外した太い列の転送 | AWS Glue(→ BigQuery、毎時) | AWS → GCP | 原則不要(zero-ETL はテーブル単位で丸ごと運ぶ) | 列単位で外せないので、別経路で運ぶ必要もなくなる。逆に費用を見ながら運ぶ列を選ぶことはできない |
| PII 列を落とした取り込み | Datastream の除外設定 | GCP | AWS DMS(必要なテーブルだけ) | 列を落とす用途は DMS の変換ルール(remove-column)で担う |
| ファイルの受け口 | Cloud Storage(GCS) | GCP | Amazon S3 | クラウドをまたぐ転送がなくなる |
| コストデータ | AWS のコストデータを Avro で GCS に送る | AWS → GCP | CUR 2.0(Data Exports)を S3 に出力 | Redshift 連携用の出力形式とスクリプトが公式にある |
| DWH | BigQuery | GCP | Redshift Serverless / プロビジョンド | 課金がスキャン量から計算時間(RPU 時間)に変わる |
| データ変換 | dbt(dbt-bigquery) | GCP | dbt(dbt-redshift) | SQL の方言の書き換えが要る |
| BI・セマンティックレイヤー | Lightdash(セルフホスト) | GCP | Lightdash(セルフホスト) | 変わらない。接続先を Redshift にする |
| AI の入口 | 自前の MCP サーバー | GCP | 自前の MCP サーバー | 変わらない |
| AI クライアント | Claude Code / Slack bot | — | Claude Code / Slack bot(LLM は Bedrock も可) | AWS の中で LLM を呼ぶ選択肢が増える |
| コンテナの実行基盤 | GKE Autopilot | GCP | ECS Fargate | Kubernetes を使わない構成になる |
| 列単位のアクセス制御 | Policy Tags(不採用) | GCP | Redshift の RLS・動的データマスキング・列権限 | SQL で宣言でき、DB 側の防御線として使いやすい |
| クエリの監査 | INFORMATION_SCHEMA.JOBS | GCP | SYS_QUERY_HISTORY + CloudTrail | 全員分を見るには sys:monitor ロールが要る |
| 費用の監視 | Cloud Billing の予算アラート | GCP | AWS Budgets + Cost Anomaly Detection | 異常検知を足せる |
| IaC | Terraform | — | Terraform | 変わらない。定義する実行基盤が GKE から ECS に変わる |
元の構成では、データが AWS(Aurora)から GCP へ渡り、Glue のように両方のクラウドにまたがる部品もありました。AWS だけの構成では、すべてが 1 つのクラウドに収まります。その代わり、取り込み(zero-ETL 連携)と DWH(Redshift)の性質が変わるので、後の「AWS で変えるべき 3 つのポイント」で説明する注意点が生まれます。
BigQuery 版からそのまま持ち込める設計
元記事の設計のうち、DWH に依存しない部分は変える必要がありません。
- 定義は 1 か所:指標の定義は dbt の
schema.ymlだけに書き、Lightdash も AI もそこを見る - BI 層での権限制御:dbt の meta に
required_attributesを宣言してテーブルを分離し、user_attributesで行を絞る - PII の扱い:staging でソルト付きの決定的ハッシュをかけ、平文が必要な列は
<table>_piiに隔離する - CI での強制:
*_piiの命名、data_class: piiラベル、required_attributesの宣言を CI で検査する - MCP サーバー:
*_piiを参照するクエリには行の値を返さず、件数・チャートの URL・SQL だけを返す。URL と SQL はツール側で生成し、LLM には作らせない - 期限付きの権限付与:申請・承認・自動失効で
user_attributesを付与する
dbt の SQL は BigQuery と Redshift で方言が違うので、ハッシュ関数などは書き換えが要ります。ただし、どこに何を書くかという設計は同じです。
AWS で変えるべき 3 つのポイント
1. zero-ETL 連携では PII 列をソース側で落とせない
元記事では、PII が混ざる列をソース側(Datastream)で除外して、そもそも BigQuery に入れていませんでした。
一方、Aurora zero-ETL 連携のデータフィルタは データベース単位・テーブル単位 で、取り込む・取り込まないを指定する仕組みです。公式ドキュメントには、列単位・行単位のフィルタには対応していないと明記されています。そのため、テーブルを取り込むと PII 列も Redshift の raw 層まで届きます。
対策は 2 つあります。
raw スキーマを閉じる:raw スキーマを読めるのは、dbt を実行するロールと保守担当者だけにします。Lightdash の接続ユーザーには、staging より上のスキーマだけを許可します。元記事の「BigQuery を直接読めるのはパイプラインと保守者だけ」と同じ考え方を、スキーマの権限で実現します。
-- Lightdash の接続ユーザーからは raw を見えなくする
REVOKE ALL ON SCHEMA raw FROM lightdash_user;

-- staging と mart だけ読めるようにする
GRANT USAGE ON SCHEMA staging, mart TO lightdash_user;
GRANT SELECT ON ALL TABLES IN SCHEMA staging, mart TO lightdash_user;
REVOKE は、そのユーザーに直接付与した権限しか取り消しません。PUBLIC(全ユーザー)に付与した権限が残っていると raw は閉じられないので、raw スキーマには最初から PUBLIC に権限を付けないようにします。
列を落とす必要があるテーブルだけ DMS を使う:AWS DMS は、テーブルマッピングの変換ルール(remove-column)で列を除外できます。PII の列があり、そもそも分析環境に複製したくないテーブルだけを DMS に回します。
{
  "rules": [
    {
      "rule-type": "selection",
      "rule-id": "1",
      "rule-name": "include-contacts",
      "object-locator": { "schema-name": "app", "table-name": "contacts" },
      "rule-action": "include"
    },
    {
      "rule-type": "transformation",
      "rule-id": "2",
      "rule-name": "drop-phone",
      "rule-target": "column",
      "object-locator": {
        "schema-name": "app",
        "table-name": "contacts",
        "column-name": "phone_number"
      },
      "rule-action": "remove-column"
    }
  ]
}
DMS を補助経路にする場合は、タスクが止まっても気づける監視を最初から用意しておきます。
2. Redshift Serverless の費用は「止まらない計算」に注意
元記事の最大の失敗は、BigQuery の CDC が変更を適用するたびにテーブル全体を読み、1 日約 330 USD かかったことでした。AWS にも、形を変えた落とし穴があります。
- zero-ETL 連携そのものは追加料金なし です。ただし、複製されたデータを処理する Redshift の計算資源とストレージ、初回の取り込み、Aurora 側の I/O、AZ 間のデータ転送などは課金されます。
- Redshift Serverless は、クエリが動いていない間は計算の課金が止まるのが利点です。しかし CDC で変更が絶えず流れ込むと、計算資源が動き続けて アイドルにならない おそれがあります。
- 公式ドキュメントは、zero-ETL と組み合わせる場合の費用対策として、変更を反映する間隔(
REFRESH_INTERVAL)を延ばすことや、利用できる環境では基本容量を小さめ(8 RPU)にすることを挙げています。 - 変更が常に流れる用途では、小さめのプロビジョンドクラスターをリザーブドインスタンス(1 年または 3 年の契約割引)で契約したほうが、Serverless より安くなる場合があります。
どちらが安いかはテーブル数と更新頻度で決まるので、PoC で 1〜2 週間ほど RPU 時間を計測してから決めるのが安全です。元記事と同じく、AWS Budgets のアラートは全体・Redshift・DMS などの単位で最初から設定しておきます。
3. Aurora スナップショットの S3 エクスポートは AWS でも高い
元記事が日次スナップショットをやめた理由は、Aurora のスナップショットを S3 にエクスポートすると スナップショット全体のサイズ で課金されるからでした。これは AWS の中で完結させても変わりません。エクスポートの対象を特定のテーブルに絞っても、課金はスナップショット全体のサイズに対してかかります。
「とりあえず日次で S3 にスナップショットを出して Athena で読む」という案は手軽に見えますが、費用の面では避けたほうがよい選択です。
補足:Redshift の RLS と動的データマスキングで二重に防ぐ
元記事は、列単位で制御する BigQuery の Policy Tags を「運用が重すぎる」として採用しませんでした。Redshift では、行レベルセキュリティ(RLS)、動的データマスキング、列単位の権限付与を SQL で宣言できます。
Lightdash の権限制御を主とし、<table>_pii などの重要なテーブルだけに Redshift の RLS やマスキングを重ねておけば、BI 層の設定ミスがあっても DB 側で止められます。
監査に使う SYS_QUERY_HISTORY は、スーパーユーザー以外には自分のクエリしか見えません。「誰がどの PII テーブルを読んだか」を全員分たどるには、監査用のロールに sys:monitor ロールを付与します(またはユーザーに SYSLOG ACCESS UNRESTRICTED を設定します)。
別案:S3(Iceberg)+ Athena
固定費をさらに抑えたい場合は、DWH を持たない構成も考えられます。
- 取り込み:AWS DMS で Aurora の CDC を S3 に出力し、Iceberg テーブルにマージする
- DWH:Athena でクエリする(スキャンしたデータ量で課金)
- 変換:dbt-athena
- BI:Lightdash(Athena への接続に公式に対応)
| 観点 | Redshift 案 | S3 + Athena 案 |
|---|---|---|
| 取り込みの手間 | zero-ETL 連携で設定だけ | CDC を Iceberg にマージする処理を自作・運用する |
| 誰も使わないときの費用 | Serverless はアイドルなら計算課金なし(CDC で止まらないおそれ)。プロビジョンドは常時課金 | ほぼ S3 の保管料だけ |
| 費用の落とし穴 | CDC で計算資源が止まらない | 小さなファイルが増えると、スキャン量と処理時間が増える |
| 向いている場面 | 1 人で早く立ち上げたい、鮮度が要る | 更新頻度が低い、クエリ回数が少ない |
元記事のように「少人数で、1 か月程度で立ち上げる」ことを優先するなら Redshift 案、データの鮮度要件が緩く、クエリの回数も少ないなら Athena 案が候補になります。
導入の進め方(PoC から本番まで)
- PoC(1〜2 週間):主要なテーブルだけを zero-ETL で Redshift に複製し、RPU 時間と鮮度を計測する
- dbt の土台づくり:raw → staging → mart の層と、PII のハッシュ化、
*_piiの命名規則、CI の lint を先に作る - Lightdash の公開:
schema.ymlに指標を定義し、required_attributesとuser_attributesで権限を設定してから、ビジネスメンバーに公開する - MCP サーバーの追加:PII ガードと URL・SQL の返却を備えた MCP サーバーを立て、Claude Code や Slack bot から使えるようにする
- 費用の見直し:1 か月運用した RPU 時間をもとに、Serverless を続けるかプロビジョンドに移るかを決める
まとめ
元記事の基盤が AI ネイティブと呼べる理由は、BigQuery を使ったことではありません。指標の定義・権限・PII の扱いを、人間にも AI にも同じ規則で効くように整理した ことです。その部分は AWS だけでもそのまま実現できます。
AWS に置き換えるときに設計を見直すのは次の 3 点です。
- zero-ETL 連携では PII 列をソース側で落とせないので、raw スキーマを閉じるか、DMS を併用する
- Redshift Serverless は CDC で計算が止まらないおそれがあるので、PoC で費用を測ってから形態を決める
- Aurora スナップショットの S3 エクスポートはスナップショット全体のサイズで課金されるので、日次の全量コピーには使わない
マルチクラウドの運用負担を避けたいチームは、この構成案を出発点に PoC を始めてみてください。
関連記事
- データ照会チャットボットはデータ分析基盤を作ってから?ツール呼び出し・Text-to-SQL・セマンティックレイヤーの関係と進め方:業務システムのデータ照会チャットボットと、この構成のような分析基盤をどう組み合わせ、どの順番で作るか