はじめに
業務システムを機能ごとに分けた結果、受注・在庫・請求といった業務ごとに API サーバーが別々に立ち、React の SPA がそれらを横断して呼び出すという構成はよく見かけます。各 API は ECS(一部は EC2)で動き、それぞれ自分のデータベースを持っています。
最初のうちはこれで回ります。ところが業務が増えるにつれて、次の 2 つの問題が目立ってきます。
- 複数の API をまたぐ更新の作法が決まっていない。 「受注を登録して、在庫を引き当てて、請求を作る」という一連の処理を、画面ごと・担当者ごとに違うやり方で書いている。途中で失敗したときの後始末も画面によって違う。
- 帳票が遅い。 常駐している Celery のワーカーで帳票を作ると、同時リクエストが重なったときにメモリが足りなくなり、タスクが落ちる。それを避けるために、帳票ごとに ECS タスクを別に起動している。ところが今度はその起動に時間がかかり、利用者を待たせてしまう。CSV や Excel の一括ファイル取り込みも、同じ構造の重い処理である。
利用者からの要望は「帳票をもっと速く出してほしい」です。よくある答えは「サーバー側に仕組みを足す」ことです。ワーカーを大きくし、ジョブキューと常駐ワーカーの数を増やします。業務をまたぐ処理にはオーケストレーター(AWS Step Functions など)を置きます。これは正攻法ですが、同時リクエストのピークに合わせてサーバーを用意し続けることになります。
この記事では逆の方向を検討します。利用者の PC で動くデスクトップアプリに、帳票の生成と Saga の調整を寄せる方向です。サーバーは「データを返し、整合性を検査する」だけの薄い層に保ちます。デスクトップアプリにはもう一つ、利用者の PC で動く AI エージェントに業務を手伝わせる土台になるという利点もあります。方針は次の 4 つです。
- 方針 1: 帳票はクライアントで生成する。 サーバーはデータとテンプレートを返すだけにする。サーバーに送って突合・保管するのは、保存が必要な正式な帳票だけ。1 日に何度も出す確認用の帳票は、PC で作って表示するだけで終わる。メモリ不足も起動待ちも、サーバーから消える
- 方針 2: Saga の司令塔をデスクトップアプリに置く。 そのかわりサーバーには、クライアントが途中で消えても壊れない約束事(冪等キー・補償 API・有効期限つきの仮状態)を持たせる。一括ファイル取り込みも、PC で解析・検証してから Saga で送れば、進捗を表示しながら安全に取り込める
- 方針 3: 入口(BFF)もデスクトップアプリに組み込む。 トークンの保管・振り分け・読み取りの集約をアプリのネイティブ側が担い、サーバー側の BFF を不要にする。ブラウザから使う画面が残る場合だけ、CloudFront と BFF を置く
- 方針 4: AI エージェントにはツールを渡し、鍵は渡さない。 アプリが業務の操作を MCP のツールとして公開し、利用者の PC の AI エージェントがそれを組み合わせて複雑な処理をこなす。クレデンシャルはアプリの中に閉じ込めたままにする。確認のために帳票を出していた業務はエージェントに聞けば済むので、帳票を出す回数も減る。ソースを読ませれば、ヘルプやマニュアルの保守を、ソースと設計文書の保守に置き換えられる
方針 1 と 2 はつながっています。帳票のためにデスクトップアプリを配るなら、業務をまたぐ更新の調整役もそこに置けます。サーバーにオーケストレーターを新しく立てずに、問題 1 の「作法がばらばら」を 1 つの Saga ランナーに揃えられるわけです。既存の React の画面は、デスクトップアプリ基盤(Tauri など)の WebView でそのまま動かせます。帳票と Saga の部分だけをネイティブ側に足せばよく、利用者が社内に限られる業務システムなら配布のハードルも高くありません。方針 3 は、そうして置いたアプリに API の入口もまとめるものです。方針 4 は、アプリに閉じ込めた鍵を前提に、AI エージェントに業務を任せるものです。
「ブラウザで動く SPA に司令塔を任せてよい」という話ではない点に注意してください。後で詳しく書きますが、ブラウザのタブと、ローカルに状態を保存できるデスクトップアプリとでは、中断への強さがまったく違います。
用語とプロダクト
| 用語 / プロダクト | この記事での意味 |
|---|---|
| Saga | 複数サービスにまたがる処理を、ローカルなトランザクションの列と「失敗時に打ち消す補償トランザクション」で組み立てるパターン |
| オーケストレーション型 | Saga の実装方式の 1 つ。司令塔が各サービスを順に呼び、失敗したら補償を指示する |
| 結果整合性(Eventual Consistency) | 途中で一時的な不整合が見えても、最終的には整合した状態に落ち着くこと |
| 補償トランザクション | 完了済みのステップを業務的に取り消す処理(引当解除、受注取消など) |
| 冪等キー(Idempotency Key) | 同じリクエストを何度送っても 1 回分しか効果が出ないようにするための、クライアントが付ける一意な値 |
| 有効期限つきの仮状態 | 「仮登録」「仮引当」に期限を持たせ、確定されないまま期限が切れたらサーバーが自動で解放する仕組み |
| 決定論的なレンダラ | 同じ入力からは、OS や環境によらず同じ出力(PDF)を作る生成エンジン |
| Tauri | Rust 製のデスクトップアプリ基盤。画面は OS の WebView で描き、ネイティブ処理を Rust で書く |
| WebView | アプリの中に埋め込むブラウザエンジン。macOS では WKWebView、Windows では WebView2 |
| BFF(Backend for Frontend) | 特定のフロントエンド専用に置く薄いサーバー。認証の終端や読み取りの集約を担う |
| MCP(Model Context Protocol) | AI エージェントが外部のツールやデータを呼び出すための標準プロトコル。アプリが MCP サーバーになり、エージェントが MCP クライアントとして呼ぶ |
| Celery | Python の非同期タスクキュー。常駐するワーカーがキューからタスクを取り出して実行する |
| Amazon ECS / AWS Fargate | コンテナの実行基盤。常駐する「サービス」と、1 回だけ動かす「タスク」がある |
| AWS Step Functions | AWS のワークフローサービス。サーバー側に Saga の司令塔を置くときの代表的な選択肢 |
| Amazon SQS | AWS のメッセージキュー。失敗したメッセージを隔離するデッドレターキュー(DLQ)を持てる |
帳票が遅い理由: Celery のメモリ不足と ECS タスクの起動待ち
最初に、帳票が遅くなる仕組みを整理しておきます。手を打つ前に、今の遅さを分解して測っておくことをおすすめします。キューでの待ち時間、タスクの起動時間、帳票の生成時間、生成中のメモリのピークに分けると、どこを削れば速くなるかが分かります。
常駐ワーカーで作るとメモリが足りなくなる
Celery のような常駐ワーカーで帳票を作る構成では、1 つのコンテナのメモリ上限を、同時に走るタスクで分け合います。PDF の生成は、元データ・テンプレート・フォント・組版の途中結果をメモリに抱えるので、1 件あたりのメモリ消費が大きい処理です。同時に何件も走ると合計がワーカーの上限を超え、コンテナごと落ちます。落ちると、同じワーカーで処理していた他の帳票も巻き込まれます。
帳票ごとにタスクを起動すると待たされる
そこで帳票ごとに ECS タスクを起動して隔離すると、メモリ不足は起きにくくなります。ところが今度は、タスクの起動そのものに時間がかかります。コンテナイメージの取得、コンテナの起動、アプリの初期化が、帳票を 1 件作るたびに利用者の待ち時間に乗ります。帳票の生成自体が数秒で終わるものでも、起動の分だけ待たされます。
つまり、サーバー側だけで解こうとすると次の板挟みになります。
| 方式 | メモリ不足 | 待ち時間 |
|---|---|---|
| 常駐ワーカーで作る | 起きる(同時リクエストが重なると落ちる) | 短い |
| 帳票ごとにタスクを起動する | 起きにくい | 長い(起動待ちが毎回乗る) |
| 常駐ワーカーを大きく・多くする | ピーク時の同時数まで用意すれば起きない | 短い |
3 行目なら両方とも解決しますが、月末のような一番混む時間に合わせてサーバーを用意し続けることになります。それ以外の時間は、用意したメモリの大部分が使われません。しかもこれは、処理能力の天井をピークの高さまで押し上げるだけです。利用者や帳票が増えれば、また同じ板挟みに戻ります。
サーバー側でできる応急処置
板挟みを和らげる手段は、サーバー側にもあります。クライアントへの移行を待つ間の応急処置として有効です。
- 同時実行数を絞る: Celery の
worker_concurrencyを、1 件あたりのメモリから逆算した数に下げる。worker_prefetch_multiplier = 1にして、ワーカーが帳票を先取りしすぎないようにする - ワーカーのプロセスを定期的に作り直す:
worker_max_tasks_per_childやworker_max_memory_per_childで、一定件数またはメモリ量を超えたプロセスを入れ替え、メモリの溜め込みを防ぐ - 帳票専用のキューとワーカーに分ける: 帳票を他の非同期処理と同じワーカーで処理しない。帳票用のワーカーだけ、メモリの大きいタスクサイズにする
- 起動を速くする: 帳票用のコンテナイメージを小さくする。Fargate なら SOCI(Seekable OCI)のインデックスを付けて、イメージを遅延読み込みさせる方法もある
ただし、どれも「サーバー側の帳票の処理能力」という天井は動かせません。同時リクエストが増えれば、待ち行列か起動待ちのどちらかで、また待たされます。
クライアントで作れば板挟みが消える
一方、利用者の PC は複数コアの CPU と数 GB 以上のメモリを持ち、多くの時間は手が空いています。帳票を PC で作れば、次のようになります。
- メモリ不足がサーバーから消える。 帳票を組み立てるメモリは、各利用者の PC が出す。同時に 10 人が発行しても、サーバー側の 1 つのワーカーに 10 件が集中することはない
- 起動待ちが消える。 アプリはすでに起動しているので、帳票を作るためにコンテナを起こす必要がない
- 並列に作れる。 100 件の請求書でも、PC の複数コアで並列に組み立てられる。サーバーの 1 つのワーカーで順に作るより速く終わることも珍しくない
- 利用者が増えれば、計算資源も増える。 処理能力の天井が、サーバーのサイズではなく利用者の数で決まる。ここが、サーバーを増強する案との一番の違い
新しくかかるのは、出来上がった PDF をアップロードする時間です。ただし、アップロードするのは保存が必要な正式な帳票だけで、1 日に何度も出す確認用の帳票は送りません(詳しくは方針 1 で)。送る場合も、組み上がった PDF を送るだけなので、組版のようにサーバーのメモリを食うことはありません。生成しながら 1 件ずつ送れば、生成とアップロードが重なり、最後にまとめて待たされることもありません。
サーバーに残るのは、データとテンプレートを返すことと、正式な帳票だけを突合して保管することです。どちらもメモリをほとんど使いません。副次的な効果として、帳票用のワーカーやタスクを外せば、業務 API のタスクも小さくできます。
目標アーキテクチャの全体像
ここまでを踏まえて、この記事で目指す構成を図にすると次のようになります。左の利用者の PC 側に調整(Saga ランナー)と計算(帳票レンダラ)と入口(アプリ内 BFF としての API クライアント)があり、右のサーバー側はネットワークの入口(ALB)と業務 API と保管だけです。アプリの中の MCP サーバーは、同じ PC の AI エージェントに業務の操作をツールとして公開します(方針 4)。
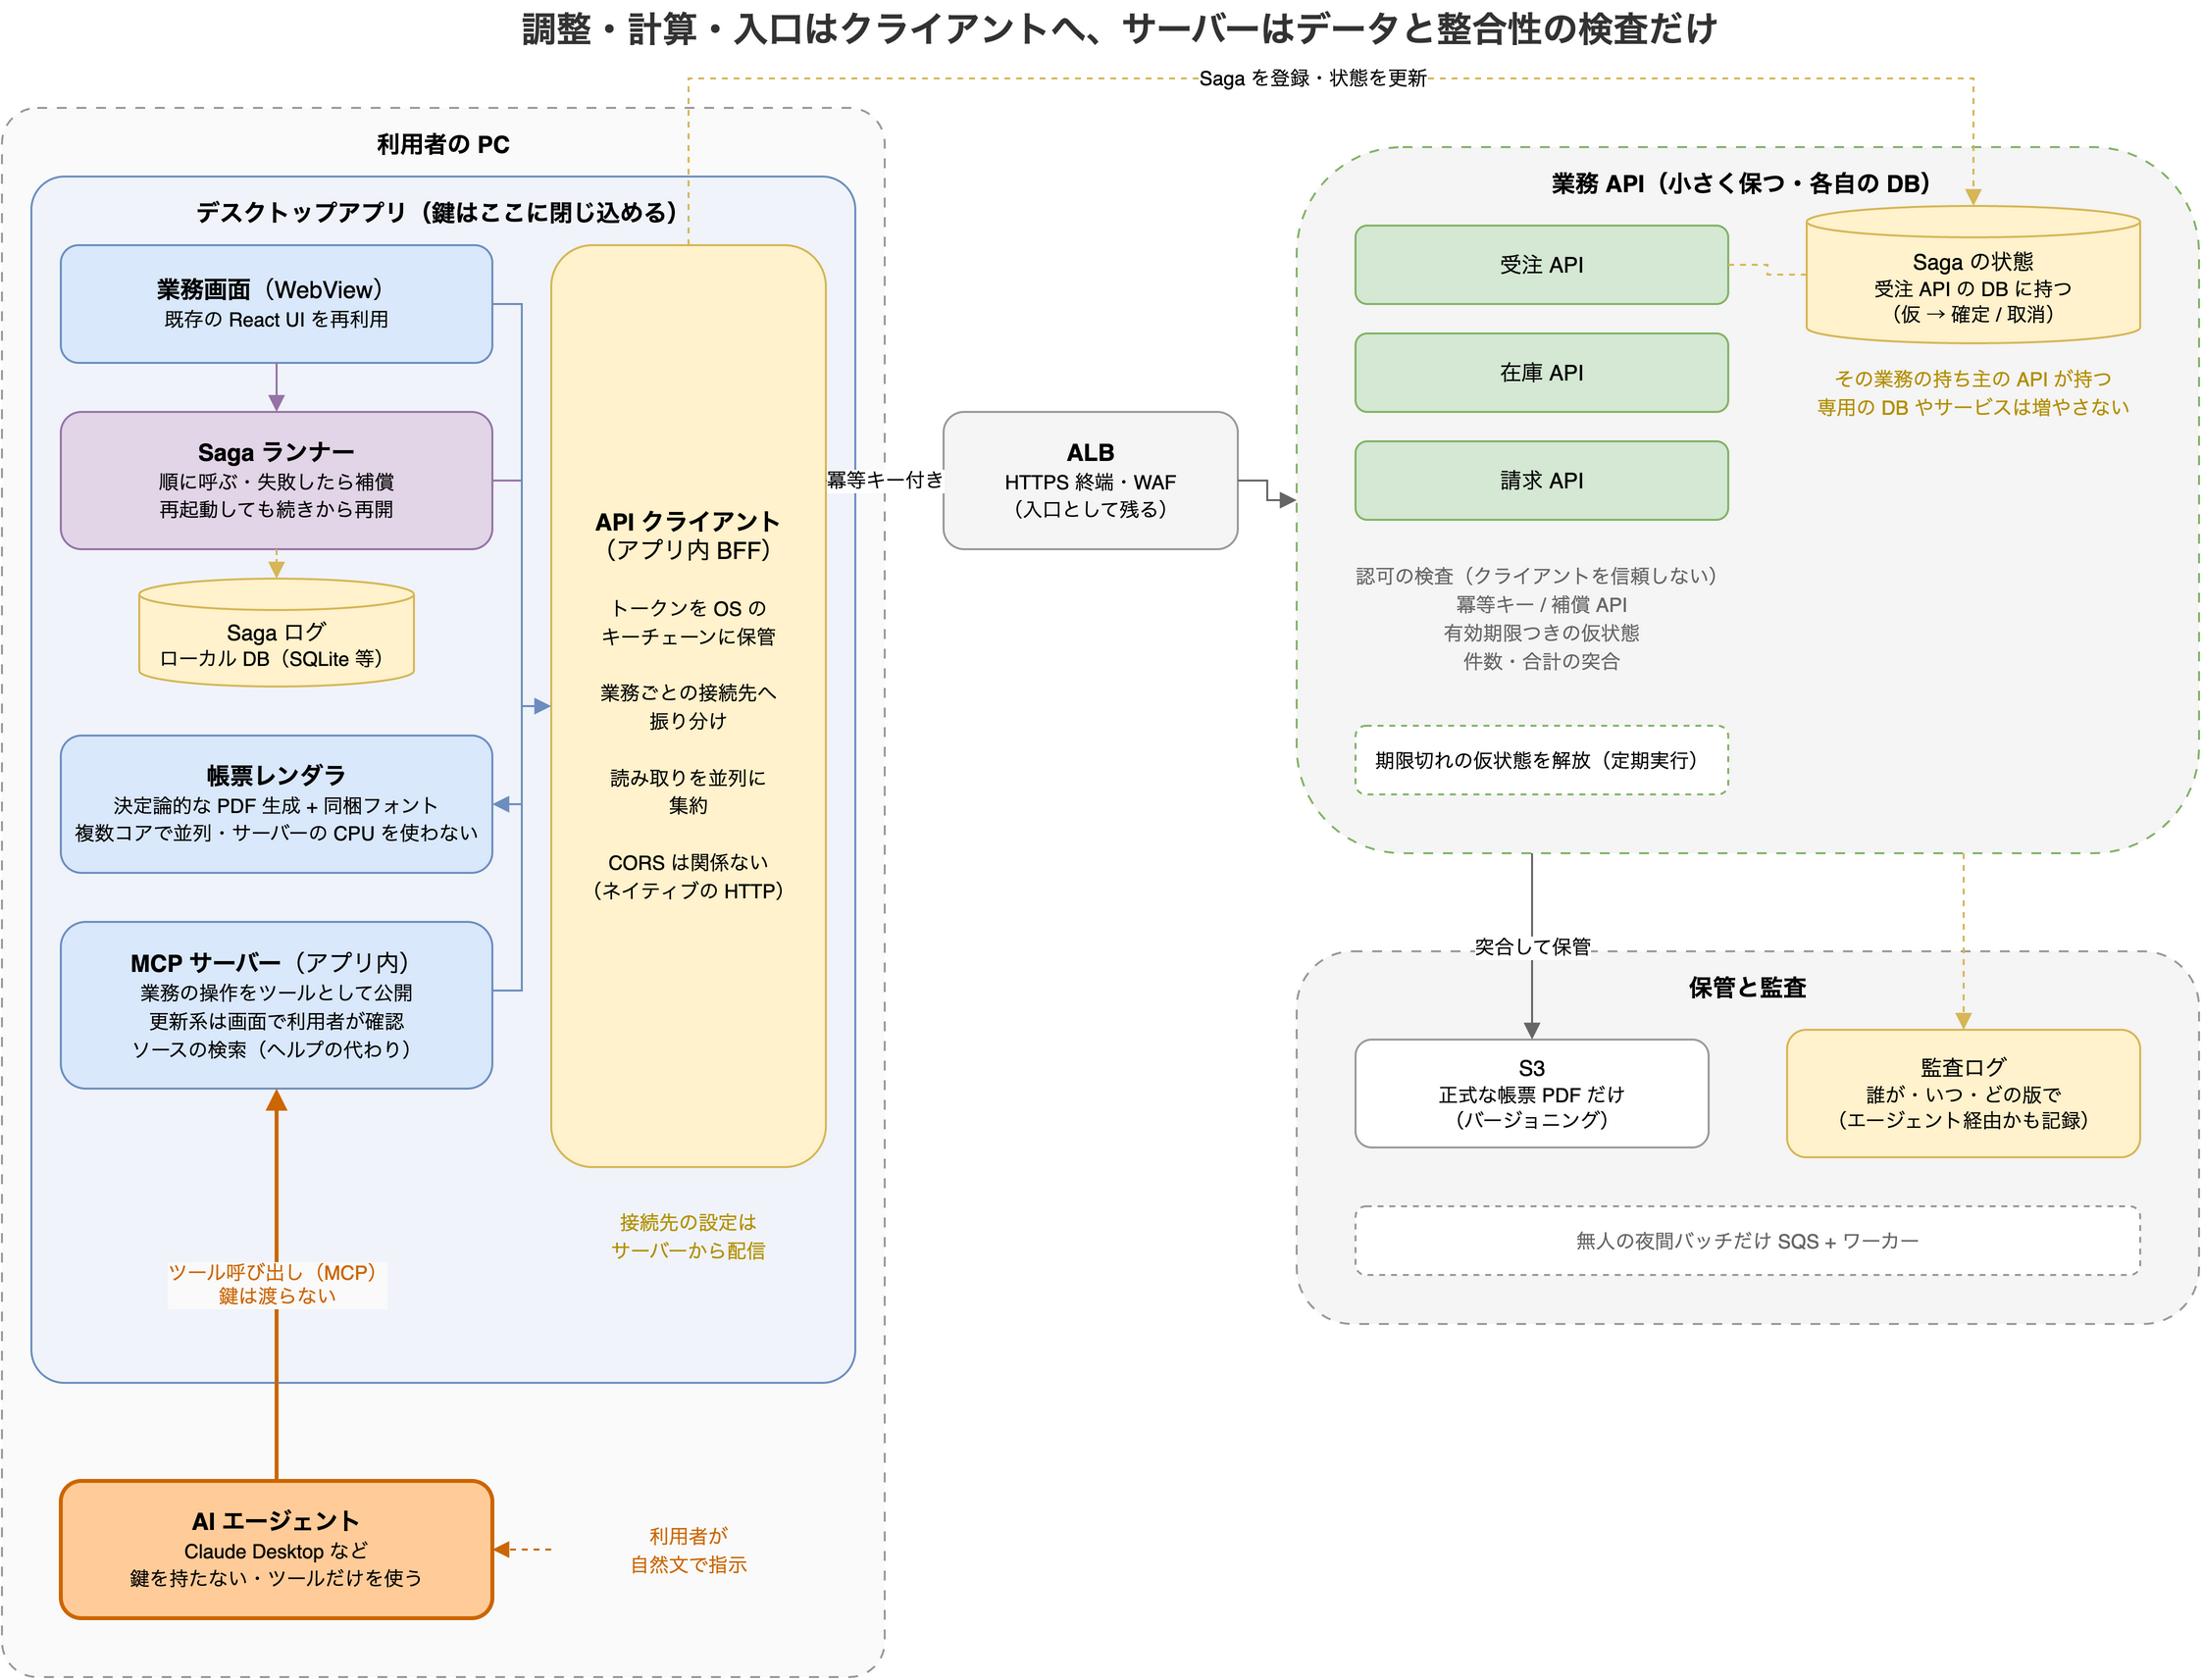
役割ごとに見ると、次のように分かれます。
| 層 | 役割 | やらないこと |
|---|---|---|
| デスクトップアプリ | 画面、Saga の調整と再開、帳票の生成 | 数字を自前で作ること(入力は必ず API から取る) |
| アプリ内の API クライアント | トークンの保管、業務ごとの接続先への振り分け、読み取りの集約(従来の BFF の役割) | 権限の判断(認可は業務 API が行う) |
| アプリ内の MCP サーバー | 業務単位のツールの公開、更新前の確認画面 | トークンをエージェントに渡すこと |
| AI エージェント | 指示の解釈と、ツールの組み合わせ | 鍵を持つこと、更新を自分で承認すること |
| ALB | HTTPS の終端、WAF などネットワークの入口 | 業務ロジック、リクエストの組み替え |
| 業務 API | 自分の業務データの整合性、冪等性、補償、期限切れの解放、帳票の突合 | 長時間の処理、他業務の DB を直接触ること |
| 保管と監査 | 正式な帳票の保管、誰がいつ作ったかの記録 | 帳票の生成、確認用の帳票の保管 |
方針 1: 帳票はクライアントで生成する
サーバーは「データ」と「テンプレート」を返すだけ
帳票をクライアントで作る場合、サーバーの役割は次のようになります。
- 帳票の元データを参照 API で返す
- 帳票のテンプレートを(版番号つきで)返す
- 保存が必要な正式な帳票だけ、出来上がったものを受け取り、突合して保管する
PDF を組み立てる CPU 処理は、すべて利用者の PC で行います。
保存する帳票と、確認用の帳票を分ける
帳票には 2 種類あります。請求書のように保存が必要な正式な帳票と、残高や進み具合を確かめるために1 日に何度も出す確認用の帳票です。数で言えば、確認用のほうがずっと多いのが普通です。
| 種類 | 例 | 生成 | サーバーに送るか |
|---|---|---|---|
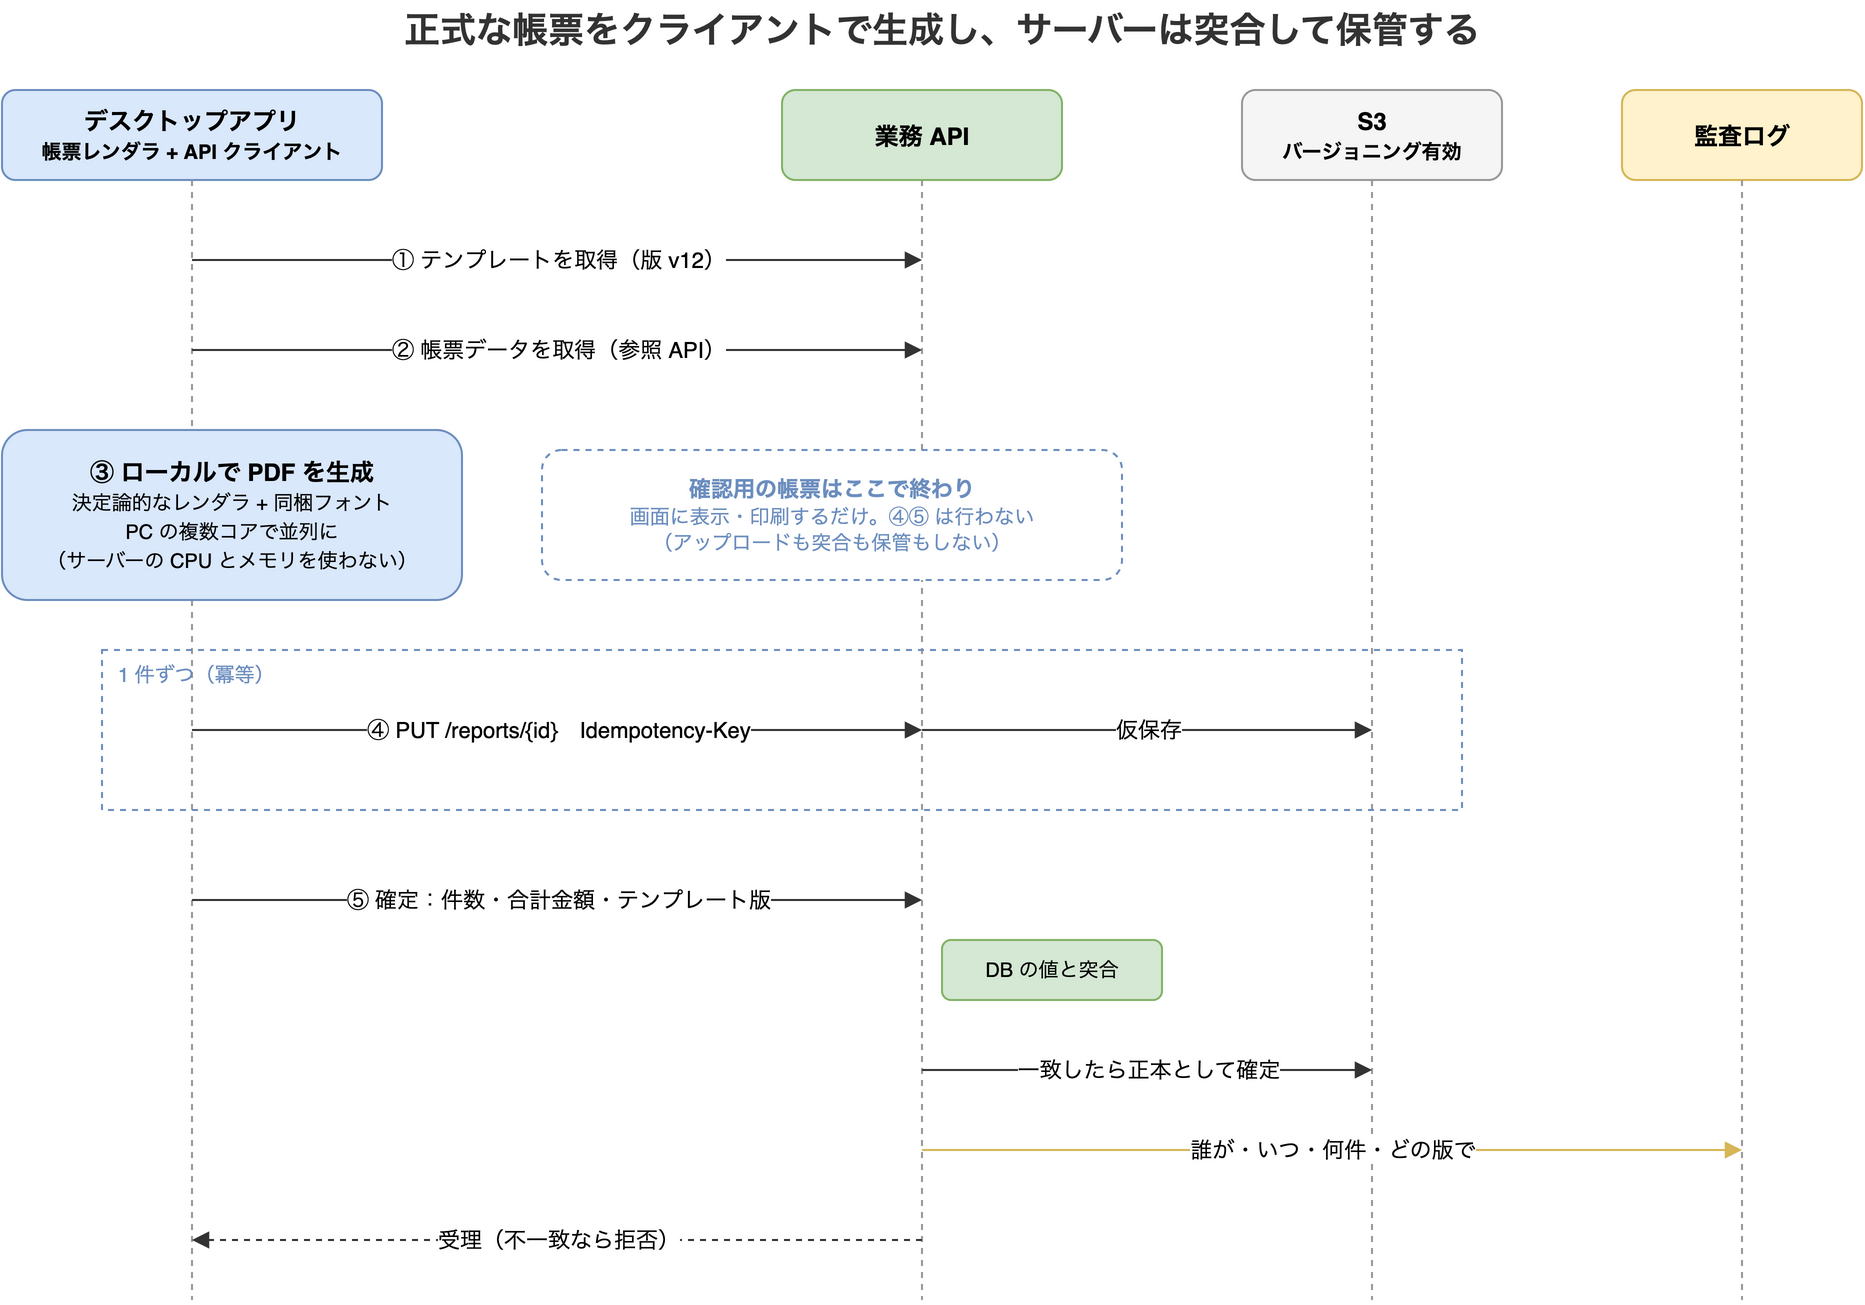
| 正式な帳票 | 請求書、納品書、支払通知書 | PC で生成 | 送る。突合して S3 に保管し、監査ログに残す |
| 確認用の帳票 | 残高一覧、進捗表、日々の集計表 | PC で生成 | 送らない。画面に表示し、必要なら印刷するだけ |
確認用の帳票は、PC で作って表示したら役目を終えます。アップロードも突合も保管も要りません。サーバーから見れば、データとテンプレートを返すだけの参照 API の呼び出しにすぎず、帳票のための負荷はほぼゼロです。アップロードの待ちもないので、利用者にとっても一番速くなります。
S3 に送るべき帳票は、正式なものだけで、数は少なくて済みます。以下の「3 つの条件」や突合の手続きは、この正式な帳票のためのものです。さらに、方針 4 の AI エージェントが入ると、確認用の帳票は「聞けば分かる」ものに置き換わっていき、出す回数自体も減っていきます。
正式な帳票の流れを図にすると次のようになります。
生成場所はブラウザかデスクトップアプリか
クライアントで帳票を作る方法は 2 つあります。
| 生成場所 | 方法 | 向いている場面 |
|---|---|---|
| ブラウザ | Web Worker 上で JavaScript / WebAssembly の PDF ライブラリを動かす | 件数が少ない帳票。配布の仕組みが要らない |
| デスクトップアプリ | ネイティブ側(Rust など)で PDF を生成する | 一括発行のような大量の帳票、ローカルへの保存やプリンタ連携が要る帳票 |
ブラウザでも、Web Worker を論理プロセッサ数(navigator.hardwareConcurrency。ブラウザが実際より小さい値を返すこともある)を目安に立てれば、並列に生成できます。ただし、大量の帳票では、メモリの上限、多数のファイルのダウンロード、生成中にタブを閉じられる問題が出てきます。一括発行が主な用途なら、デスクトップアプリのほうが扱いやすいでしょう。
正式な帳票をクライアントで作るための 3 つの条件
請求書のように「正本」として扱う帳票をクライアントで作るなら、正本であることを生成場所ではなく手続きで担保する必要があります。次の 3 つは必須です。① と ③ は確認用の帳票にも効きます。同じテンプレートとレンダラを使えば、確認用で見た数字と正式な帳票の数字が食い違いません。
| # | 起こりうる問題 | 対策 |
|---|---|---|
| ① | OS やブラウザで見た目が変わる。 Tauri は OS の WebView を使う(macOS は WKWebView、Windows は WebView2)。文字の組み方が違うので、同じ帳票が別の見た目になりうる | WebView やブラウザの印刷機能(print-to-pdf)に頼らない。決定論的な PDF レンダラを使い、フォントをアプリに同梱する |
| ② | データと帳票が一致する保証がない。 クライアントが作ったものをそのまま正本にすると、差し替えの余地がある | 入力データは必ず API から取得する(クライアントが数字を作らない)。確定時にサーバーが件数と合計金額を DB と突合し、合わなければ受理しない。保管先はバージョニングを有効にする |
| ③ | テンプレートの版がずれる。 古い版のアプリが、古いレイアウトで発行し続けるかもしれない | テンプレートはサーバーから配信し、アプリに持たせない。発行時のテンプレート版を、帳票のメタデータと DB に記録する |
① が最も重要です。OS の印刷機能に頼った瞬間に、Windows と macOS で別の正本が出てしまいます。
あわせて、生成の事実(誰が・いつ・何件・どの版で)を監査ログに送ります。生成と保管は分けて考え、保管はこれまでどおりサーバー側(S3 や文書管理基盤)が担います。確認用の帳票は、個人情報を含むなど出力の記録が求められる場合に限り、生成した事実だけを軽く記録すれば十分です。
振り分けるのは「件数」ではなく「保存の要否」
「少ない件数ならサーバー、大量ならクライアント」のように振り分けたくなりますが、おすすめしません。同じ帳票が、生成経路によって別物になりうるからです。どこで線を引くかも恣意的になり、運用の途中で必ず揉めます。
振り分けてよいのは、生成した後に保存するかどうかです。生成の経路(同じテンプレート、同じレンダラ)は 1 つに統一し、帳票の種類ごとに「保存が必要か」だけを決めておきます。正式な帳票には上の 3 条件を、確認用の帳票には生成までを適用します。
長い処理は「1 件単位の冪等 API」に分解する
一括発行のように件数の多い処理は、1 件単位の冪等な API をクライアントがループで呼ぶ形に分解します。
async function issueInvoices(month: string) {
  const { template, version } = await api.get(`/api/report-templates/invoice`);
  const invoices = await api.get(`/api/billing/invoices?month=${month}`);

  // 発行の単位を登録する。冪等キーを月と版から決めておけば、
  // 中断後にやり直しても同じ batchId が返る
  const { batchId } = await api.post(`/api/report-batches`, { month, version }, {
    headers: { "Idempotency-Key": `invoice:${month}:v${version}` },
  });

  // 再開時は、アップロード済みのものを飛ばす
  const uploaded = new Set(await api.get(`/api/report-batches/${batchId}/items`));
  const remaining = invoices.filter((inv) => !uploaded.has(inv.id));

  // PC の複数コアで並列に生成し、1 件ずつアップロードする
  await parallel(remaining, navigator.hardwareConcurrency, async (inv) => {
    const pdf = await renderer.render(template, inv);           // サーバーの CPU を使わない
    await api.put(`/api/report-batches/${batchId}/items/${inv.id}`, pdf, {
      headers: { "Idempotency-Key": `${batchId}:${inv.id}` },   // 再送しても二重にならない
    });
  });

  // 件数・合計金額・テンプレート版を送り、サーバーに突合させて確定する
  await api.post(`/api/report-batches/${batchId}/finalize`, {
    count: invoices.length,
    total: sum(invoices.map((i) => i.amount)),
    templateVersion: version,
  });
}
ここでは、後で述べる Saga(方針 2)のような巻き戻しは要りません。各アイテムは互いに独立していて、どれか 1 件の失敗が他を巻き戻す必要がないからです。途中で止まっても、アップロード済みのものはサーバーに残っています。batchId は冪等キーで固定されているので、再開時は残りだけを送り直せばよく、最後の finalize で件数と合計が合わなければ確定されません。
サーバー側に残すもの
クライアント生成にできない帳票もあります。
- 無人の夜間バッチで作る帳票: 利用者の PC が動いていない時間に作る必要がある
- 外部システムが直接取りに来る帳票: 利用者の操作を経ずに作る必要がある
こうした帳票だけは、サーバー側で処理します。そのときも帳票ごとに ECS タスクを起動するのではなく、**SQS と常駐ワーカー(ECS サービス)**にするのが定石です。
- ワーカーのタスク数と 1 タスクあたりの同時実行数で、同時に作る帳票の数を制御できる。1 件あたりのメモリから逆算して決めれば、メモリ不足で落ちるのを防げる
- 処理中に落ちたメッセージは、可視性タイムアウト(受信中のメッセージを他のワーカーから見えなくしておく時間)が過ぎると再配信される
- 何度も失敗したメッセージは DLQ に隔離される
- SQS の標準キューは「少なくとも 1 回」の配信なので、ワーカーはジョブ ID で冪等に処理する
数が少なければ、夜間だけワーカーを起動するスケジュールにしてもかまいません。
Saga とは: 業務をまたぐ更新を組み立てる考え方
方針 2 に入る前に、Saga とそれに付随する概念を整理しておきます。冒頭の問題 1(業務をまたぐ更新の作法がばらばら)を解く道具が Saga です。
なぜ必要か: トランザクションはサービスをまたげない
1 つの DB の中なら、BEGIN から COMMIT までをトランザクションで囲めば、「全部成功するか、全部なかったことにするか」を DB が保証してくれます。途中で失敗すれば ROLLBACK で元に戻ります。
ところが、受注・在庫・請求が別々の API サーバーと別々の DB に分かれていると、この保証は使えません。受注 API の DB のトランザクションは、在庫 API の DB には及ばないからです。
複数の DB をまたいで同じ保証を得る方法として、2 相コミット(2PC) があります。参加するすべての DB に「確定してよいか」を聞いて回り、全員がよいと答えたら一斉に確定する方式です。しかし、HTTP でつながった API 同士では一般に採りにくい方式です。全員の返事がそろうまで、各 DB がロックを持ったまま待つことになるので、1 つのサービスが遅いだけで全体が止まります。
そこで、「全部まとめて巻き戻す」ことをあきらめ、業務的に打ち消すことで整合性を取るのが Saga です。
Saga の仕組み: ローカルトランザクションと補償トランザクション
Saga は、業務をまたぐ 1 つの処理を、次の 2 種類の部品で組み立てます。
- ローカルトランザクション: 1 つのサービスの中で完結する、普通の DB トランザクション。「在庫を引き当てる」のように、1 つの API の 1 回の呼び出しで終わる
- 補償トランザクション(Compensating Transaction): 完了したローカルトランザクションを、業務的に打ち消す処理。「引当を解除する」「受注を取り消す」など
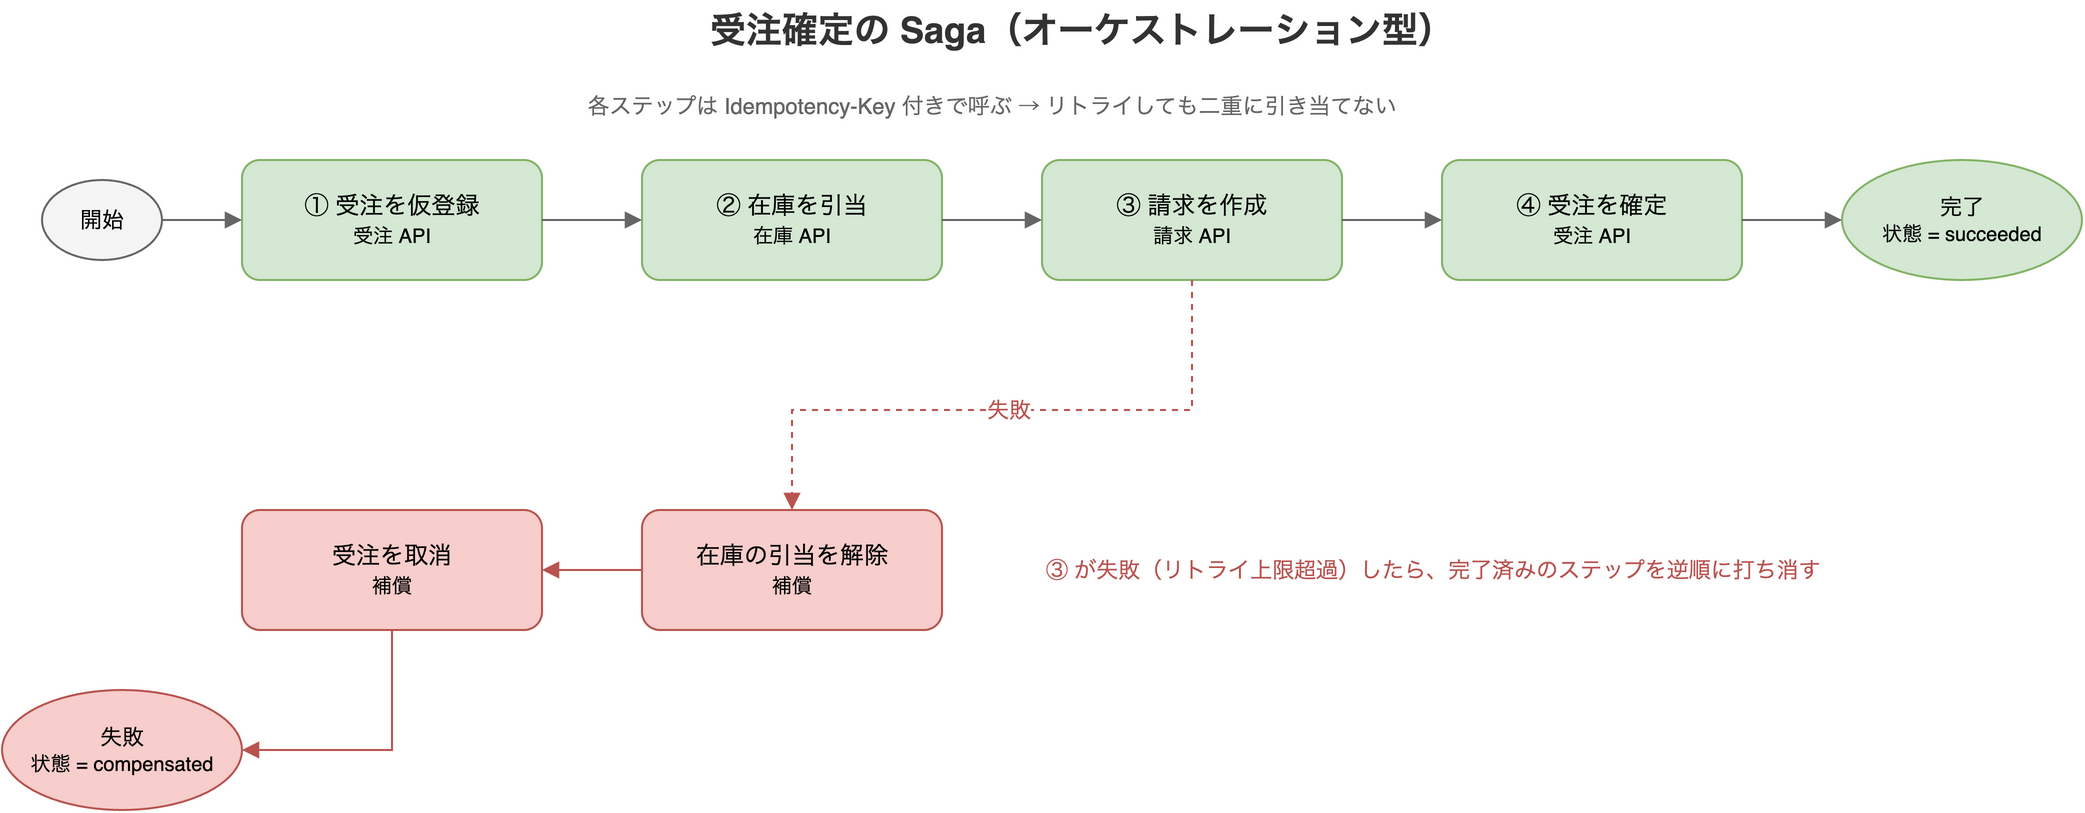
ローカルトランザクションを順に実行し、途中で失敗したら、それまでに完了したステップを補償トランザクションで打ち消します。打ち消す順番は基本的に逆順です(依存関係がなければ並列に打ち消してもかまいません)。受注確定の例では、次の表のようになります。
| ステップ | ローカルトランザクション | 失敗したときの補償トランザクション |
|---|---|---|
| ① | 受注を仮登録する(受注 API) | 受注を取り消す |
| ② | 在庫を引き当てる(在庫 API) | 引当を解除する |
| ③ | 請求を作成する(請求 API) | 請求を取り消す |
| ④ | 受注を確定する(受注 API) | — |
③ で失敗したら、② の引当解除 → ① の受注取消の順に補償します。
補償はロールバックではない
補償トランザクションは、DB のロールバックとは性質が違います。
- 記録が残る。 ロールバックは「なかったこと」にするが、補償は「取り消した」という業務上の操作を新たに行う。取り消された受注は、取消済みの受注として履歴に残る
- 完全には元に戻せないことがある。 送ってしまったメールや、外部システムに送信したデータは取り消せない。できるのは「お詫びのメールを送る」「取消の電文を送る」ことだけ
- 補償そのものも失敗しうる。 だから補償も、何度呼んでも壊れないように作り、成功するまで再試行できるようにする
このため、取り消せない処理(メールの送信、外部への送信など)は Saga の最後のほうに置きます。それより前のステップが全部成功したことを確かめてから、取り返しのつかない操作をするためです。
一時的な不整合と「仮」状態
Saga の途中では、「在庫は引き当てたが、請求はまだ」のような一時的な不整合が見えます。最終的には全部確定するか、全部取り消されて整合するので、これを**結果整合性(Eventual Consistency)**と呼びます。
注意したいのは、Saga には DB のトランザクションのような分離性(Isolation)がないことです。途中の状態はほかの処理からも見えるので、確定前の引当を見て在庫が足りないと判断する、といったことが起こりえます。
そこで、途中の状態をほかの処理が本物と勘違いしないように、「仮」の状態をはっきり持たせます。Saga の対策としては「セマンティックロック(Semantic Lock)」と呼ばれるもので、「この行は処理中」と業務の状態で示します。受注をいきなり「確定」にせず、「仮登録 → 確定」の 2 段階にするのはこのためです。仮登録の受注は、一覧や集計で確定済みと区別でき、補償も「削除」ではなく「取消」という業務的に自然な操作になります。この記事では、さらに仮状態に有効期限を持たせ、司令塔が戻ってこなくても自動で解放される安全網にします(方針 2 で詳しく扱います)。
冪等性: 同じ呼び出しを何度送っても 1 回分
Saga では、呼び出しの再試行が頻繁に起きます。ネットワークが切れて、成功したのか失敗したのか分からないときは、もう一度呼ぶしかありません。補償も、成功するまで再試行します。
このとき、在庫の引当が 2 回効いてしまっては困ります。そこで各ステップを冪等(同じリクエストを何度送っても、効果は 1 回分)にします。具体的には、呼び出しに**冪等キー(Idempotency Key)**という一意な値を付け、サーバーは同じキーの再送に対して、処理をやり直さずに前回の結果を返します。実装は、方針 2 の「業務 API 側の約束事」で示します。
オーケストレーション型とコレオグラフィ型
Saga の実装方式は 2 つあります。
| 方式 | 仕組み | 長所 | 短所 |
|---|---|---|---|
| オーケストレーション型 | 司令塔(オーケストレーター)が各サービスを順に呼び、失敗したら補償を指示する | フローが 1 か所に集まり、「どこまで進んだか」「どこで失敗したか」を 1 か所で確かめられる | 司令塔をどこかで動かす必要があり、その司令塔が止まると Saga も止まる |
| コレオグラフィ型 | 各サービスがイベント(「受注を仮登録した」など)を発行し、ほかのサービスがそれに反応して次の処理を進める | サービス同士の結合が緩く、司令塔が要らない | フローが各サービスに散らばり、全体の流れや失敗箇所を追いにくい |
業務システムで「作法がばらばら」なことが問題になっているなら、オーケストレーション型を標準にするのがおすすめです。業務の流れが 1 つの定義に集まるので、業務担当者にも説明しやすくなります。上の図もオーケストレーション型です。
残る問いは、その司令塔をどこで動かすかです。それが方針 2 の主題です。
方針 2: Saga の司令塔をデスクトップアプリに置く
帳票のためにデスクトップアプリを入れるなら、冒頭の問題 1(業務をまたぐ更新の作法がばらばら)も、同じアプリで解けます。サーバーにオーケストレーターを新しく立てる代わりに、アプリの中の 1 つの Saga ランナーに作法を揃えます。
司令塔をどこに置くか
オーケストレーション型の Saga では、「司令塔をどこで動かすか」が設計の分かれ目になります。
| 置き場所 | 中断への強さ | サーバー側に増えるもの | 向いている場面 |
|---|---|---|---|
| ブラウザのタブ | 弱い。タブを閉じる・リロードすると、進み具合ごと消える | なし | 向かない |
| デスクトップアプリ | 進み具合をローカルに保存すれば、再起動後に続きから再開できる | なし | 利用者の操作をきっかけに始まる業務 |
| サーバー(Step Functions など) | 最も強い。利用者の PC と無関係に進む | オーケストレーターの運用 | 無人で動く処理、外部システムが起点の処理、厳しい締め切りがある処理 |
ブラウザの SPA が複数の API を順に呼ぶ、次のような実装は危険です。
// ブラウザのタブでこれをやると危ない
async function confirmOrder(input: OrderInput) {
  const order = await ordersApi.create(input);   // ① 成功
  await stockApi.reserve(order.id);              // ② 成功
  await billingApi.createInvoice(order.id);      // ③ ここでタブを閉じられたら?
  await ordersApi.confirm(order.id);
}
② まで終わって ③ の前にタブが閉じられると、在庫だけ引き当てられた受注が残ります。後始末をするはずのコードは、もう動いていません。どこまで進んだかの記録もメモリ上にしかないので、次に開いたときに続きから再開することもできません。
デスクトップアプリなら、この弱点を埋められます。各ステップを呼ぶ前に、進み具合をローカルの DB に書いておくからです。アプリが落ちても、PC が再起動しても、次に起動したときにログを読んで続きから再開するか、補償に回すかを決められます。
クライアントを司令塔にするための 5 つの約束事
ただし、デスクトップアプリでも「PC がそのまま戻ってこない」ことはあります。そこで、クライアントが途中で消えてもデータが壊れないように、サーバー側とクライアント側に次の約束事を置きます。
- 進み具合を先に書く(クライアント)。 各ステップを呼ぶ前に「これから ② を呼ぶ」とローカルの Saga ログに書く。終わったら「② 完了」と書く。再起動したらログを読んで再開する
- 冪等キーを Saga ID とステップ名から作る(クライアント → サーバー)。
"{sagaId}:reserve-stock"のようにする。再開時に同じステップをもう一度呼んでも、サーバーは前回の結果を返すだけで二重に処理しない - 仮状態に有効期限を持たせる(サーバー)。 仮登録・仮引当には期限を付け、確定されないまま期限が切れたらサーバーが自動で解放する。PC が二度と戻らなくても、時間が経てばデータは元に戻る。これがオーケストレーターなしで成り立つための安全網になる
- 補償 API を用意する(サーバー)。 「引当」に対する「引当解除」、「仮登録」に対する「取消」を公開する。補償も冪等にする(2 回取り消しても壊れない)
- Saga をサーバーに登録する(クライアント → サーバー)。 開始時に Saga ID・種類・開始者を登録し、ステップが進むたびに状態を更新する。ほかの端末や管理者からも「誰の、どの処理が、どこで止まっているか」が見える
5 の登録先は、その業務の持ち主の業務 API の DB に置きます。受注確定の Saga なら受注 API の DB です。Saga 用のテーブルを足すか、受注レコードに Saga の ID と状態を持たせます。Saga の最初のステップが作る受注の「仮登録」は、もともと「仮 → 確定 / 取消」という状態を持っているので、それ自体が Saga の進み具合になります。3 の期限切れの解放も、同じ受注 API の中で完結します。
Saga 専用の DB や登録サービスを新しく立てる必要はありません。サーバーに常駐するものを増やさない、というこの記事の方針とも一致します。Saga の種類が増えて、管理者が 1 画面で一覧したくなった時点で、小さな専用の登録簿(DynamoDB のテーブルと、それを読み書きする小さな API など)を足せば十分です。業務 API の約束事は変わらないので、後から足しても既存の Saga には影響しません。
3 の「期限切れの解放」は、サーバー側に定期実行の小さな処理を 1 つ置くだけで実現できます。期限切れの行を探して解放するクエリを、スケジューラから 1 日数回起動する程度のものです。常駐するオーケストレーターに比べれば、運用の重さはずっと小さくなります。
デスクトップアプリ側の Saga ランナー
デスクトップアプリ側の Saga ランナーは、たとえば次のように書けます。ローカルの永続化には SQLite などを想定しています(ここでは sagaLog として抽象化しています)。registry は、上の 5 で述べた持ち主の業務 API に Saga の状態を書く呼び出しです。
type Step = {
  name: string;
  run: (sagaId: string, idempotencyKey: string) => Promise<void>;
  compensate?: (sagaId: string, idempotencyKey: string) => Promise<void>;
};

async function runSaga(sagaId: string, steps: Step[]) {
  // 補償の途中で落ちていたら、前へ進まずに補償を続ける
  if ((await sagaLog.status(sagaId)) === "compensating") {
    return compensate(sagaId, steps, await sagaLog.failedIndex(sagaId));
  }

  const done = await sagaLog.completedSteps(sagaId); // 再開時はここから続ける

  for (const [i, step] of steps.entries()) {
    if (done.includes(step.name)) continue;

    await sagaLog.markStarted(sagaId, step.name);    // ① 呼ぶ前に書く
    try {
      await withRetry(() => step.run(sagaId, `${sagaId}:${step.name}`));
      await sagaLog.markDone(sagaId, step.name);     // ② 終わったら書く
      await registry.update(sagaId, { step: step.name, status: "running" });
    } catch (e) {
      // 補償に入ったことを先に書く(補償の途中で落ちても、再起動後に補償へ戻れる)
      await sagaLog.markCompensating(sagaId, i);
      await compensate(sagaId, steps, i);
      throw e;
    }
  }
  await registry.update(sagaId, { status: "succeeded" });
}

// 失敗したステップ自身も含めて逆順に補償する。
// 失敗したステップは「サーバーでは処理済みで、応答だけ失われた」可能性があるため。
// 補償は冪等なので、未処理のステップに対して呼んでも、2 回呼んでも壊れない
async function compensate(sagaId: string, steps: Step[], failedIndex: number) {
  const compensated = await sagaLog.compensatedSteps(sagaId);
  for (const step of steps.slice(0, failedIndex + 1).reverse()) {
    if (compensated.includes(step.name)) continue;
    await withRetry(() => step.compensate?.(sagaId, `${sagaId}:${step.name}:compensate`));
    await sagaLog.markCompensated(sagaId, step.name);
  }
  await registry.update(sagaId, { status: "compensated" });
}

// アプリ起動時: 終わっていない Saga を探して再開する
for (const sagaId of await sagaLog.unfinished()) {
  await runSaga(sagaId, definitions[await sagaLog.typeOf(sagaId)]);
}
この Saga ランナーは画面(WebView)側で書いても動きます。ただし、Tauri のようにネイティブ側(Rust)を持てる基盤なら、画面を閉じても動き続けるネイティブ側に置くほうが堅牢です。
業務 API 側の約束事
クライアントが司令塔でも、サーバーが司令塔でも、業務 API に求められることは同じです。これを「社内 API の標準」として明文化しておくと、新しい業務を追加するときの議論が減ります。
- 更新系 API は冪等にする。
Idempotency-Keyヘッダー(IETF で標準化のドラフトが進んでいる)を受け付け、同じキーでの再送には前回と同じ結果を返す - 補償用の API を用意する。 補償も冪等にする
- 「仮」の状態と有効期限を持つ。 仮登録 → 確定の 2 段階にすると、補償が「削除」ではなく「取消」という業務的に自然な操作になる。期限切れは自動で解放する
- エラー形式を揃える。 RFC 9457(Problem Details for HTTP APIs)の
application/problem+jsonに揃えておくと、クライアントが同じ方法でエラーを解釈できる - 相関 ID を引き回す。 Saga ID や W3C Trace Context の
traceparentヘッダーを全サービスに伝播させ、1 つの操作のログを横断して追えるようにする
冪等キーの実装は、キーとレスポンスを保存するテーブルを 1 つ持つだけで始められます。
# 更新系 API での冪等キーの扱い(擬似コード)
import hashlib

def handle(request):
    key = request.headers.get("Idempotency-Key")
    if key is None:
        return problem(400, "Idempotency-Key is required")

    # 組み込みの hash() はプロセスごとに値が変わるので、SHA-256 で比べる
    body_hash = hashlib.sha256(request.body).hexdigest()

    saved = idempotency_store.get(key)
    if saved:
        if saved.request_hash != body_hash:
            return problem(422, "Idempotency-Key reused with different payload")
        return saved.response  # 前回と同じ結果を返す

    with db.transaction():
        result = do_business_logic(request)
        # キー列にユニーク制約を付けておく。同じキーの同時リクエストが
        # ここで衝突したら、トランザクションを捨てて保存済みの結果を読み直す
        idempotency_store.put(key, body_hash, result)  # 業務の更新と同じトランザクションで保存
    return result
サーバー側に司令塔を置くべき場面
すべての Saga をクライアントに寄せられるわけではありません。次のような処理は、サーバー側(Step Functions など)に司令塔を置くほうが適しています。
- 利用者の操作がきっかけではない処理: 夜間の定期処理、外部システムからの連携が起点の処理
- 締め切りが厳しい処理: 「必ず今日中に確定させる」必要があり、PC が戻るのを待てない
- 複数の利用者にまたがる処理: 承認待ちを挟んで、別の人の操作で続きが進む
AWS なら Step Functions で、リトライ(Retry)と失敗時の分岐(Catch)をステートマシンとして定義できます。業務 API の約束事は同じなので、最初はクライアントで動かし、必要になった Saga だけサーバーへ移すこともできます。
応用: 一括ファイル取り込みも PC で回す
帳票と同じ性質の重い処理に、一括ファイル取り込みがあります。数千行の CSV や Excel をサーバーに送り、サーバーが 1 回のリクエストの中で解析・検証・登録する作りだと、帳票と同じ問題が起きます。
- 解析と検証でサーバーのメモリと時間を食い、同時に取り込まれると落ちる
- 利用者は何分も待たされたあげく、「1,234 行目でエラー」と言われてやり直しになる
- 待っている間、どこまで進んだのかが分からない
これも、方針 1 と方針 2 を組み合わせて PC に寄せられます。
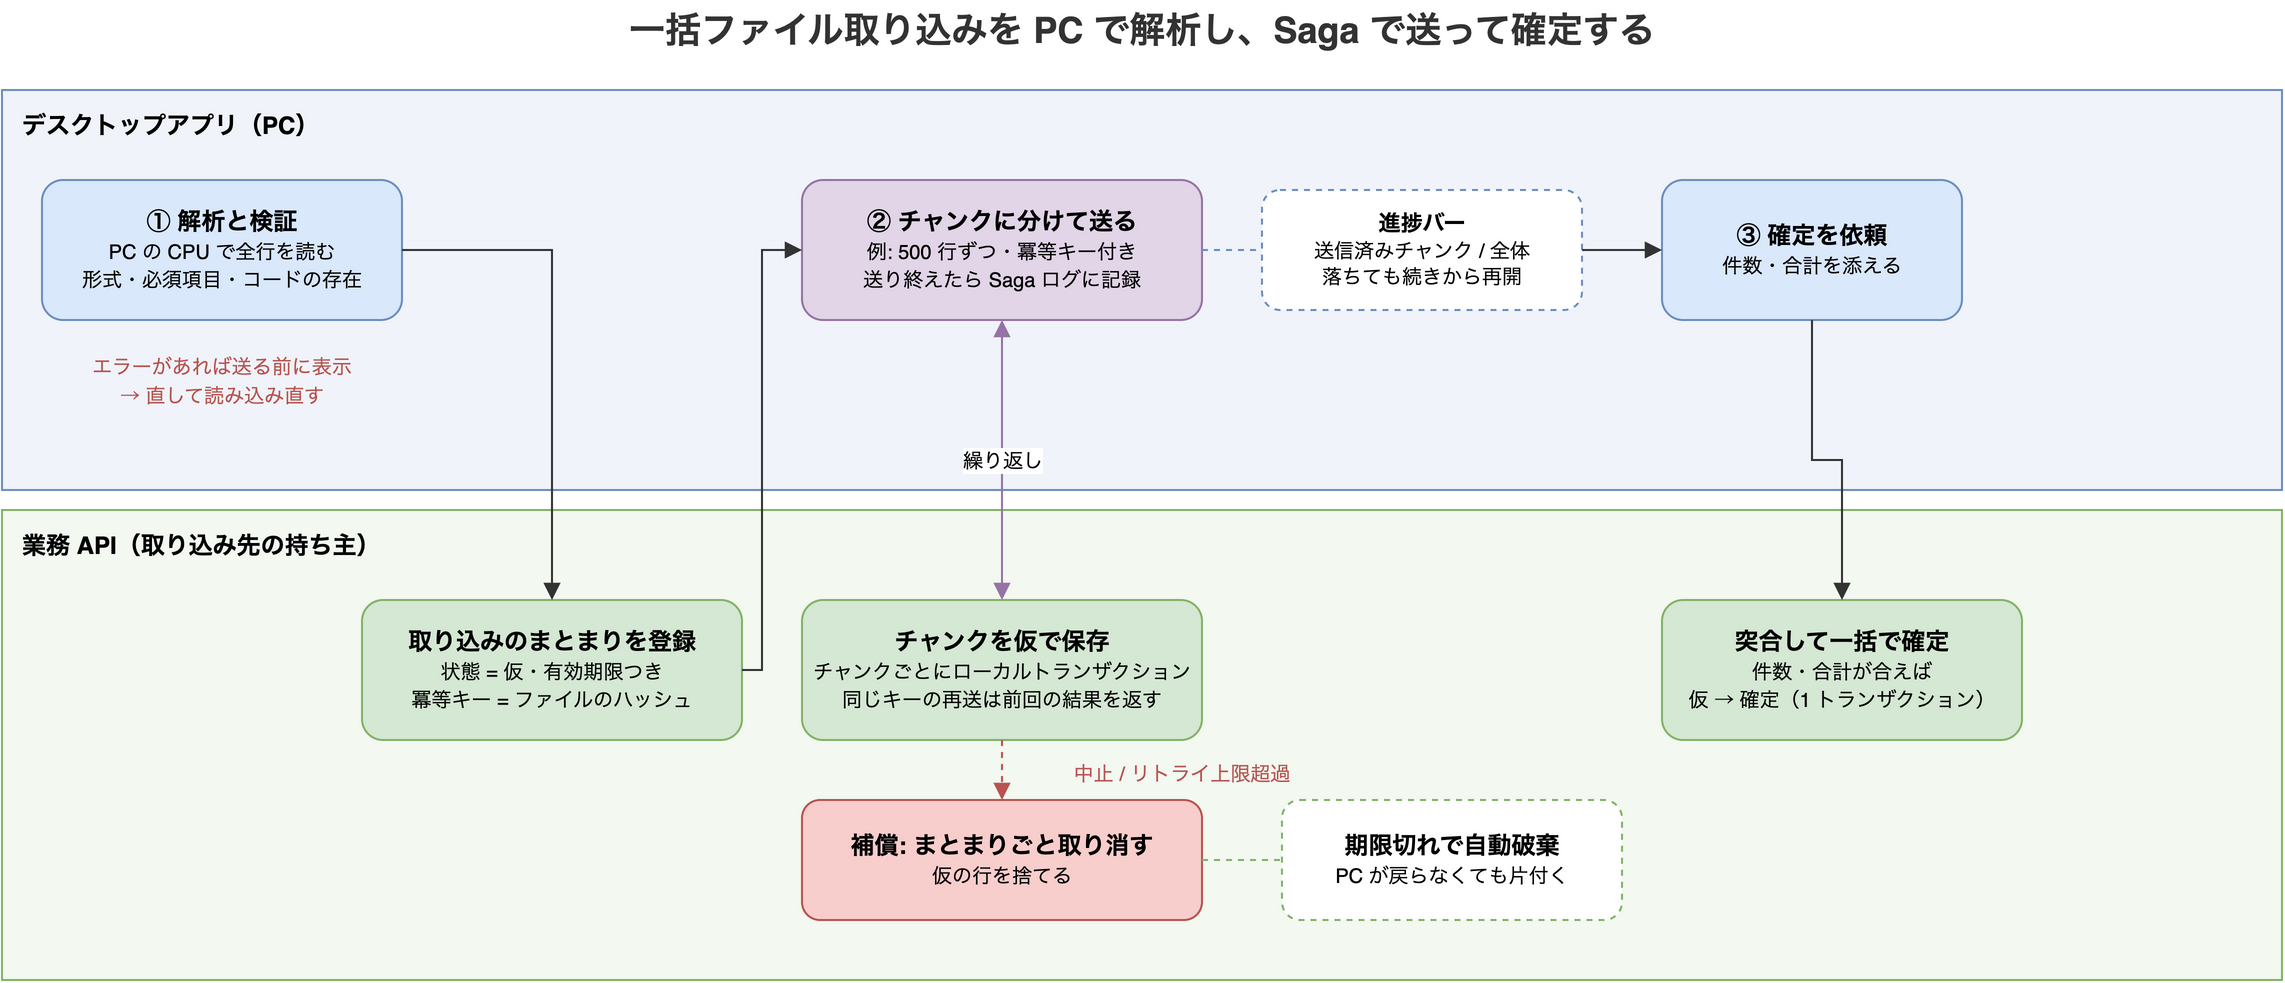
- 解析と検証は PC で行う(方針 1)。 ファイルを読み、形式・必須項目・コードの存在などを PC の CPU で検証する。エラーは送る前に一覧で見せ、利用者に直してもらう。サーバーとの往復なしに、何度でもやり直せる
- 取り込みのまとまりを「仮」で登録する。 取り込み 1 回分を、有効期限つきの仮の状態で登録する。冪等キーにはファイルのハッシュを使うと、同じファイルを送り直しても同じまとまりが返る
- チャンクに分けて送る(Saga のステップ)。 500 行ずつなどに分け、冪等キー付きで 1 チャンクずつ送る。サーバーはチャンクごとにローカルトランザクションで仮保存する。送り終えたチャンクは Saga ログに記録するので、アプリが落ちても続きから再開できる
- 最後に突合して一括で確定する。 件数と合計を添えて確定を依頼し、サーバーは合っていれば仮の行をまとめて確定に切り替える。確定は、取り込み先の業務 API の中の 1 トランザクションで済む。仮の行の状態を切り替えるだけなので、解析や検証に比べればずっと軽い
- 中止や失敗は、まとまりごと取り消す(補償)。 利用者が中止したときや、リトライの上限を超えたときは、仮の行をまとまりごと捨てる。PC が戻ってこなくても、有効期限が切れれば自動で捨てられる
取り込み途中の行は「仮」なので、確定するまでは一覧や集計に混ざりません。「途中まで入ってしまった」という中途半端な状態が、業務から見えなくなります。
async function importFile(file: File) {
  // ① PC の CPU で解析と検証。エラーは送る前に見せる
  const { valid, errors } = await parseAndValidate(file);
  if (errors.length > 0) return showErrors(errors);

  // ② 取り込みのまとまりを仮で登録。ファイルのハッシュを冪等キーにする
  const digest = await crypto.subtle.digest("SHA-256", await file.arrayBuffer());
  const fileHash = toHex(digest);
  const { batchId } = await api.post(`/api/imports`, { name: file.name, count: valid.length }, {
    headers: { "Idempotency-Key": `import:${fileHash}` },
  });

  // ③ チャンクに分けて送る。送信済みは飛ばすので、落ちても続きから再開できる
  const chunks = chunk(valid, 500);
  const sent = new Set(await api.get(`/api/imports/${batchId}/chunks`));
  for (const [i, rows] of chunks.entries()) {
    if (!sent.has(i)) {
      await api.put(`/api/imports/${batchId}/chunks/${i}`, rows, {
        headers: { "Idempotency-Key": `${batchId}:${i}` },
      });
    }
    showProgress(i + 1, chunks.length); // 進捗バーを更新
  }

  // ④ 件数と合計を添えて確定。サーバーが突合し、合えば仮 → 確定
  await api.post(`/api/imports/${batchId}/finalize`, {
    count: valid.length,
    total: sum(valid.map((r) => r.amount)),
  });
}利用者から見た違いは大きく、ストレスが大きく下がります。
- 進み具合が見える。 「3,000 行中 1,500 行を送信済み」のように進捗バーで表示できる。何分も黙ったまま待たされることがない
- エラーが早く分かる。 検証は送る前に PC で終わっているので、数分待ってからエラーを知らされることがない
- 止めても、落ちても、やり直せる。 中止すれば取り消され、落ちても続きから再開できる。どちらの場合も、業務データが中途半端に残らない
取り込みが複数の業務 API にまたがる場合(たとえば受注と在庫の両方に登録する場合)は、それぞれの API の「仮で送る」「確定する」が Saga のステップになり、取り消しがそれぞれの補償になります。取り込んだ元のファイルを保存しておく必要がある業務なら、正式な帳票と同じく、そのファイルだけをサーバーに預けます。
BFF とは: フロントエンドごとに置く専用のバックエンド
方針 3 に入る前に、BFF(Backend for Frontend)というデザインパターンを整理しておきます。パターン名としては、フロントエンドごとに複数置くことから、複数形の Backends for Frontends とも呼ばれます。
なぜ必要か: 汎用の API を画面から直接使うと苦しくなる
業務 API は、受注・在庫・請求といった業務の単位で作られています。どの画面からでも使える汎用の API です。ところが画面は、業務の単位ではなく、利用者の仕事の単位でできています。「受注の詳細画面」には、受注の中身に加えて、在庫の引当状況と請求の状態も並べたくなります。
この汎用の API を、ブラウザの SPA から直接呼ぶと、次のような困りごとが出てきます。
- 呼び出しが多くなる。 1 つの画面を表示するために、何本もの API を呼ぶ。往復が増え、画面が遅くなる
- 画面の都合が汎用の API に入り込む。 「この画面のためにこの項目も返してほしい」という要望が業務 API に積み重なり、業務 API が特定の画面に縛られていく
- クライアントの種類ごとに都合が違う。 Web とモバイルでは、欲しいデータの量も形も違う。1 つの汎用 API で全員の都合に応えようとすると、どれにも合わなくなる
- トークンをブラウザに置くことになる。 各 API を呼ぶためのアクセストークンを、JavaScript から読める場所に持つことになり、XSS で盗まれたときの被害が大きい
仕組み: クライアントの種類ごとに専用のバックエンドを置く
BFF は、特定のフロントエンド(クライアントの種類)専用に置く、薄いバックエンドです。Web 用の BFF、モバイル用の BFF のように、クライアントの種類ごとに用意するのが基本です。SoundCloud で Phil Calçado らが使い始めた呼び名で、Sam Newman が 2015 年に記事で整理して紹介し、広く知られるようになりました。
この記事では、BFF が担う役割を次の 4 つに整理します。最初の 2 つと 4 つ目が BFF の本来の役割で、3 つ目はセキュリティの文脈から加わった役割です。
| 役割 | 中身 |
|---|---|
| 集約(API Composition) | 1 つの画面に必要なデータを、複数の業務 API から並列に取って 1 回で返す |
| 画面用の整形 | 業務 API の汎用の形を、その画面がそのまま使える形に変える。不要な項目は落とす |
| 認証の終端 | ブラウザとは Cookie のセッションでやり取りし、アクセストークンは BFF が保持する。トークンがブラウザに渡らない |
| クライアントの違いの吸収 | Web とモバイルで違う都合を、それぞれの BFF が引き受ける。業務 API は汎用のまま保てる |
3 つ目の「認証の終端」は、セキュリティのための BFF として独立して語られることもあります。OAuth のブラウザアプリ向けのベストプラクティス(“OAuth 2.0 for Browser-Based Applications”、2026 年 8 月に RFC 10017 として発行)でも、トークンを BFF に持たせ、ブラウザには Cookie だけを渡す BFF パターンが示されています。
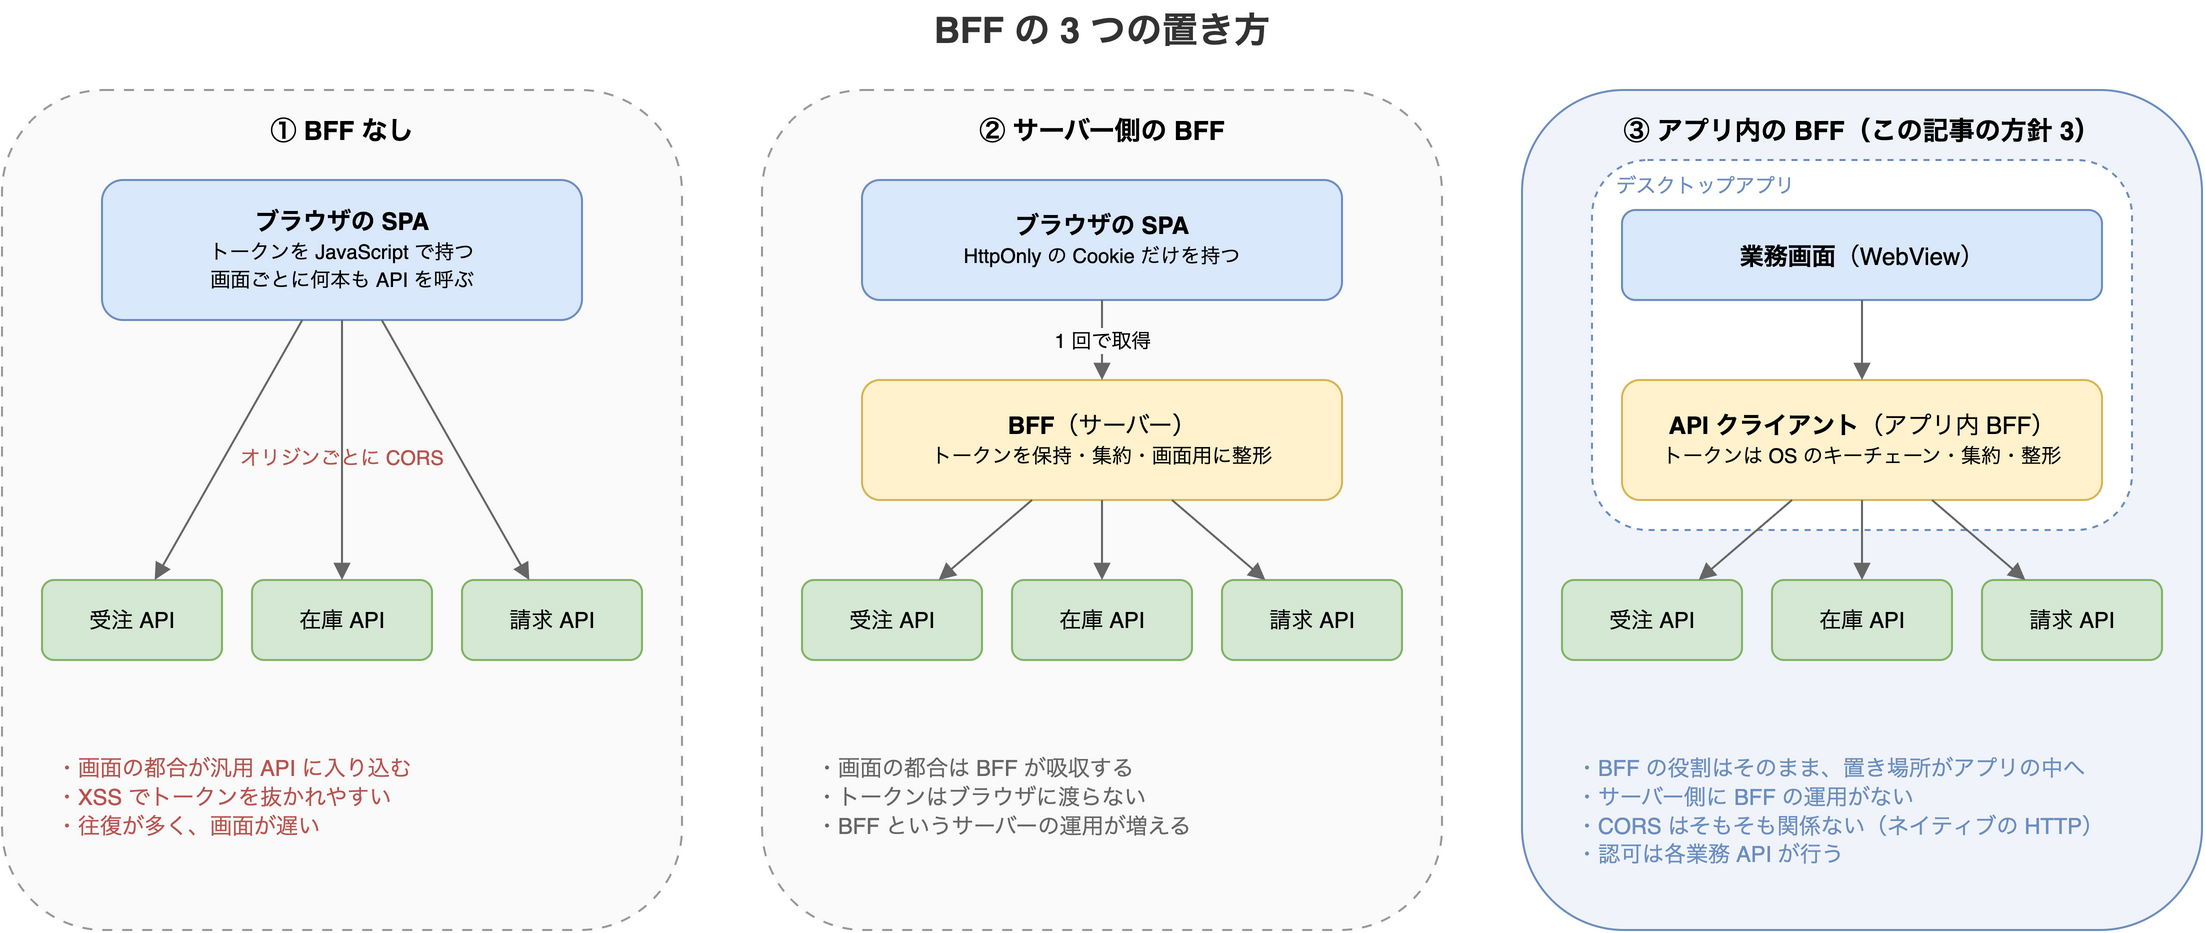
次の図は、BFF を置かない構成、サーバー側に BFF を置く構成、そしてこの記事で採るアプリ内の BFF を比べたものです。
API Gateway との違い
BFF とよく比べられるのが API Gateway です。どちらも「クライアントと業務 API の間に立つ」点は同じですが、役割が違います。
| API Gateway | BFF | |
|---|---|---|
| 誰のためにあるか | すべてのクライアントに共通 | 特定のクライアント専用 |
| 主な仕事 | ルーティング、認証、流量制限など、横断的な処理 | 集約、画面用の整形、トークンの保持 |
| 中身 | 業務やクライアントの都合を知らない | その画面の都合を知っている |
両方を組み合わせることもよくあります。API Gateway を共通の入口に置き、その後ろにクライアントごとの BFF を並べる構成です。
よくある落とし穴
BFF は便利なぶん、気を抜くと太っていきます。
- 業務ロジックを入れない。 「この画面のときだけ金額を丸める」のような業務ルールを BFF に書き始めると、BFF が新しい「巨大な共通サーバー」になる。業務ルールは業務 API に、業務をまたぐ流れは Saga の司令塔に置き、BFF は画面の都合だけを吸収する
- BFF 同士で同じ処理が重複する。 Web 用とモバイル用の BFF に同じ集約処理が書かれがちになる。重複が業務ルールなら業務 API に戻し、画面の都合なら重複を許す、と線を引く
- 持ち主をはっきりさせる。 BFF はその画面を作るチームが持つのが基本。画面の変更と BFF の変更を同じチームが同じタイミングで出せることが、BFF を置く意味そのもの
方針 3: 入口(BFF)もデスクトップアプリに組み込む
ここまで見てきた BFF の役割を、デスクトップアプリに当てはめます。ブラウザの SPA ではサーバー側に BFF を置くのが定石でしたが、デスクトップアプリなら、BFF の役割はどれもアプリのネイティブ側が引き受けられます(上の図の ③)。
| BFF の役割 | デスクトップアプリでの置き場所 |
|---|---|
| トークンを JavaScript から隠す | OS の安全な保管場所(macOS のキーチェーンや Windows の資格情報マネージャー)に置き、ネイティブ側だけが使う |
| 複数の API への振り分け | ネイティブ側の API クライアントが、業務ごとの接続先を知っていればよい |
| CORS の回避 | CORS はブラウザが強制する仕組み。ネイティブ側の HTTP クライアントはブラウザではないので、そもそも関係ない |
| 読み取りの集約 | アプリの中で複数の API を並列に呼び、画面用にまとめればよい |
つまり、アプリの中に BFF を持つ形になります。サーバー側から BFF というサービスが 1 つ消え、その分の運用もなくなります。
ただし、次の 3 つはアプリに移せません。
- ネットワークの入口: 各業務 API の HTTPS の終端(ALB)と、WAF や IP 制限は残る。消えるのは「BFF というサーバー」であって、入口そのものではない
- 認可の検査: クライアントは利用者の手元にあり、信頼できる実行環境ではない。誰が何をしてよいかは、必ず各業務 API が検査する
- 接続先の設定: 接続先をアプリに埋め込むと、構成を変えるたびにアプリを配り直すことになる。接続先の一覧はサーバーから配信し、アプリは起動時に読み込む
どの経路でも、クライアントが持つのは利用者自身のトークンだけにし、サービス用の鍵は配らないことが前提です。
ブラウザの画面が残る場合
デスクトップアプリを主役にしても、ブラウザから使う画面が残ることはあります。その画面のためだけに、サーバー側の入口を用意します。
- CloudFront で同一オリジン化する: ビヘイビアで
/は S3 の静的ファイル、/api/*は BFF や各業務 API へ振り分ける。ブラウザから見ればすべて同じオリジンなので、CORS の設定もプリフライト(本番のリクエストの前にブラウザが送るOPTIONSリクエスト)も不要になる - BFF で Cookie セッションを終端する: ブラウザには
HttpOnly; Secure; SameSite属性付きの Cookie だけを持たせ、アクセストークンは BFF が保持する。JavaScript からトークンが読めなくなり、XSS でトークンを抜かれるリスクを下げられる。Cookie 認証にするなら CSRF 対策も併せて行う
方針 4: AI エージェントにはツールを渡し、鍵は渡さない
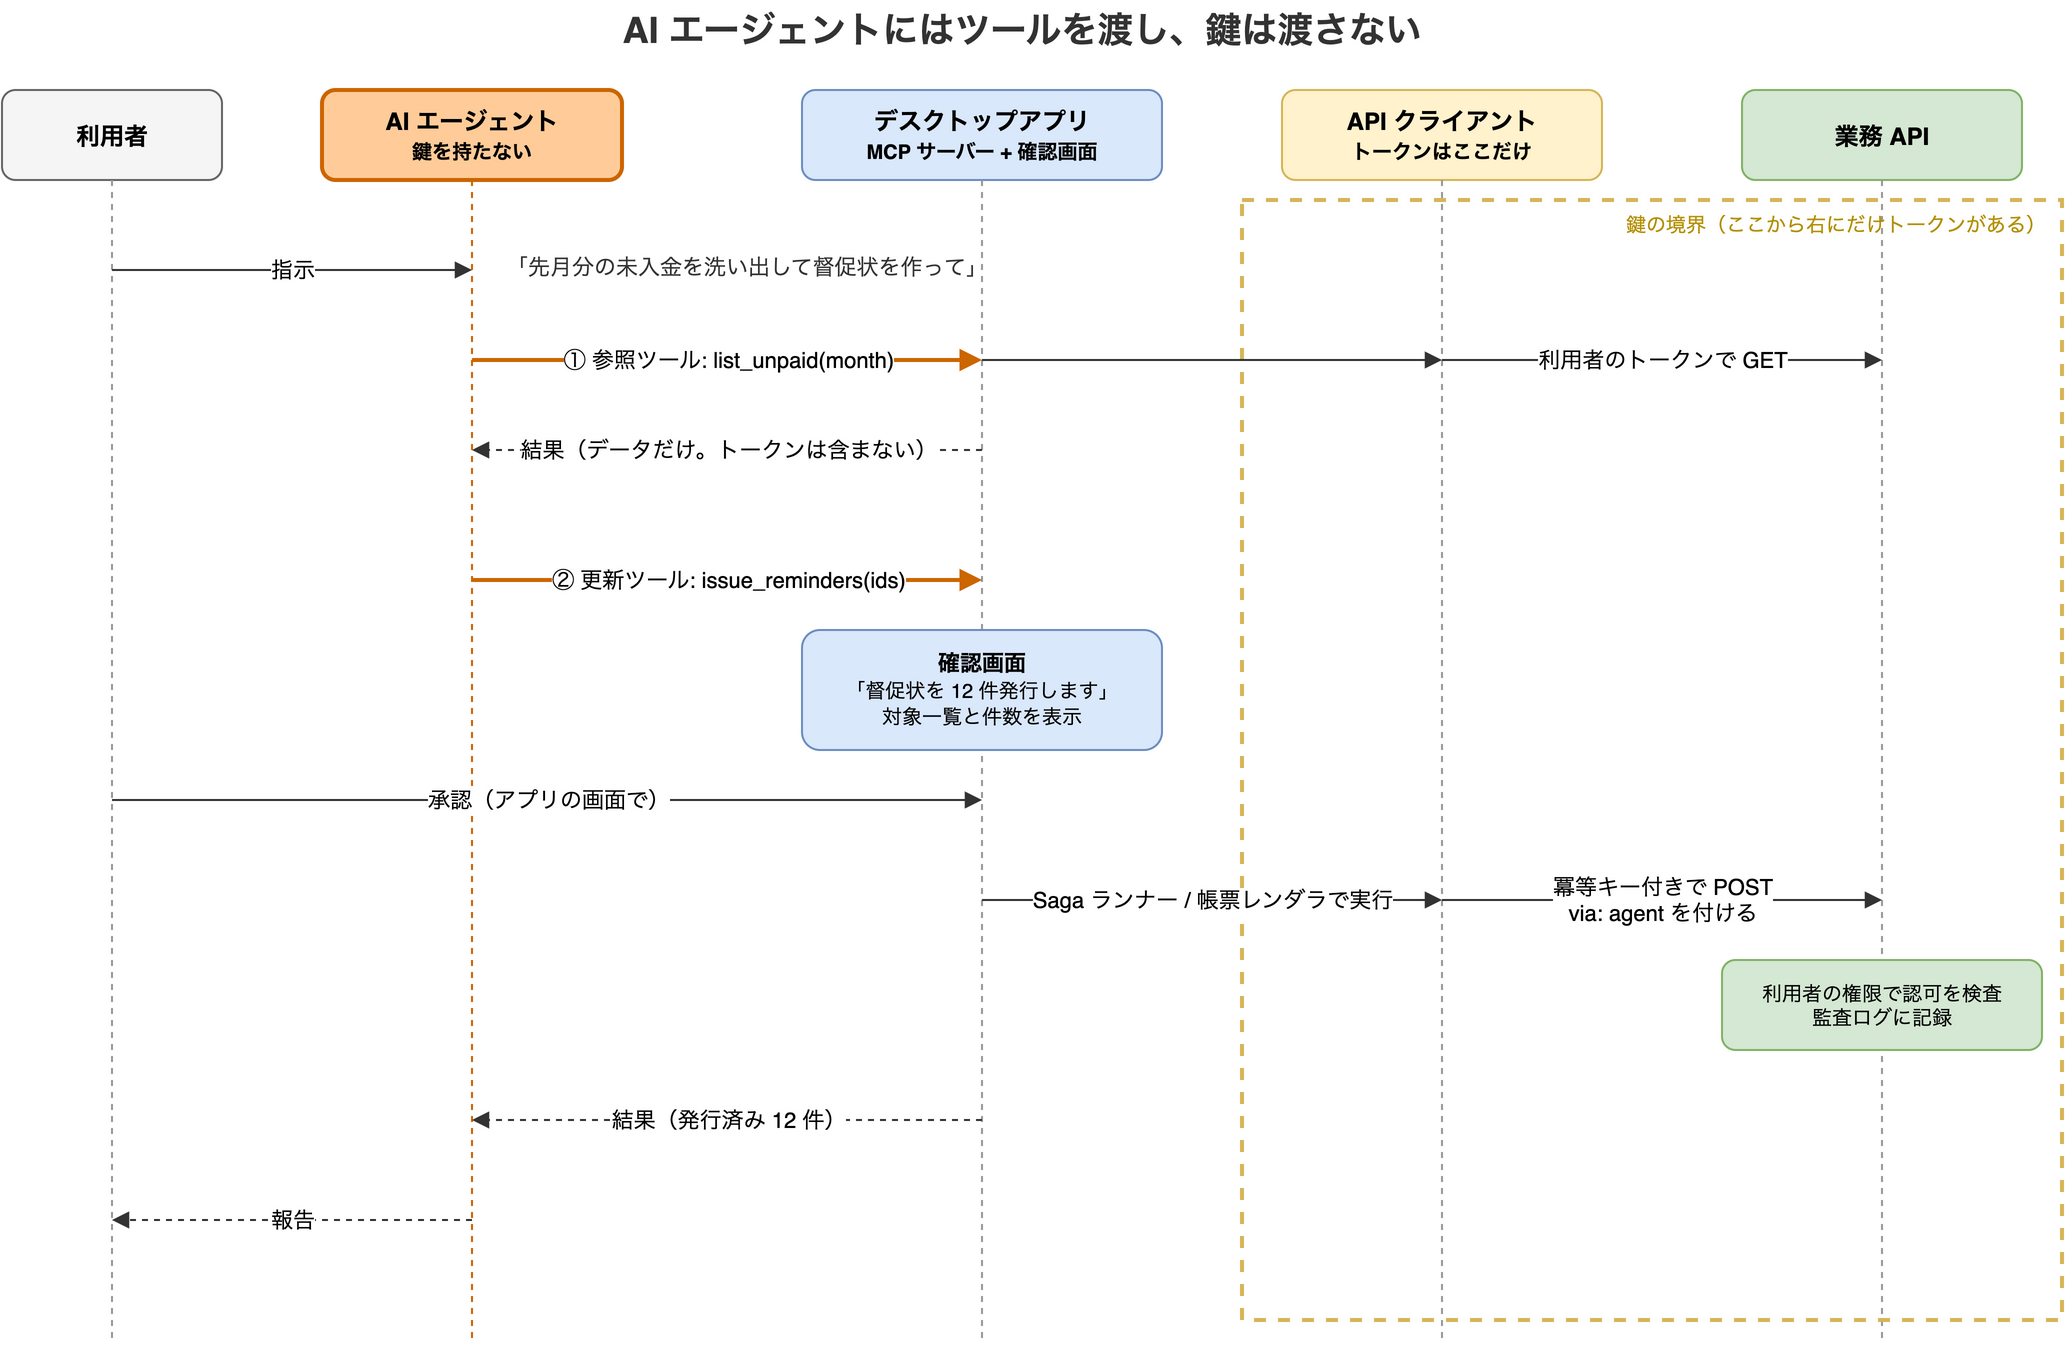
方針 3 で、トークンをアプリの中に閉じ込めました。この形は、AI エージェントに業務を手伝わせるときにも効いてきます。ここでは、API のアクセストークンなどのクレデンシャルをまとめて「鍵」と呼びます。利用者の PC では、Claude Desktop のような AI エージェントがすでに使えるようになっています。そのエージェントに「先月分の未入金を洗い出して督促状を作って」と頼めば、複数の API を組み合わせる面倒な処理を代わりにこなしてくれます。画面を何枚も渡り歩く必要がなくなります。
鍵はアプリの中に閉じ込める
エージェントに API を直接呼ばせようとすると、エージェントにアクセストークンを渡すことになります。トークンが設定ファイルや会話の履歴、ログに残ります。外から取り込んだデータに紛れ込んだ指示(プロンプトインジェクション)で、トークンを外に送らされるおそれもあります。
そこで、アプリが MCP サーバーになり、業務の操作をツールとして公開します。エージェントはツールを呼ぶだけです。API を実際に呼ぶのはアプリの API クライアント(方針 3 のアプリ内 BFF)で、トークンを付けるのもアプリです。エージェントに返るのは結果のデータだけで、トークンは一度もエージェントの手に渡りません。
ツールの設計で守ること
ツールの切り方と、更新の扱いで安全性が決まります。
- ツールは業務の単位で切る。
list_unpaid(month)(未入金の一覧)、issue_reminders(ids)(督促状の発行)のように、業務の言葉でツールを作る。call_api(method, url, body)のような汎用のツールは作らない- 汎用のツールを渡すと、エージェントに利用者のすべての権限を丸ごと渡すのと同じになるため
- 参照と更新を分け、更新はアプリの画面で利用者に確認させる。 更新系のツールが呼ばれたら、アプリが対象の一覧と件数を確認画面に出し、利用者が承認してから実行する。承認はエージェントとの会話ではなく、アプリの画面で行う。エージェントが自分で「承認しました」と言えないようにするため
- 更新は Saga ランナーや帳票レンダラを通す。 エージェントの操作も、画面からの操作と同じ道を通す。冪等キー・補償・突合の保証がそのまま効き、エージェントが同じツールを何度呼び直しても二重に処理されない
- エージェント経由であることを記録する。 API を呼ぶとき、エージェント経由であることを示す印(独自のヘッダーなど)を付け、監査ログで画面からの操作と区別できるようにする
- 認可はサーバーで行う。 エージェントは利用者の権限の範囲でしか動けない。アプリ側でツールを絞っても、最終的な権限の判断は業務 API が行う
- API が返すデータを指示として扱わない。 取引先名や備考欄に、エージェントへの指示に見える文が入っているかもしれない。更新の前にアプリの画面で利用者が確認する仕組みが、ここでも防波堤になる
ローカルの MCP サーバーを守る
MCP では、エージェントとサーバーの間の通信方式(トランスポート)として、標準入出力(stdio)と HTTP(Streamable HTTP)が定められています。クレデンシャルを持つのは常駐しているアプリなので、つなぎ方は 2 通りです。
- stdio: エージェントが小さな中継プロセスを起動し、その中継が OS のプロセス間通信(Unix ドメインソケットや名前付きパイプ)で常駐中のアプリにつなぐ
- localhost の HTTP: アプリ自身が PC の中だけで HTTP を待ち受ける
HTTP で待ち受けるなら、MCP の仕様のセキュリティ上の注意に従います。仕様は Origin ヘッダーの検証を必須とし、localhost での待ち受けと認証を推奨しています。
Originヘッダーを検証する(必須)。ブラウザで開いた悪意のあるページから、DNS リバインディングでローカルのサーバーを呼ばれるのを防ぐ127.0.0.1だけで待ち受ける(推奨)。外部のネットワークからは届かないようにする- 接続に認証をかける(推奨)。PC 上の別のプログラムから勝手に呼ばれないようにする
stdio の中継を使う場合も、中継と常駐アプリの間のプロセス間通信に同じ配慮が要ります。ソケットやパイプを、利用者本人しか開けない権限で作っておきます。
確認用の帳票そのものが減る
エージェントの補助が入ると、帳票の出し方も変わります。今は、確認用の帳票をダウンロードして目で確かめている業務がたくさんあります。たとえば「先月の未入金のうち、30 日を超えているものはあるか」を調べるために、残高一覧を出して眺める、といった使い方です。
こうした確認は、エージェントに聞けば済むようになります。エージェントは参照系のツールでデータを取り、条件に合うものだけを答えます。帳票を出して人が探す手間が省けるうえ、帳票を出す回数そのものが減ります。
帳票の速さが出発点だったこの記事にとって、これは大きな意味を持ちます。
- 確認用の帳票は、速く出す以前に、出さずに済むものが増える。 残るのは、紙で配る・取引先に渡す・保存するといった、形のある帳票が本当に要る場面
- 正式な帳票は残る。 保存や提出が必要なものは、これまでどおり方針 1 の手続きで作る
- 参照系のツールが、帳票の代わりの窓口になる。 確認用の帳票ごとにテンプレートを作り込むより、業務の言葉で問い合わせられる参照ツールを揃えるほうが、効く場面が増える
応用: ソースを読ませて、ヘルプとマニュアルの代わりにする
エージェントにソースコードを読ませると、画面のヘルプや操作マニュアルを別に維持する必要がなくなります。「この画面の『請求残高』はどう計算されている?」「督促の対象になる条件は?」と聞けば、エージェントがソースを読んで答えます。マニュアルは書いた時点から古くなっていきますが、ソースは常に今の動きそのものです。
ただし、次の 4 つは押さえておきます。
- 動いている版のソースを読ませる。 利用者が使っているアプリと API の版に対応するソース(リリースのタグなど)を読ませる。開発中のブランチを読ませると、まだ出ていない機能を説明してしまう
- ここでも鍵を渡さない。 エージェントに git のクレデンシャルを持たせると、方針 4 の原則が崩れる。アプリの MCP サーバーが、その版のソースの読み取り専用のスナップショットを検索ツール(
search_source、read_sourceなど)として公開すれば、エージェントは鍵を持たずにソースを読める - 秘密をソースに置かない。 読ませる範囲(画面、API、設計文書)にパスワードや鍵、社外秘の設定が入っていないことを確かめる。読ませるディレクトリを絞るのも有効
- 「なぜ」はソースの隣に書く。 ソースが教えてくれるのは「どう動くか」までで、「なぜその業務ルールなのか」は書かれていないことが多い。設計判断の記録(ADR)や業務ルールの説明はリポジトリの中に置き、ソースと一緒に読ませる。答えには根拠のファイルを示させると、利用者が確かめられる
手順書が要らなくなるわけではありません。「何をどこに書いておけばエージェントが答えられるか」が変わる、と捉えるのがよいでしょう。マニュアルを別に書いて維持する代わりに、ソースと設計文書をエージェントが読める形に保つことが、ヘルプの保守になります。
アプリの更新と配布をどう考えるか
デスクトップアプリにすると、Web の SPA のように「サーバーに置けば全員が最新になる」わけではなくなります。そこで、変更のたびにアプリを配り直さずに済む部分を増やし、配り直しが必要な部分は自動更新と互換性のルールで管理する、と考えます。
変わりやすいものをアプリの外に出す
どこまでをアプリのバイナリに入れるかで、配布の頻度が決まります。
| 部分 | 置き場所 | 変えたときに再配布が要るか |
|---|---|---|
| 帳票のテンプレート | サーバーから配信(方針 1) | 要らない |
| 接続先・機能フラグ・最低バージョン | サーバーの設定 API から起動時に読む | 要らない |
| 業務ルール・認可 | 業務 API | 要らない |
| 画面(React) | アプリに同梱する(推奨)か、サーバーから読み込むか | 同梱なら要る |
| ネイティブ側(Saga ランナー、帳票レンダラ、API クライアント、MCP サーバー) | アプリのバイナリ | 要る |
画面をサーバーから読み込めば、Web と同じ手軽さで更新できます。ただしその場合、外から読み込んだ画面に、トークンを使う API クライアントなどネイティブ側の機能を呼ばせることになります。Tauri ではリモートの画面に許す権限を設定で絞れますが、「鍵をアプリに閉じ込める」という前提は弱くなります。基本は画面も同梱し、自動更新で配るほうが安全です。
配り直しは自動更新にする
- 自動更新の仕組み: Tauri には公式のアップデーター(updater プラグイン)がある。更新のたびに配布者の鍵で署名し、アプリは署名を検証してから入れ替える。更新情報は静的な JSON ファイルでもよいので、S3 と CloudFront に置くだけで運用できる
- OS のコード署名: macOS は Developer ID での署名と公証(notarization)、Windows はコード署名証明書での署名が要る。署名がないと、OS の警告で利用者が止まってしまう(Windows の SmartScreen は、署名しても配布実績がたまるまで警告が出ることがある)
- 最初の配布: 社内向けなら、Microsoft Intune や Jamf などの MDM で配ると、最初のインストールと更新の強制を情報システム部門が管理できる
アプリと API の版のずれを管理する
全員が同時に更新するとは限らないので、古い版のアプリが残る前提で考えます。
- API は後方互換を基本にする。 項目の追加はしても、削除や意味の変更はしない。互換を壊す変更は、新しいエンドポイントを作って並べる
- 最低バージョンを決めて強制する。 アプリはリクエストごとに自分の版をヘッダーで送る。サーバーは最低バージョンより古ければ、更新を求めるエラー(
application/problem+jsonのtypeで種類を表す)を返す。アプリは起動時にも設定 API から最低バージョンを読み、古ければ更新を促す - 途中の Saga を壊さない。 更新の直前に、途中の Saga が残っていることがある。Saga の定義には版を付け、開始したときの版のまま最後まで進める(進行中の Saga のステップの意味を書き換えない)。ローカルの Saga ログの形を変えるときは、移行処理をアプリに入れる
- エージェント向けのツールとソースも版に揃える。 MCP で公開するツールの定義も、エージェントに読ませるソースのスナップショットも、アプリの版と一緒に変わる。方針 4 のとおり「動いている版」に揃える
段階的に出す
- 先行グループから配る。 更新情報の配信先を分け、まず一部の利用者に出し、問題がなければ全員に広げる
- 戻すときは、より新しい版として出す。 Tauri のアップデーターは、既定では今より新しい版にしか更新しない(ダウングレードは許可されない)。不具合で戻すときは、前の版の中身を新しい版番号で出し直すのが確実
- 機能フラグで逃がす。 新しい機能はサーバーの設定で有効・無効を切り替えられるようにしておけば、配り直さずに止められる
利用者が社内の数十〜数百人程度の業務システムなら、MDM と自動更新、それに最低バージョンの強制で十分に回ります。
段階的な移行の進め方
すべてを一度に作り替える必要はありません。利用者を待たせている帳票から順に進めるのがおすすめです。
- 今の遅さを分解して測る: キューでの待ち時間、タスクの起動時間、帳票の生成時間、生成中のメモリのピークを分けて集計する
- サーバー側の応急処置を入れる: 帳票専用のキューに分け、同時実行数を 1 件あたりのメモリから逆算して絞る。メモリ不足で落ちるのを止める
- デスクトップアプリを用意する: 既存の React の画面をデスクトップアプリの WebView に載せ、API の呼び出しとトークンの保管をネイティブ側の API クライアントに移す。コード署名、自動更新、最低バージョンの強制は、最初の配布の前に揃えておく
- 帳票をクライアント生成に移す: まずは保存の要らない確認用の帳票から移す。テンプレートの配信だけで始められ、出す回数が多いので効果も大きい。正式な帳票は、件数と合計の突合と監査ログを揃えてから移す
- 業務 API の約束事を入れる: 冪等キー、補償 API、有効期限つきの仮状態、
application/problem+jsonを順次入れる。司令塔をどこに置く場合でも必要になる - Saga を 1 つデスクトップアプリに移す: Saga ログと再開の仕組みを作り、最も事故が多い業務フローから移す。期限切れを解放する定期処理も同時に入れる。待ち時間への不満が大きい一括ファイル取り込みは、最初の題材に向いている
- サーバーを縮める: 帳票用のワーカーと帳票ごとのタスク起動を外し、業務 API のタスクサイズを下げる。ブラウザの画面がなくなれば、BFF も外せる
- AI エージェント向けのツールを公開する: まず参照系のツールと、動いている版のソースを検索するツールから始める。更新系のツールは、確認画面と監査の印を揃えてから足す
最後まで残った無人バッチや外部システム起点の処理だけを、SQS + ワーカーや Step Functions で扱います。
まとめ
- 帳票が遅いのは、メモリ不足と起動待ちの板挟みだから。 常駐ワーカーで作れば同時リクエストで落ち、帳票ごとにタスクを起動すれば待たされる。サーバー側だけで解くと、ピークに合わせてサーバーを用意し続けることになる
- 帳票はクライアントで生成する。 メモリ不足も起動待ちもサーバーから消え、PC の複数コアで並列に作れる。サーバーはデータとテンプレートを返すだけにする。突合して保管するのは保存が必要な正式な帳票だけで、1 日に何度も出す確認用の帳票は PC で表示して終わる。正式な帳票の正本性は「決定論的なレンダラとフォントの同梱」「API からの入力とサーバーでの突合」「テンプレートのサーバー配信」で担保する
- 長い処理は 1 件単位の冪等 API に分解する。 クライアントがループで呼び、最後にサーバーが件数と合計を突合して確定する
- Saga の司令塔もデスクトップアプリに置ける。 ブラウザのタブとは違い、進み具合をローカルに保存して再起動後に再開できる。サーバーには冪等キー・補償 API・有効期限つきの仮状態を持たせ、PC が戻らなくても壊れないようにする
- 一括ファイル取り込みも PC で回す。 解析と検証は PC で済ませ、エラーは送る前に見せる。チャンクを仮で送って最後に一括で確定し、中止や失敗はまとまりごと取り消す。進捗が見えるので、利用者のストレスが下がる
- 入口(BFF)もアプリに組み込める。 トークンの保管、接続先への振り分け、読み取りの集約はネイティブ側が担い、CORS も関係なくなる。サーバーに残るのは ALB などのネットワークの入口と、各業務 API での認可の検査
- AI エージェントにはツールを渡し、鍵は渡さない。 アプリが業務の操作を MCP のツールとして公開し、クレデンシャルはアプリに閉じ込める。更新はアプリの画面で利用者が確認してから実行する。確認用の帳票を出して目で探していた業務はエージェントに聞けば済むようになり、帳票を出す回数そのものが減る。動いている版のソースを読ませれば、ヘルプやマニュアルの保守を、ソースと設計文書の保守に置き換えられる
- 更新と配布は「外に出す」と「自動更新」で考える。 テンプレート・設定・業務ルールはサーバーに置いて配り直しを減らし、バイナリは署名付きの自動更新で配る。古い版が残る前提で、API の後方互換と最低バージョンの強制で版のずれを管理する
- 業務 API の約束事を社内標準として明文化する。 冪等キー、補償 API、有効期限つきの仮状態、
application/problem+json、相関 ID。司令塔をクライアントとサーバーのどちらに置いても、これが共通の土台になる - サーバーに残すのは、利用者の PC では動かせないものだけ。 無人バッチや外部システム起点の処理は、SQS + ワーカーや Step Functions で扱う
分散したサービスの前に立つクライアントの設計で大事なのは、サーバーとクライアントのどちらが何を担うかを、速さ(重い処理をどこで走らせるか)と中断への強さで決めることです。ブラウザのタブは中断に弱いので、調整を任せられません。一方、状態を保存できるデスクトップアプリなら、サーバーが「壊れない約束事」を守っている限り、計算と調整を任せられます。帳票を速く出しつつ、サーバーも小さく保てます。さらに、鍵をアプリの中に閉じ込めておけば、AI エージェントにも安全に業務を任せられます。