社内の業務システムに「利用者がチャットで質問すると、システムのデータを調べて答えてくれる」機能を付けたい、という要件はよくあります。「この案件の今月の原価は?」「先月の入金はいくら?」といったデータ照会型の問い合わせです。
真っ先に思い付くのは Text-to-SQL です。NVIDIA Auto Ontology のように、DB のメタデータからオントロジーを作り、LLM に正確な SQL を書かせる仕組みも出てきました。
しかし、会計や原価管理のような利用者ごとに見える範囲が決まっている業務システムでは、Text-to-SQL をそのまま中核に据えるのはおすすめできません。この記事では、ある社内の会計・原価管理システムへの組み込みを検討したときの分析をもとに、その理由と代わりに選ぶべき構成を整理します。なお、システム固有の情報は一般化しています。結論は、既存の業務ロジックを照会専用のツールとして LLM に呼ばせる構成(Function Calling / Tool Use)を中核にし、管理本部や監査担当など許可された役割にだけ Text-to-SQL を開放するハイブリッド運用です。
前提:想定する業務システム
検討の対象は、次のような典型的な社内業務システムです。
- Python の Web フレームワーク(Django など)で作られ、DB は MySQL
- 利用者は複数の事業所・部署に属し、自分の事業所のデータだけが見える(オブジェクト単位・行単位の権限制御)
- 帳票や集計の数字は、アプリのコードで計算している。同じ指標に複数の計算経路があることもある
- マスタ用と業務用など、DB が複数に分かれている
- 画面のほかに REST API や GraphQL API を持っている
問い合わせの中身は「操作方法」ではなくデータの照会が中心、という条件で考えます(操作方法の質問なら、マニュアルや仕様書を元にした RAG のほうが向いています)。
データ照会チャットボットの 2 つの構成
データ照会チャットボットの作り方は、大きく 2 つに分かれます。
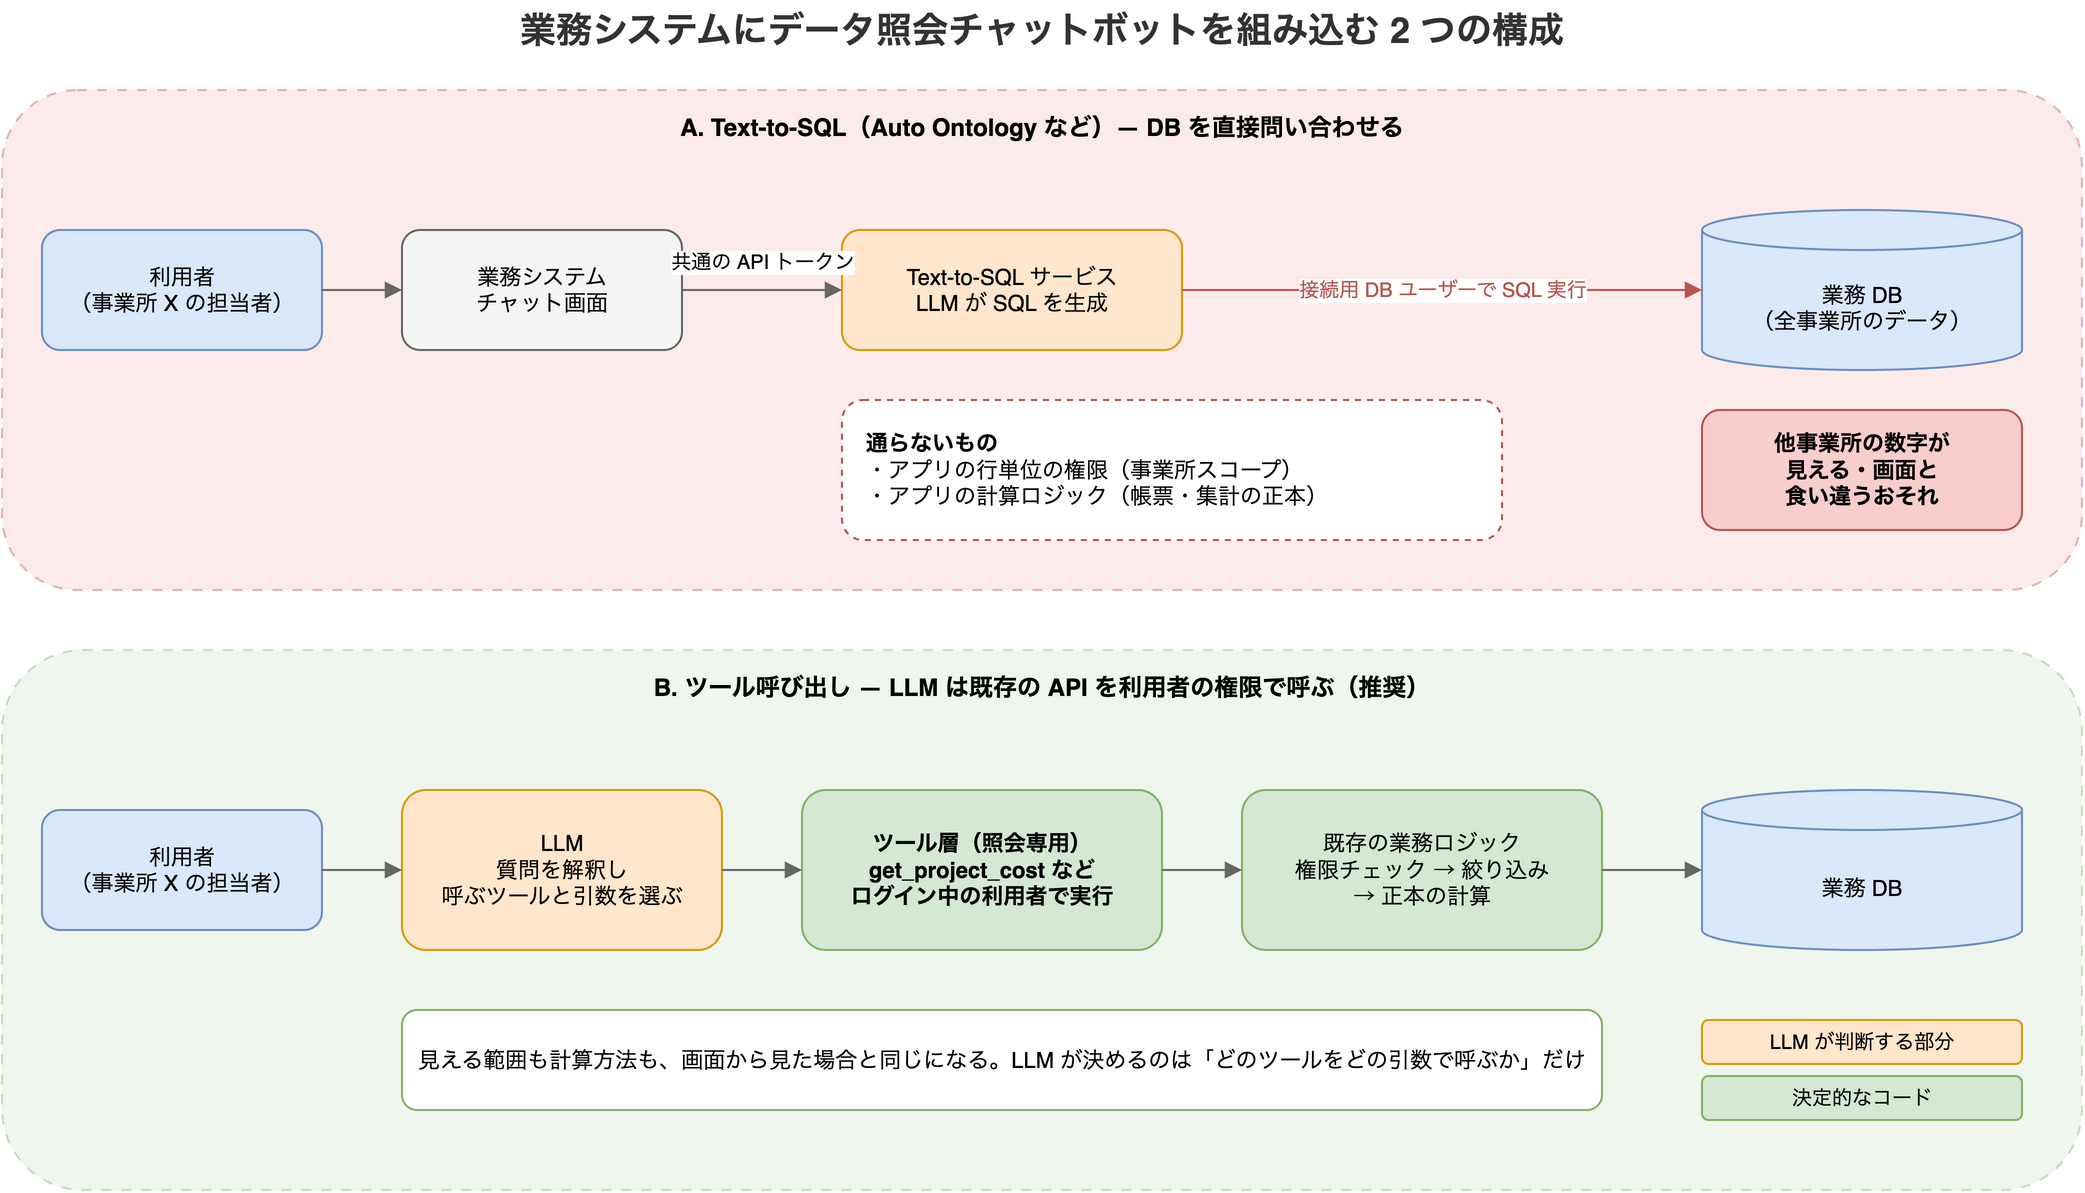
- A. Text-to-SQL:LLM が質問から SQL を生成し、DB に直接実行します。Auto Ontology のようなツールで精度を高めます。
- B. ツール呼び出し(Function Calling / Tool Use):アプリ側に「照会用の関数(ツール)」を用意し、LLM にはどのツールをどの引数で呼ぶかだけを決めさせます。ツールはログイン中の利用者として既存の業務ロジックを呼びます。
結論から言うと、この種の業務システムでは B を中核に据えるべきです。ただし A が要らなくなるわけではなく、後半で述べるように役割を限って併用します。以下、A を中核にしたときの問題点から見ていきます。
Text-to-SQL を中核にしたときの問題
1. 行単位の権限を守れない(最大の問題)
業務システムの権限は、たいていアプリの中で実装されています。Django なら django-rules や django-guardian のようなオブジェクト単位の権限、あるいはクエリセットを利用者の所属で絞り込む実装です。
Text-to-SQL サービスは、このアプリを通りません。接続に登録した DB ユーザーの権限で SQL を実行します。Auto Ontology の場合、接続ごとに絞り込めるのはスキーマとテーブルの単位(許可リストと正規表現)までで、ドキュメントには行単位の制御が示されていません。
さらに、Auto Ontology の API トークンは持ち主の権限で動きます。アプリから 1 つのトークンで呼ぶと、全利用者が同じ権限で問い合わせることになります。結果として、事業所 X の担当者が事業所 Y の数字を聞けば、答えが返ってしまうおそれがあります。会計データでは致命的です。
DB 側で防ぐ手もありますが、MySQL には PostgreSQL の行レベルセキュリティ(Row Level Security)に相当する機能がありません。事業所ごとにビューと DB ユーザーを作り、接続も分ける必要があります。事業所や権限の組み合わせが増えるほど破綻しやすく、現実的ではありません。
2. 「正しい数字」の正本がアプリのコードにある
帳票や集計の数字は、SQL 一発ではなく、アプリのコードで計算していることが多いはずです。締め処理、端数処理、取消・訂正の扱い、計算経路の使い分けなどが、モデルのメソッドやサービス層に入っています。
Text-to-SQL でこれを再現するには、同じ計算を SQL(Auto Ontology なら SQL 属性)として書き直す必要があります。しかし二重管理になり、チャットの答えと画面の数字が食い違うリスクを抱え続けます。利用者から見れば「チャットは間違った数字を言う」ことになり、信頼を失います。
3. データが外部に出る(Auto Ontology の場合)
Text-to-SQL サービスは、スキーマの情報や列のサンプル値、質問文を LLM に渡します。Auto Ontology の既定構成では、推論は NVIDIA のクラウド(NVIDIA API カタログ)に送られます。会計データを扱うなら、セルフホストのモデルか、社内で承認された推論エンドポイントへの切り替えが前提になります。
4. 別のシステムを丸ごと運用することになる(Auto Ontology の場合)
Auto Ontology は、Next.js のゲートウェイ、FastAPI のバックエンド、取り込みサービス、PostgreSQL(pgvector)からなる独立したスタックです。業務システムとは別に、認証・バックアップ・監視・アップデートを回す必要があります。また Vault を使わない場合、接続用の DB パスワードは PostgreSQL に平文で保存されます。DB が複数に分かれている場合に、DB をまたいだ結合をどこまで扱えるかも事前に確かめておく必要があります。
加えて、生成された SQL が更新系にならないよう、接続には読み取り専用の DB ユーザーを用意しておく必要があります。
推奨:既存の業務ロジックを照会ツールとして LLM に呼ばせる
B の構成では、LLM に SQL を書かせません。アプリ側に照会用のツールを用意し、LLM には「どのツールを、どの引数で呼ぶか」だけを決めさせます。ツールの中身は、アプリ内部のサービス層やモデルのメソッドを直接呼んでも、既存の REST API を呼んでもかまいません。要は、画面と同じ権限チェックと計算ロジックを通ることです。
なぜこれで問題が解けるのか
| 問題 | Text-to-SQL(A) | ツール呼び出し(B) |
|---|---|---|
| 行単位の権限 | DB ユーザーの権限で実行され、アプリの権限を通らない | ツールがログイン中の利用者として動くので、画面と同じ範囲しか見えない |
| 数字の正しさ | 計算を SQL で書き直す必要があり、画面と食い違うおそれ | 画面と同じ業務ロジックで計算する |
| 書き込み | 読み取り専用の設定に頼る | 照会用のツールしか用意しなければ、そもそも書き込めない |
| 外部に出るデータ | スキーマ、サンプル値、質問文 | 質問文と、ツールが返した結果だけ |
| 運用 | 別スタックが増える | 業務システムの中に収まる |
要は、LLM の担当を「質問の意味を理解して、適切な照会を選ぶこと」に絞り、権限と計算という間違えてはいけない部分を、すでにテストされた既存のコードに任せるということです。
ツールの設計例
ツールは、利用者がよく聞く質問から逆算して作ります。たとえば「案件の月次原価」を返すツールなら、LLM に渡す定義は次のようになります。JSON Schema で引数を定義する点は主要な LLM の API で共通ですが、外側のキー名は API ごとに異なります(以下は Anthropic の input_schema 形式です。OpenAI や Gemini では parameters です)。
{
  "name": "get_project_cost",
  "description": "指定した案件の、指定した月の原価の内訳を返す。案件コードが分からない場合は、先に search_projects で検索すること。",
  "input_schema": {
    "type": "object",
    "properties": {
      "project_code": {
        "type": "string",
        "description": "案件コード(例: A-000123)"
      },
      "month": {
        "type": "string",
        "description": "対象月(YYYY-MM 形式)"
      }
    },
    "required": ["project_code", "month"]
  }
}ツールの実装側では、必ずログイン中の利用者を受け取り、既存の権限と計算ロジックを通します。定義に user がないのは意図的です。利用者は LLM が決める引数ではなく、アプリがリクエストのログインユーザー(Django なら request.user)から渡します。LLM に利用者を選ばせてはいけません。
Django なら、次のようなイメージです(モデル名やメソッド名は説明用の仮のものです)。
def get_project_cost(user, project_code: str, month: str) -> dict:
    # 利用者の権限で見える案件だけに絞り込む(画面と同じクエリセット)
    project = Project.objects.visible_to(user).filter(code=project_code).first()
    if project is None:
        # 「存在しない」と「権限がない」を区別しない
        return {"error": "該当する案件が見つかりません"}

    # 画面や帳票と同じ計算ロジックを使う
    summary = project.cost_summary(month)
    return {
        "project_code": project.code,
        "month": month,
        "total": summary.total,
        "breakdown": summary.breakdown,
        "url": project.get_absolute_url(),  # 回答に画面へのリンクを添えられる
    }


# LLM が返したツール呼び出しを、ログイン中の利用者付きで実行する
TOOLS = {"get_project_cost": get_project_cost}

def run_tool(request, name: str, args: dict) -> dict:
    if name not in TOOLS:  # 用意したツール以外は実行しない
        return {"error": f"unknown tool: {name}"}
    args = {k: v for k, v in args.items() if k != "user"}  # 利用者を LLM に指定させない
    try:
        return TOOLS[name](request.user, **args)
    except TypeError:  # 引数の過不足は、エラーとして LLM に返す
        return {"error": f"invalid arguments for {name}"}
既存の REST API がそのまま使えるなら、ツールの中でログイン中の利用者の資格情報を使って API を呼ぶ形でもかまいません。ただし、REST API と GraphQL API で権限チェックの仕組みが違うこともあります。ツールが通る経路で絞り込みが効いているかを確かめておきましょう。
設計で押さえておきたいこと
- 照会専用にする:書き込み系のツールは用意しません。業務システムの登録・更新には、承認フローや整合性チェックなどの副作用が伴うことが多く、チャットから呼ぶべきではありません。
- 利用者を必ず引き継ぐ:ツールの実行者を、サービスアカウントではなくログイン中の利用者にします。ここが崩れると、A と同じ問題が起きます。
- 権限エラーを情報源にしない:「存在しない」と「見る権限がない」を同じ応答にして、他事業所の案件の存在を推測させないようにします。
- 結果の件数と大きさを絞る:一覧系のツールは件数の上限を設け、LLM に渡すデータ量(=外部に出るデータ量)を抑えます。
- 根拠を返す:結果に画面へのリンクや対象期間を含め、回答に添えさせます。利用者が画面で数字を確かめられます。
- ログを残す:質問、呼ばれたツール、引数、結果を記録し、誤答の調査と改善に使います。
- 答えられない質問を決めておく:用意したツールで答えられない質問には、無理に推測させず「この質問には答えられない」と返すよう、システムプロンプトで指示します。
- 評価用の質問集を作る:よくある質問と正解の組を用意し、ツールやプロンプトを変えるたびに回して確かめます。
ツールの数が増えすぎたら
最初は「よく聞かれる質問」の上位から 5〜10 個のツールで始め、ログを見て足していくのが現実的です。数十個に増えて LLM の選択精度が落ちてきたら、ツールを業務領域ごとにまとめる、検索系と詳細系に分けるといった整理をします。
ここで役に立つのが、オントロジーの考え方です。「案件」「原価」「入金」といった業務用語の定義と同義語、用語どうしの関係をまとめた用語集があれば、ツールの説明文(description)を正確に書けます。LLM が「コスト」や「経費」と聞かれたときに、「原価」のツールを呼べばよいと判断しやすくなります。Text-to-SQL を使わなくても、オントロジーで業務の意味を整理しておく価値は変わりません。
ツール呼び出しだけでは足りない利用者がいる
ツール呼び出しは「よく聞かれる質問」には強い一方、用意したツールの範囲でしか答えられません。これが問題になるのが、管理本部や内部監査のような、業務監査に近い仕事をする担当者です。
こうした担当者の問い合わせは、たとえば次のようなものです。
- 起票者と承認者が同じ伝票を抽出したい
- 締め処理のあとに修正された伝票を、期間と部門をまたいで洗い出したい
- 取引先マスタの重複や、使われていない取引先を探したい
- 受注・発注・請求・入金の金額が、案件ごとに突き合うかを確かめたい
どれも毎回条件が違う、一度きりの複雑な問い合わせです。API やツールを先回りして用意しきることは現実的ではありません。
一方で、こうした担当者は全社のデータを閲覧する権限をもともと持っていることが多いはずです。そうした役割に限れば、Text-to-SQL の最大の問題だった「行単位の権限を通らない」は問題になりません。ただし、監査担当でも子会社や機密部門のデータは見られない、といった制限がある組織では、この前提が崩れます。開放する前に、その役割が本当に全データを見てよいかを確かめてください。
推奨:利用者の役割で使い分けるハイブリッド運用
そこで、実際の運用はツール呼び出しを中核にしつつ、許可された役割の利用者にだけ Text-to-SQL を開放するハイブリッドにするのが現実的です。
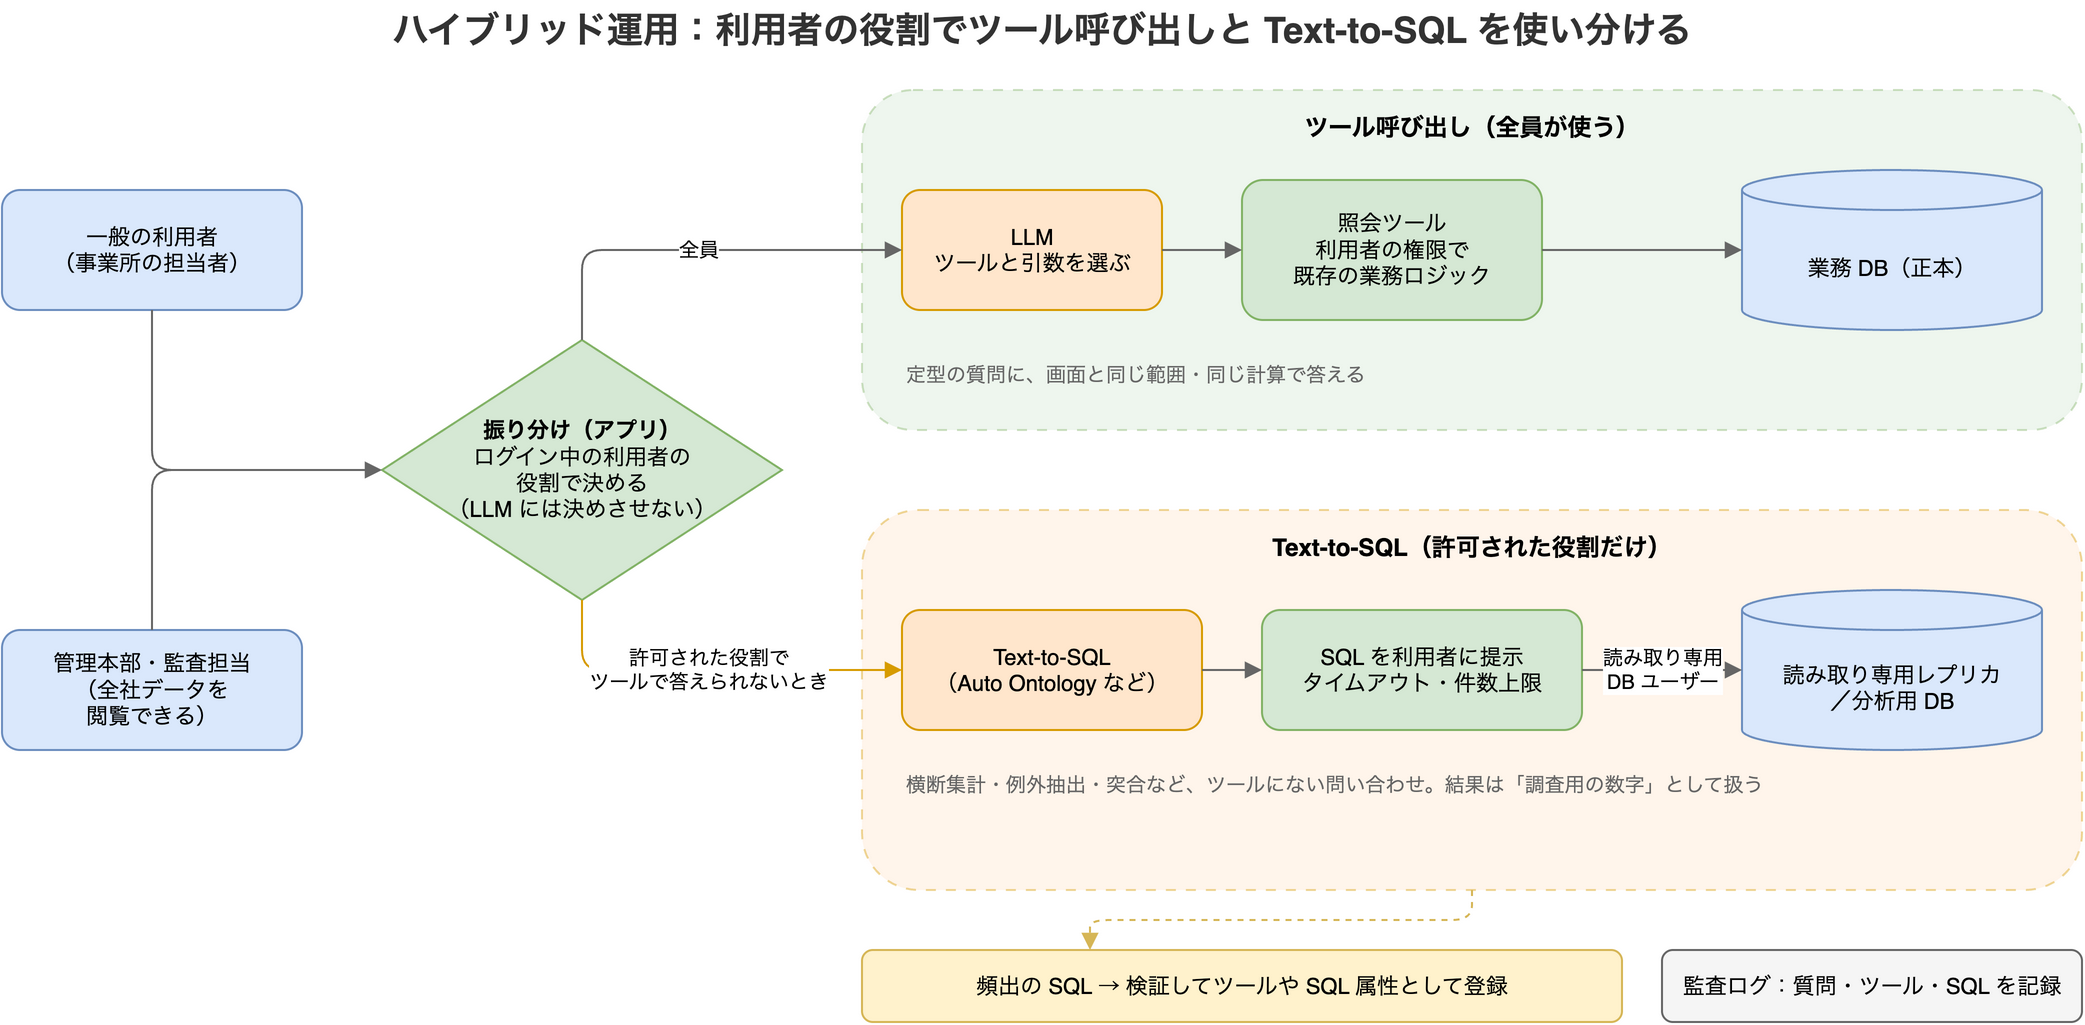
| 利用者 | 主な問い合わせ | 方式 | 問い合わせ先 |
|---|---|---|---|
| 一般の利用者(事業所の担当者) | 自分の案件や部署の数字 | ツール呼び出しのみ | 業務 DB(アプリの権限と計算を通す) |
| 管理本部・監査担当 | 上記に加えて、横断集計・例外抽出・突合 | ツール呼び出しを優先し、答えられないときに Text-to-SQL | 読み取り専用のレプリカ/分析用 DB |
ハイブリッドで押さえておきたいこと
- 振り分けはアプリが役割で決める:チャット画面は業務システムの中にあるので、バックエンドはログイン中の利用者とその権限を知っています。Text-to-SQL を使えるかどうかは、その権限で判定します(下の例を参照)。LLM に「この質問は SQL で答えるべきか」を判断させて権限を広げてはいけません。
- ツールを優先する:許可された利用者でも、ツールで答えられる質問はツールで答えます。正本の計算を通した数字を返せるからです。Text-to-SQL は、ツールで答えられないときの受け皿にします。
- 本番の DB と切り離す:Text-to-SQL は読み取り専用のレプリカか分析用 DB に、読み取り専用の DB ユーザーでつなぎます。重いクエリが本番の画面を遅くしないよう、タイムアウトと件数の上限も設けます。
- SQL を必ず見せる:監査の仕事では、答えの数字よりも「どう数えたか」が重要です。生成された SQL と、どの用語・結合を使ったかを答えに添えます(Auto Ontology は回答に SQL と実行した手順を添えて返します)。
- 調査用の数字として扱う:Text-to-SQL の結果は帳票の正本ではありません。画面や帳票の数字と食い違ったら、その食い違い自体が調べる対象です。正式な数字は正本で確かめる運用にします。
- 頻出の問い合わせを API に置き換える:何度も来る要求は、開発者が決定論的な API にしてツールとして組み込みます。これがハイブリッド運用の本体なので、次の節で詳しく述べます。
- 監査ログを残す:誰が何を聞き、どの SQL が実行されたかを記録します。全社データを横断できる機能なので、監査担当者自身の利用も後から確かめられるようにしておきます。
- 外部送信の条件は同じ:Text-to-SQL ではスキーマやサンプル値も LLM に渡るので、推論先はセルフホストのモデルか、社内で承認されたエンドポイントにします。
振り分けの実装例
振り分けは、チャットのバックエンドで数行の分岐として書けます。Django なら、Text-to-SQL を使える独自の権限をモデルの Meta.permissions で 1 つ定義し、管理本部や監査担当のグループにだけ付与しておきます(関数名や権限名は説明用の仮のものです)。なお、有効なスーパーユーザーは has_perm が常に真になるので、スーパーユーザーのアカウントの扱いにも注意します。
def answer(request, question: str) -> dict:
    # まず全員、ツール呼び出しで答えを試みる
    result = answer_with_tools(request, question)
    if result["answered"]:
        return result

    # ツールで答えられず、かつ許可された役割のときだけ Text-to-SQL に回す
    # 判定はログイン中の利用者の権限で行い、LLM には決めさせない
    if request.user.has_perm("chatbot.use_text_to_sql"):
        return ask_text_to_sql(request.user, question)

    return {"answered": False, "message": "この質問には答えられません。担当部署にお問い合わせください。"}
ask_text_to_sql の中で Text-to-SQL サービスを呼ぶときは、誰の問い合わせかが監査ログに残るようにします。Auto Ontology の場合、API トークンは持ち主として動くほか、信頼された呼び出し元が転送する SSO の ID トークンでも利用者を識別できます。共通のトークン 1 つで全員分を呼ぶと、Auto Ontology 側の会話履歴はすべてトークンの持ち主のものになり、誰の問い合わせか区別できなくなります。少なくともアプリ側のログに利用者を残しておきます。
導入前の準備:過去の問い合わせ事例からオントロジーを作る
ツールの設計にも Text-to-SQL の精度にも、業務用語の定義(オントロジー)が効きます。では、それを導入前にどう作るか。既存の仕様書・画面・バックエンドのコードを網羅的に分析してグラフ化する、という方法も考えられますが、すべてを対象にすると終わりません。
利用者からの問い合わせを課題管理で受けているなら、過去の問い合わせ事例を起点にし、コードと仕様書は裏付けに使うのが効率的です。
需要側から始め、供給側で裏付ける
コードと仕様書が表すのは「システムが何を持っているか」(供給側)です。問い合わせ事例が表すのは「利用者が何を知りたいか」(需要側)です。需要側で対象を絞ってから、供給側で正しい定義を確かめます。
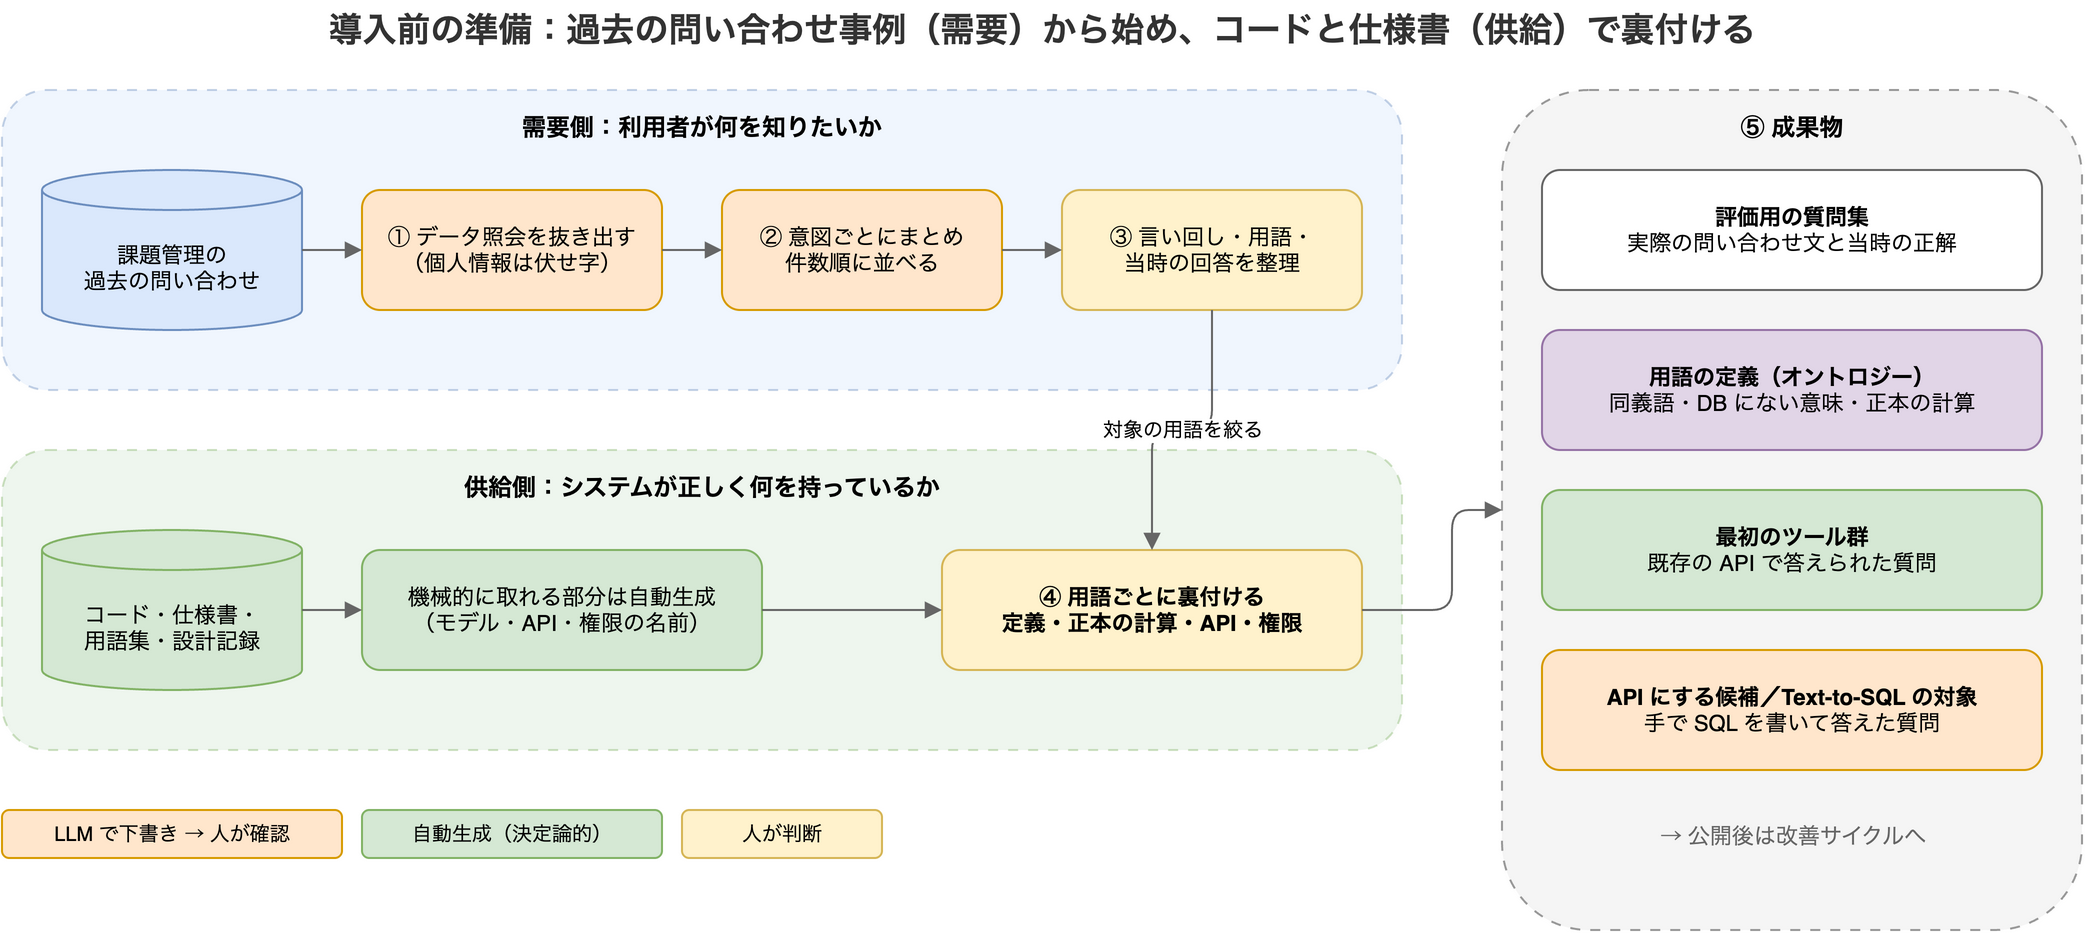
過去の問い合わせ事例からは、次のものが取れます。
| 取れるもの | 使い道 |
|---|---|
| 利用者が実際に使う言い回し(「現場の原価」「今月の入り」など) | 用語の同義語。LLM がツールや用語を正しく選べるようになる |
| よく聞かれる質問とその頻度 | どの用語・ツールから作るかの優先順位 |
| 担当者がどう答えたか(実行した SQL、案内した画面、使った API) | 正解つきの評価用の質問集。検証済みの SQL はツールにする候補 |
| 利用者の誤解や、あいまいだった点 | 用語の定義に書くべき注意点。チャットボットが聞き返すべき場面 |
特に「担当者が手で SQL を書いて調べた」事例は、チャットボットを入れる前の時点で、後述する改善サイクルの「記録する」段階がすでに済んでいるのと同じです。
コードと仕様書で「DB にない意味」を補う
Auto Ontology がオントロジーの草案を作る材料は、DB のメタデータ・サンプル値と、DB が公開していればクエリ履歴です。しかし業務システムで本当に大事な意味は、DB ではなくコードと仕様書の中にあります。
| DB からは読めない知識 | どこにあるか |
|---|---|
| 「締め済み」「有効な契約」などの状態が、どの列のどんな条件で決まるか | モデルのメソッドやクエリの条件 |
| 業務上の一意のキーが、複数の列の組み合わせであること | 用語集・モデル定義 |
| 帳票の数字を、どの関数で計算するのが正本か | サービス層・帳票のコード |
| 論理削除の扱い(行は残るが、無いものとして扱う) | 設計記録・モデル |
| その数字を見るのに、どの権限が要るか | 権限の定義 |
絞り込んだ用語ごとに、これらをコードと仕様書から確かめます。結果は、Auto Ontology の用語の説明や SQL 属性として取り込めます(API で編集するか、Ossie YAML でインポートします)。クエリ履歴に条件として現れる一部を除けば、メタデータから作った草案には出てきにくい知識です。また「業務用語 ↔ モデル・項目 ↔ 正本の計算 ↔ API ↔ 画面 ↔ 必要な権限」の対応表があれば、繰り返し来る質問を「実は既存の API で答えられる」とすぐに判断でき、改善サイクルも速く回ります。
進め方
- データ照会の問い合わせを抜き出す:課題から、操作方法の質問やバグ報告ではなく、データ照会の問い合わせを分類します(LLM で下書きし、人が確かめます)。
- 意図ごとにまとめて、件数順に並べる:似た問い合わせをまとめ、上位から対象にします。
- まとまりごとに整理する:利用者の言い回し、関係する業務用語、当時の回答(SQL・画面・API)を記録します。
- コードと仕様書で裏付ける:モデルと項目、URL のルーティング、権限の名前やビューに付けた権限クラスのように機械的に取れる部分は、フレームワークのイントロスペクションで自動生成します(Django ならモデルの
_metaや URL リゾルバーから取り出せます)。誰にどの権限を与えるか、ビューの中でどんな条件を確かめているかといった実際の権限の規則は、イントロスペクションでは取れないので、コードを読んで補います。用語の定義や状態の意味、正本の計算は、用語集や仕様書をもとに下書きし、人が確かめます。 - 成果物を分ける:評価用の質問集、用語の定義、最初のツール群(既存の API で答えられた質問)、API にする候補と Text-to-SQL の対象(手で SQL を書いて答えた質問)の 4 つです。
注意点
- 個人情報・取引先名:課題には利用者名・取引先名・金額が含まれます。LLM に渡す前に伏せ字にします。推論先の条件もこれまでと同じです。
- 古い事例:仕様変更の前の問い合わせは、当時の回答が今では正しくないことがあります。日付と仕様の変更履歴を見て、裏付けの段階で確かめます。
- 記録に残らない問い合わせ:電話や口頭で済んだ簡単な質問は課題になっていないので、頻度が実態より低く見えることがあります。公開後のログで補います。
- 事例だけでは定義は決まらない:当時の回答が誤っていた可能性もあります。正しさの根拠は、あくまでコードと仕様書に置きます。
- 陳腐化を防ぐ:コードを正本、オントロジーは派生物と位置づけ、自動で作り直せる部分を最大にします。最初からグラフ DB を用意する必要はなく、リポジトリに置いた YAML や JSON の対応表で十分です。
- 権限の知識は参照用にとどめる:抜き出した権限の定義でアクセスを制御してはいけません。制御は、これまでどおりアプリの中で行います。
改善サイクル:繰り返される問い合わせを決定論的な API に置き換える
ハイブリッド運用で大事なのは、Text-to-SQL を終着点にしないことです。Text-to-SQL は「まだ API がない問い合わせ」の受け皿にすぎません。
Text-to-SQL は同じ要件でも毎回作り直す
複数の利用者から同じ要件の問い合わせが来ても、Text-to-SQL はそのたびに SQL を生成し直します。Auto Ontology には、別の利用者の過去の質問や回答を再利用して速く答える仕組みはありません。質問のたびに、分類・検索・結合経路・SQL 生成・検査をやり直し、LLM を何度も順番に呼ぶので、典型的には 1 回に数十秒かかります。
過去の記録に関係する仕組みとしては、次のものがあります。
- SQL 属性:レビューした計算式を登録しておくと、エージェントが再利用するので、同じ指標は同じ式で計算されます。DB のクエリ履歴から候補を提案する機能もあります。ただし、SQL 属性があっても回答の各段階は毎回すべて実行されるので、一貫性のための仕組みであって、速くするための仕組みではないと考えたほうがよいでしょう。
- 会話の履歴:同じ会話の中で「では 8 月は?」のような続きの質問を解釈するためのもので、他の利用者とは共有されません。
README は「認定された修正や利用状況をオントロジーに還元する(Learn)」とうたっており、人が直して認定した定義は次回以降も残ります。つまり Auto Ontology は定義を育てることはできますが、個々の回答を使い回すわけではありません。
同じ要件を何度も LLM に生成させ続けると、遅く、推論のコストがかかり、毎回少しずつ違う SQL になるおそれもあります。何度も来る要求は、システム開発者が決定論的な実装として API に組み込むべきです。
問い合わせのログを要求の発見に使う
見方を変えると、Text-to-SQL に回った問い合わせのログは、利用者が本当に必要としている照会の一覧です。これを開発の入力にする改善サイクルを回します。
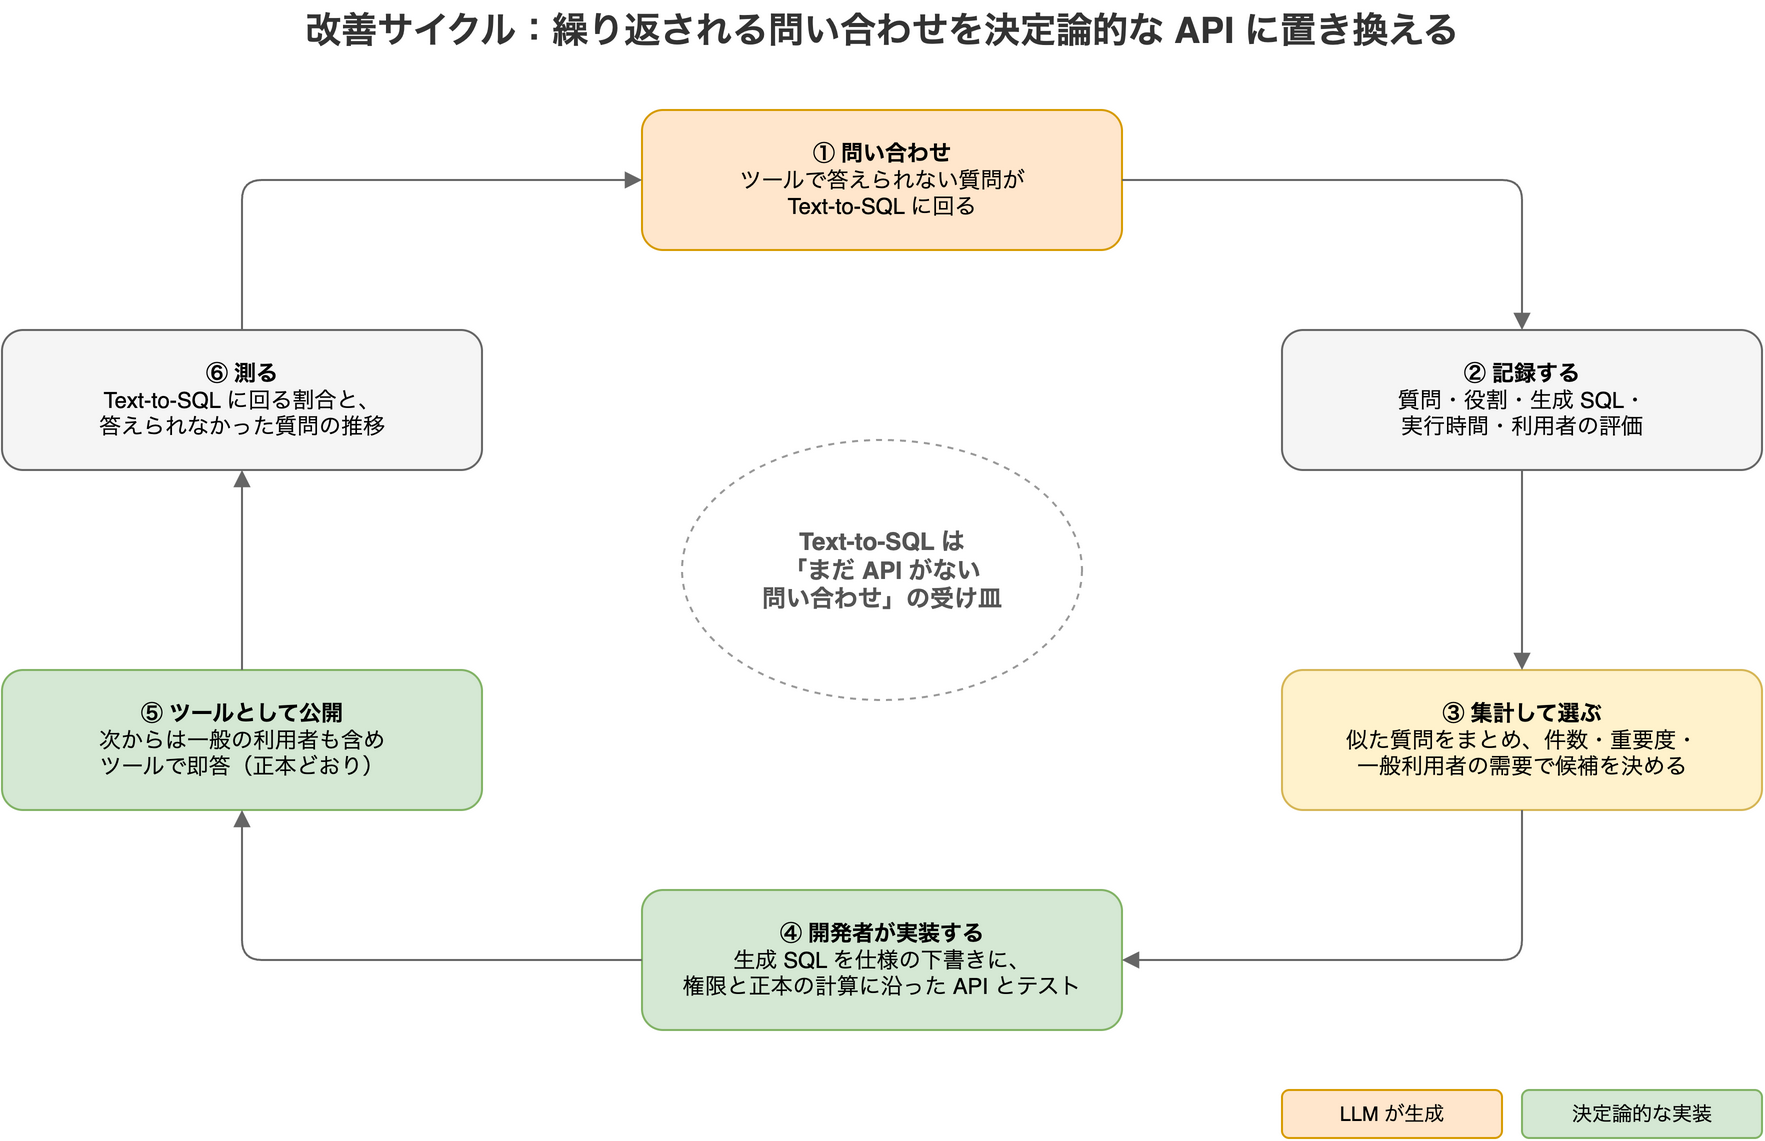
サイクルの起点は、ツールで答えられない質問が Text-to-SQL に回ること(図の ①)です。そこから先を順に見ていきます(図の ②〜⑥)。
- 記録する:質問、利用者の役割、答えた方式(ツールか Text-to-SQL か)、生成された SQL、実行時間、利用者の評価(正しかったか、役に立ったか)を残します。
- 集計して選ぶ:定期的に、Text-to-SQL に回った質問を意図ごとにまとめ(埋め込みで似た質問をまとめると楽です)、件数の多い順に並べます。件数のほか、帳票に関わるなど正しさが重要か、一般の利用者にも需要がありそうかで、API にする候補を決めて開発のバックログに積みます。
- 開発者が実装する:生成された SQL は、仕様の下書きとして使えます。どのテーブルをどう結合し、何を数えたかが具体的に書かれているからです。開発者はそれを参考に、既存の権限チェックと正本の計算に沿って API を実装し、テストを書きます。Text-to-SQL の答えとの突き合わせをテストに含めると、どちらかの誤りに気付けます。
- ツールとして公開する:API を照会ツールとして登録します。次からは監査担当だけでなく一般の利用者も、数十秒ではなく即座に、画面と同じ範囲・同じ計算で答えを得られます。
- 測る:Text-to-SQL に回る割合や、答えられなかった質問の件数がどう推移するかを見ます。サイクルが回っていれば、Text-to-SQL は本当に一度きりの探索に絞られていきます。
API にするまでのつなぎとして、検証済みの SQL をアプリ側で使い回す仕組みを作ることもできます。その場合は、結果ではなく条件を差し替えられる SQL を再利用すること、検証済みのものだけを使うこと、共有は同じ権限の利用者の間に限ることが条件です。検証していない回答を使い回すと、誤りが他の利用者に広がります。
このサイクルを回すと、チャットボットの導入が「LLM に任せきりにする」ことではなく、利用者の要求を拾って業務システムそのものを育てる仕組みになります。
Text-to-SQL の部分は Auto Ontology を使うか、自前で作るか
ハイブリッドの Text-to-SQL 部分を、Auto Ontology で賄うか、同等の機能を自前で作るか。結論から言うと、最初から自前で作るのはおすすめしません。まず Auto Ontology で PoC を行い、実際の問い合わせでの正確さを測ってから決めるのが堅実です。
難しいのは「動く SQL」ではなく「正しい SQL」
スキーマをプロンプトに入れるだけの Text-to-SQL なら、試作はすぐに動きます。しかしそれでは、指標の計算式や結合経路の取り違え、答えられない質問への無理な回答といった問題がそのまま残ります。Auto Ontology が手間をかけているのは、まさにこの部分です。
| 機能 | 自前で作る難しさ |
|---|---|
| メタデータとクエリ履歴からの用語・説明の自動生成 | 高い。テーブルが多いほど手作業では回らない |
| 外部キーの推定と、データによる裏付け | 高い。結合の取り違えを防ぐ肝の部分 |
| 用語・SQL 属性を人がレビューして認定する仕組み(UI を含む) | 中程度 |
| 生成した SQL の検査と修復、結果が空のときのフィルタ値の確認 | 中〜高 |
| 答えられるかどうかの判定 | 中程度 |
| 精度を測る評価環境 | 中程度 |
この種の業務システムで Auto Ontology を使うときの懸念
| 懸念 | 見立て |
|---|---|
| 別のスタック(Next.js・FastAPI・取り込みサービス・PostgreSQL)を運用する必要がある | いちばん大きなコスト |
| 利用者の管理が業務システムと二重になる | SSO でつなげば軽くできる。業務システムのバックエンドから REST API で呼べば、利用者が Auto Ontology の画面に触れる必要はない |
| 既定の推論先が NVIDIA のクラウド | OpenAI 互換のエンドポイントに切り替えられるので、セルフホストのモデルや社内で承認された推論先を使える(構造化出力に対応したモデルが必要) |
| 行単位の制御がない | 全社データを見てよい役割だけに開放するなら問題にならない |
| DB が複数に分かれている場合の、DB をまたいだ結合 | ドキュメントでは確認できない。PoC で必ず試す |
| プロジェクトが新しい(2026 年 4 月公開、外部からのプルリクエストは受け付けていない) | 依存のリスクとして認識しておく |
進め方
- PoC を行う:読み取り専用のレプリカと、承認された推論エンドポイントにつないで、Docker Compose で動かします。監査担当に実際の質問を 20〜50 件出してもらい、正解の SQL と組にした評価用の質問集を作ります。正答率、DB をまたぐ質問の扱い、取り込みが DB にかける負荷を測ります(取り込みは外部キーの推定を確かめるために DB へクエリを発行します。
PREVENT_SEMANTIC_FK_DB_QUERIES=trueで止められますが、その場合は外部キーをデータで裏付けずに採用します)。 - 結果で判断する
- 正確さも運用負荷も許容できる → 採用します。業務システムのバックエンドから REST API で呼び、Auto Ontology の画面は定義をメンテナンスする担当者だけが使います。
- 正確さは十分だが、スタックが重すぎる → オントロジーだけを借ります。Auto Ontology は定義を Ossie YAML 形式でエクスポートできるので、作り込んだ用語・SQL 属性・結合の定義を書き出し、業務システムの中の軽量な自前の Text-to-SQL のプロンプトや検証に使います。
- 正確さが足りない → 自前で作っても簡単には超えられないので、Text-to-SQL を開放する範囲そのものを見直します。
- 最初から自前を選んでよい場面:対象のテーブルが数十程度に絞れる、利用者が数名しかいない、別スタックの運用が組織として認められない、のいずれかに当てはまる場合です。
ポイントは、価値があるのは実行環境ではなく、人がレビューして作り込んだオントロジー(定義)のほうだということです。定義は Ossie YAML で持ち出せるので、Auto Ontology で始めても、後から自前の実装に乗り換える道が残ります。
なお、監査担当が自分で SQL を書けるなら、読み取り専用のレプリカに BI ツールや SQL クライアントでつなぐだけで足りる場合もあります。PoC の前に、どれくらいの人が SQL を書けるかを確かめておくとよいでしょう。
まとめ
- 業務システムにデータ照会チャットボットを組み込むとき、Text-to-SQL を中核にすると、行単位の権限を通らない、計算の正本と食い違うという 2 つの大きな問題が起きる。加えて、データの外部送信と別システムの運用負荷も考える必要がある
- 会計・原価管理のように利用者ごとに見える範囲が決まっているシステムでは、既存の業務ロジックを照会専用のツールとして LLM に呼ばせる構成を中核にする
- LLM が決めるのは「どのツールをどの引数で呼ぶか」だけにし、権限と計算はテスト済みの既存コードに任せる
- ただし、管理本部や監査担当のように、ツールでは支えきれない複雑な問い合わせをする利用者もいる。こうした全社データを見てよい役割にだけ Text-to-SQL を開放するハイブリッド運用が現実的
- ハイブリッドでは、振り分けをアプリが役割で決め、Text-to-SQL は読み取り専用のレプリカで実行し、SQL を見せ、結果は調査用の数字として扱う
- 導入前のオントロジー作りは、課題管理に残る過去の問い合わせ事例を起点にして対象を絞り、コードと仕様書で「DB にない意味」を裏付ける。評価用の質問集と最初のツール群も、そこから作れる
- Text-to-SQL は同じ要件でも毎回 SQL を作り直す。何度も来る要求は、問い合わせのログから拾い、開発者が決定論的な API として組み込む改善サイクルにつなげる。Text-to-SQL は「まだ API がない問い合わせ」の受け皿であって、終着点ではない
- Text-to-SQL の部分は、最初から自前で作らず、まず Auto Ontology で PoC を行って正確さと運用負荷を測る。価値があるのは作り込んだ定義のほうで、Ossie YAML で持ち出せる
- オントロジー(業務用語の定義と関係)は、ツールの説明を書く土台としても、Text-to-SQL の精度を上げる土台としても役に立つ
関連記事
- データ照会チャットボットはデータ分析基盤を作ってから?ツール呼び出し・Text-to-SQL・セマンティックレイヤーの関係と進め方:この記事のチャットボットと DWH・セマンティックレイヤーの分析基盤の関係、分析基盤を作るタイミング、Text-to-SQL の接続先を DWH に移す理由