はじめに
LLM を賢くする一番素直な方法は、層を積んでモデルを大きくすることです。ただしパラメータが増えるほど、メモリも配布サイズも膨らみます。
Looped Transformer(ループ型 Transformer)は逆の発想をとります。層を増やさず、同じ層を何度も通すことで「深さ」を稼ぎます。パラメータ数は変えずに、推論時の計算量だけを増やして性能を引き出す方式です。
2026 年 11 月、NVIDIA の研究者らがこの方式の 4B モデル Dory1.0-4B を論文「Dory1.0-4B: A Looped Normalized-GPT」で公開しました。Avi Chawla 氏の X(旧 Twitter)のポストで話題になっていたので、論文の内容と合わせて整理します。
結論を先に書くと、Dory1.0-4B はループを 2 回にするだけで 12 ベンチマーク平均が 35.17 から 39.67 に伸び、Qwen3.5-9B や Gemma 4 26B-A4B を上回ります。総計算量の増加は約 1.03〜1.25 倍という見積もりです。本記事では、前提となる Transformer の仕組みをおさらいしてから、Dory1.0-4B の構造(入力の足し戻し)、ループ回数ごとのベンチマークと計算コスト、KV キャッシュの扱い、ループの限界の順に見ていきます。
そもそも Transformer とは
Looped Transformer の話に入る前に、土台となる Transformer を押さえておきます。
Transformer は、2017 年に Google の研究者らを中心とするチームが論文「Attention Is All You Need」で提案したニューラルネットワークの構造です。GPT、Gemini、Qwen など、現在の LLM のほとんどがこの構造をベースにしています。
層の中身:Attention と FFN
Transformer は同じ形の「層」を何段も積み重ねた構造です。1 つの層は主に 2 つの部品からなります。
| 部品 | 役割 |
|---|---|
| Self-Attention(自己注意) | 各トークンが文中のほかのトークンを見渡し、どれにどれだけ注目するかを計算して情報を集める。「それ」が何を指すか、といった文脈の関係をとらえる |
| FFN(フィードフォワードネットワーク) | 集めた情報をトークンごとに変換する。FFN がキーと値の記憶のように働くという研究(Geva et al., 2021)があり、学習で得た知識の多くはここの重みに蓄えられると考えられている |
それぞれの部品には残差接続(入力をそのまま出力に足すバイパス)と正規化が付いており、層を深く積んでも学習が安定するようになっています。
文章の生成と KV キャッシュ
GPT 型の LLM は、次の 1 トークンを予測しては文末に足す、という処理を繰り返して文章を生成します。トークンを 1 つ出すたびに、入力は最下層から最上層まですべての層を通ります。
Attention は過去のトークンを参照するので、素直に実装すると毎回すべての過去トークンを計算し直すことになります。そこで、過去トークンの Key / Value を保存して使い回すのが KV キャッシュです。KV キャッシュは層ごとに持つため、層が多いほど、また文脈が長いほどメモリを消費します。
層を積むほど大きくなる
通常の Transformer では、層ごとに別々の重みを持ちます。層を増やして深くすれば表現力は上がりますが、そのぶんパラメータ数も増えます。モデルを賢くするために層を積み、幅を広げ、パラメータを数百億、数千億と増やしてきたのがこれまでの LLM の大きな流れです。
Looped Transformer は、ここを変えます。
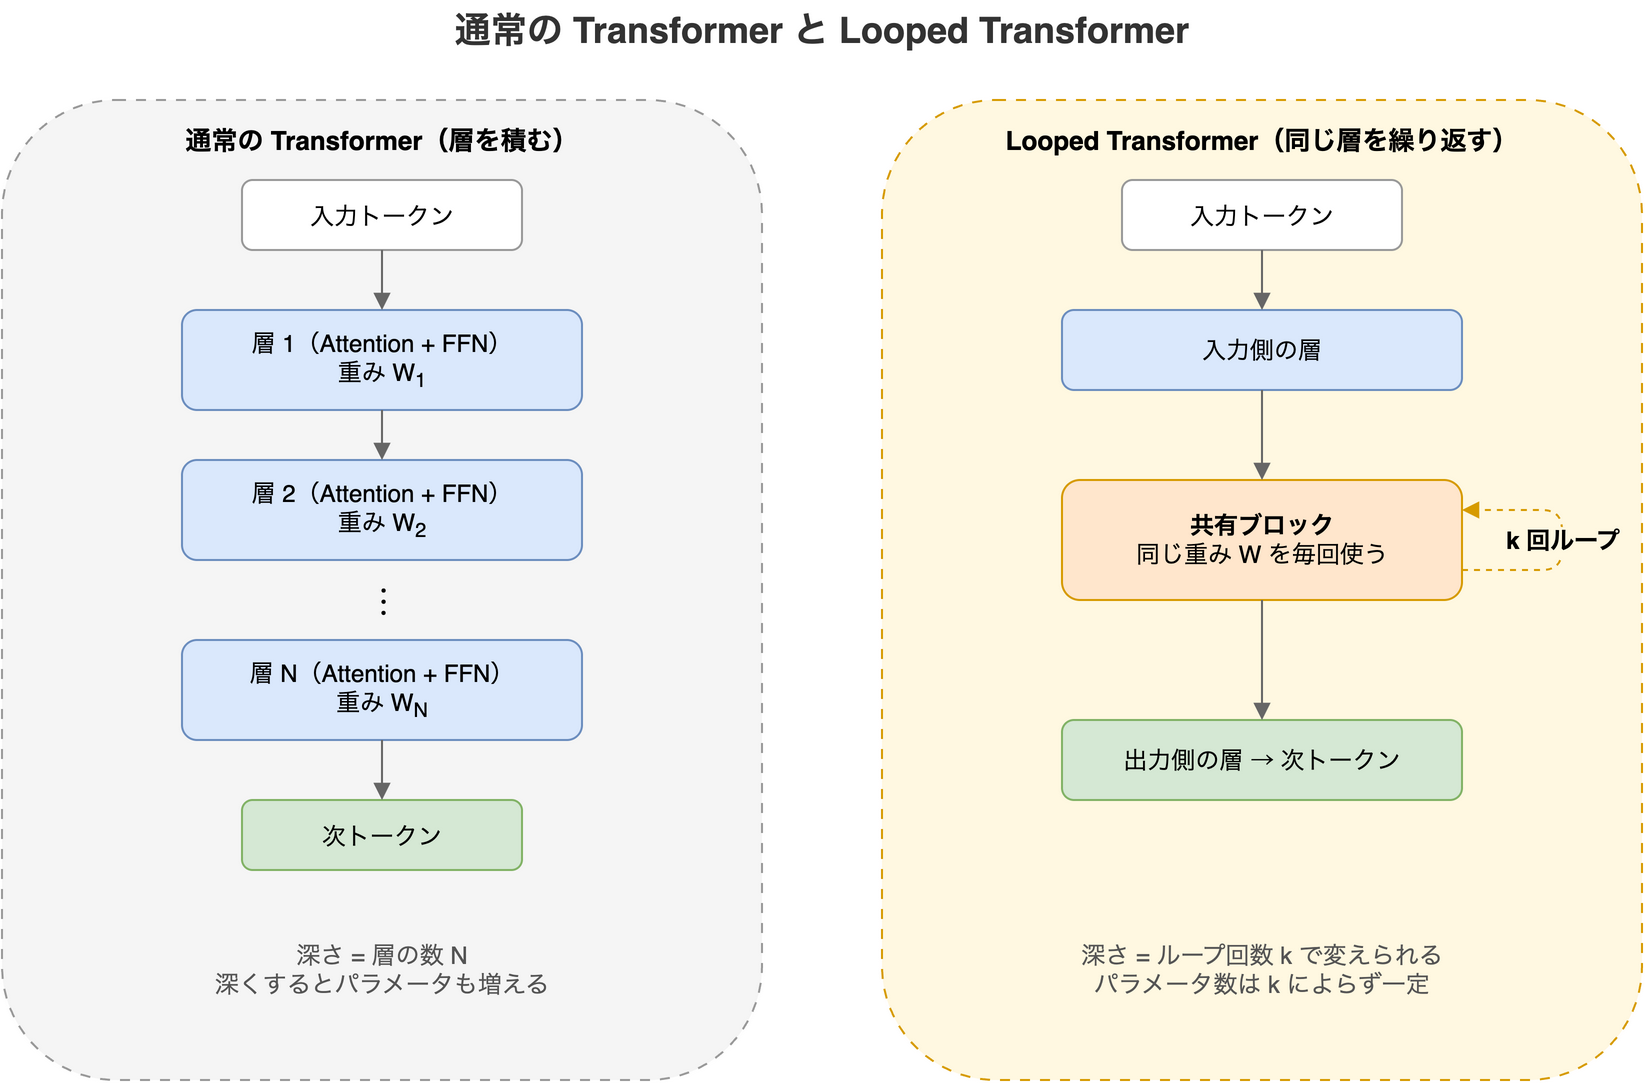
一部の層を重み共有のまま繰り返し通すので、パラメータ数は変えずに「深さ」だけを増やせます。ループ回数は推論時に変えられるため、同じモデルで「軽く速く」と「深く考える」を切り替えられます。ただし、ループを回すほど 1 トークンあたりの計算は増えますし、素直に実装すると KV キャッシュもループの回数分必要になります。この 2 点が、後で見る Dory1.0-4B の設計の焦点です。
用語
| 用語 | 意味 |
|---|---|
| Looped Transformer | 一部の層を重み共有のまま複数回繰り返し適用する Transformer。latent recurrent model とも呼ばれる |
| ループ回数 k | 再帰ブロックを何回通すか。推論時に選べる |
| elastic depth | 1 つのチェックポイントで、ループ回数を変えて計算量と精度のバランスを調整できる性質 |
| nGPT | 残差ストリームや各サブレイヤーの出力を L2 正規化する「正規化 Transformer」 |
| KV キャッシュ | 過去トークンの Key / Value を保持して、生成のたびに再計算しないための仕組み |
| GQA | Grouped-Query Attention。複数のクエリヘッドで K/V を共有し、KV キャッシュを小さくする注意機構 |
| RLVR | 検証可能な報酬による強化学習(Reinforcement Learning with Verifiable Rewards) |
Dory1.0-4B の構造
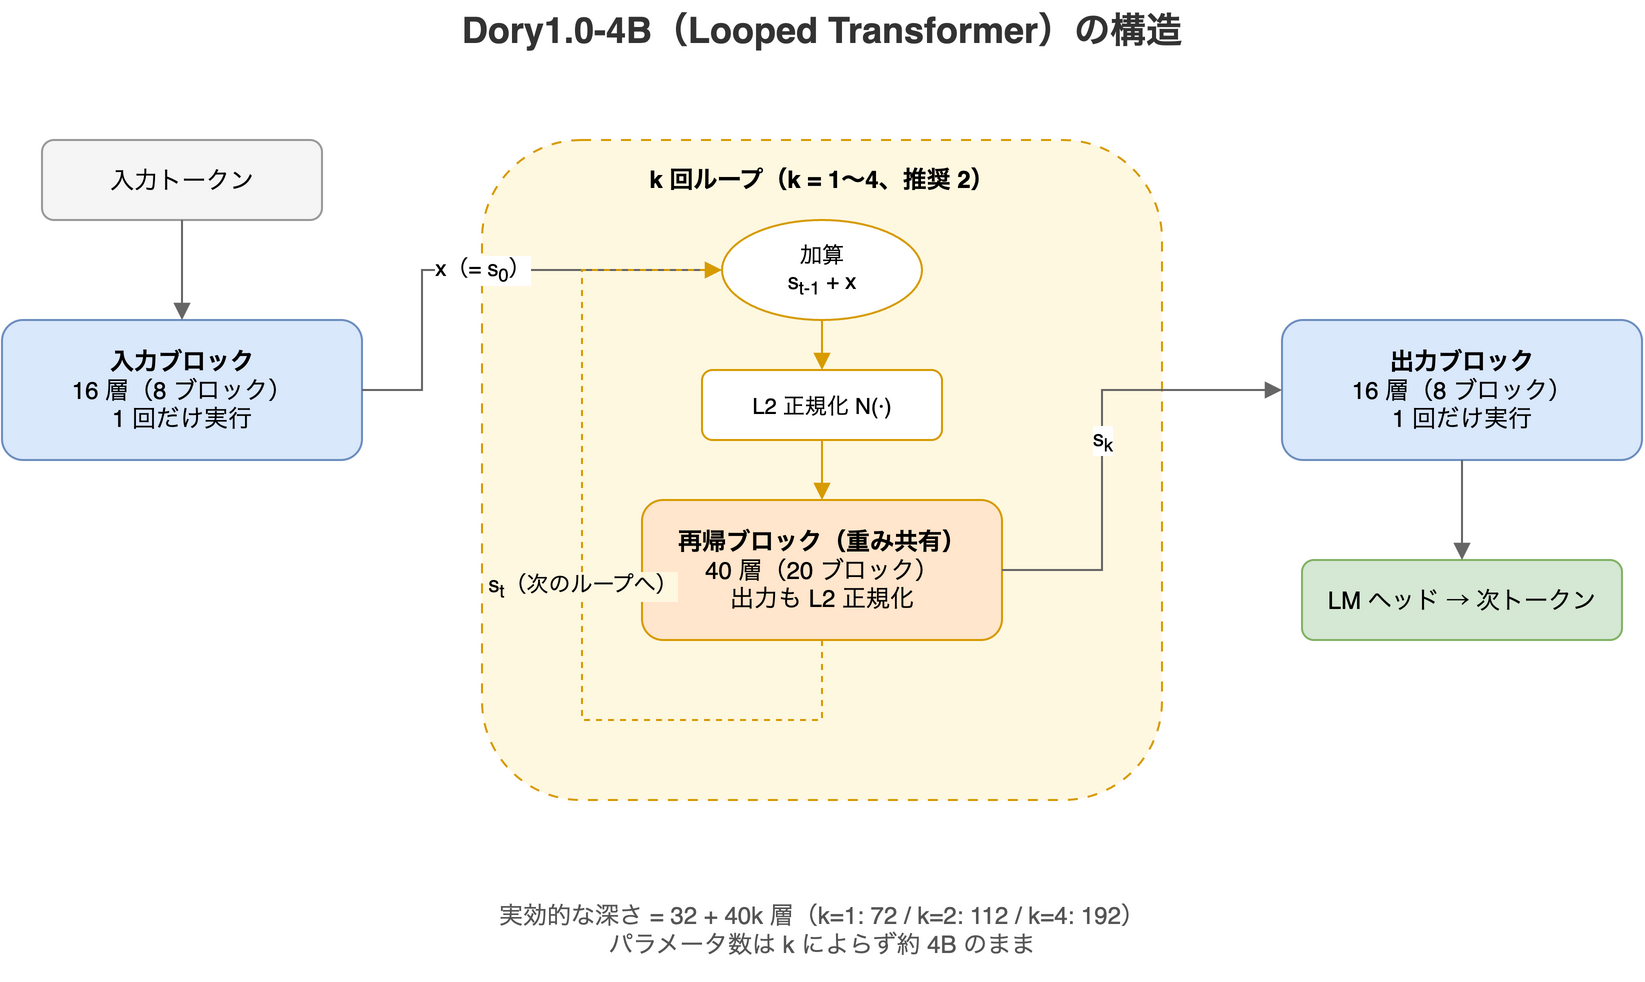
物理的な層は 72 層で、3 つのブロックに分かれています(ポストでは 2 層を 1 ブロックとして「8 / 20 / 8 ブロック」と数えています)。
| ブロック | 層数 | 実行回数 |
|---|---|---|
| 入力ブロック | 16 層 | 1 回 |
| 再帰ブロック(重み共有) | 40 層 | k 回(k = 1〜4) |
| 出力ブロック | 16 層 | 1 回 → LM ヘッド |
実効的な深さは 32 + 40k 層になります。k=1 で 72 層、k=2 で 112 層、k=4 で 192 層相当の計算をしますが、パラメータ数は約 4B のままです。
入力を毎回足し戻す
ループの要は、再帰ブロックに入る前に入力ブロックの出力 x を毎回足し戻す点です。論文の式は次のとおりです(N はトークンごとの L2 正規化、F は再帰ブロック)。
s_0 = x
u_t = N(s_{t-1} + x)
s_t = N(F(u_t))
2 行目と 3 行目を t = 1, …, k について繰り返し、最後の s_k を出力ブロックに渡します。
何周しても元のトークン表現 x を参照できるので、ループを重ねるうちに入力の情報が薄れていくのを防げます。論文によると、この足し戻しには学習可能なアダプタも外側の残差接続も使っていません(単純な加算と正規化だけです)。
その他の設計
- 注意機構: GQA(クエリ 16 ヘッド、KV 4 グループ)。直近 1024 トークンだけを参照するスライディングウィンドウ注意と、全体注意を 3:1 で配置
- 事前学習: 約 6T(6 兆)トークン
- 前半の約 4.5T は 4 ビット浮動小数点の NVFP4 精度、k=1 で学習
- 後半はループ回数 k を {1, 2, 3, 4} からサンプリングして学習
- その後 256K コンテキストへ拡張
- 事後学習: SFT と RLVR。難しいプロンプトほど深いループに割り当てる「難易度に応じたループのカリキュラム」を使う
- 重み: BF16 / MXFP8 / NVFP4 / GGUF で公開(Hugging Face のコレクション、ライセンスは OpenMDW-1.1)
ベンチマーク:ループを増やすと何が変わるか
ループ回数ごとの主な結果です(論文 Table 2 より)。
| ベンチマーク | k=1 | k=2 | k=4 |
|---|---|---|---|
| SWE-bench Verified | 50.3 | 59.5 | 61.8 |
| Terminal-Bench v2.1 | 12.5 | 18.1 | 22.2 |
| SciCode | 27.3 | 34.94 | 35.11 |
| GPQA Diamond | 69.19 | 72.41 | 72.16 |
| AA-LCR(長文脈) | 63 | 71 | 73 |
| 12 ベンチマーク平均 | 35.17 | 39.67 | 40.60 |
数値の桁数は論文の表記どおりです。論文の評価は k=1 / 2 / 4 で行われています。
比較対象モデルの 12 ベンチマーク平均は Qwen3.5-9B が 32.21、Gemma 4 12B が 32.59、Gemma 4 26B-A4B が 36.73 です。Dory は k≥2 でこの 3 モデルを上回ります。k=4 の 40.60 は、Qwen3.6-35B-A3B(42.30)まで 1.7 ポイント差です。
伸びが大きいのはコーディング、エージェント、長文脈のタスクです。さらに k=4 ではエージェント系タスクで出力トークン数が 1.3〜2.5 倍少なくなりました。GDPval-AA v2 ではターン数が 116 から 49 に減っており、1 ステップを深く処理できるぶん試行錯誤が減ったと読めます。
計算コストと推奨ループ回数(k=2)
ループを増やせばトークンあたりの計算は増えます。ただし出力トークン数が減るので、論文の見積もり(出力トークン数 × トークンあたりの層適用回数)では総計算量はそれほど増えません。
- k=2: k=1 の 約 1.03〜1.25 倍
- k=4: k=1 の約 1.07〜2.04 倍
なお、これは実測のレイテンシではなく計算量の見積もりです。
k=2 だけで、k=4 で得られる改善の 42〜86% が得られます(GDPval-AA v2 86%、SWE-bench 80%、Terminal-Bench 58%、τ3-Banking 42%)。論文は k=2 をデフォルト、精度を最優先するタスクでは k=4 を推奨しています。
KV キャッシュの扱い
ループ型モデルの実運用で気になるのが KV キャッシュです。再帰ブロックをループするたびに K/V が生まれるため、素直に実装するとメモリがループ回数に比例して増えます。
| 方式 | メモリ | 精度 |
|---|---|---|
| ループごとにキャッシュ(学習時と同じ) | k に比例して増える | 基準 |
| 最終ループのみキャッシュ | 通常モデルと同じ(k=1 相当) | k=4 で最大 2.12 ポイント低下(一部は微増) |
「最終ループのみ」方式では、再帰層ごとにキャッシュを 1 つだけ持ち、ループのたびに上書きします。再学習なしで使え、KV メモリは非ループモデルと同じに収まります。精度の低下はわずかです(Terminal-Bench v2.1 で 22.19 → 20.22、SciCode は 35.11 → 35.37 とむしろ微増)。メモリが厳しい環境では有力な選択肢です。
ループは「知識」を増やさない
注意したいのは、ループで伸びるのは推論力であって知識量ではない点です。
「推論力」と「知識量」の違い
今の LLM の評価では、この 2 つを別の能力として扱います。
| 知識量 | 推論力 | |
|---|---|---|
| 問われること | 事実を覚えているか | 手持ちの情報から結論を組み立てられるか |
| 例 | ある論文の著者は誰か、ある API の引数名は何か | バグの原因を絞り込んで直す、数学の証明を順に追う |
| 主に効くもの(一般にそう言われる) | パラメータ数や学習データ(覚えている量) | 計算の深さ・量 |
推論力と呼ばれるものは、具体的には次のような力です。
- 多段階の論理: 数学や論理パズルのように、中間結果を積み上げて結論まで進む
- コードの理解と修正: リポジトリを読み、原因を特定し、修正してテストを通す
- 計画と試行錯誤: コマンドを打ち、結果を見て次の手を決める(エージェント的なタスク)
- 長い文脈の統合: 長い文書のあちこちにある情報を結び付けて答える
推論力はどう測るか
推論力は、基本的に結果の正しさ(正答率)で測ります。速度は推論力の指標ではありません。ただ、同じ正答率にどれだけ計算を使ったかという効率も並べて報告するのが一般的になっています。
主な指標は「正しく解けた割合」
答えが正しいかを機械的に判定できる問題を用意し、その正答率や成功率を見ます。この記事に出てくるベンチマークでは、次のように判定します。
| ベンチマーク | 何を「正解」とみなすか | 指標 |
|---|---|---|
| SWE-bench Verified | モデルが書いた修正パッチで、隠しテストが通るか | 解決率(%) |
| Terminal-Bench | ターミナル操作の後、環境が目的の状態になっているか | 成功率(%) |
| SciCode | 生成したコードがテストを通るか | 正答率(%) |
| GPQA Diamond | 選択式の問題で正解を選べたか | 正答率(%) |
| GDPval-AA | 成果物どうしを比べ、どちらが良いかを判定する | Elo レーティング |
この 5 つはいずれも、途中の考え方ではなく最終結果を判定します。思考過程の各ステップを採点する方法もありますが、ステップごとに人手の正解ラベルが要るなど手間がかかります。一方「テストが通るか」「答えが合うか」は自動で検証できます。用語表の RLVR が「検証可能な報酬」を名前に掲げているのも、同じ考え方です。
試行回数の数え方にも種類があります。
- pass@1: 1 回の試行で解けた割合。実際の使い勝手に近い
- pass@k: k 回試して 1 回でも解けた割合。「解ける力があるか」を見る
速度ではなく「どれだけ計算を使ったか」
かかった時間(レイテンシ)は、GPU、量子化、推論エンジンの実装に大きく左右されます。そのため、モデル同士の推論力の比較には向きません。代わりに、ハードウェアに左右されにくい量で効率を見ます。
- 出力トークン数: 正解までにどれだけ考えたか
- ターン数: エージェントのタスクで何往復したか
- 計算量・コスト: 1 問あたりの計算量や API 料金
Dory の論文もこの形です。正答率(Table 2)に加えて、出力トークン数とターン数(Table 3)を示しています。さらに本文では、「出力トークン数 × トークンあたりの層適用回数」で総計算量を概算しています(実測の FLOPs ではありません)。「k=4 で正答率が上がり、しかも出力トークンが減った」と言えるのは、精度と効率の両方を測っているからです。
正答率には知識も混ざる
正答率は推論力だけを純粋に測っているわけではありません。
- 知識の混入: GPQA のように専門知識が要る問題では、推論が強くても知識が足りなければ解けない
- データ汚染: 学習データにベンチマークの問題が含まれていると、推論ではなく記憶で解けてしまう。対策として、新しい問題を足し続けるもの(LiveCodeBench)や、公開セットとは別に非公開の問題を持つもの(Humanity’s Last Exam)がある。この記事の SWE-bench Verified などは問題が公開されている
このため「推論力が伸びた」と言うときは、知識を測るベンチマークが動いていないこととセットで示すと説得力が増します。Dory の論文は、まさにそれを AA-Omniscience で示しています。
ベンチマークでの現れ方
Dory1.0-4B の結果も、この区別どおりに分かれています。
- ループで大きく伸びたもの(推論力が効く): SWE-bench Verified(コード修正)50.3 → 61.8、Terminal-Bench v2.1(エージェント操作)12.5 → 22.2、SciCode(科学計算のコーディング)27.3 → 35.11、AA-LCR(長文脈)63 → 73
- 伸びなかったもの(知識量が効く): 事実知識の正確さを測る AA-Omniscience の正答率は、ループ回数によらず約 10% のまま
- 途中で頭打ちになったもの: GPQA Diamond は k=1 の 69.19 から k=2 で 72.41 に伸びたものの、k=4 は 72.16 とほぼ同じで、Qwen3.5-4B(77.71)にはなお届かない。専門知識も要る問題なので、知識の不足で頭打ちになっていると読めます
パラメータに入っていない知識は何周回しても出てきません。Looped Transformer は「持っている知識をより深く使う」技術だと理解するのがよさそうです。
「考える計算」をどこで増やすか
今の主要な LLM は、推論力を上げるために推論時の計算(test-time compute)を増やす方向に進んでいます。増やし方は大きく 2 通りあります。
| 方式 | 計算を増やす場所 | 例 |
|---|---|---|
| 思考をトークンとして生成する | 回答の前に思考過程のトークンを長く生成する(ユーザーに全文が見えるとは限らない) | OpenAI の o シリーズ、Claude の extended thinking、DeepSeek-R1 |
| 内部で深く計算する(latent reasoning) | トークンを出さず、1 トークンあたりの計算を深くする | Looped Transformer(Dory1.0-4B など) |
Dory で k=4 にすると、エージェント系タスクの出力は k=1 の 1/1.3〜1/2.5 まで短くなりました。トークンとして生成していた試行錯誤の一部を、内部の計算が肩代わりした結果とも読めます。2 つの方式は排他ではなく、Dory も思考ありと思考なしの両方の応答で学習されています。
まとめ
- Looped Transformer は、重みを共有した層を繰り返し通して、パラメータを増やさずに深さを稼ぐ
- Dory1.0-4B は 16 + 40×k + 16 層の構成で、各ループの前に入力 x を足し戻して L2 正規化する
- k=2 で 12 ベンチマーク平均が 35.17 → 39.67 に伸び、Qwen3.5-9B や Gemma 4 26B-A4B を上回る。総計算量の増加は約 1.03〜1.25 倍の見積もり
- 最終ループのみ KV キャッシュを持てば、メモリは通常モデル並みのまま、精度低下はわずか
- 伸びるのは推論力で、知識量は増えない
1 つのチェックポイントで、推論時にループ回数を選んで計算量と精度を調整できるのは実用上大きな利点です。エッジや小型 GPU で「軽く速く」と「深く考える」を使い分けたい場面で、選択肢になりそうです。