はじめに
X で、次のような投稿が 15 万回以上表示されていた(@callanxai の投稿、2026 年 11 月 14 日 UTC)。
Prompting was the old way. Engineering the system around the model is the new one
(プロンプトは古いやり方。これからはモデルの周りのシステムを設計する時代だ)
投稿には約 10 分の動画が付いていて、空のターミナルから「エージェント → ループ → グラフ → 自己改善するシステム」と Claude Code の構成を組み上げていく様子が映っている。投稿者は、動画の人物を「Anthropic のエンジニア」と紹介している。その人物が「プロンプトはもう終わり」「エンジニアの 95% がすでに自己改善ループを回している」「次はグラフだ」と語っている、というのが投稿の触れ込みだ。
ただし、この人物が誰なのか、95% という数字の出どころがどこなのかは、投稿からは確かめられない。投稿者自身も Anthropic の社員とは名乗っていない。数字は話半分に聞いておくのがよい。
この記事で取り上げたいのは、動画の煽り文句ではなく、投稿が引用している長文記事のほうだ。@hanakoxbt による「Loops and Graphs: how to stop babysitting agents and only approve the last step」(ループとグラフ:エージェントの子守りをやめて、最後の一手だけ承認する方法。2026 年 8 月)は、エージェントに仕事を任せるときの設計原則を、ツールに依存しない形でまとめている。なお、元記事は有料コースの案内も兼ねている。
以下では、元記事の要点を 4 つの原則に整理し、このブログの運用に当てはめて考える。プロンプトからループへ の続きとして、グラフ側の具体論にあたる内容だ。
用語の整理
| 用語 | この記事での意味 |
|---|---|
| ループ | 作る → 検査する → 直す、を検査が通る(グリーンになる)まで繰り返す仕組み |
| グラフ | どんな仕事の単位があり、それらがどうつながるかを決める構造 |
| ノード/エッジ | グラフを構成する処理の箱/それらをつなぐ矢印 |
| 単位(ユニット) | 1 つのループが受け持つ仕事のまとまり。ファイル 1 つ、記事 1 本など |
| チェック | プログラムが合否を判定できる検査。テスト、型検査、スキーマ検証など |
| 決定的 | 同じ入力に対して必ず同じ出力を返すこと |
| ゲート | 結果を先に進めてよいかを判定するノード |
| 修正エッジ/学習エッジ | 今回の実行を直すために戻る矢印/次回以降の実行に効かせるために戻る矢印 |
| 影響範囲(blast radius) | その変更が失敗したときに壊れる範囲と、元に戻せるかどうか |
ループとグラフは役割が違う
元記事の中心にある主張は一つだ。
- ループは、1 つの単位を正しくする。
- グラフは、どんな単位があり、それらがどう関係するかを決める。
ループだけを回していると、「次は何をやらせるか」「どれとどれがつながっているか」を人間が毎回考えて指示することになる。これが元記事のタイトルにある「子守り(babysitting)」だ。グラフは、この判断を構造として先に書いておくものだ。そうすれば、人間の出番は最後の承認だけになる。
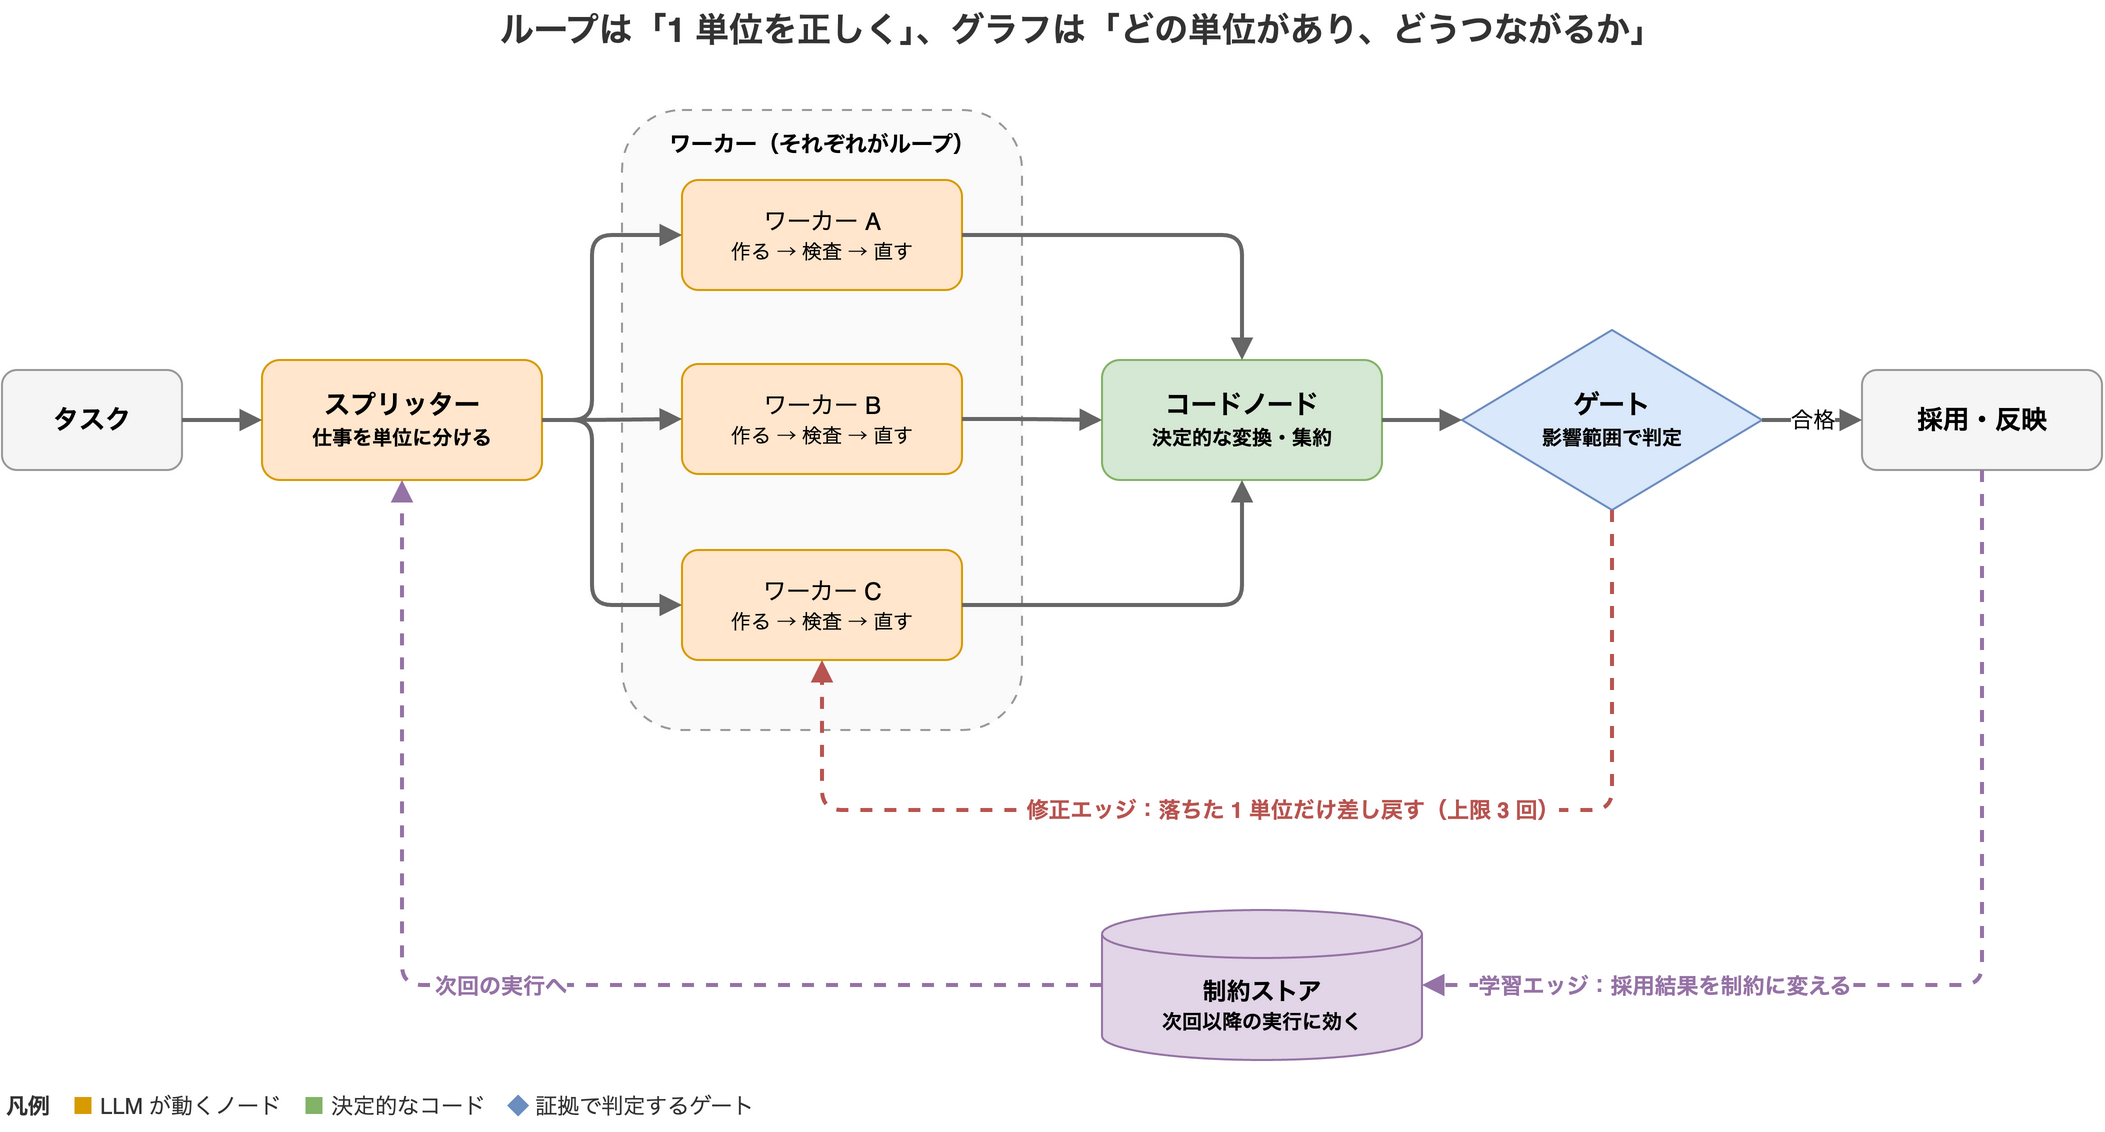
次の図は、この後の原則 1〜4 で説明する要素を 1 枚にまとめた全体像だ。
原則 1:ループのチェックはプログラムが判定できるものにする
ループの「検査が通るまで繰り返す」は、検査が信頼できて初めて意味を持つ。元記事は、チェックをプログラムが評価できる形で書くよう求めている。そのうえで、別のモデルに出力を見てもらうだけのレビューを「楽観主義者が 2 人で同意しているだけ」と否定的に扱っている。
モデルによるレビューは判断が揺れるうえ、「よさそうです」で通ってしまうことがある。ループの終了条件をそこに置くと、ループは「グリーンになるまで回る」のではなく「モデルが納得するまで回る」ものになる。
チェックとして使えるものの例を挙げておく。
# どれも終了コードで合否が決まる(プロジェクトに合わせて選ぶ例)
pytest tests/                             # テスト
npx tsc --noEmit                          # 型検査
python3 scripts/validate_frontmatter.py   # スキーマ・規約の検証
npx astro build                           # ビルドが通るか
このブログでも、記事の frontmatter やタグ表記の揺れは validate_frontmatter.py が CI で落とす。人手やモデルによる確認に頼っていた頃より、漏れがはっきり減った。
なお、モデルによるレビューに価値がないわけではない。このブログでは、記事ごとに別ティアのモデルでファクトチェックをしている(ファクトチェックを繋ぎ直した 3 つの穴)。ただし、それはループの終了条件ではなく、人間に判断材料を渡すための仕組みとして置いている。元記事の線引きとは、この点で矛盾しない。
原則 2:グラフのノードは 4 種類、決定的な処理はコードノードへ
元記事は、グラフのノードを 4 種類に分けている。
| ノード | 役割 |
|---|---|
| スプリッター | 仕事を単位に分ける |
| ワーカー | 1 単位をループで仕上げる |
| コードノード | マージ・並べ替え・重複除去などの決定的な処理 |
| ゲート | 先に進めてよいかを判定する |
ここで強調されているのが、決定的な処理はモデルではなくコードノードでやるという点だ。結果のマージや並べ替え、重複の除去を LLM にやらせると、遅く、高く、ときどき間違える。答えが一つに決まる処理は、コードで書いたほうがよい。
図でワーカーをオレンジ、コードノードを緑に塗り分けたのはこのためだ。どこでモデルが動き、どこが決定的なのかがひと目でわかるグラフは、障害が起きたときの切り分けも速い。
ゲートの判定も、モデルの言い分を鵜呑みにするものではない。元記事によれば、ゲートは証拠を決まった順で読む。まず決定的なチェックの結果、次に実行の経過、次に過去にロールバックした履歴で、モデル自身の評価は最後だ。
原則 3:戻りのエッジは 2 種類ある
グラフには、前に進むエッジのほかに、後ろに戻るエッジが 2 種類ある。
- 修正エッジ(correction edge) — ゲートで落ちた単位を、それを作ったステップに差し戻し、今回の実行の中で直させる。
- 学習エッジ(learning edge) — 採用された結果を制約に変え、次回以降の実行に効かせる。
修正エッジ:落ちた単位だけを、3 回まで
修正エッジについて、元記事は 2 つの具体的な指針を挙げている。
- バッチ全体ではなく、落ちた単位だけを差し戻す。 複数の単位のうち 1 つが落ちたときに全部をやり直させると、通っていたものまで書き直され、壊れるおそれがある。
- 修正は 3 回までで打ち切る。 3 回直して通らないなら、問題はその単位を生んだ計画の側にある。同じループを回し続けても解決しない。
この 2 つを Python で素朴に書くと、次のようになる(元記事のコードではなく、考え方を示すためのスケッチ。3 回で通らなかったときに人間へ回すのは筆者の補足)。
MAX_CORRECTIONS = 3

class NeedsHuman(Exception):
    """人間へのエスカレーション"""

def run_graph(task, splitter, worker, check, merge, gate):
    units = {u.id: u for u in splitter(task)}   # スプリッター
    results = {}
    for uid, unit in units.items():
        results[uid] = worker(unit)        # ワーカー(中でループを回す)

    for attempt in range(MAX_CORRECTIONS):
        failed = [uid for uid, r in results.items() if not check(r)]
        if not failed:
            break
        for uid in failed:                 # 修正エッジ:落ちた単位だけ戻す
            results[uid] = worker(units[uid], feedback=results[uid])
    else:  # break せずに上限回数を使い切ったとき
        failed = [uid for uid, r in results.items() if not check(r)]
        if failed:
            raise NeedsHuman(failed)       # 計画の見直しは人間へ

    merged = merge(results.values())       # コードノード(決定的)
    return gate(merged)                    # ゲート
学習エッジ:制約はスプリッターに戻す
学習エッジで大事なのは、制約がどこに戻るかだ。元記事は、採用された結果をスプリッターへの制約として戻すとしている。ワーカーへの指示に足すのではなく、仕事の切り方を決めるブリーフに入れる、と明言している。例として、原因が確認された不具合はルールになり、次回からはその前提で仕事が切られる。
ワーカーの指示に注意書きを積み増していくと、指示はどんどん長くなる。仕事の切り方そのものを変えれば、同じ失敗が起きる単位がそもそも生まれにくくなる。図で学習エッジがスプリッターに戻っているのはこのためだ。
このブログでいえば、レビューで繰り返し出た指摘を CLAUDE.md やスキルの手順に書き足していく運用がこれに近い。毎回同じ指摘を人間がするのではなく、指摘そのものをグラフの入力に戻す。
原則 4:承認ゲートはモデルの確信度ではなく影響範囲で判定する
最後の原則が、タイトルにある「最後の一手だけ承認する」につながる。元記事は、ゲートを開くかどうかを**モデルの確信度ではなく、影響範囲(blast radius)**で決めるよう勧めている。理由は、確信度が判定材料の中で唯一、モデル自身が左右できるものだからだ。
影響範囲は 3 段階に分けられている(例は元記事のものを要約した)。
| 影響範囲 | 例 | ゲートの扱い |
|---|---|---|
| 元に戻せて、範囲が限られる | 文言の修正、テストの追加、テストのある独立した関数 | 最初に開けてよい(失敗しても revert で済む) |
| 元に戻せるが、範囲が広い | 共有ユーティリティの変更、スキーマへの追加 | 決定的なチェックに加え、実行の経過がきれいであることを求める |
| 元に戻しにくい | マイグレーション、削除、本番データへの書き込み、送金 | スコアに関係なく自動では開かない |
ポイントは 3 段目だ。ここは「確信度が十分に高ければ通す」レーンではなく、どれだけスコアが高くても自動では開かないレーンとして扱われている。モデルが「95% 自信があります」と言っても、それが本番データの削除なら自動では進めない。逆に、確信度が低くてもテストの追加なら走らせてよい。
こうして線を引けば、人間が見るべきものは自動では開かないものだけに絞られる。元記事の言葉では、すべてを承認するのではなく 1 つだけ承認する(approve one thing)状態だ。人間は、影響が最も大きく、最も元に戻しにくい 1 ステップ——たとえばマージや、どの修正を出荷するかの選択——に置く。
このブログの記事作成フローもこの形に近い。下書き・ビルド・レビュー・ドラフト PR の作成までは自動で進める。マージ(公開)という元に戻しにくい一手は、自動では行わず人間が判断する。Claude Code の権限設定も同じ考え方だ。読み取り系のコマンドは許可し、外部への送信や設定の書き換えには確認を求めている。
自作の dev-loop・spec-loop に当てはめてみる
筆者は Claude Code のプラグインとして、2 つのループを自作して使っている(hdknr/claude-code-setup)。
| プラグイン | 何をするか |
|---|---|
| dev-loop | GitHub Issue 1 件を、受入基準の検証が通るまで実装 → 検証 → レビュー → マージと 1 周させる。cruise は親 Issue のチェックリストから台帳を作り、複数の Issue を依存順に回す |
| spec-loop | 要求確定 → 仕様レビュー → 見積り → 提案書 → Issue 化(scaffold)までを、それぞれループとして回す(プラグイン化の記事) |
この 2 つを、ここまでの 4 原則に照らして評価した。
| 原則 | dev-loop | spec-loop |
|---|---|---|
| ループとグラフの分離 | △ 1 周 = Issue 1 件がループ、cruise の台帳がグラフ。ただし仕事を切るのは人間か spec-loop で、cruise は切らない | ○ 各スキルが 1 回分のループで、autopilot の台帳が次の 1 単位を選ぶ。単位を切るのは scaffold.py(1 機能 = Issue 1 件) |
| 1. チェックはプログラムで判定 | △ 周を閉じる判定は Verifier(モデル)。ただし Verifier には「証拠はコマンドの出力で示す」ことを求め、証明手段の無い受入基準は BLOCKED にするなど、証拠への縛りは強い | △ 条件 1 はスクリプト、形式検証は TLC/Alloy の出力と陽性対照が根拠。ただし条件 2・3 は Red Team(モデル)の判定がそのまま抜ける条件になっている |
| 2. 決定的な処理はコードへ | ○ 台帳・マージ・親 Issue の読み取りなどがスクリプトで、多くのスクリプトに「なぜスクリプトか」が書いてある | ○ 版の重ね合わせ、署名の照合、PPTX、ガント、Issue 本文の生成まですべてスクリプト |
| 3a. 修正エッジ | ○ 落ちた指摘だけを戻し、2 パス目は差分だけを確かめる。上限は 3 回ではなく 2 パスで、指摘数が減らないという実測を根拠に意図して変えている | ○ 指摘を生んだ段(仕様/要求確定/見積り/実装)へ振り分けて戻す |
| 3b. 学習エッジ | × 還元先は CLAUDE.md・Skill・メモリで、どれもワーカー向けの指示 | △ 「同じ機能で 3 回目の質問が来たら、範囲を決め直す質問に切り替える」はスプリッターへ戻す形に近い。ただし学びの多くは判定役の指示文に積まれている |
| 4. 影響範囲でゲート | ◎ 本番反映は線として宣言できず、台帳のスクリプトが拒む | ◎ タグ付け・scaffold・Issue 登録は、自動運転の線の選択肢にそもそも置いていない |
できていること
原則 2 と 4 は、両方とも元記事より厳しい形で実装できていた。 特に spec-loop の自動運転の点検スクリプトは、元に戻しにくい操作を「選択肢の値にしない。値に置くと選ばれうる」として、選べる線から外している。「スコアに関係なく自動では開かない」を、設定の形そのもので保証している。
元記事にない手当てもある。チェック自体が壊れていないかを確かめる陽性対照や、「走らなかった検査は緑ではない」という扱いだ。元記事は「チェックはプログラムで判定せよ」で止まっているが、そのプログラムが空振りしていれば判定は意味を持たない。
足りないこと
弱点は 2 つあり、どちらも両方のプラグインに共通していた。
- 「関門を通った」を確かめているのがモデル。 チェックの一つ一つはコマンドの出力に基づくが、全部通ったと判断してマージや Issue 化に進むのはモデルで、それをスクリプトが照合していない。dev-loop のマージ用スクリプトは冒頭で「マージしてよいかは決めない」と明言しており、spec-loop の
scaffold.pyは「条件 2〜5 は判定していない」と出力するだけだ。 - 学習エッジがワーカーへの指示に向いている。 周から得た学びは SKILL.md や判定役の指示文に書き足されていく。dev-loop の SKILL.md は 1879 行まで膨らんでいた。元記事が戒める「ワーカーの指示に注意書きを積み増す」形そのものだ。
この評価から、改善を 5 件の Issue にした。
- #1043 dev-loop: 関門を通ったかをスクリプトで照合してからマージする
- #1044 spec-loop: 抜ける条件 2〜5 と上限をスクリプトで再計算する
- #1045 dev-loop・spec-loop: 学習の還元先に「仕事の切り方」の層を足す
- #1046 spec-loop: 自動運転でのタグ・Issue 登録を、散文でなく権限で止める
- #1047 dev-loop: 影響範囲の中間段とロールバック履歴を、不在の周のマージ判定に入れる
元記事の原則は、自分のループを点検する物差しとしてそのまま使えた。「ゲートの判定をスクリプトに寄せる」「学びを切り方に戻す」の 2 点は、どのエージェント運用でも見直す価値がある。
まとめ
- 「プロンプトの時代は終わった」「95% のエンジニアが…」といった投稿の煽りは、裏付けが取れない。持ち帰るべきは、引用されている元記事の設計原則のほうだ。
- ループは 1 単位を正しくし、グラフはどの単位がありどうつながるかを決める。
- チェックはプログラムが判定できる形で書き、モデルのレビューをループの終了条件にしない。
- ノードはスプリッター・ワーカー・コードノード・ゲートの 4 種類。決定的な処理はコードノードに寄せる。
- 戻りのエッジは、今回の実行を直す修正エッジと、次回以降に効く学習エッジの 2 種類。修正は落ちた単位だけ、3 回まで。学習した制約はワーカーではなくスプリッターに戻す。
- ゲートは確信度ではなく影響範囲で判定する。元に戻しにくいものは自動では開けず、人間が見るのはそこだけにする。
- 自作の dev-loop・spec-loop に当てはめると、決定的な処理と影響範囲のゲートはよくできていた。一方で「関門を通った」の照合と、学びの戻し先には改善の余地があった。
ループの設計そのものについては Claude Code チームのループ設計ガイドを読み解いた記事、ループの先にあるグラフの考え方は グラフエンジニアリング入門 も参考になる。