Transformer(トランスフォーマー)は、ディープラーニング(深層学習)で使うニューラルネットワークのモデル構造(アーキテクチャ)の 1 つです。2017 年に Google の研究チームが、論文「Attention Is All You Need」で発表しました。
ChatGPT や Gemini などの大規模言語モデル(LLM)をはじめ、音声認識や画像を扱うモデルまで、いまの生成 AI の多くがこの Transformer を土台にしています。この記事では、従来の RNN と比べながら次の 2 点を整理します。
- Transformer はニューラルネットワークとどういう関係にあるのか
- 何が画期的だったのか
最後に、中心となる Self-Attention の計算を NumPy のコードでも確認します。
ニューラルネットワークとの関係
結論から言うと、Transformer はニューラルネットワークという大きな枠組みの中にある、特定の設計図(アーキテクチャ)の 1 つです。
ニューラルネットワークは、人間の脳の神経回路をヒントにした計算モデルの総称です。その中に、扱うデータや目的に応じていくつもの「型」があります。
| アーキテクチャ | 得意なこと |
|---|---|
| CNN(畳み込みニューラルネットワーク) | 画像認識など、空間的なパターンの抽出 |
| RNN(再帰型ニューラルネットワーク) | 文章や音声などの時系列データ(Transformer 以前の主流) |
| Transformer | 文脈の理解と高速な並列処理の両立。現在の主流 |
建物にたとえるなら、「ニューラルネットワーク」は建築技術そのもので、Transformer はその技術で建てる、特に高性能な建物の設計図です。ニューラルネットワークの最小単位については パーセプトロン入門 で解説しています。
Transformer の何が画期的だったのか
Transformer 以前、文章を扱うニューラルネットワークの主流は RNN でした。RNN は単語を 1 つずつ順番に読み、それまでの内容を「隠れ状態」という記憶に詰め込んで次の単語へ渡していきます。この方式には 2 つの弱点がありました。
- 長い文章が苦手: 情報が隠れ状態をバケツリレーで渡っていくうちに、最初のほうの内容が薄れていく
- 計算に時間がかかる: 前の単語の計算が終わらないと次の単語を計算できないため、並列化が難しい
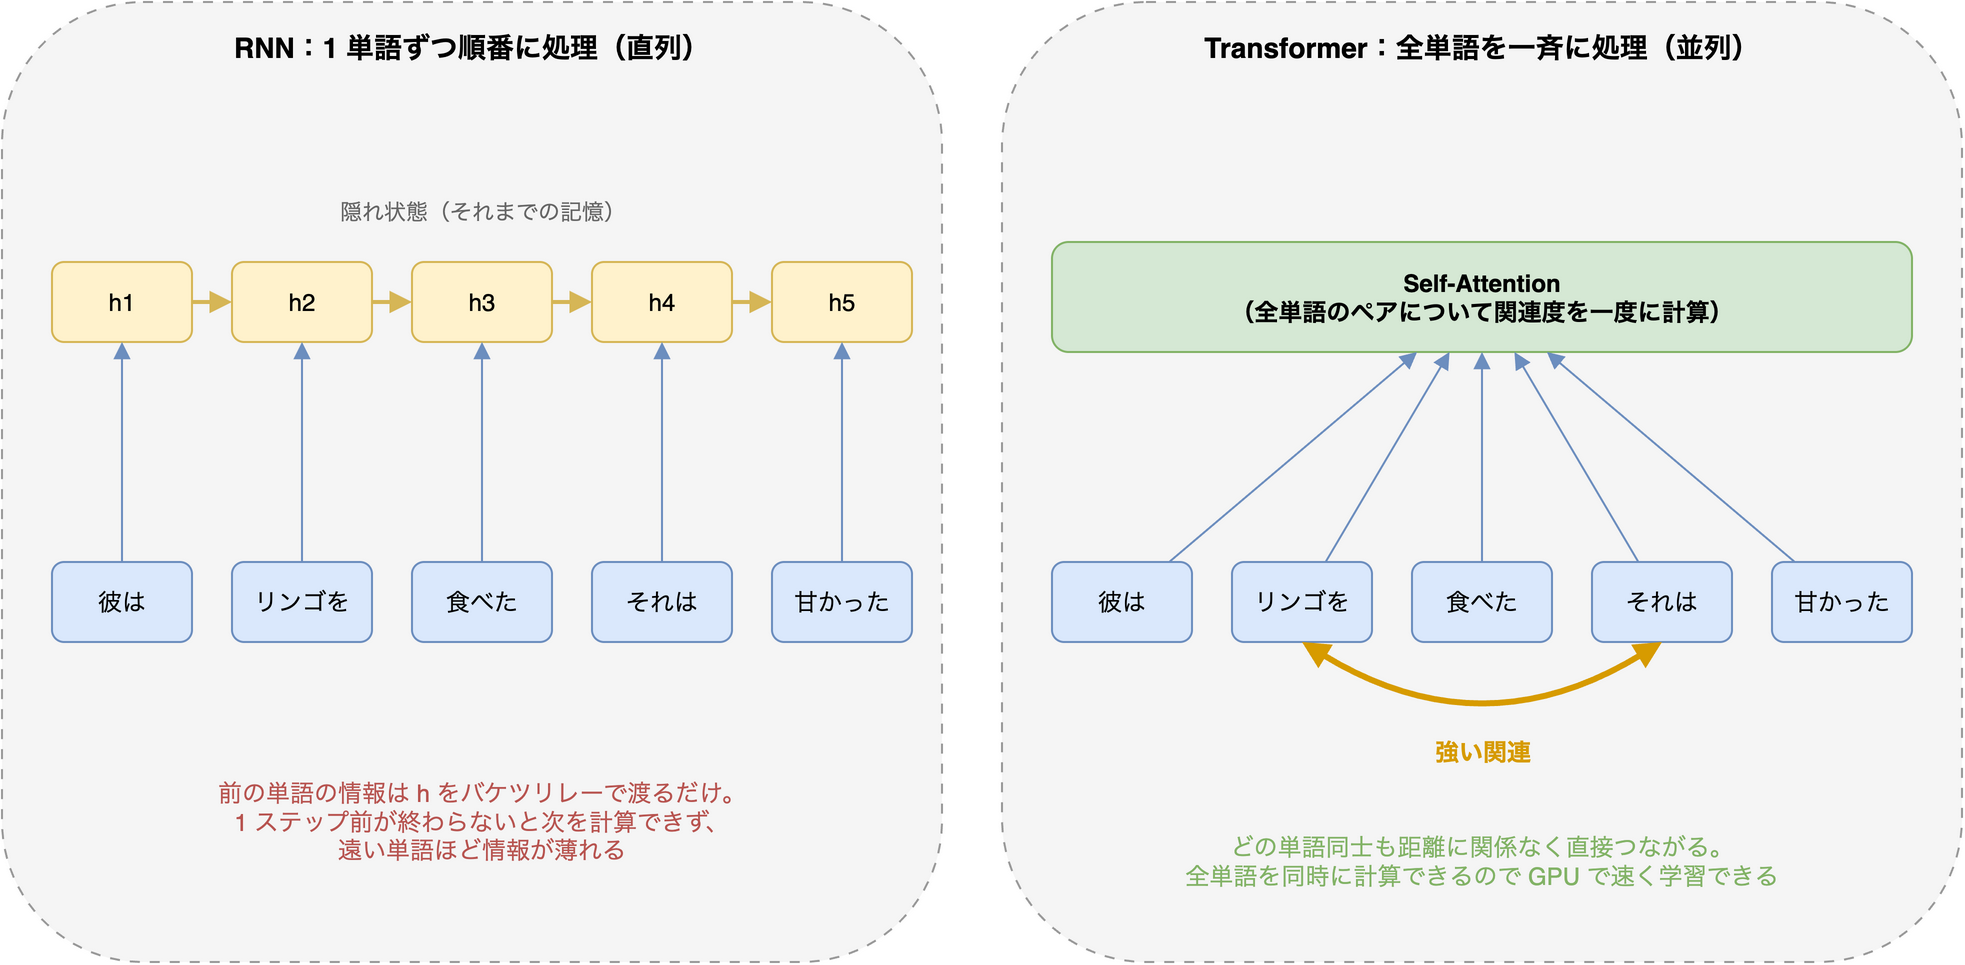
Transformer は、長い文章の問題を Attention で、速度の問題を並列処理で解決しました。
1. Attention(注意機構)
Attention(アテンション)は、文章全体を見渡して「どの単語とどの単語が強く関連しているか」という関連度(重み)を直接計算する仕組みです。
たとえば「彼はリンゴを食べた。それはとても甘かった」という文では、「それ」が「リンゴ」を指しています。RNN では、「リンゴ」の情報が何ステップも隠れ状態を経由して、ようやく「それ」に届きます。一方 Attention なら、離れた単語同士でも 1 回の計算で直接結びつけられます。
Attention 自体は Transformer 以前から、RNN の補助として機械翻訳などで使われていました(Bahdanau ら, 2014)。Transformer の新しさは、論文のタイトルどおり RNN を取り除き、Attention を中心に組み立てた点にあります。中でも、同じ文章の中の単語同士の関連を見る Attention を Self-Attention と呼びます。
2. 並列処理(Parallelization)
Transformer は単語を 1 つずつ順番に読むのではなく、文章中の全単語を一斉に処理します。これにより GPU の並列計算能力をフルに活かせるようになり、膨大なデータを現実的な時間で学習できるようになりました。この「大きくしても学習が回る」性質が、現在の巨大な LLM の誕生につながっています。
ただし、一斉に処理すると単語の順番の情報が失われます。そこで Transformer では、各単語に「何番目の単語か」を表す位置情報(Positional Encoding)を足してから入力します。元の論文では、正弦波(sin / cos)を使って位置を表しています。
Self-Attention をコードで見る
Self-Attention の中心は「Scaled Dot-Product Attention」と呼ばれる計算です。まず、単語を数値のベクトルで表したもの(埋め込み)から、Query(Q)・Key(K)・Value(V)の 3 つを作ります。次に Q と K の内積(ベクトル同士の似ている度合い)で関連度を求め、その重みで V を混ぜ合わせます。
式で書くと Attention(Q, K, V) = softmax(Q·Kᵀ / √d_k) · V です。d_k は Key ベクトルの次元数で、softmax は数値の並びを合計 1 の重みに変換する関数です。
NumPy では、次のように数行で実装できます。
import numpy as np

def softmax(x, axis=-1):
    x = x - x.max(axis=axis, keepdims=True)  # オーバーフロー対策
    e = np.exp(x)
    return e / e.sum(axis=axis, keepdims=True)

def scaled_dot_product_attention(Q, K, V):
    d_k = Q.shape[-1]
    scores = Q @ K.T / np.sqrt(d_k)   # 全単語ペアの関連度を一度に計算
    weights = softmax(scores, axis=-1)  # 各行(各単語)で合計 1 の重みに
    return weights @ V, weights

# 5 単語 × 8 次元のダミー埋め込み
rng = np.random.default_rng(0)
X = rng.normal(size=(5, 8))

# 本来は学習で得る重み行列で Q, K, V に変換する
W_q, W_k, W_v = (rng.normal(size=(8, 8)) for _ in range(3))
out, weights = scaled_dot_product_attention(X @ W_q, X @ W_k, X @ W_v)

print(weights.round(2))      # 5×5 の関連度行列
print(weights.sum(axis=1))   # 各行の合計はすべて 1
scores = Q @ K.T の 1 行で、全単語ペアの関連度が行列としてまとめて求まっています。RNN のようなループがどこにもないことが、並列処理しやすい理由そのものです。
実際の Transformer では、この Attention を視点を変えて複数並べた Multi-Head Attention と、各単語のベクトルを個別に変換する全結合層を 1 ブロックとし、何層も積み重ねています。
RNN と Transformer の比較
| 比較項目 | RNN | Transformer |
|---|---|---|
| データの処理方法 | 1 単語ずつ順番に処理(直列) | 文章全体をまとめて一斉に処理(並列) |
| 学習スピード | 遅い(並列化が難しい) | 速い(GPU と相性が良い) |
| 長い文脈の理解 | 苦手(前の情報が薄れやすい) | 得意(Attention でどの位置も直接参照) |
| 主な用途 | 機械翻訳・音声認識(Transformer 以前) | 生成 AI 全般(LLM、画像・音声などのモデル) |
Transformer の弱点
一方で、Self-Attention には弱点もあります。全単語ペアを計算するため、文章の長さ n に対して計算量が n² で増えるのです。そのため、すべての単語ペアではなく一部のペアだけを計算する「疎な Attention」など、長い文脈を効率よく扱うための改良が現在も研究されています。
まとめ
- Transformer は、ニューラルネットワークの中のアーキテクチャの 1 つ
- RNN の「長い文脈が苦手」「直列処理で遅い」という弱点を、Attention と並列処理で解決した
- Self-Attention の中心は、Q と K の内積で全単語ペアの関連度を一度に求める計算。ループがないことが並列化しやすさにつながる
- GPU で大規模に学習できる性質が、ChatGPT や Gemini などの LLM を生む土台になった
LLM の挙動や限界を理解するうえでも、「全単語の関連度を一度に計算している」という Transformer の基本の仕組みを押さえておくと見通しが良くなります。