新しいチームに入ったら、コードベースは 20 万行。どこから読めばいいのか——。Understand-Anything は、この問いに「コードベースをナレッジグラフにして、地図として眺めながら読む」という答えを出すオープンソースのプラグインです。Claude Code・Codex・Cursor などの AI コーディングツールで使えます。
X では「フォロワー 32 人の大学院生が作ったサイドプロジェクトが数万スターを集めた」という話題で紹介されていました。紹介投稿によれば、作者はジョージア工科大学でマルチモーダル感情認識を研究する Yuxiang Lin 氏(GitHub: Lum1104)です。プロジェクトは現在、Egonex-AI の Organization に移管されています。2026 年 11 月 4 日時点で GitHub スター数は約 9 万です。
この記事では、Understand-Anything が何をするのか、どう動いているのか、導入時に何に気をつけるべきかを README をもとに整理します。
Understand-Anything とは
README の一文を借りると「コードベース・ナレッジベース・ドキュメントを、探索・検索・質問できる対話的なナレッジグラフに変える」ツールです。
- ファイル・関数・クラス・依存関係をノードとエッジにしたグラフを生成する
- グラフを Web ダッシュボードで表示し、パン・ズーム・検索ができる
- ノードを選ぶと、平易な英語(
--language指定で日本語なども可)の要約と関係が表示される
リポジトリの説明文に掲げられたスローガンは「Graphs that teach > graphs that impress」。README でも、目指すのはコードベースの複雑さを誇示するグラフではないと述べています。各部品がどう組み合わさっているかを静かに教えてくれるグラフだ、というわけです。
ライセンスは MIT、実装は TypeScript です。Claude Code のプラグインとしてネイティブに動くほか、Codex、Cursor、VS Code + GitHub Copilot、Gemini CLI、OpenCode、Cline、Kiro など多数の AI コーディングツールに対応しています。
Understand-Anything の主な機能
| 機能 | 内容 |
|---|---|
| 構造グラフ | ファイル・関数・クラスをノードとして表示。クリックで要約と関係を確認 |
| ドメインビュー | コードを業務ドメイン・フロー・ステップに対応付けて表示 |
| ガイドツアー | 依存関係の順に並べたアーキテクチャのウォークスルーを自動生成 |
| ファジー/セマンティック検索 | 「認証を扱っているのはどこ?」のような意味での検索 |
| 差分の影響分析 | コミット前に、変更がどこへ波及するかを表示 |
| ペルソナ適応 UI | ジュニア開発者・PM・パワーユーザーで詳細度を切り替え |
| レイヤー可視化 | API・Service・Data・UI・Utility などのレイヤーで色分け |
| 言語概念の解説 | ジェネリクス、クロージャ、デコレータなど 12 のパターンを登場箇所で解説 |
コードだけでなく、Karpathy 流の LLM Wiki(LLM が Markdown の記事群を継続的に書き足していく知識ベースの手法)を /understand-knowledge に渡すと、Wiki の記事同士の関係をグラフ化することもできます。
仕組み:Tree-sitter と LLM の分業
Understand-Anything の設計で興味深いのは、静的解析と LLM の役割をはっきり分けている点です。
構造と意味の分業
図のように、処理は構造の抽出(Tree-sitter)と意味付け(LLM エージェント)の 2 段に分かれます。
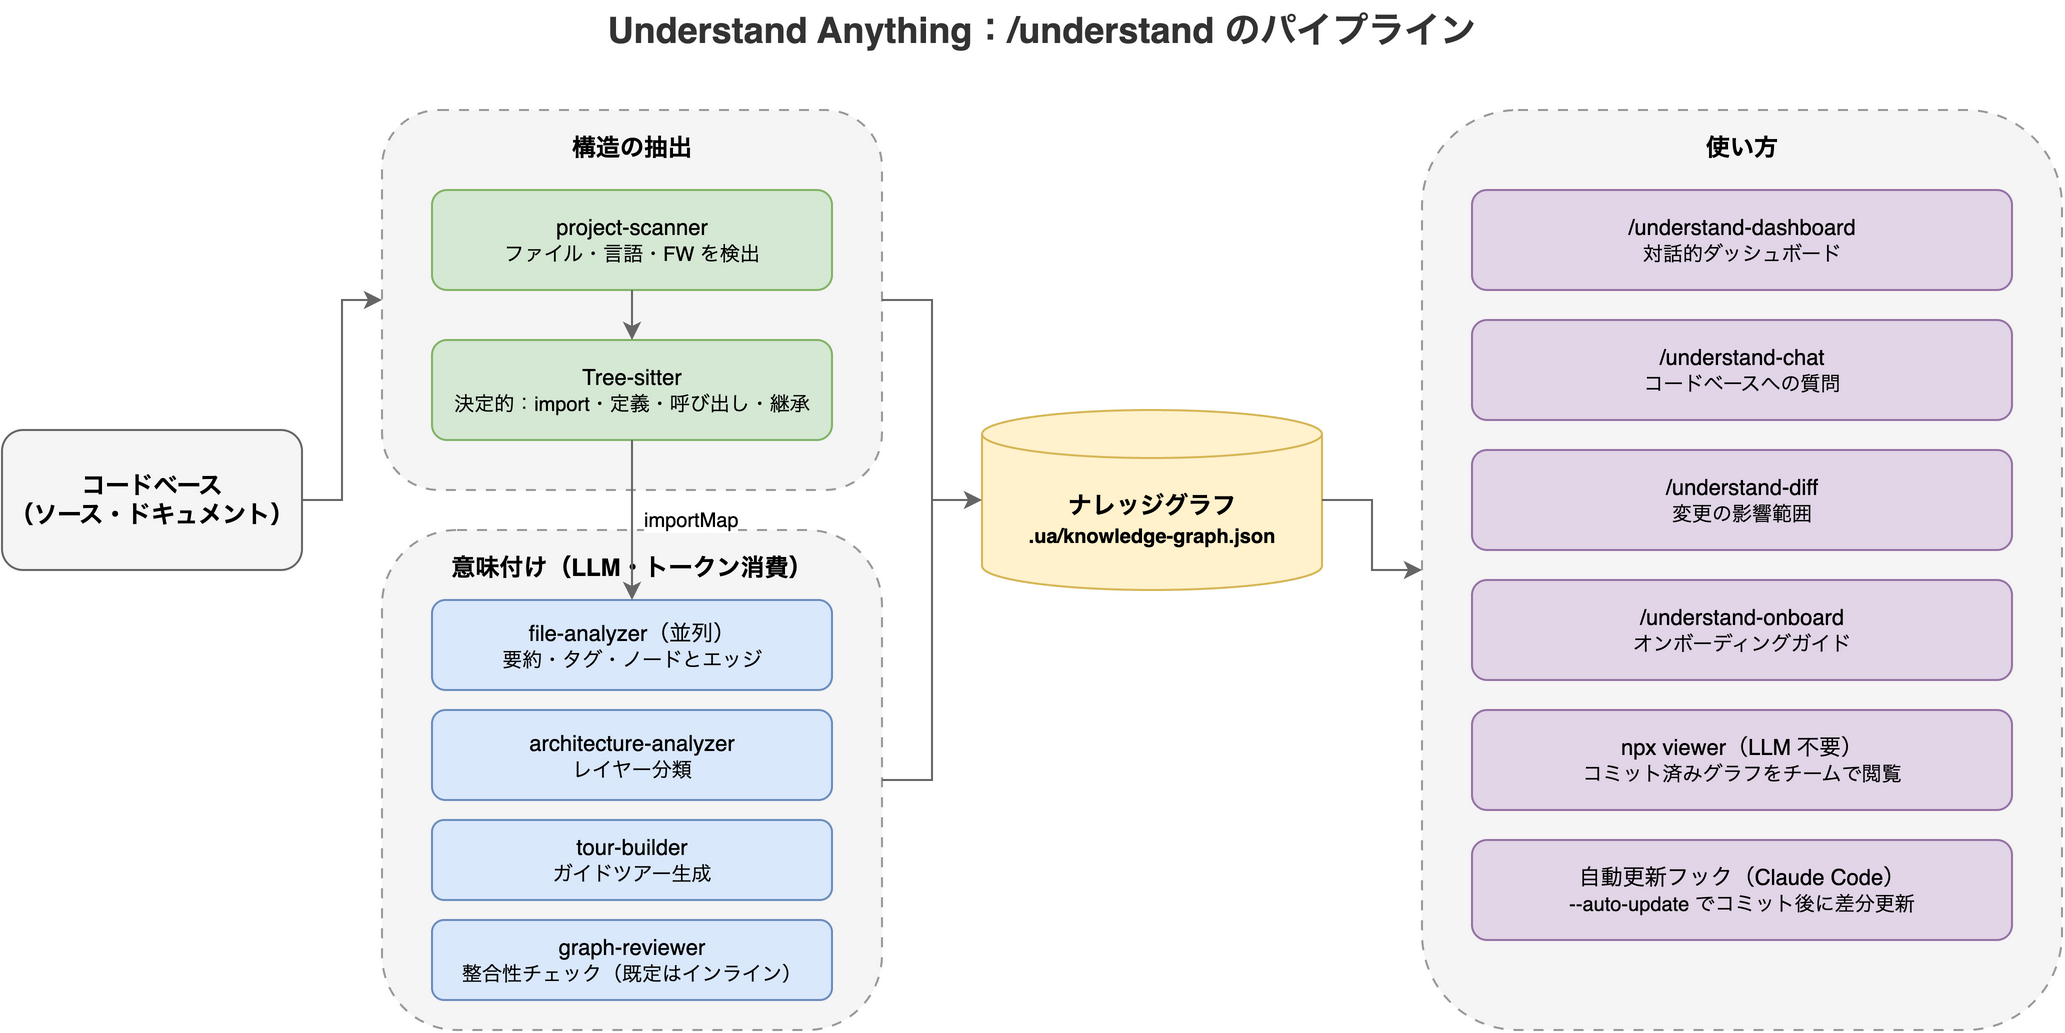
- Tree-sitter(決定的): Tree-sitter は多言語対応のインクリメンタル構文解析ライブラリです。ソースを構文木にパースし、import / export、関数・クラス定義、呼び出し箇所、継承といった構造上の事実を抽出します。同じ入力からは毎回同じ出力が得られ、インクリメンタル更新のための変更検出(フィンガープリント)にも使われます。
- LLM(意味的): パース結果と元のソースを読み、平易な要約、タグ、アーキテクチャ上のレイヤー、業務ドメインへの対応付け、ガイドツアーなど、パーサーには作れないものを生成します。
この分業により、グラフの「構造」側(どのファイルがどれを import しているか)は再現性があり、「意味」側(そのファイルが何のためにあるか)は LLM が補う、という形になっています。
/understand のマルチエージェントパイプライン
/understand は 5 つの専門エージェントを順に動かします。
| エージェント | 役割 |
|---|---|
project-scanner | ファイルの発見、言語・フレームワークの検出 |
file-analyzer | Tree-sitter の解析結果(importMap)を受け取り、関数・クラス・import からグラフのノードとエッジを生成 |
architecture-analyzer | アーキテクチャ上のレイヤーを特定 |
tour-builder | 学習用のガイドツアーを生成 |
graph-reviewer | グラフの完全性と参照整合性を検証(既定はインライン、--review で LLM によるフルレビュー) |
/understand-domain では domain-analyzer、/understand-knowledge では article-analyzer が加わります。file-analyzer は最大 5 並列、1 バッチ 20〜30 ファイルで処理されます。
Understand-Anything の使い方
インストール(Claude Code)
Claude Code のプロンプトで次を入力します(シェルではありません)。
/plugin marketplace add Egonex-AI/Understand-Anything
/plugin install understand-anything
Codex・Gemini CLI・OpenCode などの場合は、プラットフォーム名を指定するインストーラーをシェルで実行します。
curl -fsSL https://raw.githubusercontent.com/Egonex-AI/Understand-Anything/main/install.sh | bash -s codexインストーラーはリポジトリを ~/.understand-anything/repo にクローンし、各プラットフォーム用のシンボリックリンクを作ります。なお Codex ではスキルの呼び出しが /understand ではなく $understand になる点に注意してください。
curl ... | bash形式は手軽ですが、実行前にスクリプトの中身を確認する習慣をつけておくと安心です。Claude Code であれば、上のプラグインマーケットプレイス経由のインストールを使えばこの形式を避けられます。
解析とダッシュボード
以下も Claude Code のプロンプトで入力します。
# コードベースを解析して .ua/knowledge-graph.json を生成
/understand

# 日本語で要約やダッシュボードを生成
/understand --language ja

# ダッシュボードを開く
/understand-dashboard
--language を指定せずに初めて実行すると、会話で使っている言語を自動で検出します。英語以外の場合は確認したうえで、.ua/config.json に保存します。
その他のコマンド
# コードベースに質問する
/understand-chat 決済フローはどう動いている?

# 手元の変更の影響範囲を分析
/understand-diff

# 特定のファイルや関数を深掘り
/understand-explain src/auth/login.ts

# 新メンバー向けのオンボーディングガイドを生成
/understand-onboard

# 業務ドメインの知識(ドメイン・フロー・ステップ)を抽出
/understand-domain

# LLM Wiki 形式のナレッジベースをグラフ化
/understand-knowledge ~/path/to/wiki

# コミットのたびにグラフを差分更新(自動更新を有効化)
/understand --auto-update

# 巨大なモノレポではサブディレクトリに絞る
/understand src/frontend
ナレッジグラフをコミットしてチームで共有する
生成されたグラフはただの JSON なので、一度コミットすればチームメンバーはパイプラインを回さずに済みます。コミット対象は .ua/ ディレクトリです。ローカルの作業用ファイルは除外するため、.gitignore に次の 2 行を追加します。
.ua/intermediate/
.ua/diff-overlay.json
10MB を超える大きなグラフは git-lfs での管理が推奨されています。
コミット済みのグラフは、Claude Code も LLM も API キーもなしに、Node.js 18 以上だけで閲覧できます。
npx https://github.com/Egonex-AI/Understand-Anything/releases/latest/download/understand-anything-viewer.tgz /path/to/analyzed/projectアクセストークン付きのローカル URL(http://127.0.0.1:5173/?token=…)が表示され、ブラウザでダッシュボードが開きます。データはローカルディスクから読み取り専用で配信され、外部には送られません。
グラフには何が入っていて、どう使われるのか
「コードの修正はどうせコーディングエージェントとの対話で行うのだから、その過程でコードは解析されているのでは?」という疑問が湧くかもしれません。答えを出すために、グラフの中身と使われ方を、リポジトリの型定義(packages/core/src/types.ts)とスキル定義(SKILL.md)から確認しました。
knowledge-graph.json の中身
.ua/knowledge-graph.json は 1 つの JSON で、次の 5 種類のデータを持ちます。
| データ | 中身 |
|---|---|
project | 言語・フレームワーク・解析日時、そして解析時の git コミットハッシュ |
nodes | 27 種類の「もの」。コード(file function class など)に加え、config endpoint table service、業務の domain flow step なども含む |
edges | 38 種類の「関係」。imports calls inherits などの構造、reads_from writes_to などのデータの流れ、tested_by configures などの依存、業務フローのつながりなど |
layers | API・Service・Data・UI などのレイヤーへの振り分け |
tour | 順番付きの学習ステップ |
各ノードは、場所(filePath・lineRange)、LLM が書いた要約(summary)、タグ、複雑度(simple/moderate/complex)を持ちます。業務ドメインのノードには、業務ルールや入口の種類(http・cli・event・cron など)も記録されます。
コーディングエージェント自身がグラフを検索する
/understand-chat や /understand-diff は、エージェント向けの手順書(スキル)です。どちらも「グラフをまるごと読まず、Grep で必要な部分だけを引く」よう指示しています。
/understand-chat: 質問のキーワードでノードの名前・要約・タグを検索し、見つかったノードの呼び出し元と呼び出し先(1 段先まで)を集めて、その範囲だけを根拠に答えます。検索は文字列一致の Grep ですが、対象に LLM が書いた要約も含まれます。そのため、識別子に現れない言葉でも、要約に書かれていれば手がかりになります。/understand-diff:git diffで変更ファイルを取り出し、そのファイルや中の関数・クラスにあたるノードを探します。そこから 1 段先までの関係をたどって影響先を挙げ、複雑度やレイヤーをまたぐ関係の数からリスクを評価します。結果はdiff-overlay.jsonに書き出され、ダッシュボードで変更箇所と影響箇所を色分けして見られます。- 古いグラフの検知: どちらも最初に、グラフに記録されたコミットハッシュと現在の HEAD の差分を調べます。プロジェクト内のファイルが変わっていれば、「グラフが古い可能性がある」と警告します。
エージェントとの普段の対話と何が違うのか
| コーディングエージェントとの対話 | Understand-Anything | |
|---|---|---|
| 解析の範囲 | 依頼に要る箇所だけを、その都度 grep やファイル読み込みで拾う | リポジトリ全体を一度に解析する |
| 寿命 | そのセッション限り。次回はまた読み直す | JSON として残り、差分だけ更新する |
| 共有 | 本人の会話の中だけ | コミットすればチーム全員が使え、閲覧に LLM は要らない |
つまり、全体の理解を事前計算して残し、必要なときに検索して使い回すのがこの道具の考え方です。ただし、次の点は押さえておく必要があります。
- 普段の作業では自動で参照されない: 通常の依頼でグラフを自動参照する仕組み(MCP サーバーや読み取り用のフック)はありません。プラグインのフックは、自動更新を有効にしたときにグラフを「更新」するためのものです。いつもどおり「この関数を直して」と頼めば、エージェントはいつもどおりソースを読みます。エージェントの通常作業を効率化したいなら、MCP 経由でエージェントにグラフを引かせる道具のほうが目的に合います。
- 省けるのは主に「意味の理解」: どこが何を import しているかは、エージェントでも grep ですぐ拾えます。高くつくのは「このファイルは何のためにあるか」「どの業務フローの一部か」の理解で、グラフはそこを要約として事前計算しています。
- 影響分析は 1 段先まで: 呼び出し元のさらに呼び出し元(間接的な影響)は、自動ではたどりません。
- 元が取れるかは使う回数しだい: 初回の解析はまとまったトークンを使います。何度も質問する、複数人で使う、レビューのたびに影響範囲を見る、といった使い方で効いてきます。
グラフの更新とチーム運用
グラフをコミットして共有すると、コードを変える PR のたびに「マージする前にグラフも作り直すべきか」という問題が出ます。
先に結論を書くと、作り直しはマージの前提条件ではありません。ツールの側に、グラフが古いとマージを止めるような仕組みはありません。古いグラフを使う側(/understand-chat や /understand-diff)が、鮮度をチェックして警告します。問題は「いつ、誰が作り直すか」という運用の設計です。
--auto-update の実体は、README の表現から想像される git の post-commit フックではありません。Claude Code のプラグインフックです(hooks/hooks.json)。
- PostToolUse: Claude Code が Bash で
git commit/merge/cherry-pick/rebaseを実行したときに発火し、グラフを差分更新するようエージェントに指示します。 - SessionStart: 自動更新が有効な場合、セッション開始時にグラフに記録されたコミットと HEAD がずれていれば、更新を指示します。
差分更新の手順(hooks/auto-update-prompt.md)は、コストを抑えるように作られています。見た目だけの変更や削除だけのコミットでは LLM を呼びません。構造が変わったファイルだけを file-analyzer で再解析し、レイヤーとツアーは必要なときだけ作り直します。
一方で、次の点には注意が必要です。
- 人がターミナルで打ったコミットや、GitHub 上のマージでは発火しない: その場合は、次に Claude Code のセッションを開いたときに SessionStart フックが検知します。
- 更新はコミットの「後」に走る: フックの仕組みから考えると、書き換わった JSON は未コミットの変更として残り、別途コミットが要るはずです(筆者は実際に動かしては確かめていません)。
- 並行する PR がそれぞれグラフを更新すると、大きな JSON 同士が衝突しやすい
これらを踏まえた筆者の見解は、次の運用が衝突も少なく現実的だ、というものです。
- 機能 PR にはグラフの更新を含めない: コードの変更だけをレビューし、マージします。
- 作り直しは main でまとめて行う: マージ後の main で定期的に、またはリリース前に
/understandを回し、グラフだけの PR としてコミットします。README も「リリース前に/understandを手動で再実行する」方法を挙げています。 - 少し古い間は警告に頼る: グラフが古い間は、
/understand-chatや/understand-diffの鮮度チェックが警告してくれます。気づかないまま使うことは避けられます。 --auto-updateは個人の作業向き: 一人で Claude Code にコミットまで任せるなら便利です。複数人が並行して PR を出すチームでは、上の衝突の問題が先に立ちます。
導入時の注意点:初回解析のトークン消費
README 自身が「初回の /understand はコードベース全体を解析するため、大きなプロジェクトではかなりのトークンを消費する」と注意を促しています。Tree-sitter による構造の抽出は LLM を使いませんが、意味付けの段階では LLM のトークンを消費します。
対策として README が挙げているのは次の 2 点です。
- 従量課金の API ではなく、サブスクリプションのプランで実行する
- プライバシーや企業要件がある場合は、Ollama などのローカルモデルに切り替える
2 回目以降はデフォルトでインクリメンタル(変更されたファイルだけ再解析)なので、消費は大きく減ります。
まとめ
Understand-Anything は、Tree-sitter による決定的な構造解析と、LLM エージェントによる意味付けを組み合わせ、コードベースを「読める地図」に変えるツールです。次のような場面で効果を発揮しそうです。
- 知らないコードベースに入るときのオンボーディング
- 変更前の影響範囲の確認
- グラフをコミットして、LLM なしでもチーム全員が閲覧
初回のトークン消費にさえ気をつければ、まず手元の中規模リポジトリで /understand を試してみる価値は十分にあるでしょう。ライブデモではインストールせずにダッシュボードを触ることもできます。