「読んでいた。やはり評価。」
iwashi(岩瀬義昌)氏が2026年9月15日、X にこうポストしていた。
読んでいた。やはり評価。
リンク先は、LayerX の堤大貴氏(@ozro_223)が同日 Speaker Deck に公開したスライド「AIエージェントの自己改善をどう設計するか」の22枚目、最後のページだ。そこには大きくこう書かれている。
改めて、評価が大事!!!
一言だけのポストだが、スライドを通読すると「やはり」の重みがわかる。エージェントの自己改善を、データ・最適化・探索と順に組み立てていくと、最後に残るのが評価の設計になる。
本記事では、スライドとその土台になっている著者の Zenn 記事2本を合わせて、次の3点を順に見ていく。自己反省だけでは頭打ちになる理由、ハーネス側で組む4つの仕組み、そして人間に残る評価の設計だ。
- Zenn 記事①:自己改善エージェントはなぜ前提を覆せないのか ― 局所最適とハーネスでの脱出(2026年6月)
- Zenn 記事②:Agent Skills自動最適化の研究、中身はほぼ深層学習の訓練ループだった(2026年7月)
背景 — Coding Agent がワークフローを作り、直す
著者のチームは、Coding Agent に AI ワークフロー(業務処理の自動化フロー)を構築させている。ループはおおむね次の4段階だ。
- ハーネス(エージェントを動かす周辺の仕組み。ツールやテスト、評価の実行基盤など)経由でワークフローを生成・デプロイする
- 入力資料に対してワークフローを実行する
- スキル(Agent Skills。SKILL.md に書く手順書)・テスト・評価基準を使って、実行結果をハーネスが採点する
- 期待との差分をモデルに返し、修正させる
3と4を回し続ければ、ワークフローは勝手に良くなっていく——はずだった。
現象 — 自己改善が90%で頭打ちになる
スライドが挙げる例は請求書の明細抽出だ。人間がチューニングすると 98〜99% の精度に届くタスクが、エージェントの自己改善だけだと 90% 前後で頭打ちになった。
停滞中にエージェントが出してくる改善案を見ると、中身は「プロンプトに条件を足す」「文字列を置換する」ばかりだった。処理の順序を変えたり、設計そのものを組み替えたりする提案は出てこない。
なぜ前提を覆せないのか — 自己反省では局所最適を抜けられない
著者の診断はこうだ。停滞の原因はモデルの知能不足ではない。最初に書いた要件定義書や設計がアンカー(錨)になり、探索範囲が狭まることにある。エージェント自身に反省させても、その範囲は広がらない。
結果として、以降の改善は初期設計の近傍の修正に閉じてしまう。近くでは最良だが全体では最良でない、局所最適の状態だ。スライドはこの失敗パターンを支える研究として2つを挙げている。
- アンカリング効果(Lou & Sun, 2024):最初に与えられた情報が判断を引きずる。反省させるだけでは十分に緩和できない
- Degeneration-of-Thought(Liang et al., 2024):初回の答えに自信を持つと、自己反省を挟んでも発散的な思考が減っていく
つまり「もっとよく考えて」と頼んでも、同じ文脈で同じ候補を磨き続ける限り、探索は狭まる一方になる。モデルが賢くなれば解決する問題でもない。
Zenn 記事①ではさらに Feedback Friction にも触れている。正解を見せても、LLM が確信度の高い誤答を直しきれない現象だ。そのため、ある程度の頭打ちは避けられない可能性もあるとしている。
そこで著者は発想を切り替える。エージェントの自己改善能力に期待するのではなく、同じ場所で停滞させない構造をハーネス側で用意する。
自己改善ループは深層学習の訓練ループに対応する
Zenn 記事②は、2026年上半期の Agent Skills 自動最適化の研究を見渡している。そして、どれも構造的には深層学習の訓練ループだと指摘する。違うのは、更新されるのがモデルの重みではなく SKILL.md のようなテキストやワークフローのコードだという点だけだ。
スライドはこの対応を、自己改善を構成する4つの仕組みとして整理している。
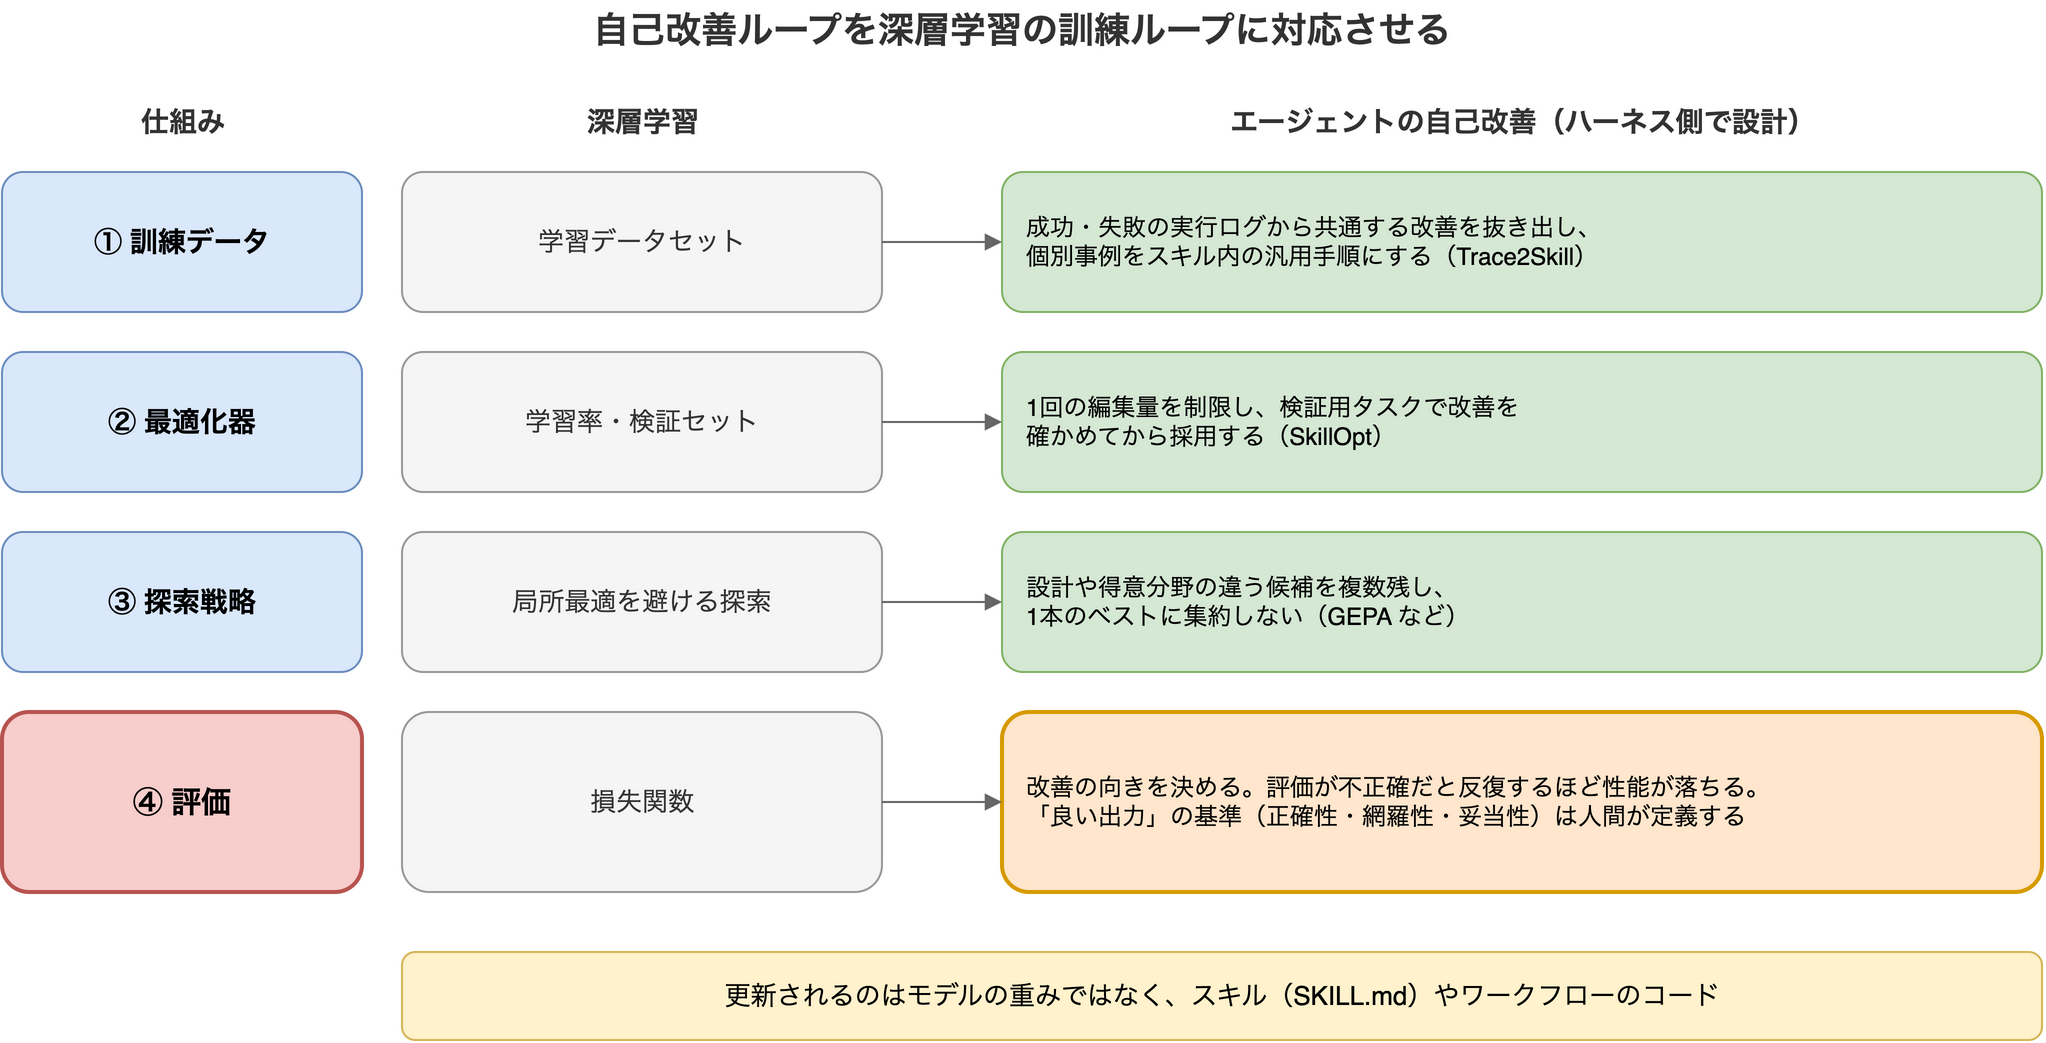
① 訓練データ — 実行ログを汎用手順に変える
成功・失敗の実行ログ(トラジェクトリ)から、繰り返し現れる改善を抜き出す。個別事例への場当たり的なパッチではなく、スキル内の汎用的な手順として書き直す(参照: Trace2Skill / Ni et al., 2026)。
② 最適化器 — 一度に大きく変えない
1回の反復で編集できる量を制限し、検証用のタスクで改善が確認できたものだけを採用する。深層学習でいえば学習率と検証セットにあたる(参照: SkillOpt / Y. Yang et al., 2026)。
③ 探索戦略 — ベストを1本に絞らない
設計や得意分野の異なる候補を複数保持し、局所最適を避ける。ある入力タイプには強いが別のタイプには弱い、という候補も捨てずに残す(参照: GEPA / Agrawal et al., 2026、Diverse Prompts / Santos et al., 2025)。
Zenn 記事①ではこの方向をさらに掘り下げ、候補を木構造でアーカイブする DGM・HGM や、設計軸で候補を分類して空いているマスを埋めにいく MAP-Elites も紹介している。ただし DGM・HGM は数百〜1000時間超の CPU 時間を要するという計算コストの留保つきだ。
④ 評価 — 改善の向きを決める
最後が評価だ。スライドによれば、評価の質が改善の方向を決める。深層学習の損失関数にあたる部分で、本記事の本題でもあるので、次の節で詳しく見る。
評価が最後に残る
①〜③は、研究の蓄積をハーネスに組み込めばある程度まで自動化できる。④だけはそうはいかない。
スライドは OpenSkill(Z. Yan et al., 2026)のグラフを引いている。正解データを使わずに評価を作る手法自体は存在するが、評価が不正確だと反復を重ねるほど性能が落ちていく。Zenn 記事②によれば、ベンチマークの SocialMaze では反復3回目の 82.7% がピークで、10回目には 78.0% まで下がった。損失関数が間違っていれば、最適化はきちんと間違った方向へ進む。
スライドには運用上の注意として、正解データは最終確認にだけ使う、とも書かれている。
Zenn 記事②は、効果測定の難しさを示す数字として、スキルの効果を測るベンチマーク SWE-Skills-Bench の報告も挙げる。公開スキル49本のうち39本は合格率(pass rate)を改善せず、平均改善はわずか +1.2% だったという。スキルを「良くした」つもりでも、測ってみると良くなっていない。測る仕組みがなければ、それに気づくこともできない。
人間の役割 — 業務上の正しさを評価に落とす
では誰が評価を作るのか。スライドの答えは人間だ。業務上の成功基準を定義し、それを評価指標へ写像する。観点は3つ挙げられている。
| 観点 | 問い |
|---|---|
| 正確性 | 回答の事実・数値・分類・判断は、業務ルールと一致しているか |
| 完全性 | 回答に必要な情報や観点が、漏れなく含まれているか |
| 適切性 | 複数の答えがありうる場合に、業務の目的や文脈に合う判断をしているか |
Zenn 記事②は、機械的に判定できないドメインの評価——たとえばブログが「面白いか」——は自動化できず、「人間に残された最後の仕事」かもしれない、と結んでいる。
まとめ
スライドのまとめを整理すると、次のようになる。
- 同じ文脈で同じ候補を磨き続けると探索が狭まり、自己反省だけでは初期の前提から抜け出せない(局所最適)
- 自己改善は「訓練データ・最適化器・探索戦略・評価」の4つの仕組みで設計する
- 評価が改善の向きを決める
- 人間が「良い出力」の基準を定義しなければ、ループは正しく改善できない
エージェントにループを回させる設計は、いまや当たり前になりつつある。だが回す速さや候補の多さをいくら上げても、評価が間違っていれば間違った方向へ速く進むだけだ。iwashi 氏の「やはり評価。」は、この結論をひと言に畳んだものだろう。
参考
- AIエージェントの自己改善をどう設計するか / How to Design Self-Improvement for AI Agents(堤大貴, Speaker Deck, 2026-09-15)
- 自己改善エージェントはなぜ前提を覆せないのか ― 局所最適とハーネスでの脱出(堤大貴, Zenn, 2026-06-17)
- Agent Skills自動最適化の研究、中身はほぼ深層学習の訓練ループだった(堤大貴, Zenn, 2026-07-08)
- iwashi 氏のポスト