Microsoft の無料カリキュラム AI-For-Beginners のパート「II. シンボリック AI」、レッスン 02「知識表現とエキスパートシステム」を解説します。カリキュラム全体の構成は Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う に、前回のレッスン 01 は AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01 にまとめています。
レッスン 01 で紹介された 2 つのアプローチのうち、トップダウン側(記号的推論)を実際に組み立てるのがこの回です。要点は次の 3 つです。
- 知識をコンピュータで扱うには、「コンピュータが使える」と「表現力がある」の間でうまい形式を選ぶ必要がある
- エキスパートシステムは、知識ベース(ルール) と 推論エンジン を分けて作る。推論には、事実から結論へ進む 順方向 と、結論から事実へさかのぼる 逆方向 がある
- 同じ発想をウェブ規模に広げたのが オントロジーとセマンティックウェブ で、Wikidata などの知識グラフとして今も使われている
レッスン 02 には Jupyter Notebook が 3 本付いています。この記事では、そのコードを実際に動かした結果も載せます。動かしてみると、教材の説明だけでは気づかない不具合もいくつか見つかりました。一覧は末尾の「教材を読むときの補足」にまとめています。
教材の場所は次のとおりです。
知識とデータは別物 — DIKW ピラミッド
レッスンはまず「知識とは何か」を整理します。本には知識が詰まっているように思えますが、教材によれば、本に入っているのは データ です。読んで自分の世界の理解(世界モデル)に組み込んだとき、はじめてそれが 知識 になります。
この区別を 4 段階で示すのが DIKW ピラミッド です。
| 段階 | 意味 | 教材の例 |
|---|---|---|
| データ(Data) | 文字や音声など、物理的な媒体に記録されたもの。人間とは独立に存在し、人から人へ渡せる | 「コンピュータ」という文字列 |
| 情報(Information) | データを頭の中で解釈したもの | 「コンピュータ」と聞いて、それが何かわかる |
| 知識(Knowledge) | 情報が世界モデルに統合されたもの。関連する概念のネットワーク | どう動くか、いくらするか、何に使えるかまで知っている |
| 知恵(Wisdom) | 知識をいつ、どう使うべきかというメタ知識 | — |
知識表現 の問題とは、この「知識」をコンピュータの中でデータとして表し、自動で使えるようにする方法を見つけることです。
知識表現の 4 分類
教材は、知識表現を 1 本のスペクトルとして描きます。左端はアルゴリズム(プログラム)で、コンピュータはそのまま実行できますが、柔軟性がありません。右端は自然言語のテキストで、表現力はいちばん高いものの、自動推論には使えません。実用的な知識表現は、この両端の間にあります。
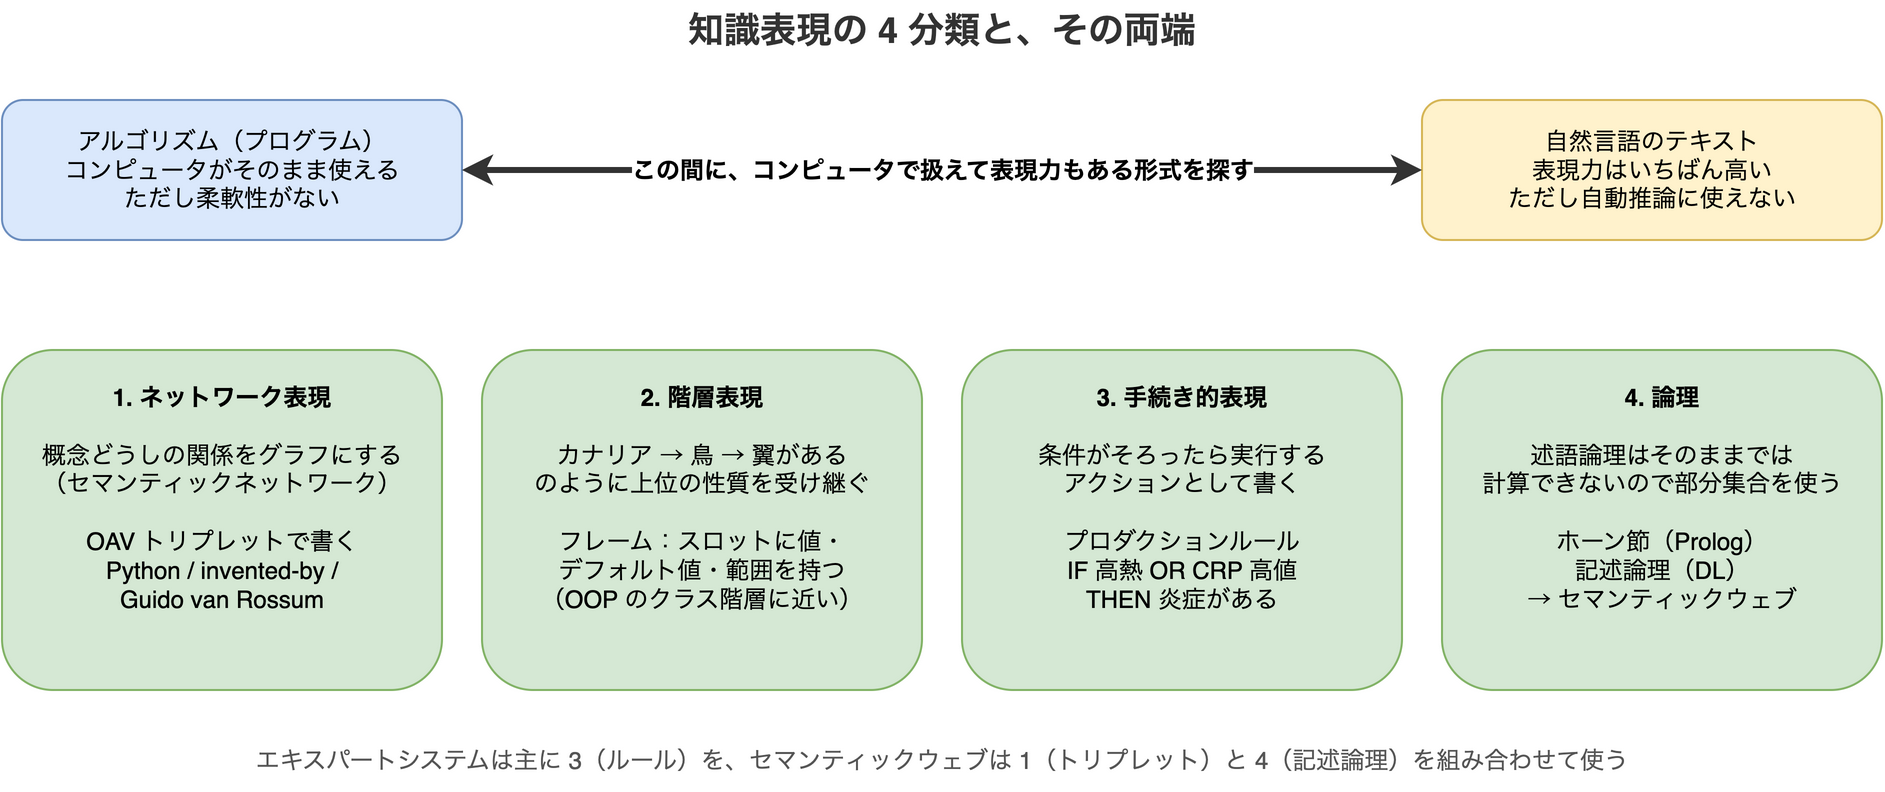
1. ネットワーク表現(セマンティックネットワーク)
頭の中の「関連し合う概念のネットワーク」を、そのままグラフとして持つ方法です。グラフはノードとエッジのリストで表せるので、オブジェクト・属性・値(OAV)のトリプレット の並びとして書けます。教材の例は次のとおりです。
| オブジェクト | 属性 | 値 |
|---|---|---|
| Python | is | Untyped-Language |
| Python | invented-by | Guido van Rossum |
| Python | block-syntax | indentation |
| Untyped-Language | doesn’t have | type definitions |
このトリプレットという形は、この先のエキスパートシステムやセマンティックウェブにもそのまま出てきます。
2. 階層表現(フレーム)
「カナリアは鳥で、鳥にはすべて翼がある」のように、上位の概念の性質を下位が受け継ぐ構造を表します。代表が フレーム表現 です。オブジェクトごとに スロット を持ち、スロットには値、デフォルト値、値の範囲などを入れます。フレーム全体は、オブジェクト指向言語のクラス階層に似た階層を作ります。
| スロット | 値 | デフォルト値 | 範囲 |
|---|---|---|---|
| Name | Python | ||
| Is-A | Untyped-Language | ||
| Variable Case | CamelCase | ||
| Program Length | 5〜5000 行 | ||
| Block Syntax | Indent |
時間とともに展開する状況を表す特殊なフレームは、シナリオ と呼ばれます。
3. 手続き的表現(プロダクションルール)
「ある条件が成り立ったら、このアクションを実行する」という形で知識を書きます。中心になるのが if-then 形式の プロダクションルール です。教材の例は医師の診断で、「IF 高熱がある OR 血液検査で CRP(C 反応性タンパク)が高い THEN 炎症がある」というルールです。ここで導いた「炎症がある」という結論は、次の推論の材料になります。
アルゴリズムも手続き的表現の一種ですが、知識ベースシステムで直接使われることはほとんどありません。
4. 論理
アリストテレス以来の、論理で知識を表す方法です。述語論理は表現力が豊かすぎてそのままでは計算できないので、実際には部分集合を使います。Prolog の ホーン節 や、オブジェクトの階層を扱う 記述論理(Description Logic) がその例で、後者は後述のセマンティックウェブの土台になっています。
エキスパートシステムの仕組み
記号的 AI の初期の成功例が エキスパートシステム です。限られた分野で専門家のように振る舞うシステムで、1 人以上の専門家から取り出した 知識ベース と、その上で推論する 推論エンジン からできています。
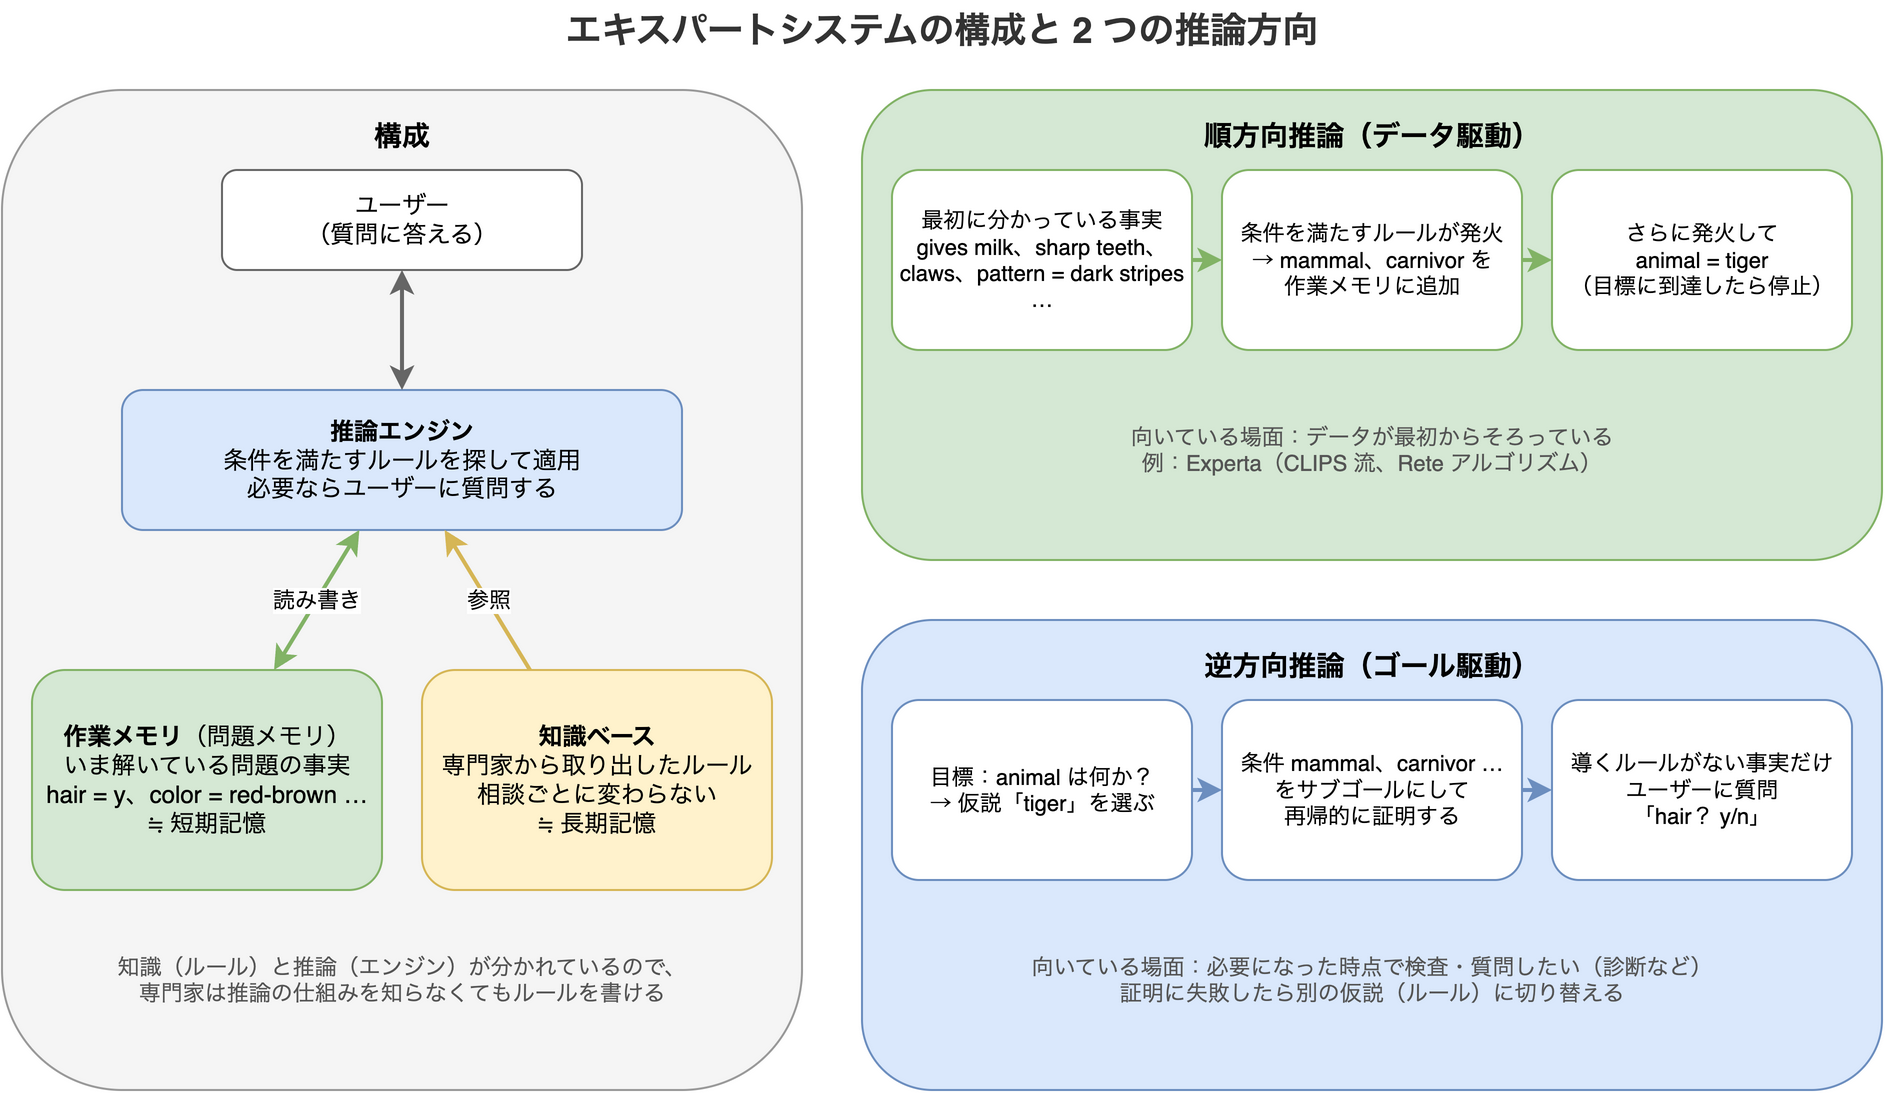
教材は、この構成を人間の短期記憶と長期記憶になぞらえています。
- 問題メモリ(作業メモリ): いま解いている問題についての知識。患者の体温や血圧、炎症があるかどうか、など。現在の問題状態のスナップショットなので 静的知識 とも呼ばれる
- 知識ベース: その分野についての長期的な知識。専門家から手作業で取り出し、相談ごとには変わらない。ある問題状態から次の状態へ進むための知識なので 動的知識 とも呼ばれる
- 推論エンジン(ルールエンジン): 問題状態の探索全体を仕切り、各状態で適用すべきルールを探す。必要ならユーザーに質問する
「変わる作業メモリが静的、変わらない知識ベースが動的」という呼び方は、直感とは逆に感じるかもしれません。これは、状態のスナップショットなのか、状態を先へ進める知識なのか、という観点での呼び分けです。
大事なのは、知識と推論が分かれていることです。そのおかげで、分野の専門家は推論の仕組みを知らなくてもルールを書けます。教材が「高水準言語で直接プログラムするのは良い考えではない」と言い、専用の エキスパートシステムシェル を勧めているのもこのためです。
ルールと AND-OR ツリー
教材の例は、身体の特徴から動物を当てるエキスパートシステムです。専門家から知識を引き出す段階では、条件の AND と OR を木構造で描いた AND-OR ツリー が便利です。コンピュータに載せるときは、それをルールの形に直します。
IF the animal eats meat
OR (animal has sharp teeth
    AND animal has claws
    AND animal has forward-looking eyes
)
THEN the animal is a carnivore
ルールの条件も結論も、中身は OAV トリプレット(「動物・食べる・肉」など)です。作業メモリ には今の問題に関するトリプレットが入り、ルールエンジン は条件を満たすルールを見つけて適用し、新しいトリプレットを作業メモリに追加していきます。
順方向推論と逆方向推論
推論の進め方には 2 通りあります。
順方向推論(データ駆動)
作業メモリにある初期データから出発し、次のループを回します。
- 目標の属性が作業メモリにあれば、停止して結果を返す
- 条件が満たされているルールをすべて集める(競合集合)
- 競合解決 で、このステップで実行するルールを 1 つ選ぶ。戦略には、知識ベースで最初に見つかったルール、ランダム、左辺の条件をいちばん多く満たす「より具体的な」ルール、などがある
- 選んだルールを適用し、新しい知識を問題状態に加える
- 1 に戻る
逆方向推論(ゴール駆動)
医療診断では、診察の前にすべての検査を済ませたりはしません。判断に必要になった時点で検査します。この進め方をモデル化したのが逆方向推論で、求めたい属性値(ゴール)から出発します。
- ゴールの値を結論(右辺)に持つルールを集める(競合集合)
- その属性を導くルールがない、またはユーザーに尋ねるべき属性なら、ユーザーに質問する
- そうでなければ、競合解決で 1 つのルールを選び、仮説 として証明を試みる
- そのルールの左辺にある属性を、それぞれサブゴールとして同じ手順で再帰的に証明する
- 途中で失敗したら、3 に戻って別のルールを試す
データが最初からそろっているなら順方向、質問を最小限にしたいなら逆方向が向いています。
ノートブック 1: 動物当てエキスパートシステムを動かす
ここからは付属のノートブックを実際に動かします。筆者は Python 3.14.7 の仮想環境で実行しました。ノートブックのセルを抜き出して順に実行し、ユーザーへの質問には、あらかじめ用意した回答を自動で返すようにしています。
自作シェルで逆方向推論
Animals.ipynb の前半では、逆方向推論のエキスパートシステムシェルを Python で自作します。知識ベースは、「結論 → 条件」の辞書として書きます。
rules = {
    'default': Ask(['y','n']),
    'color' : Ask(['red-brown','black and white','other']),
    'pattern' : Ask(['dark stripes','dark spots']),
    'mammal': If(OR(['hair','gives milk'])),
    'carnivor': If(OR([AND(['sharp teeth','claws','forward-looking eyes']),'eats meat'])),
    'ungulate': If(['mammal',OR(['has hooves','chews cud'])]),
    'bird': If(OR(['feathers',AND(['flies','lies eggs'])])),
    'animal:monkey' : If(['mammal','carnivor','color:red-brown','pattern:dark spots']),
    'animal:tiger' : If(['mammal','carnivor','color:red-brown','pattern:dark stripes']),
    'animal:giraffe' : If(['ungulate','long neck','long legs','pattern:dark spots']),
    'animal:zebra' : If(['ungulate','pattern:dark stripes']),
    'animal:ostrich' : If(['bird','long nech','color:black and white','cannot fly']),
    'animal:pinguin' : If(['bird','swims','color:black and white','cannot fly']),
    'animal:albatross' : If(['bird','flies well'])
}carnivor、pinguin、lies eggs、long nech などの綴りは原文のままです(誤記は「教材を読むときの補足」で扱います)。If の中のリストは AND、OR(...) は OR です。Ask は、ユーザーに尋ねる属性を表します。ルールに登場しない属性(hair など)は default の Ask で y/n を尋ねます。KnowledgeBase(rules).get('animal') を呼ぶと、animal:monkey から順に仮説を立て、条件をさかのぼって証明を試みます。
トラを思い浮かべて答えたときの対話は次のとおりです(→ の後ろが筆者の回答。見やすいように、質問と選択肢を 1 行にまとめています)。
hair         y/n → y
sharp teeth  y/n → y
claws        y/n → y
forward-looking eyes  y/n → y
color        0. red-brown / 1. black and white / 2. other → 0
pattern      0. dark stripes / 1. dark spots → 0
RESULT: tiger
質問は 6 回で済みました。mammal や carnivor は、ルールから導ける属性なので直接は尋ねていません。6 つの質問はすべて、最初の仮説 monkey を検証する途中で出たものです。pattern が dark spots ではないので、monkey は外れます。次の仮説 tiger は、必要な条件がすでに作業メモリにそろっています。そのため、追加の質問なしで確定します。作業メモリには、途中で導いた mammal: y や carnivor: y も残ります。
ただし、動かすと癖も見えてきます。キリンの特徴で答えると、次のようになりました(後半は省略)。
hair         y/n → y
sharp teeth  y/n → n
eats meat    y/n → n
carnivor     y/n → n
has hooves   y/n → y
...
RESULT: giraffe
carnivor の証明に失敗した直後、「carnivor ですか?」とユーザーに直接尋ねています。get メソッドは、ルールで証明できなかった属性を default の Ask に回すためです。答えは結果に影響しませんが、専門用語をそのまま聞き返されるのは、利用者から見ると不自然です。
Experta で順方向推論
ノートブックの後半では、順方向推論のライブラリ Experta を使います。古典的なエキスパートシステムツール CLIPS を模したライブラリで、ルールの照合には Rete アルゴリズム を使います。ルールは KnowledgeEngine を継承したクラスのメソッドに @Rule デコレータを付けて定義し、declare で新しい事実を追加します。
class Animals(KnowledgeEngine):
    @Rule(OR(Fact('hair'),Fact('gives milk')))
    def mammal(self):
        self.declare(Fact('mammal'))

    @Rule(Fact('mammal'),Fact('carnivor'),
          Fact(color='red-brown'),
          Fact(pattern='dark stripes'))
    def tiger(self):
        self.declare(Fact(animal='tiger'))
    # ...(ほかのルールは省略)
ノートブックと同じ初期事実(赤茶色、濃い縞模様、鋭い歯、爪、前向きの目、乳を出す)を与えて run() すると、mammal と carnivor が順に導かれ、最後に animal='tiger' が作業メモリに追加されます。
Animal is tiger
<f-7>: Fact('mammal')
<f-8>: Fact('carnivor')
<f-9>: Fact(animal='tiger')ところが、シマウマ(hair、has hooves、pattern='dark stripes')、キリン、アホウドリ(feathers、flies well)の事実を与えると、run() の途中で例外が出て止まります。
AttributeError: 'str' object has no attribute 'has_field_constraints'原因は、有蹄類と鳥のルールが Fact ではなく文字列を declare している点です。
    def hooves(self):
        self.declare('ungulate')   # 正しくは self.declare(Fact('ungulate'))

    def bird(self):
        self.declare('bird')       # 正しくは self.declare(Fact('bird'))
ノートブックはトラの例しか実行していないので、この不具合は表に出ません。2 か所を Fact(...) で包むと、シマウマもアホウドリも正しく推論できました(シマウマの出力は抜粋)。
Animal is zebra
<f-4>: Fact('mammal')
<f-5>: Fact('ungulate')
<f-6>: Fact(animal='zebra')
教材はこの演習に「ルールが 200 程度を超えるまでは、知的な振る舞いには見えない」と注意書きを付けています。それでも、知識ベースシステムには、どの結論もどのルールから出たのかを必ず 説明 できるという大きな特徴があります。上の出力でも、tiger の根拠が mammal と carnivor だったことを作業メモリからそのまま読み取れます。
オントロジーとセマンティックウェブ
20 世紀末には、知識表現でインターネット上のリソースに注釈を付け、非常に具体的な検索に答えられるようにしようという取り組みが生まれました。これが セマンティックウェブ で、次の 3 つの考え方に支えられています。
- 記述論理(DL) に基づく知識表現。フレームと同じく、性質を持つオブジェクトの階層を作るが、形式的な論理の意味論と推論を持つ。DL には、表現力と推論の計算量のバランスが異なる多くの種類がある
- すべての概念を世界で一意な URI で識別する分散型の知識表現。インターネット全体にまたがる知識の階層を作れる
- 知識を記述する XML ベースの言語群: RDF、RDFS(RDF スキーマ)、OWL
中心になる概念が オントロジー です。ある分野を、形式的な知識表現で明示的に定義したものを指します。いちばん単純なものはオブジェクトの階層だけですが、複雑なものは推論に使うルールも含みます。
セマンティックウェブでは、すべてがトリプレット(主語・述語・目的語)で表されます。教材の例は「このカリキュラムは Dmitry Soshnikov が 2022 年 1 月 1 日に作った」という事実です。
http://github.com/microsoft/ai-for-beginners http://www.example.com/terms/creation-date "Jan 1, 2022"
http://github.com/microsoft/ai-for-beginners http://purl.org/dc/elements/1.1/creator http://soshnikov.com
Wikidata を SPARQL で引く
セマンティックウェブの構想そのものは、検索エンジンと自然言語処理の成功に押されて失速しました。それでも、オントロジーや知識ベースを整備し続けている分野はあります。代表が Wikipedia と連動する知識ベースの Wikidata で、SPARQL(セマンティックウェブ用の問い合わせ言語)で検索できます。
教材には「人間の目の色の分布」を数えるクエリが載っています。上位 5 件だけを見るために ORDER BY と LIMIT を足して実行しました。
SELECT ?eyeColorLabel (COUNT(?human) AS ?count)
WHERE
{
  ?human wdt:P31 wd:Q5.       # human instance-of homo sapiens
  ?human wdt:P1340 ?eyeColor. # human eye-color ?eyeColor
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
GROUP BY ?eyeColorLabel
ORDER BY DESC(?count)
LIMIT 5
2026 年 9 月 30 日に実行した結果は次のとおりです。
| 目の色 | 人数 |
|---|---|
| brown | 6,853 |
| blue | 3,056 |
| dark brown | 1,334 |
| green | 1,149 |
| black | 849 |
wdt:P31 wd:Q5(「人間」のインスタンスである)のように、述語もクラスもすべて ID で指定するのが、URI で概念を識別するセマンティックウェブの流儀です。Wikidata は日々更新されるので、件数は実行する時期によって変わります。
オントロジーを自分で作ってみたい場合は、スタンフォード大学のビジュアルエディタ Protégé が紹介されています。
ノートブック 2: 家族オントロジーで親戚関係を推論する
FamilyOntology.ipynb では、ロマノフ家の家系図にオントロジーを組み合わせ、親戚関係を自動で推論します。
家系図は、系図データの標準形式 GEDCOM で書かれています(data/tsars.ged)。オントロジー(data/onto.ttl)は、「おじ」「いとこ」などの関係を、基本の述語 isMotherOf、isFatherOf、isBrotherOf、isSisterOf の組み合わせとして定義しています。たとえば「おば」は「親の姉妹」なので、OWL のプロパティチェーンで次のように書けます。
fhkb:isAuntOf a owl:ObjectProperty ;
    rdfs:domain fhkb:Woman ;
    rdfs:range fhkb:Person ;
    owl:propertyChainAxiom ( fhkb:isSisterOf fhkb:isParentOf ) .
ノートブックは、GEDCOM を python-gedcom で読み、個人と家族を Turtle 形式のトリプレットに変換して、オントロジーの末尾に書き足します。変換結果は、data/onto.ttl を作業フォルダにコピーした onto.ttl に追記されます。それを rdflib で読み込み、owlrl で 閉包(推論できるトリプレットをすべて追加した状態)を作ります。
import rdflib
from owlrl import DeductiveClosure, OWLRL_Extension

g = rdflib.Graph()
g.parse("onto.ttl", format="turtle")
print("Triplets found:%d" % len(g))

DeductiveClosure(OWLRL_Extension).expand(g)
print("Triplets after inference:%d" % len(g))
rdflib 7.6.0 と owlrl 7.6.2 で実行した結果は、ノートブックに記録された出力と同じでした。
Triplets found:669
Triplets after inference:4246
669 個の事実から、推論で 3,500 個以上のトリプレットが増えています。あとは SPARQL で「おじ」を問い合わせるだけです。
qres = g.query(
    """SELECT DISTINCT ?aname ?bname
       WHERE {
          ?a fhkb:isUncleOf ?b .
          ?a rdfs:label ?aname .
          ?b rdfs:label ?bname .
       }""")
for row in qres:
    print("%s is uncle of %s" % row)
Aleksandr I Pavlovich Romanov is uncle of Aleksandr II Nikolaevich Romanov
Fedor Alekseevich Romanov is uncle of Ekaterina Ivanovna Romanova
Fedor Alekseevich Romanov is uncle of Anna Ivanovna Romanova同じ方法で isAuntOf(おば)は 4 組、isGrandfatherOf(祖父)は 19 組見つかりました。家系図には「親子」と「兄弟姉妹」しか書いていないのに、オントロジーの定義だけで関係が次々に導かれるのが、この演習の見どころです。
ただし、推論の結果は、入力した事実の正しさを超えられません。
たとえば、エカテリーナ・イワノヴナとアンナ・イワノヴナの父イワン 5 世と、ピョートル 1 世は異母兄弟です。それなのに、ピョートル 1 世は 2 人の「おじ」として出てきません。
原因は、GEDCOM を変換するコードが、同じ両親を持つ子どもどうしにしか兄弟関係を付けないことです。オントロジーの推論は正しく動いていて、元の事実のほうに抜けがあります。
日本語版のノートブックはそのままでは動かない
translations/ja/lessons/2-Symbolic/ には日本語版のノートブックがありますが、data/ フォルダがありません。日本語版の FamilyOntology.ipynb も data/tsars.ged を読みにいくので、その場で実行するとファイルが見つからずに失敗します。英語版の lessons/2-Symbolic/ で実行するか、リポジトリのルートで次のようにシンボリックリンクを張ってから実行してください。
ln -s ../../../../lessons/2-Symbolic/data translations/ja/lessons/2-Symbolic/dataノートブック 3: 概念グラフでニュースを分類する
レッスンの最後は、手作業ではなく、テキストから自動で マイニング したオントロジーの話です。例として、Microsoft Research の Microsoft Concept Graph が紹介されています。is-a 関係でエンティティをまとめた巨大なグラフで、「Microsoft とは何か?」に「確率 0.87 で会社、0.75 でブランド」のように答えられます。
付属の MSConceptGraph.ipynb は、ニュースの見出しから名詞句を取り出し、それぞれの上位概念(「国」「企業」など)で見出しを分類する演習です。
ただし、この演習は現状ではそのまま動きません。
- README は「REST API として利用できる」と書いているが、ノートブックの冒頭には「Microsoft Concept Graph の API はもう使えない」という注記がある
- コードは 2026 年 2 月のコミットで、代わりの ConceptNet の API を使うように書き換えられた
- その ConceptNet の API(
api.conceptnet.io)も、2026 年 9 月 30 日の時点では 502 エラーを返していた - ノートブックに残っている出力は 2022 年のニュース見出しで、書き換え前のもの
- 見出しの取得には、別途ニュース API(NewsAPI.org)のキーが必要
この演習は、「概念グラフで見出しを抽象化するとどうなるか」を読んで理解するにとどめるのが現実的です。
レッスンの結論 — 明示的な推論は今も使われる
教材は、今では AI が機械学習やニューラルネットワークとほぼ同じ意味で使われていることを認めたうえで、こう結んでいます。「人間は明示的な推論も行っており、ニューラルネットワークはそれをまだうまく扱えていない。説明が必要な作業や、システムの振る舞いを制御しながら変えたい場面では、明示的な推論が今も使われている」と。
ノートブックを動かしてみると、この主張がよくわかります。エキスパートシステムは、なぜその結論になったのかを作業メモリから説明できます。家族オントロジーでは、「おば」の定義を 1 行変えるだけで、推論結果全体を制御できます。どちらも、学習データから重みを決めるニューラルネットワークにはない性質です。
教材を読むときの補足
細部で補っておきたい点を、用語、リンクと翻訳、ノートブックの 3 つに分けてまとめます。用語の誤りとノートブックの不具合は英語版・日本語版に共通で、翻訳の問題は日本語版だけのものです。
用語の誤り
- 「Descriptive Logic」は「Description Logic」: 論理の節では「Descriptive Logic」と書かれていますが、正しい名称は Description Logic(記述論理)です。後半のセマンティックウェブの節では、正しく description logics と書かれています
- OWL は「Web Ontology Language」: 教材は「Ontology Web Language」と書いていますが、W3C の正式名称は Web Ontology Language です(略称は OWL)
- Python は「型のない言語」ではない: トリプレットの例で Python を「Untyped-Language」としていますが、Python は型宣言を書かなくてよいだけで、値には型があります(動的型付け)。例の中身は正確でなくてもよいのですが、そのまま覚えないようにしてください
http://www.example.com/terms/creation-dateは標準の URI ではない: 教材はこれを「よく知られた、広く受け入れられている URI」と説明していますが、example.comは例示用に予約されたドメインです。作成日を表す標準の語彙としては、Dublin Core のhttp://purl.org/dc/terms/createdなどがあります。もう一方のhttp://purl.org/dc/elements/1.1/creatorは、実在する Dublin Core の語彙です
リンクと翻訳
- FamilyOntology.ipynb へのリンクがフォーク先を指している: 英語版・日本語版とも、本文のリンク先は
microsoft/AI-For-Beginnersではなく、個人のフォーク(Ezana135/AI-For-Beginners)です。フォークは 2023 年 7 月から更新されていないので、本家のlessons/2-Symbolic/FamilyOntology.ipynbを開いてください - 日本語版の「生産ルール」は「プロダクションルール」: production rule の直訳ですが、日本語では「プロダクションルール」と呼ぶのが一般的です
ノートブックの不具合
- Experta 版の有蹄類と鳥のルールが
Factではなく文字列をdeclareしているため、シマウマ・キリン・鳥類は推論の途中で例外になる(前述) - 自作シェル版のダチョウのルールは、
long neckがlong nechと綴り間違いになっていて、ユーザーには「long nech」と質問される。鳥のルールのlies eggsも、Experta 版のlays eggsと食い違っている
レッスンの進め方
レッスン 02 はノートブックを動かすのが中心ですが、付属の課題を使うと理解がさらに定着します。
- 講義前・講義後のクイズ: 講義前 と 講義後 で理解度を確認できる
- 本文中の ✅ の問い: 「自分の頭の中の知識を、どんな形式でノートに書き出しているか」「好きなテーマで AND-OR ツリーを描いてみる」「順方向推論と逆方向推論、それぞれどんな場面に向くか」など
- 🚀 チャレンジ: 家族オントロジーのノートブックで、ほかの家族関係を試す。オントロジーには祖先関係
isAncestorOfのような再帰的な定義もある - 課題「オントロジーを作ろう」: 人・場所・ものなどのテーマを 1 つ選び、Protégé でオントロジーを作る。教材の例は「リビングルーム」で、家具や照明を定義したうえで、キッチンや浴室、ダイニングとどう区別するかを考える
- 復習と自主学習: ブルームのタキソノミー、リンネの生物分類、メンデレーエフの周期表など、人類が知識を体系化してきた例を調べる
課題のオントロジー作りは、「リビングとダイニングを何で見分けるか」を言葉にする作業です。レッスン 01 で見た「専門家から知識を取り出す難しさ」を、自分で体験できます。
まとめ
- 知識はデータとは別物で、DIKW ピラミッドでは情報が世界モデルに統合されたものと位置づけられる。知識表現は、「コンピュータが使える」と「表現力がある」の間で形式を選ぶ問題
- 知識表現は、ネットワーク(トリプレット)、階層(フレーム)、手続き(プロダクションルール)、論理の 4 種類に分けられる
- エキスパートシステムは、知識ベースと推論エンジンを分けて作る。事実から進む順方向推論と、ゴールからさかのぼって必要な質問だけをする逆方向推論がある
- 同じ考え方をウェブ規模に広げたのがオントロジーとセマンティックウェブ。Wikidata は SPARQL で今も引けるし、OWL の推論ではわずかな定義から親戚関係を大量に導ける
- ノートブックは動かすと学べることが多い。一方で、Experta 版の例外、概念グラフ API の停止、日本語版の
data/欠落などがあるので、「教材を読むときの補足」を手元に置いて進めるとよい
次のパート「III. ニューラルネットワーク」では、トップダウンとは反対のボトムアップ側に移り、パーセプトロンを自分で作るところから始まります(解説: ニューラルネットワークの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 03〜05)。