Microsoft の無料カリキュラム AI-For-Beginners の最初のレッスン、「I. AI 入門 / 01 AI の紹介と歴史」を解説します。カリキュラム全体の構成や使い方は、別記事の Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う にまとめました。
レッスン 01 にはコードも Notebook もありません。そのぶん、この先 23 レッスンを読むための「地図」を渡す回になっています。要点は次の 3 つです。
- AI が扱うのは「手順を書き出せない問題」である
- 知能をコンピュータに載せる方法は、大きく トップダウン(記号的推論)と ボトムアップ(ニューラルネットワーク)の 2 つ
- 歴史的には前者から後者へ主役が移り、今の「AI」はほぼニューラルネットワークを指す
教材の場所は次のとおりです。
AI とは「手順を書けない問題」を解く分野
レッスンは、コンピュータの原点から話を始めます。19 世紀に機械式計算機を設計したチャールズ・バベッジの時代から、コンピュータは「明確に定義された手順(アルゴリズム)」に従って計算する機械として作られてきました。したがって、ゴールまでの手順を正確に書き出せる問題なら、普通のプログラムで解けます。
ところが、手順を書き出せない問題があります。教材の例は 写真から人の年齢を当てる ことです。私たちは大勢の人を見てきた経験からなんとなく年齢を推定できますが、頭の中で何をしているかは説明できません。説明できないので、if 文にも書けません。
このように、人間は経験から身につけているが、やり方を明示できないタスクこそが AI の対象だ、というのがこのレッスンの定義です。ポイントは、「賢いこと」一般ではなく「手順化できないこと」に焦点を当てている点です。以降のレッスンで出てくる「データから学習する」という発想も、すべてこの問題設定から来ています。
弱い AI と強い AI(AGI)
次に、AI を到達レベルで 2 つに分けます。
| 弱い AI | 強い AI(AGI) | |
|---|---|---|
| 対象 | 特定のタスク、または狭い範囲のタスク | 人間ができる知的タスクなら何でも |
| 理解・意識 | 持たない。決められた仕事が得意なだけ | 人間並みの理解を持ち、分野をまたいで適応する |
| 例 | Siri や Alexa、動画配信のレコメンド、特定業務のチャットボット | 教材の時点では「理論上の概念」で、実現例はない |
AGI(Artificial General Intelligence、汎用人工知能)は AI 研究の長期目標とされています。ただし、2026 年の今読むと、この表は少し単純すぎます。LLM は要約・翻訳・コード生成など幅広いタスクをこなすので、「特定タスク専用」という弱い AI の説明には当てはまりません。一方で、AGI と呼べるかどうかについては定義そのものに合意がありません。この表は「弱い/強い」を二択で覚えるためのものではありません。「どこまでできれば知能と呼べるのか」という次の節の問いへの導入として読むのがよいでしょう。
知能の定義とチューリングテスト
「知能」という言葉には、実は明確な定義がありません。教材は「猫は知能を持っているか?」と問いかけます。人によって答えが分かれますし、猫に IQ テストを受けさせるわけにもいきません。
そこで、定義の代わりに 判定方法 を与えたのがアラン・チューリングです。1950 年に提案された チューリングテスト では、人間の審査員がテキストだけで相手と対話し、相手が人間かコンピュータかを見分けられなければ、そのシステムは知能を持つとみなします。「知能とは何か」を定義する代わりに、「人間と区別できるか」に置き換えたわけです。
教材が挙げる事例が、2014 年のチャットボット Eugene Goostman です。このボットは最初に「13 歳のウクライナ人の少年」と名乗りました。知識不足や不自然な受け答えを「子どもだから」と思わせる作戦です。その結果、5 分間の対話で審査員の約 3 割に人間だと思わせました。この「5 分間の対話で 3 割をだませる」という水準は、チューリングが 1950 年の論文で「2000 年までに機械が到達する」と予想したものにあたります。ただし教材は、これは知能を持つシステムができた証拠ではなく、「ボットではなく作者が人間を欺いたのだ」と釘を刺しています。
この指摘は今こそ重要です。LLM は人間らしい文章を書くことにかけては Eugene Goostman とは比べものになりません。2025 年に公開された研究では、ペルソナを指示した GPT-4.5 が、3 者間のチューリングテスト(審査員が人間 1 人と AI 1 体と同時に話し、どちらが人間かを選ぶ形式)で 73% の確率で人間だと判定されています(Jones & Bergen, 2025)。当てずっぽうなら 50% になる形式なので、本物の人間より人間らしいと判定されたことになります。「人間と区別できない」ことと「人間と同じように理解している」ことは別物で、チューリングテストが測っているのは前者だけです。
知能を載せる 2 つのアプローチ
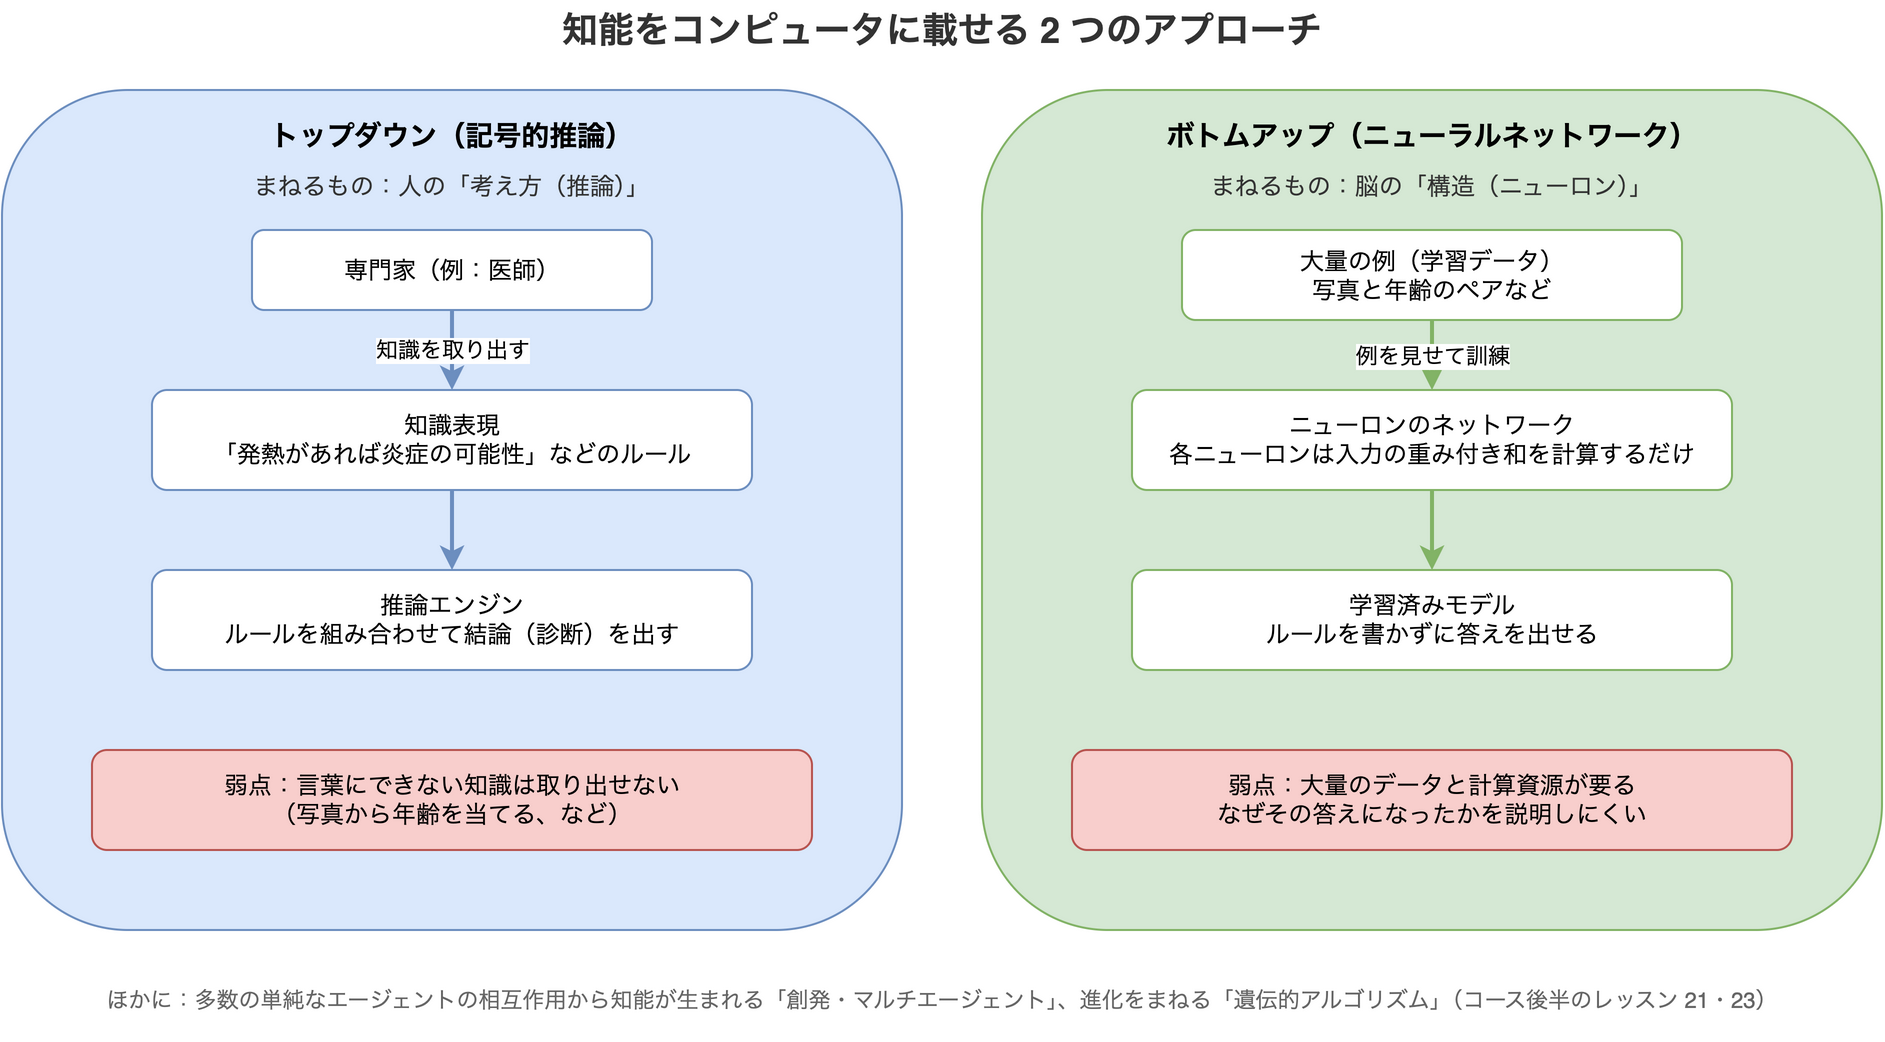
コンピュータに人間のような振る舞いをさせるには、人間の考え方をなんらかの形でモデル化する必要があります。自分の頭の働きを振り返ると、猫と犬を見分けるような無意識の処理と、筋道を立てて考える推論の 2 種類があることに気づきます。これに対応して、アプローチも 2 つに分かれます。
トップダウン(記号的推論)
人が推論するときの 考え方 をまねる方法です。医師の診断を例にとると、「発熱がある → 体内で炎症が起きているかもしれない」といったルールを大量に組み合わせて、最終的な診断にたどり着きます。こうした知識をコンピュータが読める形で表現し(知識表現)、それを使って結論を導く仕組み(推論)を作ります。
難しいのは、専門家から知識を取り出す部分です。医師自身、なぜその診断に至ったのかを正確に説明できないことがよくあります。そして写真から年齢を当てるようなタスクは、そもそもルールの操作に還元できません。
このアプローチはレッスン 02「知識表現とエキスパートシステム」で詳しく扱います(解説: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02)。
ボトムアップ(ニューラルネットワーク)
こちらは脳の 構造 をまねます。脳は ニューロン と呼ばれる単純な素子が大量につながったものです。コンピュータの中に人工のニューラルネットワークを作り、例(学習データ)を見せて訓練します。赤ちゃんが周りを観察しながら世界を覚えていくのに近い、と教材は説明しています。1 つ 1 つのニューロンがしているのは、入力にそれぞれ重みを掛けて足し合わせる程度の単純な計算です(教材は「入力の加重平均のように働く」と表現しています)。
このアプローチがレッスン 03 以降の本題で、パーセプトロンから始まって Transformer まで続きます。
その他のアプローチ
教材はほかに 2 つを挙げています。
- 創発的・マルチエージェント的アプローチ: 多数の単純なエージェントが相互作用することで、複雑な知的振る舞いが生まれるという考え方
- 進化的アプローチ(遺伝的アルゴリズム): 生物の進化の原理を使った最適化
これらはコース後半で扱います(遺伝的アルゴリズムはレッスン 21、マルチエージェントはレッスン 23)。
なお、教材は「機械学習(ML)」を、データに基づいて問題を解くことをコンピュータに学ばせる AI の一分野として位置づけています。回帰や決定木のような古典的な機械学習はこのコースでは扱わず、姉妹カリキュラムの ML-For-Beginners に任せています。
AI の簡単な歴史
2 つのアプローチを踏まえて、歴史をたどります。
記号的推論の時代と AI の冬
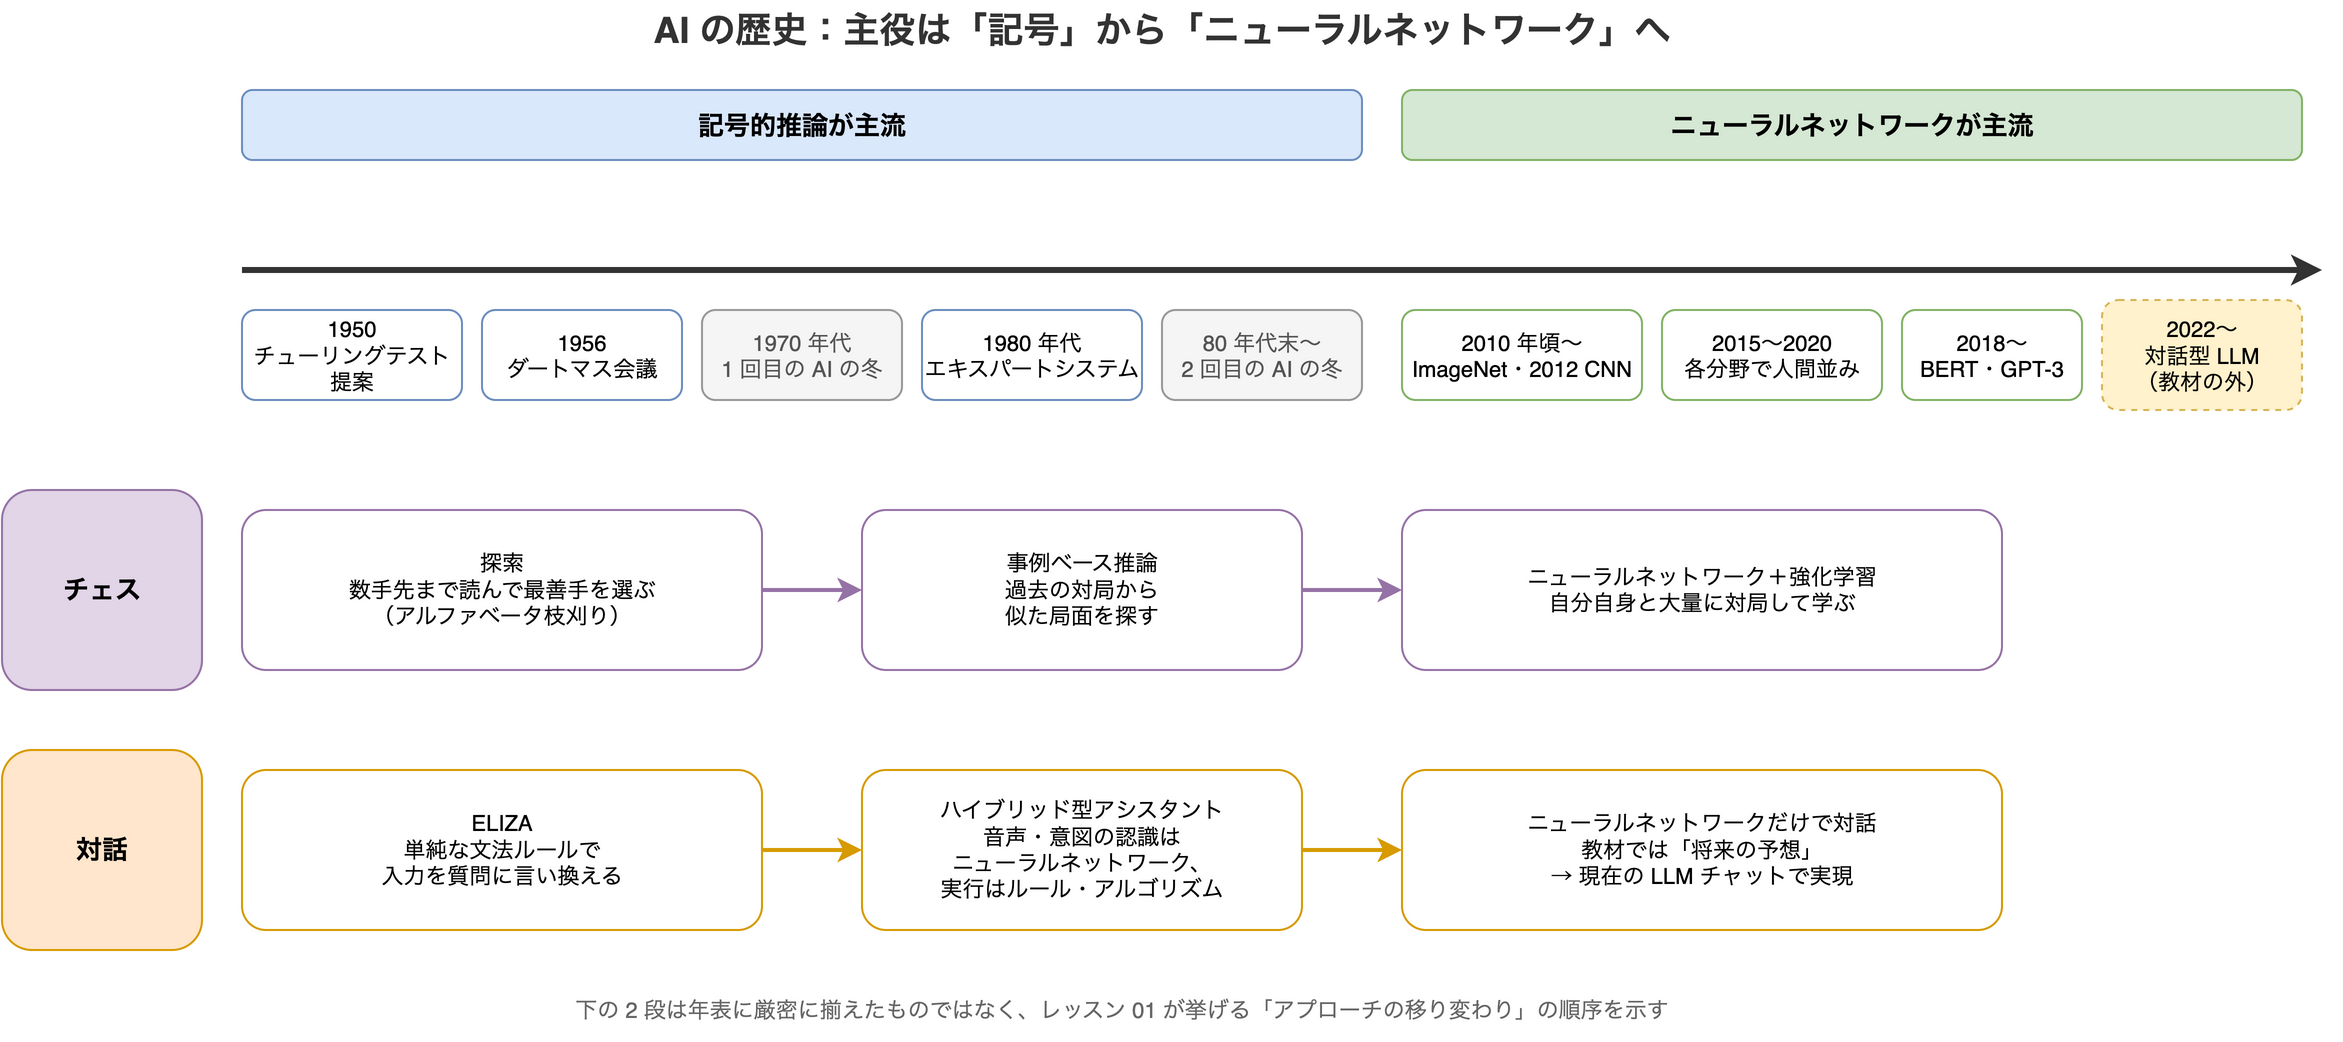
AI が研究分野として始まったのは 20 世紀半ばです。当初は記号的推論が主流で、限られた分野で専門家のように振る舞う エキスパートシステム などの成功を生みました。しかし、専門家から知識を取り出し、コンピュータで表現し、その知識ベースを正確に保ち続けるのは、非常に複雑で高くつく作業でした。こうして研究への期待と資金がしぼむ AI の冬 が訪れます。
年代については教材の書き方が少し圧縮されているので、正確な対応は後述の「教材を読むときの補足」で整理します。
ニューラルネットワークの時代へ
時代が進んで計算資源が安くなり、使えるデータが増えると、ニューラルネットワークがコンピュータビジョンや音声理解などで人間に迫る性能を見せ始めます。教材は、ここ 10 年ほど「AI」という言葉はほぼニューラルネットワークと同じ意味で使われている、と書いています。
チェスと対話に見るアプローチの移り変わり
教材の面白いところは、同じ課題に対するアプローチの変化を 2 つの題材で見せている点です。
チェス
- 初期のプログラムは 探索 が中心でした。相手の手を数手先まで読み、到達できる最善の局面から次の一手を選びます。ここから、明らかに不利になる手の先は読まずに済ませる アルファベータ枝刈り という探索の省略法が生まれました
- 探索は終盤のように手が限られる局面では強いものの、序盤は探索空間が広すぎます。そこで、人間同士の過去の対局から学ぶ方向に進みました。現在の局面によく似た過去の局面を知識ベースから探して手を選ぶ方法で、事例ベース推論 と呼ばれます
- 現在人間に勝つプログラムは、ニューラルネットワークと強化学習(勝ち負けなどの結果を報酬にして、試行錯誤で学ぶ方法)を使い、自分自身と大量に対局して自らのミスから学びます。人間の上達の仕方に似ていますが、コンピュータは桁違いの数の対局を短時間でこなせます
対話(チューリングテストを目指すプログラム)
- 初期の ELIZA は、単純な文法ルールで入力文を質問の形に言い換えるだけでした
- Cortana、Siri、Google アシスタントのような現代のアシスタントは ハイブリッド型 です。音声のテキスト化や意図の認識はニューラルネットワークが担い、その後の操作は推論や明示的なアルゴリズムで実行します
- 将来は、ニューラルネットワークだけで対話をこなすモデルが登場するだろう、と教材は予想しています。その例として挙がっているのが GPT と Microsoft の Turing-NLG です
3 番目の「予想」は、2022 年以降の対話型 LLM で現実になりました。教材が書かれたのは GPT-3 の時代なので、予想からわずか数年で実現したことになります。なお、例に挙がっている Cortana は、Windows のスタンドアロンアプリとしては 2023 年にサポートを終えています。
最近の AI 研究 — ImageNet から LLM まで
ニューラルネットワーク研究が急成長したのは 2010 年頃からで、大規模な公開データセットが使えるようになったことがきっかけです。代表が、注釈付き画像約 1,400 万枚を集めた ImageNet と、それを使った画像認識コンテスト ILSVRC です。
2012 年、畳み込みニューラルネットワーク(CNN)が初めて画像分類に使われ、エラー率が大きく下がりました(教材の表現では「約 30% から 16.4% へ」)。以降、ニューラルネットワークはさまざまなタスクで人間と同等の水準に達していきます。
| 年 | 人間と同等に達したタスク |
|---|---|
| 2015 | 画像分類 |
| 2016 | 会話音声の認識 |
| 2018 | 機械翻訳(中国語 → 英語) |
| 2020 | 画像キャプション生成 |
レッスンの最後は、BERT や GPT-3 のような大規模言語モデルの成功に触れて終わります。大量の一般的なテキストで 事前学習 し、その後で特定のタスクに 特化 させる(一般にはファインチューニングと呼ばれます)、という流れです。この話はパート V「自然言語処理」で本格的に扱います。
教材を読むときの補足
教材の内容は GPT-3 の時代までですが、大筋は今でも正確です。ただし、細部に 3 つ補っておきたい点があります。
AI の冬は 2 回ある
教材は、エキスパートシステムの行き詰まりが「1970 年代の AI の冬」につながったと読める書き方をしています。しかし一般には、AI の冬は 2 回あったとされます。1 回目は 1970 年代で、過大な期待に成果が追いつかず研究資金が削られた時期です。エキスパートシステムが商業的なブームを迎えたのはその後の 1980 年代で、そのブームがしぼんだ 1980 年代末からが 2 回目の冬にあたります。「記号的推論は現実の知識の量と複雑さに対してスケールしなかった」という教材の結論自体は変わりませんが、年代の対応は頭の中で補っておくとよいでしょう。
2015 年の「人間レベル」の論文は ResNet ではない
教材は 2015 年の画像分類について「Microsoft Research の ResNet が人間レベルの精度を達成」と書いていますが、リンク先の論文(ICCV 2015)は ResNet ではありません。同じ研究グループ(Kaiming He ら)による、活性化関数 PReLU を提案した Delving Deep into Rectifiers です。ImageNet で人間の推定精度を初めて上回ったと報告したのはこの論文で、ResNet は同年末の ILSVRC 2015 で優勝した別のモデルです。
日本語版は「話すプログラム」の節が欠落している
日本語版は Co-op Translator による機械翻訳です。レッスン 01 では、翻訳の品質以前に 本文の一部が欠落 しています。「話すプログラム」の節で、現代のアシスタントの説明が「その後、必要なアクションを」で途切れています。その直後から、次の 2 つが抜けています。
- 3 番目の項目「将来はニューラルネットワークだけで対話を扱うモデルが期待される(GPT、Turing-NLG)」
- チューリングテストの変遷を示す図(画像のクレジット行だけが残っている)
この節はレッスンの結論にあたる部分なので、日本語版で読む場合も、ここだけは英語原文の該当箇所を開いて確認してください。
レッスンの進め方
レッスン 01 は読むだけで完結しますが、付属の課題を使うと理解が定着しやすくなります。
- 講義前・講義後のクイズ: 講義前 と 講義後 で理解度を確認できる
- 本文中の ✅ の問い: 「迷路を解いてエサを取るカラスは知能を持つか?」「チャットボットを人間だと思い込んだことはあるか?」など。答えを一度書き出してみると、知能の定義の難しさが実感できる
- 🚀 チャレンジ: 地図アプリや音声認識、ゲームなど、AI がもっとも効果的に使われていると思う場所を探し、そのシステムの作られ方を調べる
- 課題「ゲームジャム」: チェスや囲碁、あるいはポンやパックマンのような古いゲームを 1 つ選び、AI の進化がそのゲームに与えた影響を、過去・現在・未来の 3 つの観点で短いエッセイにまとめる
課題のゲームジャムは、本文のチェスの例をそのまま自分で延長する課題です。たとえば囲碁なら、探索だけでは歯が立たなかった時代から、2016 年に AlphaGo がトップ棋士に勝ち、さらに人間の棋譜を使わず自己対局だけで学ぶ AlphaZero へと進んだ流れが書けます。「探索 → 人間の知識の利用 → 自己対局による学習」という、このレッスンの構図がそのまま当てはまります。
復習用には、姉妹カリキュラム ML-For-Beginners の 機械学習の歴史のレッスン が勧められています。
まとめ
- AI の対象は「人間はできるが、手順を書き出せない問題」。写真からの年齢推定が典型例
- 弱い AI と強い AI(AGI)の区別、知能の定義の難しさ、その代わりとしてのチューリングテストが導入される。ただしチューリングテストが測るのは「人間と区別できないか」だけで、理解の有無ではない
- 知能を載せる方法は、推論をまねるトップダウン(記号的推論)と、脳の構造をまねるボトムアップ(ニューラルネットワーク)が 2 本柱。AI の冬を経て、主役は後者に移った
- チェスは「探索 → 事例ベース推論 → ニューラルネットワーク+強化学習」、対話は「ELIZA → ハイブリッド型アシスタント → ニューラルネットワークだけの対話」と移り変わり、後者は教材の予想どおり LLM で実現した
- 読むときは「教材を読むときの補足」の 3 点(AI の冬は 2 回、2015 年の論文は ResNet ではない、日本語版の欠落)を補う
レッスン 01 で押さえた 2 つのアプローチは、そのまま次のレッスンの構成に対応しています。レッスン 02 ではトップダウン側の知識表現とエキスパートシステムを、レッスン 03 からはボトムアップ側のニューラルネットワークを、それぞれ手を動かして学びます。