Microsoft の無料カリキュラム AI-For-Beginners のパート「IV. コンピュータビジョン」を解説します。レッスン 06「OpenCV 入門」から 12「セマンティックセグメンテーション」までの 7 本で、カリキュラムの中でいちばん大きなパートです。
シリーズのほかの記事は次のとおりです。
- 全体の構成: Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う
- レッスン 01: AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01
- レッスン 02: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02
- レッスン 03〜05: ニューラルネットワークの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 03〜05
前回のパート では、全結合のニューラルネットワークで手書き数字を分類しました。今回はそれを画像全般に広げます。7 つのレッスンは、次の 3 段の話になっています。
- 画像を数値として扱い、位置がずれても特徴を拾えるネットワークを作る(レッスン 06〜07)。画像は画素の値を並べた配列です。OpenCV でその配列を加工するところから始め、小さなフィルターを画像全体に滑らせて特徴を拾う 畳み込みニューラルネットワーク(CNN)に進みます。前回のパーセプトロンには「数字の位置がずれると誤分類する」弱点がありました。CNN は同じフィルターをどの位置にも当てるので、この弱点を克服できます
- 学習済みのネットワークを使い回す(レッスン 08)。大量の画像で学習済みの CNN は、線や模様、目や耳といった汎用の特徴をすでに知っています。その部分をそのまま借りて、最後の分類層だけを自分の問題向けに学習するのが 転移学習 です。猫と犬の分類なら、1 エポックで正解率 97% 台に届きます
- 分類の先へ進む(レッスン 09〜12)。「この画像は何か」を当てるだけでなく、画像を 作る(オートエンコーダー、GAN)、物体が どこにあるか を四角で当てる(物体検出)、画素ごと に何が写っているかを当てる(セグメンテーション)へと、出力の形を変えていきます
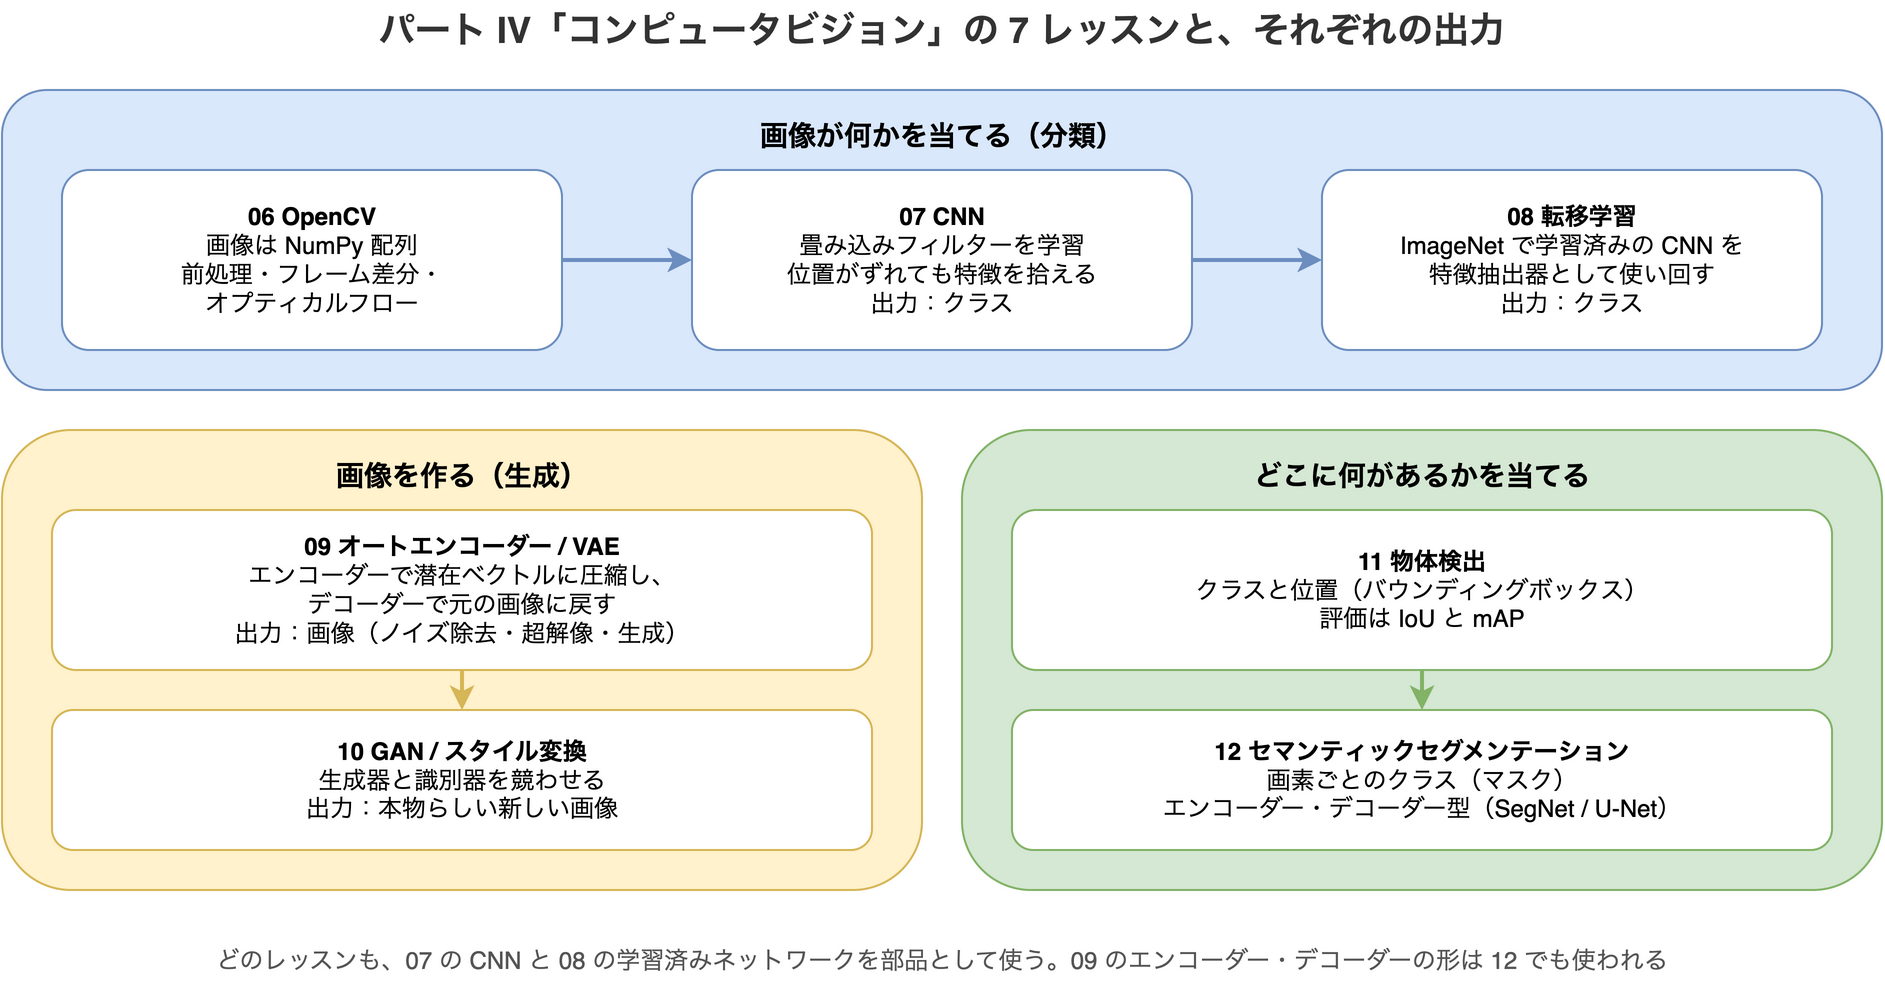
7 レッスン合わせて、ノートブックはラボを含めて 20 本あります。この記事では主要なノートブックを 2026 年 9 月時点のライブラリで実際に動かし、その結果も載せます。前回のパート以上に、そのままでは動かないセル と エラーは出ないのに結果がおかしいセル が多く見つかりました。対処法は「ノートブックを今の環境で動かすときの注意」に、教材そのものの誤りは「教材を読むときの補足」にまとめています。
教材の場所は次のとおりです。
筆者の実行環境は、Apple M3 Ultra の Mac 上の Python 3.12.8 です。主なライブラリは NumPy 2.5.3、OpenCV 5.0.0、Matplotlib 3.11.2、PyTorch 2.14.0、torchvision 0.29.0、TensorFlow 2.21.0、Keras 3.15.1 です。TensorFlow は Mac の GPU を使う追加パッケージを入れていないので、CPU で動かしています。学習に時間がかかるノートブックは、エポック数を減らして動かしたものがあります。その場合は本文で断ります。
レッスン 06: OpenCV でコンピュータビジョンに入る
コンピュータビジョンで扱う問題
コンピュータビジョン(CV)は、コンピュータに画像の意味を理解させる分野です。教材は、代表的な問題として次のものを挙げています。
- 画像分類、物体検出、イベント検出(監視カメラの映像から出来事を見つけるなど)
- 画像の説明文の生成、3D 復元
- 年齢や感情の推定、顔の検出と識別、3D の姿勢推定
画像を扱うライブラリとしては、imageio、Pillow、OpenCV、dlib(顔と顔の特徴点の検出)が紹介されています。教材で主に使うのは、C++ で書かれた OpenCV です。画像処理の事実上の標準になっているライブラリです。
画像は NumPy の配列
OpenCV で読み込んだ画像は NumPy の配列です。320×200 のグレースケール画像なら形は (200, 320)、カラーなら色の次元が加わって (200, 320, 3) になります。最後の 3 は赤・緑・青の 3 色で、この色の次元を チャンネル と呼びます。
注意点は、OpenCV のカラー画像が BGR(青・緑・赤)の順で並んでいることです。Matplotlib はふつうの RGB の順で表示するので、そのまま描くと色がおかしくなります。表示する前に cv2.cvtColor(im, cv2.COLOR_BGR2RGB) で変換します。
README は、前処理の道具として次のものを挙げています。
- 拡大縮小(
resize)、ぼかし(medianBlur、GaussianBlur) - 明るさとコントラストの調整(NumPy の演算で行う)
- 二値化(
threshold、adaptiveThreshold) - アフィン変換(3 点の対応で決まる。平行な線は平行のまま)と透視変換(4 点の対応で決まる)
- オプティカルフロー(フレーム間で画素がどちらに動いたか)
ノートブックの 3 つの例
OpenCV.ipynb は、次の 3 つの例で道具を一通り使います。
- 点字の画像を文字ごとに切り出す: ぼかしと二値化を何段か重ねてノイズを取り、ORB という手法で特徴点(角や点のように目立つ場所)を検出します。特徴点を囲む範囲を求めて点字の部分だけを切り出し、36×24 画素ずつの文字に分けます
- 動画から動きのある場面を見つける: 876 フレームの動画を白黒にして、隣り合うフレームの差の大きさを計算します。差が閾値を超えるフレームが 30 フレームより長く続く区間を、出来事として取り出します
- オプティカルフローで動きの向きを見る:
calcOpticalFlowFarnebackで画素ごとの動きを求め、向きを色相、大きさを明るさにして、HSV(色相・彩度・明るさで色を表す方式)の画像で表示します
全セルがエラーなく動き、出力もノートブックに記録された値と一致しました(点字画像の形 (242, 531, 3)、動画の 876 フレーム、出来事の区間はフレーム 195〜322 など)。ただし、2 つ目の例のフレーム差分には計算の誤りがあります。結果は記録と一致しますが、正しい値ではありません。詳しくは「教材を読むときの補足」で説明します。
レッスン 07: 畳み込みニューラルネットワーク(CNN)
畳み込みフィルター
MNIST の数字は画像の中央にそろえてありますが、現実の画像では、物体がどこに写っているか分かりません。そこで、画像の小さな範囲を見て特徴を拾う フィルター を、画像全体に滑らせて当てる方法を使います。これが 畳み込み です。
たとえば次の 3×3 のフィルターは、左右で明るさが変わる場所、つまり縦の線に強く反応します。
-1  0  1
-1  0  1
-1  0  1
昔の画像処理では、こうしたフィルターを人が設計していました。CNN では、フィルターの値そのものを学習で決めます。最初の層は線や角のような単純な形を拾い、層を重ねるほど、それらを組み合わせた複雑な特徴を拾うようになります。
1 層の畳み込みで MNIST を解く
PyTorch 版のノートブックの最初のモデルは、5×5 のフィルター 9 枚の畳み込み層 1 つと、全結合層 1 つだけです。
# ノートブックのセルから抜粋(summary の行は省略)
class OneConv(nn.Module):
    def __init__(self):
        super(OneConv, self).__init__()
        self.conv = nn.Conv2d(in_channels=1,out_channels=9,kernel_size=(5,5))
        self.flatten = nn.Flatten()
        self.fc = nn.Linear(5184,10)

    def forward(self, x):
        x = nn.functional.relu(self.conv(x))
        x = self.flatten(x)
        x = nn.functional.log_softmax(self.fc(x),dim=1)
        return x
28×28 の画像に 5×5 のフィルターを当てると 24×24 の出力が 9 枚できるので、全結合層への入力は 9×24×24 = 5,184 個です。パラメータ数は 52,084 個で、教材は全結合だけのネットワーク(約 8 万個)より少ないと説明しています。
プーリングとピラミッド型の構成
畳み込みの後には プーリング をはさみます。2×2 の範囲の最大値(最大プーリング)か平均(平均プーリング)を取って、画像を縦横半分に縮める操作です。畳み込みとプーリングを交互に重ね、層が進むほど画像を小さく、フィルターの枚数を多くする ピラミッド型 が、CNN の基本形です。
畳み込み層を 2 段にした MultiLayerCNN は、パラメータが 8,490 個しかないのに、OneConv より正解率が上がりました。
| モデル | パラメータ数 | 検証データの正解率(5 エポック後) |
|---|---|---|
| OneConv(PyTorch 版) | 52,084 | 0.973 |
| MultiLayerCNN(PyTorch 版) | 8,490 | 0.983 |
| OneConv(TensorFlow 版) | 52,084 | 0.9839 |
| MultiLayerCNN(TensorFlow 版) | 8,490 | 0.9870 |
小数の桁数は、それぞれのノートブックの表示に合わせています。
最後に、32×32 のカラー画像を 10 クラスに分ける CIFAR-10 を、LeNet 型(1990 年代に手書き数字の認識で使われた小さな CNN の構成)のネットワークで解きます。教材は「50% を超える」と書いていて、PyTorch 版(3 エポック)は 0.520、TensorFlow 版(10 エポック)は最高 0.6224 でした。でたらめに当てれば 10% なので、小さなネットワークでも十分学習できています。
なお、CIFAR-10 の配布元のトロント大学のサーバーは、筆者が試したときは毎秒 100KB 前後しか出ませんでした。そこで、Hugging Face にあるミラーからデータを組み立て直して先に進みました。後で配布元のファイルのダウンロードも完了したので照合したところ、全 60,000 枚の画像とラベルは同じでした(学習データの並び順だけが違います)。
有名なアーキテクチャ
補足資料の CNN_Architectures.md は、代表的な CNN を紹介しています。
- VGG-16: 畳み込みとプーリングを素直に積み重ねたピラミッド型。教材によれば、2014 年に ImageNet(約 1,000 クラス・100 万枚以上の画像を集めたデータセット)で top-5 正解率(上位 5 つの候補に正解が入っていれば正解とみなす)92.7% を出した
- ResNet: 2015 年に Microsoft Research が提案。層を飛ばして入力を足し込む 残差ブロック で、非常に深いネットワークを学習できるようにした
- Inception: 大きさの違うフィルターを並列に当てて結果をつなぐ。1×1 の畳み込みで、チャンネルを混ぜて数を減らす
- MobileNet: 畳み込みを「チャンネルごと」と「1×1」の 2 段に分けて計算量を減らした、スマートフォン向けの軽いモデル
レッスン 08: 転移学習
学習済みネットワークを特徴抽出器として使う
CNN を一から学習するには、大量の画像と計算資源が要ります。しかし、ImageNet のような大規模なデータで学習済みの CNN は、どんな画像にも共通する特徴をすでに学んでいます。その畳み込み部分を 特徴抽出器 としてそのまま使い、最後の分類層だけを自分の問題向けに学習し直すのが 転移学習 です。
教材は、土台にするネットワークとして VGG-16/19(単純で最初に試すのによい)、ResNet(深くて重い)、MobileNet(小さくて軽いが正解率は少し落ちる)を挙げ、Kaggle の猫と犬の写真で試します。
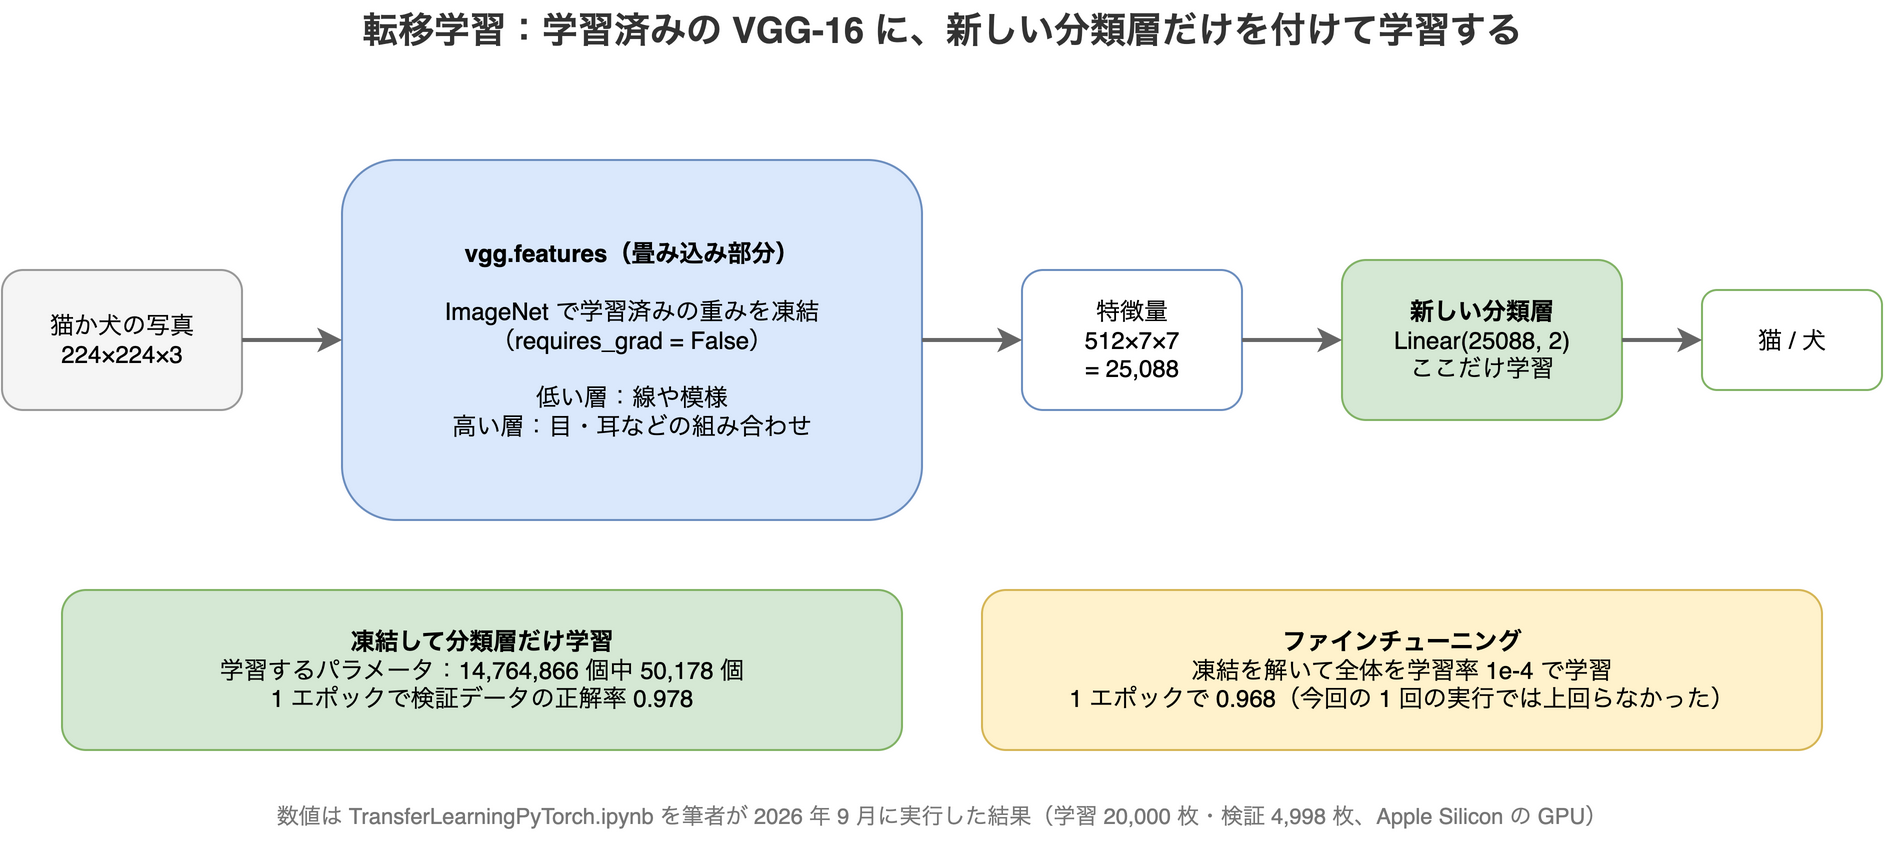
PyTorch 版の TransferLearningPyTorch.ipynb の流れは次のとおりです。
- 学習済みの VGG-16 で、そのまま写真を分類してみる(猫の写真は ImageNet のクラス 281「tabby」(トラ猫)と判定された)
- VGG-16 の畳み込み部分だけで特徴量を計算しておき、それを入力に 1 層の分類器を学習する
- VGG-16 の分類層を
Linear(25088, 2)に取り替え、畳み込み部分を 凍結 して(学習中にその部分の重みを更新しないようにして)全体として学習する - 凍結を解いて、全体を小さい学習率で学習し直す(ファインチューニング)
学習データ 20,000 枚、検証データ 4,998 枚で動かした結果は次のとおりです(ノートブックと同じく各 1 エポック。「Mac では GPU が使われない」で説明する書き換えをして、Mac の GPU で実行)。
| 方法 | 検証データの正解率 | ノートブックの記録 |
|---|---|---|
| 畳み込み部分を凍結して分類層だけ学習 | 0.9780 | 0.9672 |
| 凍結を解いてファインチューニング | 0.9676 | 0.9744 |
教材は、ファインチューニングでは最初に一度正解率が落ちることがある、と注意しています。今回の 1 回の実行では、ファインチューニングで正解率は上がりませんでした。また教材自身が、ImageNet にはもともと猫と犬のクラスが含まれているので「公平な比較ではない」と認めています。
学習のコツと Dropout
補足資料の TrainingTricks.md は、深いネットワークを学習させるためのコツをまとめています。
- 値を [-1, 1] や [0, 1] の範囲にそろえる(大きさの違う数を足すと、小さい方が丸めで消える)
- 重みの初期値を工夫する(Xavier / Glorot の初期化など)
- バッチ正規化: 層の出力を、ミニバッチごとに平均 0・分散 1 にそろえる
- Dropout: 学習中にニューロンの一部をランダムに止める。過学習を抑える
- 最適化手法(モメンタム、RMSProp、Adam など。迷ったら Adam)、勾配クリッピング、学習率の減衰
Dropout.ipynb は、MNIST の CNN で Dropout の割合を 0、0.2、0.5、0.8 と変えて比べます。教材は「0.2〜0.5 がいちばん速く、よく学習する」と書いています。シード(乱数の種)を 3 通りに変えて 5 エポック後の検証データの正解率を比べると、0.2 は 3 回中 2 回でいちばん高くなりました(残りの 1 回は 0.5 が 0.0001 だけ上)。ただし、同じシードの中での差は最大でも 0.3 ポイント弱です。1 エポック目の正解率は、Dropout なしが高いシードも 0.2 が高いシードもあり、一貫しませんでした。「速く学習する」効果は、この小さな例でははっきりしませんでした。
敵対的な猫と敵対的攻撃
AdversarialCat_TF.ipynb は、ネットワークの重みではなく 入力画像の方 を勾配降下法で変えていきます。
- ランダムな画像を「シャム猫」と判定されるように変えていくと、人間には雑音にしか見えない画像になる
- 隣り合う画素の差を小さくする損失(全変動)を加えると、模様らしきものが見えてくる
- 犬の写真を少しだけ変えて、VGG-16 に「猫」と判定させる。これを 敵対的攻撃 と呼ぶ。同じ画像を ResNet-50 に見せると猫とは判定されないので、複数のモデルを組み合わせることが防御になる
筆者の実行(反復回数を減らしたもの)でも、犬の写真は 100 回の更新で「シャム猫」と確率 0.865 で判定され、ResNet-50 は同じ画像を「線虫」と判定しました(確率 0.131)。どちらもノートブックの記録と一致します。
レッスン 09: オートエンコーダー
入力そのものを正解にする
オートエンコーダー は、入力画像を小さな 潜在ベクトル に圧縮するエンコーダーと、そこから元の画像を復元するデコーダーをつないだネットワークです。正解ラベルの代わりに入力画像そのものを正解として学習します(自己教師あり学習)。ラベルなしのデータで学習できるのが利点です。
使い道として、教材は次のものを挙げています。
- 次元削減(主成分分析より良い表現が得られることがある)
- ノイズ除去(ノイズを加えた画像を入力し、元の画像を正解にする)
- 超解像(低解像度の画像から高解像度の画像を復元する)
- 画像の生成(潜在ベクトルを適当に作ってデコーダーに通す)
ノートブックでは、MNIST を使って、ふつうの復元・ノイズ除去・超解像の 3 通りを学習させます。筆者の実行(エポック数を減らしたもの)でも、3 通りとも数字の形を復元できました。
VAE で潜在空間をなめらかにする
ふつうのオートエンコーダーの潜在ベクトルは、どこを取ればどんな画像になるかが整理されていません。変分オートエンコーダー(VAE)は、エンコーダーが潜在ベクトルそのものではなく、正規分布の平均と分散を出力します。そこからサンプリングした点をデコーダーに通します。損失には、復元の誤差に加えて、分布が標準正規分布から離れすぎないようにする KL ダイバージェンスを入れます。
潜在空間を 2 次元にして MNIST を学習させると、2 次元の平面上で、数字がなめらかに移り変わる地図ができます。
PyTorch 版のノートブックは、さらに 敵対的オートエンコーダー(AAE)も扱います。潜在ベクトルの分布を正規分布に近づける役を、KL ダイバージェンスの代わりに、次のレッスンの GAN と同じ識別器(本物か作り物かを見分けるネットワーク)に任せるモデルです。ただし、この AAE の実装には 2 つの誤りがあり、識別器がまったく学習していません(「教材を読むときの補足」を参照)。
レッスン 10: GAN とスタイル変換
生成器と識別器を競わせる
敵対的生成ネットワーク(GAN)は、2 つのネットワークを競わせて画像を生成します。
- 生成器: 乱数ベクトルから画像を作る。オートエンコーダーのデコーダーと同じ形
- 識別器: 画像が本物か、生成器が作った偽物かを見分ける。ふつうの CNN の分類器
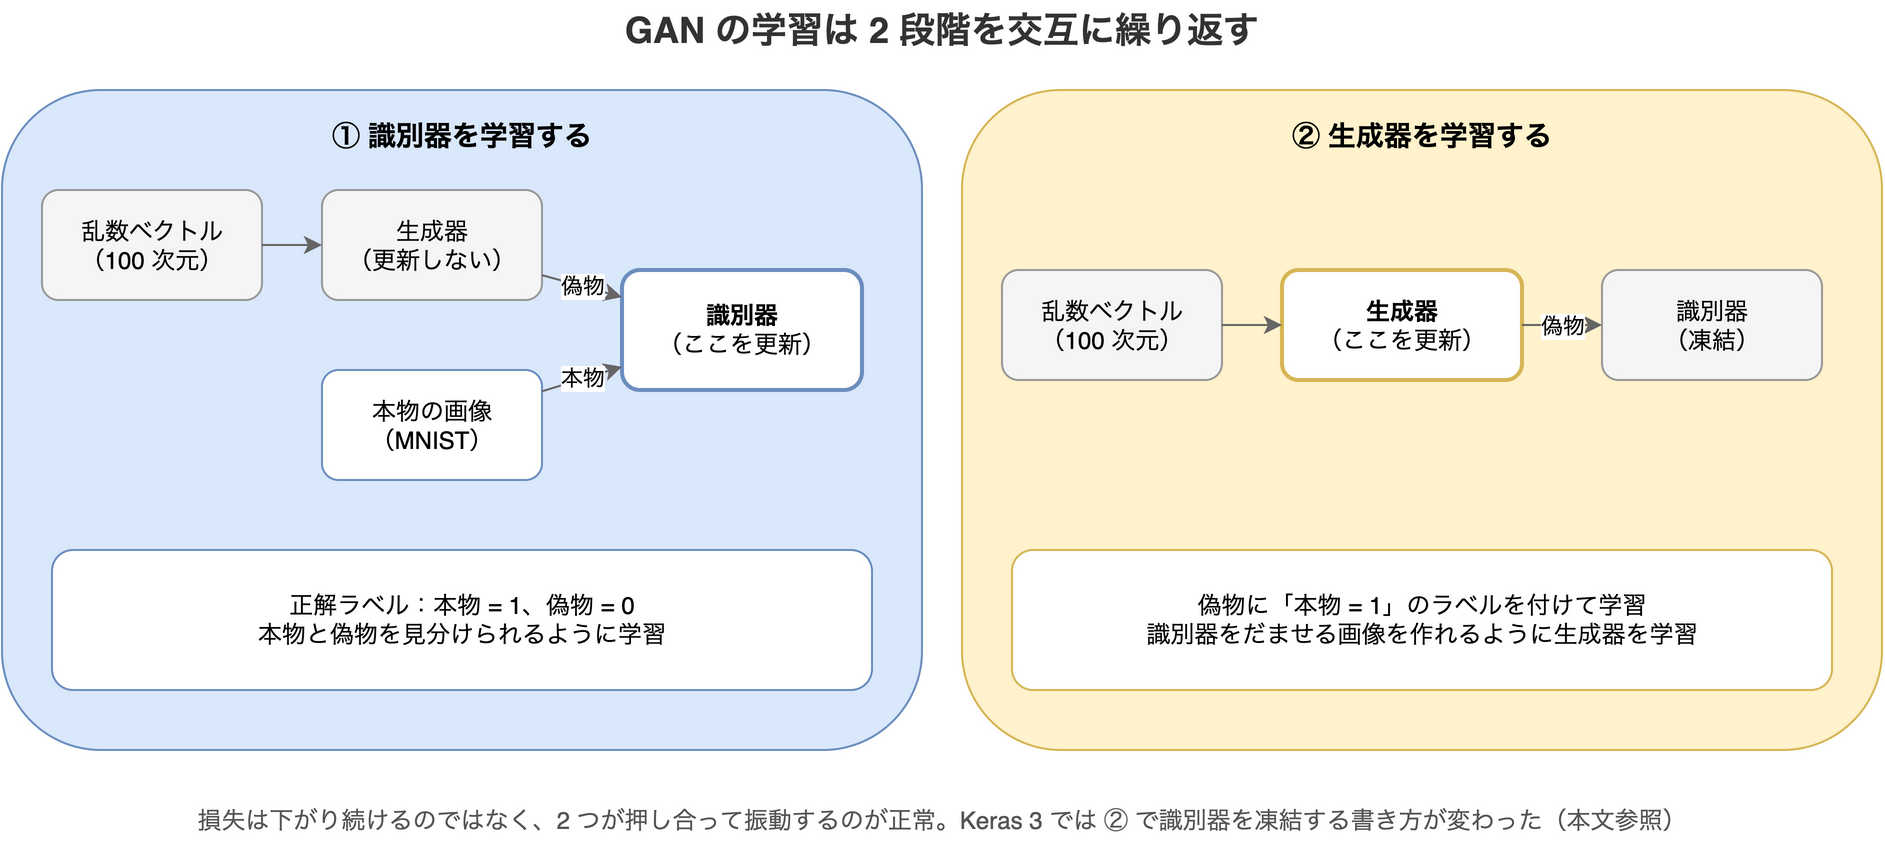
学習では、識別器の学習と生成器の学習を交互に繰り返します。生成器を学習するときは、まず識別器を凍結します。そのうえで、生成器と識別器をつないだネットワークに、偽物の画像と「本物」のラベルを与えて学習します。2 つが押し合うので、損失は下がり続けるのではなく振動するのが正常です。
教材は、GAN の難しさとして次のものを挙げています。
- モード崩壊: 生成器が、識別器をだませる少数の画像ばかりを作るようになる
- ハイパーパラメータ(学習率や層の数など、学習の前に人が決める設定値)に敏感で、生成器と識別器の力の釣り合いを取るのが難しい(識別器が強すぎると生成器が学習できなくなる)
- 高解像度の画像の生成が難しい
畳み込み層で作った GAN を DCGAN と呼びます。PyTorch 版を Mac の GPU で動かすと、全結合の GAN(20 エポックに短縮)は数字らしい形がかろうじて出る程度でした。DCGAN(10 エポックに短縮)は、はっきりした数字を生成できました。
スタイル変換
スタイル変換 は、ある写真(コンテンツ)を、ある絵画(スタイル)の画風で描き直す手法です。GAN とは違い、ネットワークは学習済みの VGG-16 を固定して使い、画像そのもの を最適化します。
- コンテンツ損失: 生成画像と写真の、VGG の中間層の特徴の差
- スタイル損失: 生成画像と絵画の、特徴の グラム行列(チャンネル同士の相関)の差。どこに何があるかには関係なく、色や筆づかいの傾向を表す
- 変動損失: 隣り合う画素の差。画像をなめらかにする
ノートブックの StyleTransfer.ipynb は、これらの重み付きの和を Adam で小さくしていきます。そのままだと色が派手にずれた画像になりますが、これは教材の前処理の誤りが原因です(「教材を読むときの補足」の「結果を変えてしまうコードの誤り」を参照)。
レッスン 11: 物体検出
何がどこにあるか
物体検出 は、画像の中の物体のクラスと、それを囲む四角(バウンディングボックス)の位置を当てる問題です。代表的なデータセットは、20 クラスの PASCAL VOC と、80 クラスの COCO です。
ノートブックの ObjectDetection.ipynb は、2 つの素朴な方法を試します。
- 画像をタイルに分けて分類する: 学習済みの VGG-16 で、猫と女の子の写真の猫らしさを計算すると、画像全体では 0.618 でした。これを 10×10 のタイルごとに計算すると、猫がいる場所が分かるヒートマップになります。ただし、四角の位置は粗くなります
- 四角の座標を回帰で直接当てる: 8×8 の画像に四角を 1 つ描いた人工データを 10 万枚作り、四角の 4 つの座標を全結合のネットワークで予測します
このノートブックは追加のライブラリなしで、今の Keras でもそのまま最後まで動きました。
IoU と mAP
予測した四角が正解とどれだけ重なっているかは、IoU(Intersection over Union)で測ります。2 つの四角の重なった部分の面積を、2 つを合わせた部分の面積で割った値で、完全に一致すれば 1、重ならなければ 0 です。上の 2 つ目の例では、500 枚のテスト画像の IoU の平均は 0.7125 でした(ノートブックの記録は 0.7151)。
検出器全体の性能は mAP(mean Average Precision)で比べます。クラスごとに、適合率(検出したもののうち正しかった割合)と再現率(正解のうち検出できた割合)の曲線の下の面積(AP)を計算し、クラス全体で平均したものです。PASCAL VOC は IoU が 0.5 以上なら正解とみなし、COCO は複数の IoU の閾値で平均します。
本格的な検出器
README は、実用的な検出器を 2 系統に分けて紹介しています。
- 候補領域(物体がありそうな場所の候補)を使う方法: R-CNN(候補領域を切り出して CNN で分類)→ Fast R-CNN(畳み込みを画像全体で 1 回だけ計算)→ Faster R-CNN(候補領域の提案もネットワークで行う)。R-FCN もこの系統
- 1 回で検出する方法: YOLO(画像を格子に分け、マスごとに四角とクラスを予測)、SSD、RetinaNet
レッスン 12: セマンティックセグメンテーション
画素ごとに分類する
セマンティックセグメンテーション は、画素 1 つ 1 つがどのクラスに属するかを当てる問題です。背景も 1 つのクラスとして扱います。同じクラスの物体を 1 つずつ見分ける問題(羊が 3 匹写っていれば、1 匹ずつ別の色で塗り分ける)は、インスタンスセグメンテーション と呼ばれます。
出力は入力と同じ大きさの マスク で、クラスごとに 1 チャンネルを持ちます。そのため、ネットワークはエンコーダーで画像を縮めて特徴を取り出し、デコーダーで元の大きさに戻す形になります。レッスン 09 のオートエンコーダーと同じ形です。
- SegNet: エンコーダー(畳み込みとプーリング)とデコーダー(拡大と畳み込み)を対称に並べる
- U-Net: エンコーダーの各段の出力を、同じ大きさのデコーダーの段に直接つなぐ(スキップ接続)。縮めたときに失った細かい位置の情報を、デコーダーが取り戻せる
ノートブックは、皮膚の病変(ほくろなど)の写真 200 枚とそのマスクからなる PH² データセットで、病変の範囲を当てます。
データセットが手に入らない
ところが、ノートブックが PH² をダウンロードする Dropbox のリンクは、2026 年 10 月時点で無効になっています。公式サイトから入手するには登録フォームの送信が必要で、利用条件で再配布も禁じられています。
そのため筆者は、PH² と同じフォルダ構成で、肌色の背景に暗い楕円を 1 つ描いた 人工のデータ 200 枚を作り、ノートブックを動かしました。本物の皮膚画像よりはるかに簡単なデータなので、以下の数値は PH² での性能を表すものではありません。意味があるのは、同じデータでの比較だけです。
8 エポックに短縮した PyTorch 版では、IoU(予測と正解のマスクの重なり具合)は SegNet が 0.898、U-Net が 0.980 で、スキップ接続の効果がはっきり出ました。ノートブックに残っている本物の PH² での学習記録も、U-Net の方が検証データの損失が低くなっています。
ノートブックを今の環境で動かすときの注意
レッスン 10〜12 のノートブックは 2022 年 5 月を最後に更新されておらず、ほかのレッスンもほぼ当時のライブラリを前提にしたままです(2026 年に入ってからの更新は、補助モジュールの小さな修正と、「教材を読むときの補足」の「自動修正で壊れたセル」で説明する修正くらいです)。2026 年 9 月時点のライブラリで動かすと、次の箇所で止まったり、黙っておかしな動きをしたりしました。
日本語版のフォルダからは動かない
日本語版のフォルダには、翻訳されたノートブックがあります。コードのセルは英語版と同じです。ただし、ノートブックが読み込むデータ(data/ フォルダ)や補助のモジュール(pytorchcv.py、tfcv.py)が日本語版のフォルダにはありません。そのまま動かすと、次のようなエラーで止まります。
ModuleNotFoundError: No module named 'pytorchcv'ノートブックは英語版の lessons/ のフォルダで動かし、説明は日本語版で読むのが確実です。全体の記事 で紹介した sparse-checkout の手順なら、lessons/ も展開されます。
Mac では GPU が使われない
PyTorch 版のノートブックは、使うデバイス(計算に使う CPU や GPU)を 'cuda' if torch.cuda.is_available() else 'cpu' のように選んでいます。Mac の GPU(MPS)は選ばれないので、エラーは出ずに CPU で動きます。DCGAN を CPU で動かすと 1 エポック約 2,400 秒かかりましたが、MPS では 6〜10 秒でした。ノートブックの 50 エポックを CPU で回すと、1 日以上かかる計算です。
次のように MPS も選ぶようにすると、現実的な時間で動きます。
device = 'cuda:0' if torch.cuda.is_available() else ('mps' if torch.backends.mps.is_available() else 'cpu')レッスン 07・08 の補助モジュール pytorchcv.py の default_device も同じ書き方なので、同様に直します。
また、レッスン 07 の PyTorch 版は、データは pytorchcv.default_device のデバイスに送るのに、モデルを送っていません。そのため GPU がある環境では 次のようなエラーになります(筆者は MPS で再現しました)。
RuntimeError: Tensor for argument weight is on cpu but expected on mpsnet = OneConv().to(pytorchcv.default_device) のように、モデルも同じデバイスに送れば動きます。
PyTorch の torch.load(レッスン 08)
転移学習のノートブックは、torch.save(vgg, ...) でモデル全体を保存し、torch.load で読み戻しています。PyTorch 2.6 で torch.load の weights_only の既定値が True に変わったため、読み込みが次のエラーで止まります。
UnpicklingError: Weights only load failed ... Unsupported global: GLOBAL torchvision.models.vgg.VGG自分で保存したファイルなら torch.load(..., weights_only=False) で読めます。本来は state_dict() だけを保存するのが安全です。
Keras 3 で変わったこと
TensorFlow 2.16 以降は Keras 3 が標準になり、多くのノートブックが影響を受けます。
| ノートブック | エラー | 対処 |
|---|---|---|
| TransferLearningTF(08) | module 'numpy' has no attribute 'int' | astype(int) にする(NumPy 1.24 で削除済み) |
| TransferLearningTF(08) | Invalid filepath extension for saving | 保存先を cats_dogs.tf から cats_dogs.keras にする |
| TransferLearningTF(08) | Unknown variable: ... This optimizer can only be called for the variables it was originally built with | 層の trainable を変えた後に model.compile(...) し直す |
| AdversarialCat_TF(08) | 'list' object has no attribute 'shape' | 損失関数に渡す正解を tf.constant(target) にする |
| AdversarialCat_TF(08) | Argument learning_rate should be float | SGD(learning_rate=1.0) のように小数で渡す |
| AutoencodersTF(09) | missing 1 required positional argument: 'pool_size' | AveragePooling2D(pool_size=(2, 2)) |
| GANTF(10) | Argument(s) not recognized: {'lr': 0.0002} | Adam(learning_rate=0.0002)。decay は無視される |
最後の Adam の引数は、Keras 2 で使えた lr という別名が Keras 3 で削除されたためです。同じ理由で、セグメンテーションの TensorFlow 版の Adam(..., decay=wd) も、警告が出るだけで重みの減衰が 黙って無効 になります。
VAE は書き直しが必要(レッスン 09)
AutoencodersTF の VAE は、tf.compat.v1.disable_eager_execution() で TensorFlow 1 の動作に切り替えたうえで、損失関数の中からエンコーダーの出力(平均と分散)を参照しています。Keras 3 にはこの動作モードがなく、この 1 行を消しても、損失関数の中で中間の出力を参照できないためエラーになります。
ValueError: Tried to convert 'x' to a tensor and failed. Error: A KerasTensor cannot be used as input to a TensorFlow function.KL ダイバージェンスの計算を層の中に移し、add_loss で損失に加えると動きました。式そのものは教材と同じです。
# ノートブックの encoder・decoder・inputs の定義の後に置く
class KLLoss(tf.keras.layers.Layer):
    def call(self, inputs):
        z_mean, z_log_sigma, z = inputs
        tmp = 1 + z_log_sigma - tf.square(z_mean) - tf.exp(z_log_sigma)
        self.add_loss(tf.reduce_mean(-0.5*tf.reduce_sum(tmp, axis=-1)))
        return z

outputs = decoder(KLLoss()(encoder(inputs)))
compile に渡す損失関数は、復元の誤差(mse(x1,x2)*784)だけにします。損失の内訳を確かめると、KL の項もきちんと学習の損失に含まれていました。
Keras 3 では GAN の識別器が学習しない(レッスン 10)
GANTF の Adam の引数を直すと、エラーは出なくなります。しかし、この状態では 識別器がまったく学習しません。ノートブックは次の順に書かれています。
discriminator.compile(loss='binary_crossentropy',optimizer=optimizer,metrics=['accuracy'])
# ...
discriminator.trainable = False
adversarial = Sequential()
adversarial.add(generator)
adversarial.add(discriminator)
adversarial.compile(loss='binary_crossentropy', optimizer=optimizer)
Keras 2 では、compile を呼んだ時点の trainable がモデルごとに記録されました。そのため、識別器単体の学習では更新し、つないだネットワークの学習では凍結する、という使い分けができました。Keras 3 では trainable を学習の実行時に見るので、False にした後は識別器単体の学習でも重みが変わりません。筆者の確認では、識別器の学習ステップでの重みの変化は 0 でした。出るのは「学習できる重みがない」という警告だけです。
The model does not have any trainable weights.学習のたびに trainable を切り替え、さらにモデルごとに別の Adam を渡すと、正しく学習しました(Keras 3 のオプティマイザは、最初に使った変数の組にしか使えないため)。
# 修正箇所の抜粋(名前空間はノートブックの import に合わせている)
discriminator.compile(loss='binary_crossentropy', optimizer=keras.optimizers.Adam(learning_rate=0.0002), metrics=['accuracy'])
adversarial.compile(loss='binary_crossentropy', optimizer=keras.optimizers.Adam(learning_rate=0.0002))

# 学習ループの中
  discriminator.trainable = True
  d_loss = discriminator.train_on_batch(x_combined_batch, y_combined_batch)
  # ...
  discriminator.trainable = False
  g_loss = adversarial.train_on_batch(noise, y_mislabled)
ノートブックと同じ 3,000 ステップで動かすと、識別器と生成器の損失が押し合って変化するようになりました。GAN の学習は、エラーが出ないまま失敗することがある、というよい例です。
動かないノートブック: StyleTransfer_Keras(レッスン 10)
レッスン 10 のフォルダには、スタイル変換のノートブックが 2 本あります。StyleTransfer_Keras.ipynb は TensorFlow 1 の書き方(K.get_session、K.placeholder など)で、今の TensorFlow では書き直さない限り動きません。そもそも from tf.keras import ... という、どのバージョンでも動かない import があり、一度も最後まで実行されていない形跡があります。README からもリンクされていないので、スタイル変換は StyleTransfer.ipynb の方で学べば十分です。
教材を読むときの補足
教材そのものの誤りをまとめます。日本語版は英語版の誤りもそのまま翻訳しているので、特に断りがなければ英語版・日本語版に共通です。
結果を変えてしまうコードの誤り
エラーにならないので気づきにくく、いちばん注意が要るものです。
- フレーム差分が uint8 で桁あふれしている(レッスン 06):
diffs = [(p2-p1) for ...]は 0〜255 の符号なし整数(uint8)どうしの引き算なので、10 − 11 が 255 になります。差の大きさの中央値は、桁あふれした値で 8,506、cv2.absdiffで正しく計算すると 68 でした。閾値 13,000 は、桁あふれした値に合わせて決められています。cv2.absdiff(p2, p1)で計算し直す場合は、閾値も 1,000〜2,000 程度に下げる必要があります - 損失の表示が小さすぎる(レッスン 07・08):
pytorchcv.pyは、ミニバッチごとの 平均 の損失を足し合わせ、それをサンプル数で割っています。表示される損失はバッチサイズ分の 1 になり(バッチサイズ 128 なら 1/128)、ノートブックに「Train loss=0.000」と出ます - 転移学習で
vgg.eval()を呼んでいない(レッスン 08): PyTorch 版は学習済みの VGG-16 で写真を分類するとき、Dropout が有効な学習モードのままです。同じ画像を 10 回分類すると、クラスが 281・282・285 と揺れ、確率も 0.20〜0.73 の間でばらつきました。vgg.eval()にすると毎回同じ結果になります - 敵対的攻撃の出発点が「犬」ではない(レッスン 08): 犬の写真を 255 で割っただけで、VGG-16 用の前処理(
preprocess_input)をせずに入力しています。その時点で VGG-16 は「蚊帳」(mosquito net)と判定していて、「犬を猫に変える」デモになっていません - AAE の識別器が学習していない(レッスン 09): 識別器の
forwardが最後の層にlinear5ではなくlinear4をもう一度使っているので、出力が 1 個ではなく 500 個になっています。さらに、識別器の損失でoptim_disc.step()ではなくoptim_dec.step()(デコーダーのオプティマイザ)を呼んでいます。識別器の重みは一度も更新されず、識別器の損失は 2 log 2(約 1.386)、エンコーダー側の損失は log 2(約 0.693)に張り付きます。ノートブックに残っている出力(1.39 と 0.692)も同じ状態です - スタイル変換の前処理で桁あふれしている(レッスン 10): 写真と絵画は uint8 のまま
preprocess_inputに渡されています。TensorFlow のテンソルが uint8 だと、平均を引く計算が 256 で折り返します([10, 120, 250] が [147, 4, 143] になる。正しくは [146.1, 3.2, −113.7])。目標の特徴が壊れるので、生成画像の色が大きくずれます。img_content.astype('float32')のように小数にしてから渡すと、絵画に近い色合いになりました - DCGAN の生成器が評価モードのまま学習している(レッスン 10): PyTorch のモデルには、学習用(
train())と評価用(eval())の 2 つのモードがあり、Dropout やバッチ正規化の動き方が変わります。PyTorch 版のtrain_dcganは学習の前に 1 回だけgen.train()を呼びますが、途中で画像を表示するdcplotnがgenerator.eval()を呼びます。そのため 2 エポック目以降は、バッチ正規化が評価用の動作のまま生成器を学習しています。dcplotnの後にgen.train()を呼び直します - シグモイドを 2 回かけている(レッスン 12): PyTorch 版のセグメンテーションのモデルは最後に
nn.Sigmoid()を通しているのに、損失にnn.BCEWithLogitsLoss()(内部でシグモイドをかける)を使っています。損失が 0.6 程度から下がらなくなります。nn.BCELoss()にすると、人工データでの損失は 0.08〜0.13 まで下がり、IoU も SegNet で 0.898 → 0.907、U-Net で 0.980 → 0.987 に上がりました。TensorFlow 版は逆に、ロジット(シグモイドをかける前の値)を 0.5 で二値化しています(正しくは 0)
自動修正で壊れたセル(レッスン 08)
TensorFlow 版の転移学習のノートブックは、VGG-16 の重みをダウンロードするセルが、必ず次のエラーで止まります。
ValueError: Incomplete or corrupted file detected. The sha256 file hash does not match the provided value of 64373286793e3c8b2b4e3219cbf3544bce2f55ab4682710a29f5e7af8f5e4f61.このセルは、2026 年 5 月の自動セキュリティ修正(ツールが脆弱性を検出して自動で作る修正コミット)で、ダウンロードした重みのハッシュ値を検査するように書き換えられたものです。その後 7 月に、GitHub の Copilot Autofix による別の自動修正で今の形になりました。ところが、書かれている「SHA-256」の値は、Keras が持っている重みの MD5(32 桁)に 32 桁を継ぎ足したもので、本物の SHA-256 ではありません。正しい SHA-256 は 8b81f25be4126c5ec088f19901b2b34e9a40e3d46246c9d208a3d727462b4f5c です。この値に直すか、keras.applications.VGG16() のように Keras 自身のダウンロードと検査に任せれば動きます。日本語版のノートブックも同じ状態です。
記述の誤り
- README の OpenCV のコード(レッスン 06):
cv2.INTER_LANCZOSは存在しない定数で、AttributeErrorになります。cv2.INTER_LANCZOS4が正しい名前です - 透視変換になっていない(レッスン 06): 点字の例は「文字が傾いていてもよいように」透視変換を使うと説明していますが、実際には軸に平行な四角を平行な四角に写していて、求めた変換は平行移動だけです
- ResNet-52 は存在しない(レッスン 07 の CNN_Architectures.md): ResNet の論文の構成は 18・34・50・101・152 層です。「ResNet-52」は ResNet-50 の誤りです。PyTorch 版の転移学習のノートブックの「ResNet-151」も、ResNet-152 の誤りです
- フィルターは加重平均ではなく加重和(レッスン 07): 教材はフィルターが「加重平均を計算する」と書いていますが、縦線のフィルターの値の合計は 0 で、平均ではありません
- 論文の著者と論文が違う(レッスン 07): README は「Hislop-Lynch の論文」として、Lee・Grosse・Ranganath・Ng の論文(ICML 2009、畳み込み深層信念ネットワーク)にリンクしています。Inception の「元の論文」のリンク(arXiv 1312.4400)も、Inception の論文ではなく、1×1 畳み込みの元になった Network In Network の論文です
- データの説明が古い(レッスン 07・08 のラボ): README は Oxford-IIIT Pet を「35 品種」と書いていますが、37 品種です。レッスン 07 のラボは、昔は顔の部分だけを切り抜いた画像を使っていたようで、題名は「Pet Faces」のまま、今のダウンロードは全身の写真です
- TrainingTricks.md の用語(レッスン 08): 勾配をその大きさで割る更新式を「Adagrad」と呼んでいますが、Adagrad はパラメータごとに過去の勾配の二乗和で割る手法です。また、重みの初期化の説明で、出力の標準偏差が n になるという誤りを、英語版は 2026 年 8 月に √n に直しましたが、日本語版はまだ古いままです
- VAE のサンプリングと KL の式が合っていない(レッスン 09): 潜在ベクトルのサンプリングでは
exp(z_log_sigma)を標準偏差として使い、KL ダイバージェンスでは同じ値を分散の対数として扱っています。一貫させるなら、サンプリングはexp(0.5 * z_log_sigma)です。2016 年の Keras のブログ記事の書き方を引き継いだもので、今の Keras の公式例はexp(0.5 * z_log_var)を使っています - モード崩壊の説明(レッスン 10): 英語版の README は、モード崩壊で生成器が「生成器をだます」と書いています。正しくは識別器です。日本語版は「Discriminator を欺く」と正しく訳されています
- スタイル変換の説明とコードが違う(レッスン 10): 説明では「512×512」「VGG-19」ですが、コードは 256×256 の VGG-16 です
- R-CNN の論文のリンクが Faster R-CNN(レッスン 11): README の R-CNN の「公式論文」のリンク先は、Faster R-CNN の論文(arXiv 1506.01497)です。R-CNN の論文は arXiv 1311.2524 です
- ImageNet の「猫」に大型のネコ科が入っている(レッスン 11): ノートブックはクラス 281〜293 の確率の合計を猫らしさにしていますが、286〜293 はクーガー、オオヤマネコ、ヒョウ、ユキヒョウ、ジャガー、ライオン、トラ、チーターです。家猫は 281〜285 です(結果への影響は小さく、0.618 が 0.610 になる程度)
- 物体検出のノートブックの説明と計算が違う(レッスン 11): 「32×32 の画像」と書いていますが、コードは 8×8 です。また「mAP」と書いて計算しているのは、IoU の平均です
リンクとファイルの問題
- レッスン 11 の README がリンクしている
ObjectDetection-TF.ipynbは、リポジトリに存在しません - レッスン 12 の PH² データセットの Dropbox のリンクは無効です(前述)
- レッスン 08 の TrainingTricks.md からの
Overfitting.mdへのリンク(3 か所)は、ファイルが存在しません - レッスン 06 のラボの README の指の追跡の参考記事(benmeline.com)は、ドメインが引けなくなっています
- レッスン 09 の README には「講義後のクイズ」のリンクが 2 つあり、2 つ目はレッスン 08 のクイズ(quiz/16)を指しています
- towardsdatascience.com の記事へのリンクは、いくつかが無関係の記事やトップページに転送されるようになっています
- レッスン 11 のチャレンジで紹介されている keras-retinanet は、リポジトリ自身が非推奨(torchvision への移行を推奨)と書いています
レッスンの進め方
各レッスンに講義前・講義後のクイズが付いています。ラボはレッスン 06・07・08・11・12 にあります。
| レッスン | クイズ | ラボ・課題 |
|---|---|---|
| 06 OpenCV | 講義前 / 講義後 | 手のひらを上下左右に動かす動画から、オプティカルフローで動きの向きを判定する |
| 07 CNN | 講義前 / 講義後 | Oxford-IIIT Pet の 37 品種を、CNN を一から作って分類する |
| 08 転移学習 | 講義前 / 講義後 | 同じ 37 品種を、VGG-16 や ResNet-50 を使った転移学習で分類する |
| 09 オートエンコーダー | 講義前 / 講義後 | TensorFlow 版ノートブックの最後の課題(畳み込みで VAE を作る) |
| 10 GAN | 講義前 / 講義後 | ラボなし。自分の画像で GAN やスタイル変換を試す |
| 11 物体検出 | 講義前 / 講義後 | 映画のフレームの Hollywood Heads データセットで、人の頭を検出する |
| 12 セグメンテーション | 講義前 / 講義後 | Kaggle の MADS データセットで、人の体を切り抜く |
レッスン 07 の講義後のクイズのリンクは、README ではなく CNN_Architectures.md の末尾にあります。
レッスン 07 と 08 のラボは、同じ Oxford-IIIT Pet を、一から作った CNN と転移学習で解かせる構成です。筆者が一から作った小さな CNN(パラメータ約 40 万個、128×128 画素)では、30 エポック学習しても検証データの正解率は最高 0.491 で、学習データでは 0.795 と過学習していました。教材が「50% 程度」と書いているのは、だいたいこのくらいが上限ということです。同じデータで転移学習なら、ずっと高い正解率が期待できます。2 つのラボを続けて解くと、転移学習の効果を自分の数字で実感できます。
なお、筆者は Oxford-IIIT Pet の配布元のダウンロードが遅かったため、Hugging Face のミラーから組み立てた 7,349 枚を使いました。また、レッスン 11 のラボの Hollywood Heads は 5.4GB、レッスン 12 のラボの MADS は Kaggle へのログインが必要(約 500MB)です。この 2 つのラボは筆者は動かしていません。
まとめ
- 画像は NumPy の配列で、OpenCV で加工できる。OpenCV のカラー画像は BGR の順に並んでいる
- CNN は小さなフィルターを画像全体に当てて特徴を拾う。畳み込みとプーリングを重ねたピラミッド型が基本で、パラメータが少なくても全結合より高い正解率が出る
- 学習済みの CNN を特徴抽出器として借りる転移学習なら、猫と犬の分類は 1 エポックで 97% 台に届く
- オートエンコーダーと GAN は画像を作り、物体検出は位置を四角で、セグメンテーションは画素ごとに当てる。セグメンテーションのネットワークは、オートエンコーダーと同じエンコーダー・デコーダー型
- ノートブックは Keras 3、PyTorch 2.6 以降、NumPy 2 の変更で止まるセルが多い。Mac では GPU を使うように書き換えないと、学習に何十倍も時間がかかる
- エラーにならないまま結果を変えてしまう誤り(uint8 の桁あふれ、GAN や AAE の学習していない識別器、シグモイドの 2 重がけ)がいくつもあるので、「教材を読むときの補足」を手元に置いて進めるとよい
次のパート「V. 自然言語処理」では、画像の代わりにテキストを扱います。このパートで学んだ「学習済みのモデルを特徴抽出器として使い回す」考え方は、単語の埋め込みや BERT として、そのまま LLM への道につながっていきます(解説: 自然言語処理の基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 13〜20)。