Microsoft の無料カリキュラム AI-For-Beginners のパート「V. 自然言語処理」を解説します。レッスン 13「テキストの表現」から 20「大規模言語モデル」までの 8 本で、Bag of Words・Word2Vec から RNN・Transformer・BERT・GPT までを扱い、このカリキュラムが LLM(大規模言語モデル)にいちばん近づくパートです。
シリーズのほかの記事は次のとおりです。
- 全体の構成: Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う
- レッスン 01: AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01
- レッスン 02: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02
- レッスン 03〜05: ニューラルネットワークの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 03〜05
- レッスン 06〜12: コンピュータビジョンの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 06〜12
前回のパート では画像を扱いました。画像は最初から画素の値の配列なので、そのままネットワークに入れられます。テキストはそうはいきません。単語は数値ではありません。文の長さもばらばらです。さらに「I do not like those big colorful tasty oranges」の not と like のように、離れた単語の関係が意味を決めます。8 つのレッスンは、この難しさに 3 段で取り組みます。
- テキストを数値にする(レッスン 13〜15)。最初は単語の出現回数を数えるだけ(Bag of Words)です。次に、単語を短いベクトルに置き換え、意味の近い単語が近くに来るようにします(埋め込み)。最後に、その埋め込みを「周りの単語から真ん中の単語を当てる」課題で、ラベルのない文章だけから学習します。この「単語を予測する課題で学習する」考え方が、そのまま言語モデルの出発点です
- 語順を扱う(レッスン 16〜17)。単語を 1 つずつ順に読み、それまでの内容を内部の状態にためていく RNN(再帰型ニューラルネットワーク)を使います。分類だけでなく、「次の文字を予測する」を繰り返せば文章も生成できます
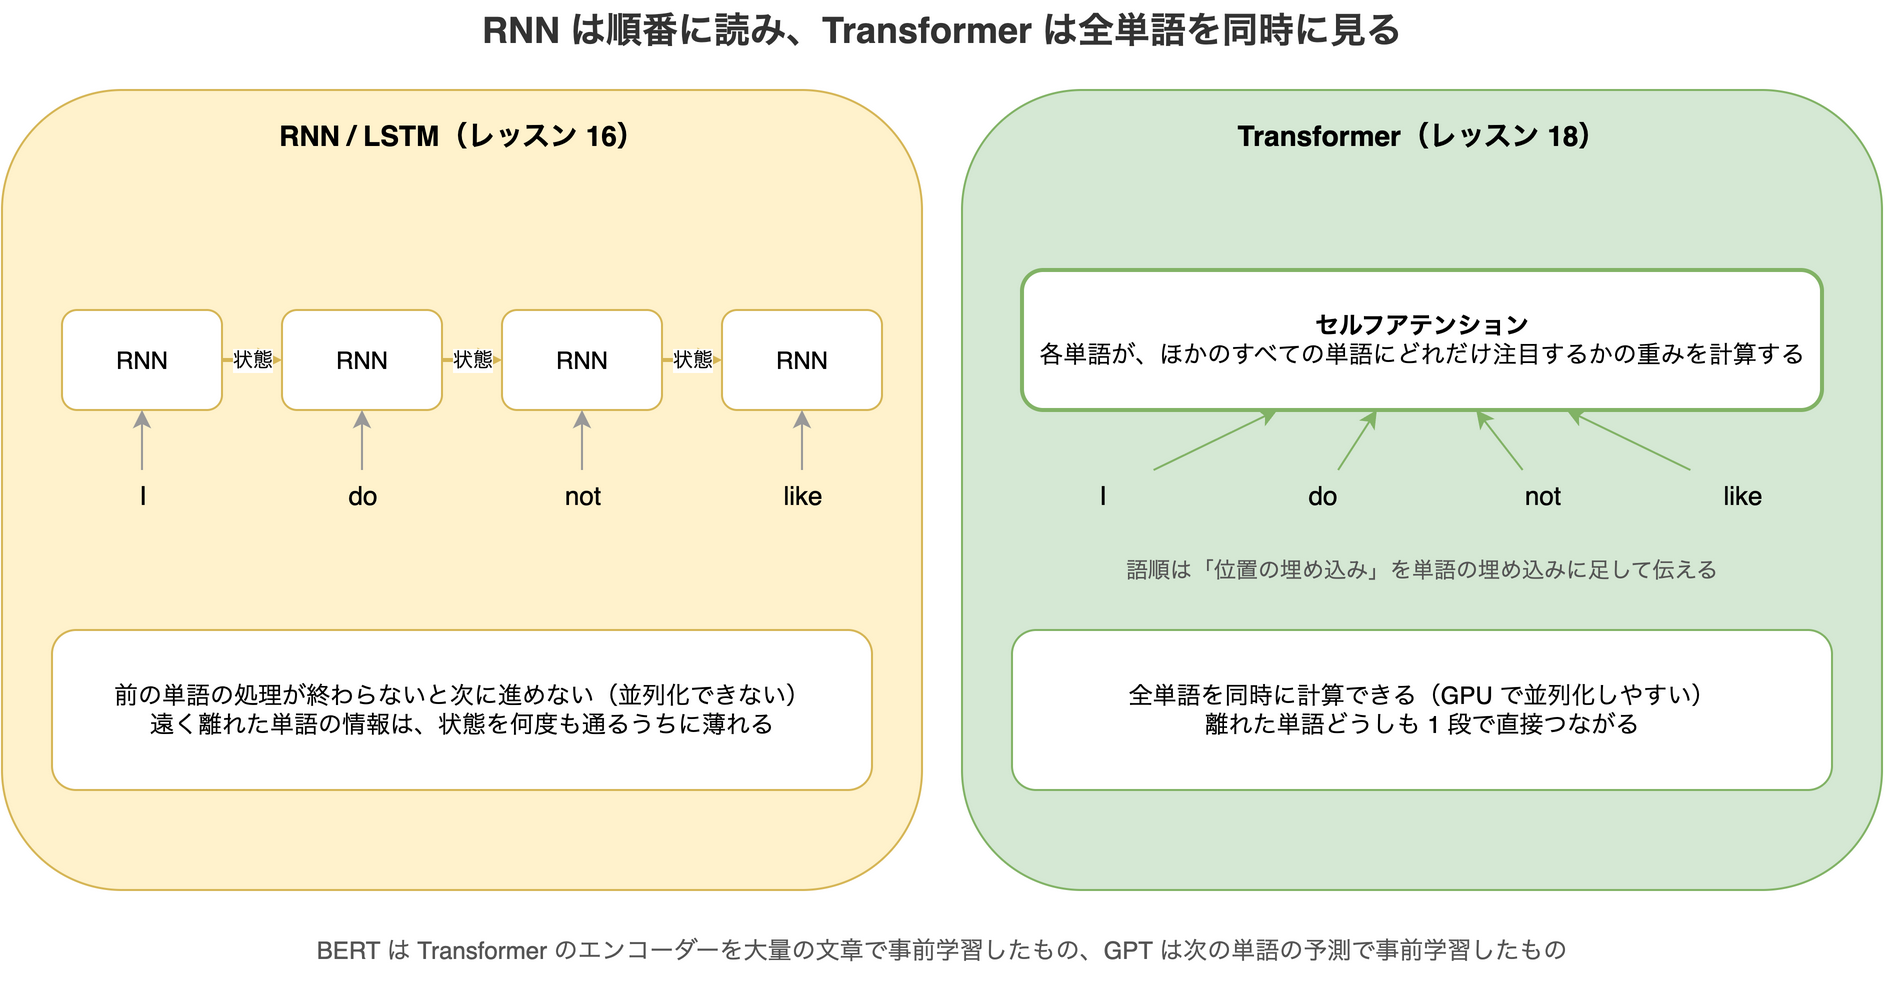
- 全体を一度に見る(レッスン 18〜20)。RNN は順番に読むので遅く、離れた単語の情報が薄れます。Transformer は、すべての単語どうしの関係(アテンション)を一度に計算して、この問題を解決しました。大量の文章であらかじめ学習しておいた(事前学習 した)Transformer が BERT や GPT です。これが、固有表現抽出のような応用や、プロンプトだけでタスクを解く大規模言語モデルにつながります
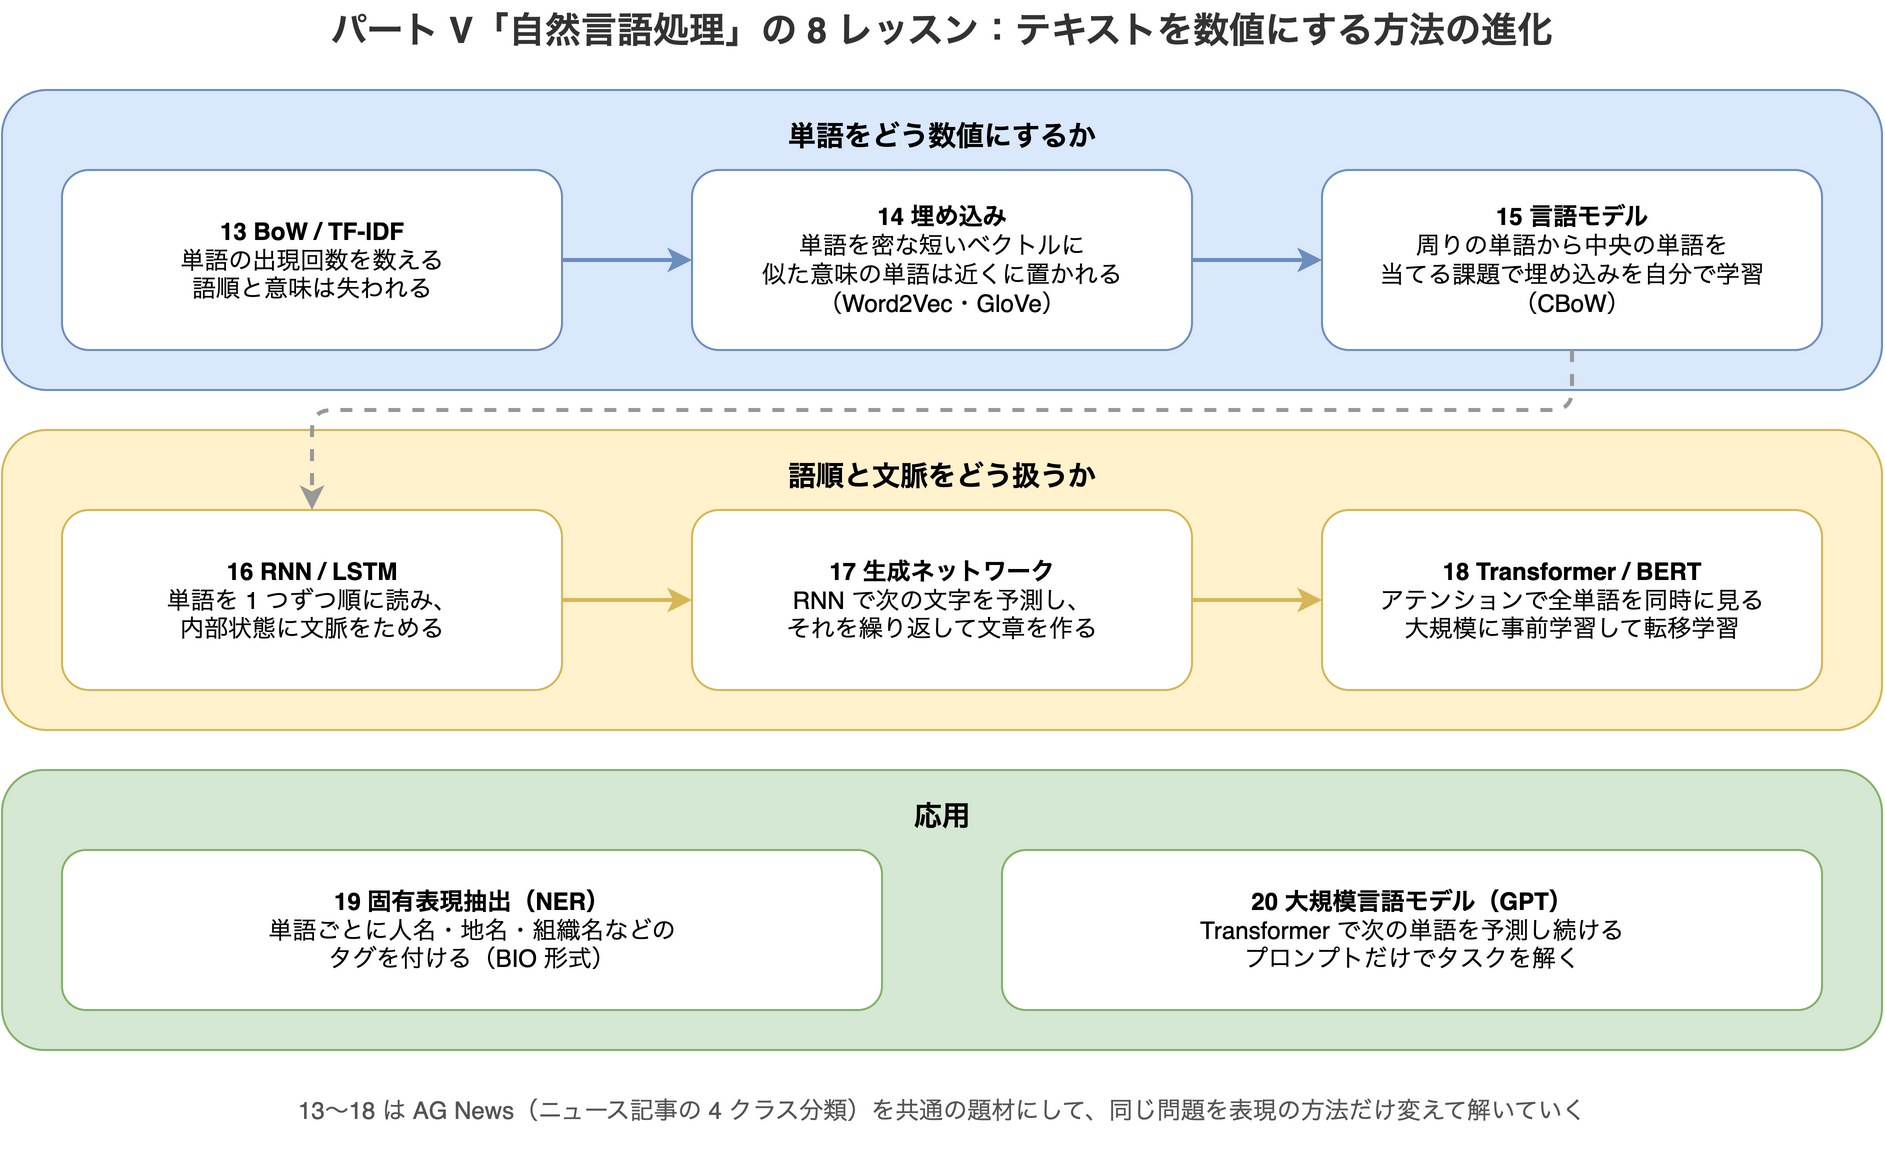
レッスン 13〜18 は、どれも AG News(ニュース記事を World・Sports・Business・Sci/Tech の 4 クラスに分ける公開データ、学習用 12 万件・テスト用 7,600 件)を題材にしています。同じ問題を、テキストの表現の方法だけを変えて解いていくので、手法による違いを比べやすい構成です。
8 レッスン合わせて、ノートブックは 14 本あります。この記事では全ノートブックを 2026 年 9〜10 月時点のライブラリで実際に動かし、その結果も載せます。このパートは前回以上に そのままでは動かない ノートブックが多く、torchtext(PyTorch のテキスト処理用ライブラリ。開発は終了済み)を使う PyTorch 版は、どれもそのままでは動きませんでした。対処法は「ノートブックを今の環境で動かすときの注意」に、教材そのものの誤りは「教材を読むときの補足」にまとめています。
教材の場所は次のとおりです。
- 英語原文: lessons/5-NLP/
- 日本語版: translations/ja/lessons/5-NLP/
筆者の実行環境は、Apple M3 Ultra の Mac 上の Python 3.12.8 です。主なライブラリは NumPy 2.5.3、PyTorch 2.14.0、TensorFlow 2.21.0、Keras 3.15.1、scikit-learn 1.9.1、gensim 4.4.0、Hugging Face Transformers 5.18.0、pandas 3.0.6 です。TensorFlow は CPU で動かしています。PyTorch 版のノートブックが使う torchtext は今の PyTorch では読み込めないため、同じ動作をする小さな代替モジュールを書いて動かしました(詳しくは「torchtext が読み込めない」を参照)。
レッスン 13: テキストを数値で表す(Bag of Words と TF-IDF)
文字単位と単語単位
ニューラルネットワークに入れるには、テキストを数値にする必要があります。教材は 2 つの単位を紹介しています。
- 文字単位: 1 文字を 1 つのベクトルにする。「Hello」は 5 文字なので、文字の種類数 C の one-hot ベクトル(1 か所だけが 1 で残りが 0 のベクトル)が 5 個並ぶ
- 単語単位: 文章を単語(トークン)に分け、出てきた単語の一覧(語彙)を作り、単語を語彙の中の番号に置き換える
ノートブックの例では、AG News の学習データから作った語彙は 95,810 語になりました。単語単位は意味を持つ単位で扱えますが、語彙が大きくなります。
Bag of Words と N-gram
文章全体を 1 つのベクトルにするいちばん単純な方法が Bag of Words(BoW)です。語彙の大きさのベクトルを用意し、文章に出てくる単語の位置に出現回数を入れます。語順は捨てるので「袋に単語を放り込む」という名前です。
語順を少しでも残すために、隣り合う 2 単語(バイグラム)や 3 単語(トライグラム)も 1 つの単語として数える N-gram があります。ただし語彙は爆発的に増え、AG News では単語とバイグラムを合わせて 1,308,842 語になりました。
TF-IDF
BoW では「the」や「a」のような、どの文章にも出てくる単語が大きな値を持ってしまいます。TF-IDF は、文章の中での出現回数(TF、Term Frequency)に、その単語が出てくる文章の少なさ(IDF、Inverse Document Frequency)を掛けて、ありふれた単語の重みを下げます。多くの文章に出てくる単語ほど、文章を見分ける手がかりにならないからです。
BoW と TF-IDF の正解率
BoW をそのまま 1 層の全結合層に入れるだけで、4 クラスの分類はかなりできます。
| ノートブック | 方法 | 正解率 |
|---|---|---|
| PyTorch 版 | BoW(学習データの最初の 15,000 件を 1 周) | 学習中 0.863 / テスト 0.894 |
| TensorFlow 版 | BoW(1 エポック。学習データを 1 周すること) | 検証 0.8688 |
| TensorFlow 版 | 出現回数(output_mode='count') | 検証 0.8775 |
| TensorFlow 版 | TF-IDF(output_mode='tf-idf') | 検証 0.8862 |
検証データは学習の途中で様子を見るためのデータ、テストデータは最後の評価だけに使うデータです。どちらも学習には使っていないので、だいたい比べられます。PyTorch 版のノートブックはテストデータで評価していないので、テストの値は筆者が評価のコードを足して計算したものです。TF-IDF にすると、BoW より正解率が上がりました(0.8688 → 0.8862)。
教材は最後に、言語学者 J. R. Firth の「単語の完全な意味は、常に文脈の中にある」という言葉を引用します。BoW は単語の数を数えるだけで、意味も文脈も扱えません。次のレッスンからは、それを扱う方法に進みます。
レッスン 14: 単語の埋め込み(Word2Vec と GloVe)
単語を短いベクトルにする
BoW や one-hot のベクトルは、語彙の数(数万〜数十万)の長さがあり、ほとんどが 0 です。しかも、どの 2 単語も互いに同じだけ離れていて、「cat」と「dog」が似ているという情報がありません。
埋め込み(embedding)は、単語を数十〜数百次元の短いベクトルに置き換える方法です。意味の近い単語が近いベクトルになるように学習します。ネットワークの中では Embedding 層 が担当し、単語の番号を受け取って、その番号の行のベクトルを返します。番号を入力にする全結合層と考えると分かりやすいです。
文章を分類するには、文章中の単語ベクトルを平均などでまとめて 1 本のベクトルにします。PyTorch には、このまとめまでを 1 つの層で行う EmbeddingBag があります。ふつうは長さの違う文章を 0 で埋めてそろえます(パディング)。EmbeddingBag は代わりに、文章の区切り位置(オフセット)を渡すだけで扱えます。
Word2Vec と GloVe
埋め込みは、分類の学習の中で一緒に学習することもできますが、大量の文章であらかじめ学習したものを使うこともできます。代表例が Word2Vec で、周りの単語から真ん中の単語を当てる CBoW と、真ん中の単語から周りの単語を当てる skip-gram の 2 つの方式があります(教材の skip-gram の説明は逆になっています。「教材を読むときの補足」を参照)。
ノートブックでは、Google ニュースの記事で学習済みの 300 次元の Word2Vec(gensim でダウンロード、約 1.7GB)を使います。
- 「neural」に近い単語は「neuronal」(コサイン類似度 0.780)など
- 「king − man + woman」に最も近い単語は「queen」(コサイン類似度 0.7118)
コサイン類似度は 2 つのベクトルの向きの近さで、1 に近いほど似ています。小数の桁数は、ノートブックや gensim の表示に合わせています。
ベクトルの足し引きで「王様から男性を引いて女性を足すと女王」という関係が出てくる、有名な例です。ほかに、単語の部分文字列の埋め込みも学習する FastText と、単語が一緒に出てくる回数の表(共起行列)から作る GloVe も紹介されています。
学習済みの埋め込みで分類する
学習済みの埋め込みを分類器の Embedding 層に入れれば、少ないデータでも意味を使えるはず、というのがノートブックの狙いです。ところが、この部分には PyTorch 版・TensorFlow 版の両方に誤りがあり、ノートブックの記録では学習済みの埋め込みがほとんど効いていないように見えます。PyTorch 版は学習済みの重みが実際には 1 つも書き込まれていません。TensorFlow 版は、埋め込みの表(単語の番号ごとにベクトルを並べた行列)の中で、単語と重みの対応が 2 行ずれています。TensorFlow 版のずれを直すと、検証データの正解率は 0.6086 から 0.8661 に上がりました。詳しくは「教材を読むときの補足」で説明します。
教材は最後に、埋め込みの限界にも触れています。「play」は「遊ぶ」でも「演奏する」でも同じベクトルになります。文脈によって意味が変わる単語を扱うには、レッスン 18 の BERT のように、文脈を見て単語の表現を変えるモデルが必要です。
レッスン 15: 言語モデルで埋め込みを学習する(CBoW)
ラベルなしの文章から学習する
Word2Vec のような埋め込みは、ラベルのない大量の文章から学習できます。文章の一部の単語を隠して、それを当てる課題を作れば、正解は文章そのものの中にあるからです。正解ラベルの代わりに文章そのものを正解に使う、前回のパートのオートエンコーダーと同じ自己教師あり学習です。教材は 3 つの方式を紹介しています。
- N-gram 言語モデル: 直前の N 個の単語から次の単語を当てる
- CBoW(Continuous Bag-of-Words): 前後 N 個ずつの単語から、真ん中の単語を当てる
- skip-gram: 真ん中の単語から、前後の単語を当てる
ノートブックは CBoW を自作します。語彙を頻度上位 5,000 語にし、30 次元の Embedding 層と、語彙の数だけ出力を持つ全結合層をつないで、「周りの単語 → 真ん中の単語」のペアを分類問題として学習します。
学習した埋め込みの近い単語
TensorFlow 版をノートブックと同じ 200 エポック(約 32 分)学習させると、損失は 5.0283(記録は 5.0190)になり、意味の近い単語がちゃんと近くに来るようになりました。
| 単語 | 近い単語(筆者の実行) | ノートブックの記録 |
|---|---|---|
| china | israel, russia, britain, europe | russia, pakistan, israel, turkey |
| official | diplomats, department, military, diplomat | military, office, police, sources |
国名の近くに国名が、「official」の近くに政府関係の単語が集まっています。一方、PyTorch 版は 10 エポック後も「microsoft」の近くに「refugees」「restructuring」が来るなど、意味のない結果でした。原因は教材のコードの誤りです。テスト用の 7,600 件で学習しているうえ、語彙を最初の 501 件の記事だけから作っています。そのため、学習データの単語の 19% が、語彙にない単語をまとめて置き換える記号(<unk>)になっています。
教材のまとめは、「自分の分野の文章で埋め込みを学習するのは難しくない」というものです。
レッスン 16: 再帰型ニューラルネットワーク(RNN)
語順を扱う
埋め込みを平均するモデルは、語順を捨てています。「not … like」のような関係を捉えるには、単語を順番に読む必要があります。
RNN は、単語を 1 つずつ入力し、そのたびに内部の 状態 を更新するネットワークです。各ステップで、今の単語のベクトル X_i と 1 つ前の状態 S_{i−1} から、新しい状態 S_i を計算します(S_i = f(W·X_i + H·S_{i−1} + b)。W と H は重み、b はバイアス、f は活性化関数)。すべてのステップで同じ重みを使うので、どんな長さの文章でも扱えます。
LSTM と GRU
単純な RNN は、ステップを重ねるうちに勾配(学習で重みを直す量)が小さくなりすぎる 勾配消失 を起こし、長い文章の前のほうを学習できません。これを解決したのが LSTM(Long Short-Term Memory)です。
LSTM は、通常の状態(隠れ状態 h)とは別に、長期の記憶を運ぶ セル状態 c を持ち、3 つの ゲート(どれだけ通すかを 0〜1 で決める仕組み)で情報の出し入れを制御します。
- 忘却ゲート: セル状態のどの部分を忘れるかを決める
- 入力ゲート: 新しい情報のどの部分をセル状態に加えるかを決める
- 出力ゲート: セル状態のどの部分を、隠れ状態 h として出力するかを決める
LSTM を簡単にした GRU(Gated Recurrent Unit)もあります。さらに、文章を後ろからも読む 双方向 RNN や、RNN を何層も重ねる 多層 RNN も紹介されています。
LSTM と単純な RNN の比較
RNN と LSTM で AG News を分類した結果です(どれも 1 エポック)。
| モデル | PyTorch 版(テスト) | TensorFlow 版(検証) |
|---|---|---|
| 単純な RNN | 0.881 | 0.794(タイトルのみ)/ 0.872(本文も使用) |
| LSTM | 0.893 | 0.895 |
pack_padded_sequence を使う LSTM(PyTorch)/ 2 層の双方向 LSTM(TensorFlow) | 0.897 | 0.898 |
pack_padded_sequence は、パディングした部分を RNN に読ませないようにする PyTorch の機能です。PyTorch 版のノートブックは学習中の正解率しか表示しないので、テストの値は筆者が評価のコードを足したものです。TensorFlow 版の 2 層の双方向 LSTM は、ノートブックの記録では学習が途中で止まっていて最終的な値が残っておらず、表の 0.898 は筆者の実行結果です。
LSTM は単純な RNN より正解率が上がりますが、レッスン 13 の TF-IDF(0.886)と比べると、差はわずかです。ニュースの分類のように、どんな単語が出てくるかで大部分が決まる問題では、語順の効果は大きくありません。
PyTorch 版の RNN は、Mac の GPU(MPS)を使っても速くなりませんでした(単純な RNN で CPU 40.8 秒、MPS 117.7 秒)。小さなモデルを 1 ステップずつ動かすので、GPU に処理を渡す手間のほうが大きくなるためです。
レッスン 17: RNN で文章を生成する
次の文字を予測して文章を作る
RNN の使い方は分類だけではありません。教材は、入力と出力の形で 4 つに分けています。
- 一対一: 1 つの入力から 1 つの出力(RNN を使わないふつうのネットワーク)
- 一対多: 画像から説明文を作る
- 多対一: 文章の分類(レッスン 16)
- 多対多: 翻訳のように、文章から文章を作る(seq2seq)
このレッスンでは、次の文字を予測する ネットワークを学習します。正解は「入力を 1 文字ずらしたもの」なので、ラベルは要りません。文章を生成するときは、最初の数文字(プロンプト)を入れて状態を作り、予測した文字を入力に戻す操作を繰り返します。
貪欲法と温度
いちばん確率の高い文字を毎回選ぶ(貪欲法)と、同じ言い回しを繰り返しがちです。PyTorch 版を筆者が動かした例でも「today of the service to the service to the service…」のように、同じ句がループしました。
そこで、予測の確率に従ってランダムに文字を選びます。温度 T で確率の分布を調整し、T を大きくするとより平らに(ランダムに)、小さくするとより貪欲法に近くなります。
PyTorch 版を筆者が動かすと、T = 0.3 では「Today and Australia #39;s and a company…」のようなそれらしい文章、T = 1.8 では意味のない文字列になりました。#39; は、AG News のデータに残っているアポストロフィの文字参照です。
TensorFlow 版はニュースのタイトルだけで学習するので、「Today Pot Begins Unveiling North Climb Movers (Reuters)」のような、タイトルらしい文字列が生成されました。
レッスン 18: Transformer と BERT
アテンション
翻訳のような seq2seq の RNN は、入力文全体を最後の 1 つの状態に詰め込んでから、出力文を生成します。そのため、長い文では最初のほうの情報が失われます。アテンション は、出力の各単語を作るときに、入力のすべての単語の状態に重みを付けて参照する仕組みです(Bahdanau ら、2015 年)。
Transformer
RNN は単語を順に処理するので、並列に計算できません。2017 年の論文「Attention Is All You Need」の Transformer は、RNN をやめて、アテンションだけで文を処理します。
- セルフアテンション: 文の中の各単語が、同じ文のほかの単語にどれだけ注目するかを計算する。「it」が何を指すかのような関係を捉えられる
- マルチヘッドアテンション: 注目の仕方を複数(ヘッド)並べて、違う種類の関係を同時に捉える
- 位置の埋め込み: 全単語を同時に見るので、語順の情報が消える。そこで、単語の位置を表すベクトルを単語の埋め込みに足す
BERT
BERT は、Transformer のエンコーダー部分(入力文を読んで各単語の表現を作る側。base は 12 層、large は 24 層)を、Wikipedia と書籍の大量の文章で事前学習したモデルです。文の一部の単語を隠して当てる課題(マスク言語モデル)で学習します。それを自分の問題で少しだけ追加学習(ファインチューニング)すれば、高い性能が出ます。前回のパート の画像の転移学習と同じ考え方です。
BERT と自作 Transformer の正解率
| ノートブック | モデル | 正解率 |
|---|---|---|
| PyTorch 版 | BERT(bert-base-uncased)、500 ステップ(ミニバッチ 500 個分)学習 | テスト 0.896(Mac の GPU で 36 秒) |
| TensorFlow 版 | 自作の Transformer ブロック、1 エポック | 検証 0.9179 |
| TensorFlow 版 | 小さな BERT(4 層)を凍結して分類層だけ学習 | 検証 0.7933 |
| TensorFlow 版 | 小さな BERT も含めて学習(教材のまま) | 検証 0.8245 |
| TensorFlow 版 | 同上、学習率のスケジュールの誤りを修正 | 検証 0.8916 |
TensorFlow 版の数値は、「互換モードで動かす」で説明する Keras 2 系の tf-keras で動かしたものです。学習の条件も、評価に使ったデータ(テストか検証か)もそろっていないので、表の値は手法の優劣を表すものではありません。BERT を含めた学習は、学習率を少しずつ上げてから下げる「スケジュール」の計算が教材のままだと誤っていて、学習率がほとんど上がりません。直すと、検証の正解率は 0.8245 から 0.8916 に上がりました。
レッスン 19: 固有表現抽出(NER)
単語ごとにタグを付ける
チャットボットで「明日の東京の天気は?」と聞かれたら、意図(天気を知りたい)と、その中の具体的な値(明日、東京)を取り出す必要があります。後者のように、文中の人名・地名・組織名・日付などを見つけるのが 固有表現抽出(NER)です。
NER は、単語ごとにタグを付ける分類問題として解きます。複数の単語からなる固有表現を表すために、BIO 形式 を使います。固有表現の最初の単語に B-(Begin)、続く単語に I-(Inside)、それ以外に O(Outside)を付けます。
| 単語 | John | Smith | went | to | Paris |
|---|---|---|---|---|---|
| タグ | B-per | I-per | O | O | B-geo |
per は人名(person)、geo は地名(geographical)を表します。
ノートブックは、Kaggle の「Annotated Corpus for Named Entity Recognition」(タグを付けた文章を集めたデータ。約 4.8 万文、17 種類のタグ)を、埋め込み → 2 層の双方向 LSTM → 単語ごとの分類 というネットワークで学習します。レッスン 17 の「多対多」の RNN です。
NER の正解率の見方
1 エポックで正解率は 0.9851 になり、テストの文「John Smith went to Paris」の人名・地名も正しく取れました。ただし、この正解率は見かけほど高くありません。
- 全文を最長の 104 単語に合わせてパディングしているので、評価する位置の 79% がパディング
- 実際の単語も 85% が O
「全部 O」と答えるだけで、正解率は 0.968 になります。筆者がデータの 10% を学習から外して評価すると、固有表現の単位で数えた F1 値は 0.775 でした。F1 値は、適合率(見つけたもののうち正しかった割合)と再現率(正解のうち見つけられた割合)の調和平均です。NER の評価には、単語単位の正解率ではなく、固有表現単位の F1 値を使うのが一般的です。
レッスン 20: 大規模言語モデル(GPT)
GPT
GPT(Generative Pre-trained Transformer)は、Transformer で 次の単語を予測する 言語モデルです。GPT-2 の論文は、大量の文章で事前学習するだけで、追加の学習なしに(ゼロショット)、あるいは例をいくつか見せるだけで(少数ショット)、さまざまなタスクを解けることを示しました。
言語モデルは、文の単語列 W の確率 P(W) を、前の単語から次の単語の条件付き確率を掛け合わせて計算します。その良さは パープレキシティ(1/P(W) の N 乗根、N は単語数)で測ります。おおよそ、モデルが次の単語を平均で何個の候補の中から迷っているかを表し、小さいほど文章をよく予測できています。
教材は、GPT-2(15 億パラメータ)、GPT-3(1,750 億パラメータ)と、Azure OpenAI や OpenAI API での利用、そして プロンプトエンジニアリング(解かせたいタスクが伝わるようにプロンプトを工夫すること)を紹介します。GPT-4 を「100 兆パラメータ」とする表の誤りについては、全体の記事 で書いたとおりです。OpenAI の GPT-4 Technical Report は、モデルの大きさを公表していません。
ノートブックの GPT は GPT-1
ノートブックは、Hugging Face Transformers の pipeline('text-generation', model='openai-gpt') で文章を生成します。この openai-gpt は、レッスン 20 の README の表に載っていない最初の GPT(GPT-1、約 1.2 億パラメータ)です。
# ノートブックのセルから抜粋。generator は pipeline('text-generation', model='openai-gpt') で作ったもの
generator("I love when you say this -> Positive\nI have myself -> Negative\nThis is awful for you to say this ->", max_length=40, num_return_sequences=5)
少数ショットで感情を判定させる例ですが、GPT-1 では Positive と Negative が入り混じった答えになりました。翻訳や類義語の例もうまくいかず、ノートブックに残っている出力も同じです。プロンプトだけでタスクを解けるのは、GPT-3 以降の大きなモデルになってからの話です。教材の LLM の章が GPT-2 / GPT-3 の時代で止まっていることは、全体の記事 でも触れました。
ノートブックを今の環境で動かすときの注意
このパートのノートブックは、2022 年に作られたものがほとんどで、Keras 3 や torchtext の開発終了には対応していません。2026 年 9〜10 月時点のライブラリで動かすと、次の箇所で止まったり、黙っておかしな動きをしたりしました。
日本語版のフォルダからは動かない
日本語版のフォルダには、翻訳されたノートブックがあります。コードのセルは英語版と同じです。ただし、PyTorch 版のノートブックが読み込む補助モジュール torchnlp.py が日本語版のフォルダにはなく、次のエラーで止まります。
ModuleNotFoundError: No module named 'torchnlp'前回のパートと同じく、ノートブックは英語版の lessons/ のフォルダで動かし、説明は日本語版で読むのが確実です。
torchtext が読み込めない(レッスン 13〜18 の PyTorch 版)
レッスン 13〜18 の PyTorch 版のノートブックは、どれも torchtext(PyTorch のテキスト処理用ライブラリ)で単語の分割・語彙の作成・AG News の読み込みを行っています。torchtext は 2024 年の 0.18.0 で開発を終えていて、今の PyTorch とは組み合わせられません。やっかいなのは、pip install torchtext は成功してしまうことです。読み込もうとして初めて、次のエラーで止まります。
OSError: Could not load this library: .../site-packages/torchtext/lib/libtorchtext.so内部の C++ ライブラリが、古い PyTorch(2.3 前後)に合わせてビルドされているためです。公式の解決策はありません。筆者は、ノートブックが使う 4 つの機能だけを作り直した小さなモジュールで動かしました。対象は get_tokenizer('basic_english')、ngrams_iterator、vocab、AG_NEWS で、中身は torchtext 0.18 のソースから Python の部分を写したものです(このモジュールは公開していません)。AG News は torchtext と同じ CSV ファイルを読み込み、ノートブックに記録された語彙の大きさや単語の番号がすべて一致することを確かめています。
自分で書き直すなら、単語の分割は正規表現、語彙は Python の dict、データは Hugging Face の datasets か CSV の直接読み込みで置き換えられます。
requirements ファイルではインストールできない
パートのフォルダにある requirements-pytorch.txt と requirements-tf.txt は、どちらもそのままではインストールできません。
requirements-pytorch.txtは、torch==2.13.0と、2021 年の torch 1.8 時代のtorchvision==0.9.1・torchaudio==0.8.1・torchtext==0.9.1・numpy==1.22.0を並べて指定している。ファイルの最近の更新は依存関係の自動更新(Dependabot)による torch の行の更新だけで、ほかの行は古いまま残っている。そのため、どの Python のバージョンでも全部はそろわないrequirements-tf.txtは、numpy==1.22.0と今の TensorFlow が両立しない。またtransformers==5.10.1を指定しているが、Transformers 5 では TensorFlow 用のクラスが削除されている
ファイルは参考程度にして、必要なライブラリを個別に入れるのが現実的です。
Keras 3 で変わったこと
TensorFlow 版のノートブックは、Keras 3 で次のエラーが出ます。前回のパートと共通のものも多くあります。
| エラー | 対処 |
|---|---|
module 'keras._tf_keras.keras.layers' has no attribute 'experimental' | keras.layers.experimental.preprocessing.TextVectorization を keras.layers.TextVectorization にする |
Cast string to float is not supported | TextVectorization(..., input_shape=(1,)) の input_shape をやめ、モデルの最初に keras.Input(shape=(1,), dtype=tf.string) を置く |
A KerasTensor cannot be used as input to a TensorFlow function | モデルの中の tf.one_hot や tf.reduce_sum を keras.ops.one_hot や keras.ops.sum にする |
Argument(s) not recognized: {'lr': 0.1} | SGD(learning_rate=0.1) にする(レッスン 15) |
Cannot take the length of shape with unknown rank | tf.py_function が返したテンソルに set_shape で形を設定する(レッスン 17) |
Layer TransformerBlock has multiple required positional arguments: [inputs, training] | def call(self, inputs, training=None) のように training に既定値を付ける(レッスン 18) |
Cast string to float is not supported のエラーは、文字列を受け取る層の前に、Keras 3 が自動で小数の入力を作ってしまうために起きます。次のように書き換えると動きました。
model = keras.models.Sequential([
    keras.Input(shape=(1,), dtype=tf.string),
    vectorizer,
    # 以下、ノートブックの層はそのまま
])
Keras 3 で正解率が下がるセル(レッスン 14)
エラーは出ないのに、Keras 3 だと結果が悪くなるセルもありました。レッスン 14 の TensorFlow 版の最初の分類(最適化手法を指定せず、既定の RMSprop を使うセル)は、ノートブックの記録では検証の正解率 0.8642 ですが、Keras 3 では 0.6874 でした。同じコードを互換モード(後述)で動かすと 0.8629 で、記録とほぼ同じです。
調べると、Keras 3 の RMSprop と Adam では、ミニバッチの中で同じ単語が n 回出てくると、その単語の埋め込みの更新量が √n 倍になっていました(n = 100 で 10 倍)。「the」のような頻出の単語ほど大きく動いてしまうわけです。原因は、Keras 3 のソースを読んだかぎりでは、同じ行への勾配を足し合わせる前に 1 つずつ二乗しているためと推測しています。optimizer='adam' を指定するとこのセルは 0.8728 になりましたが、Adam も同じ問題を持つので、根本的な解決ではありません。
互換モードで動かす(レッスン 18 の TensorFlow 版)
レッスン 18 の TensorFlow 版は、TensorFlow Hub の BERT、TensorFlow Model Garden(official パッケージ)、Hugging Face の TensorFlow 版 BERT と、Keras 3 に対応していない部品を多く使っています。
- TensorFlow Hub の層は、Keras 3 のモデルの中に入れると
A KerasTensor is symbolic ... You cannot convert it to a NumPy arrayで止まる officialパッケージ(tf-models-official)は、TensorFlow 2.20 を要求するので、2.21 の環境には入らない- Hugging Face Transformers 5 には TensorFlow 用のクラス自体がない(
module transformers has no attribute TFBertForSequenceClassification)
いちばん手早いのは、Keras 2 系を別パッケージにした tf-keras を入れて、TensorFlow を読み込む前に環境変数 TF_USE_LEGACY_KERAS=1 を設定する方法です。手順は次のとおりです。
- tf-keras と、TensorFlow Hub の BERT が使うパッケージを入れる(筆者の環境では tf-keras 2.21.0、tensorflow-text 2.21.1、tensorflow-hub 0.16.1)
- ノートブックの最初のセルで、TensorFlow を読み込む前に環境変数を設定する
- TensorFlow Hub の読み込みで
pkg_resourcesがないというエラーが出たら、setuptoolsを 82 未満にする(82 でpkg_resourcesが削除された) - Hugging Face の部分を動かすなら、Transformers 4 系を入れる(筆者は 4.57.6)
pip install tf-keras tensorflow-text tensorflow-hubimport os
os.environ["TF_USE_LEGACY_KERAS"] = "1"
import tensorflow as tfこの互換モードでは、レッスン 18 の自作 Transformer のセルは書き換えなしで動きました。official パッケージだけは入らないので、筆者はノートブックが使う学習率のスケジュールの部分を写した代わりのモジュールで動かしました。
pandas 2 で「None」が欠損値になる(レッスン 19)
NER のノートブックは、語彙を作るセルで次のエラーになります。
AttributeError: 'float' object has no attribute 'lower'pandas 2.0 で、CSV を読むときに欠損値とみなす文字列に「None」が加わりました。コーパスに英単語の「None」が 10 回出てくるため、それが欠損値(小数の NaN)になってしまいます。次のように、欠損値として扱う文字列を指定し直すと動きました。
df = pd.read_csv('ner_dataset.csv', encoding='unicode-escape', keep_default_na=False, na_values={'Sentence #': ['']})keep_default_na=False だけにすると、文の区切りを判定している列(Sentence #)の空欄まで欠損値でなくなり、文の区切りが壊れます。なお、Kaggle のデータのダウンロードにはログインが必要なので、筆者は Hugging Face にある同じデータの複製(約 4.8 万文・104 万 8,575 行)から CSV を作り直しました。
pipeline が max_length を無視する(レッスン 20)
GPT のノートブックは max_length=40 などで生成の長さを指定していますが、今の Transformers では次の警告が出て、248〜277 トークンもの長い文章が生成されます(警告は max_length=100 のセルのもの)。
Both `max_new_tokens` (=256) and `max_length`(=100) seem to have been set. `max_new_tokens` will take precedence.Transformers 4.52 以降、文章生成の pipeline には「新しく 256 トークンまで生成する」という既定の設定があり、そちらが優先されるためです。max_new_tokens=None を一緒に渡すと、指定どおりの長さになりました。
generator("People who liked the movie The Matrix also liked ", max_length=40, max_new_tokens=None, num_return_sequences=5)その他
- Mac の GPU: PyTorch 版は CUDA がなければ CPU を使う書き方です。レッスン 18 の BERT は Mac の GPU(MPS)を使うように書き換えると 500 ステップの学習が 36 秒で終わりますが、レッスン 16 で書いたとおり、小さな RNN は MPS の方が遅くなりました
- レッスン 18 の PyTorch 版:
bert_model = './bert'という行が、リポジトリにないフォルダを指していて止まります(Microsoft Learn 用の名残)。この行を消すと、直前のbert-base-uncasedが使われます - Hugging Face のダウンロードが止まる:
openai-gptのダウンロードが 0 バイトのまま 10 分以上止まりました。環境変数HF_HUB_DISABLE_XET=1を設定して、Hugging Face の新しいファイル転送方式(Xet)ではなく従来の方式でダウンロードすると、約 4 分で終わりました
教材を読むときの補足
教材そのものの誤りをまとめます。日本語版は英語版の誤りもそのまま翻訳しているので、特に断りがなければ英語版・日本語版に共通です。
結果を変えてしまうコードの誤り
エラーにならないので気づきにくく、いちばん注意が要るものです。
- クラス名の表示がずれている(レッスン 13): PyTorch 版は、AG News のラベル(1〜4)をそのまま 0 始まりの一覧の番号に使っていて、「Business」の記事が「Sci/Tech」と表示されます。学習のコードの方は正しく 1 を引いています
- 「頻度の高い単語」が実は「先に出てきた単語」(レッスン 13): PyTorch 版は「語彙を 5,000 語に制限すれば頻度の高い単語が残る」と説明しますが、torchtext の語彙は出てきた順に並んでいます。最初の 5,000 語と頻度上位 5,000 語で重なるのは 2,525 語だけで、テストの正解率は 0.8445 と 0.8705 でした
- 損失をバッチサイズで 2 回割っている(レッスン 13 の PyTorch 版と、レッスン 14 以降で使う
torchnlp.py): ミニバッチごとの 平均 の損失を足し、それをさらにサンプル数で割っています。表示される損失は本来の値(0.42)の約 1/16(0.026)です。前回のパートのpytorchcv.pyと同じ誤りです - 学習済みの埋め込みが書き込まれていない(レッスン 14): PyTorch 版は
net.embedding.weight[i].data = torch.tensor(...)で 1 行ずつ書き込んでいるつもりですが、これは一時的な切り出しの.dataを置き換えるだけで、重みは変わりません(書き込み前後の差は 0.0)。「41,080 語見つかった」と表示されるのに、実際にはランダムな初期値で学習しています。重みの行列を作ってnet.embedding.weight.data.copy_(W)で書き込みます - 学習率が大きすぎる(レッスン 14): PyTorch 版は Adam の学習率を 1 や 4 にしています。25,000 件で比べると、学習率 4 でテスト 0.816、0.01 で 0.893 でした。0.01 で全データを 1 エポック学習すると 0.913 で、教材の「約 90%」はこちらで実現します
- 埋め込みが 2 行ずれている(レッスン 14): TensorFlow 版の
TextVectorizationは語彙の 0 番を空文字、1 番を不明な単語用に予約しますが、gensim の Word2Vec の行列はそのまま 0 番から並んでいます。そのため、すべての単語が 2 つ隣の単語のベクトルを読んでいます(「king」の行に「lands」のベクトルが入っている)。ノートブックはこの結果(0.61)を「学習済みの語彙にない単語が多いため」と説明していますが、誤りです。np.concatenate([np.zeros((2,300)), w2v.vectors])のように 2 行足すと、0.8661 になりました - 学習データとテストデータが逆(レッスン 15): PyTorch 版は
test_dataset, train_dataset = torchtext.datasets.AG_NEWS(...)と受け取っていますが、AG_NEWS が返す順番は (学習, テスト) です。12 万件の学習データは使われず、テスト用の 7,600 件で学習しています。さらに語彙を最初の 501 件だけから作るので、19% の単語が<unk>になります - 温度を下げるとエラーになる(レッスン 17): PyTorch 版の
generate_softは確率をexp(logit/T)で計算していて、T が 0.1 以下だと値が無限大にあふれ、RuntimeError: probability tensor contains either inf, nan or element < 0で止まります。softmax(logit/T)で計算すれば問題ありません - マスクが効いていない(レッスン 17): TensorFlow 版は、パディングを one-hot の 0 番([1, 0, 0, …])で表したうえで
Masking層を使っています。Maskingが無視するのは全要素が 0 の位置なので、何もマスクされません。しかもパディングは文の前に入るので、モデルは「0 番を出力する」ことも学習します。その 0 番を生成時に選ぶとKeyError: 0で止まり、ノートブックに残っている出力もこのエラーで終わっています - 最初の生成文字が 2 回入力される(レッスン 17): TensorFlow 版の
generateはchars = inpと同じリストを指しているため、生成した 1 文字目が 2 回モデルに入ります。生成例に「#39;」が「#9;」になって出てくるのはこのためです。chars = list(inp)で直ります - 学習率がほとんど上がらない(レッスン 18): TensorFlow 版の BERT の学習は、学習率を少しずつ上げる「ウォームアップ」の長さを
len(ds_train)(12 万件、つまりサンプル数)から計算しています。実際の学習は 1 エポック 938 ステップ(バッチ数)なので、ウォームアップの 36,000 ステップのうち 938 ステップしか進まず、学習率は目標の 3e-5 に対して最大 7.8e-7 にしかなりません。バッチ数で計算し直すと、検証の正解率は 0.8245 から 0.8916 に上がりました。epochs = 3と書いているのにfitに渡していないので、学習も 1 エポックだけです - 損失関数がロジットを確率として扱っている(レッスン 18): Hugging Face の
TFBertForSequenceClassificationは確率ではなくロジット(Softmax をかける前の値)を出力しますが、損失は確率を前提にした'sparse_categorical_crossentropy'です。損失は ln 4 = 1.386 に張り付き、正解率は当てずっぽうの 0.25 前後のままです。ノートブックに残っている出力(正解率 0.25、検証 0.248)も同じ状態です。SparseCategoricalCrossentropy(from_logits=True)にします - NER の正解率はパディングで水増しされている(レッスン 19): 前述のとおり、「全部 O」で 0.968 になります。また、語彙に不明な単語の受け皿がないので、学習データにない単語を入れると
KeyErrorになります
記述の誤り
- TF-IDF の式(レッスン 13): ノートブックの式(tf × log(N/df))と、実際に使っている scikit-learn の計算(平滑化した idf に 1 を足し、さらにベクトルを正規化)は別物です。すべての文書に出てくる単語の idf は、式では 0、scikit-learn では 1 になります
- skip-gram の説明が逆(レッスン 14): README と両方のノートブックは、skip-gram を「周りの単語から今の単語を予測する」と説明していますが、それは CBoW の説明です。skip-gram は、今の単語から周りの単語を予測します(Word2Vec の論文、arXiv 1301.3781)。レッスン 15 の説明は正しいので、2 つのレッスンで説明が食い違っています
- GloVe の説明(レッスン 14): PyTorch 版は GloVe を「ニューラルネットワークで共起行列を非線形のベクトルに分解する」と説明していますが、GloVe は共起回数の対数を重み付き最小二乗法で近似するモデルです。TensorFlow 版の「行列の分解」という説明の方が正確です
- 単語の足し引きの「係数の調整」(レッスン 14): ノートブックは king − man + woman で queen を出すために「係数を調整する必要があった」と書いていますが、本当の理由は、計算に使った単語(king など)を候補から外していないことです。gensim の
most_similarのように入力の単語を除き、コサイン類似度で比べれば、係数を調整しなくても queen になります - CBoW の実装は 1 単語ずつのペア(レッスン 15): ノートブックの「CBoW」は、周りの単語を 1 つずつ真ん中の単語と組にして学習していて、周りの単語の埋め込みを平均する本来の CBoW とは違います。この作り方だと、ラボで課題にしている「skip-gram への少しの変更」をしても、学習データの組はまったく同じになります
- 「Gated Relay Unit」(レッスン 16): GRU は Gated Recurrent Unit の略です。日本語版は「ゲート付きリレー単位」と直訳しています
- LSTM の出力ゲートの説明(レッスン 16): README と PyTorch 版は、出力ゲートが「新しいセル状態 C を作る」と説明していますが、出力ゲートが作るのは隠れ状態 h です。TensorFlow 版の説明は正しいです
- LayerNormalization は値を [-1, 1] に収めない(レッスン 18): TensorFlow 版は「値を -1〜1 の範囲にする」と説明していますが、LayerNormalization は各単語のベクトルを平均 0・標準偏差 1 にそろえる処理で、値が -1〜1 に収まるわけではありません
- BERT の pooled_output は平均ではない(レッスン 18): TensorFlow 版は「全トークンを平均したもの」と説明していますが、BERT の pooled_output は、先頭の [CLS] トークンの出力を全結合層と tanh に通したものです
- 「最も小さい BERT の 1 つ」(レッスン 18): 両方のノートブックがそう書いていますが、PyTorch 版の bert-base-uncased は約 1.1 億パラメータの標準サイズです。小さいのは TensorFlow 版の 4 層のモデル(約 478 万パラメータ)だけです
- 日本語版の誤訳(レッスン 18): 「current or near current state of the art」(最新またはそれに近い技術)が「現在または近い将来の最先端技術」と訳されています
- 「貪欲法でサンプリングしてきた」(レッスン 20): GPT のノートブックは「ここまでは単純な貪欲法を使ってきた」と書いていますが、
openai-gptの設定でも今の pipeline の既定でもランダムなサンプリングをしています。実際、同じプロンプトから 5 通りの違う文章が生成されています(貪欲法なら 1 通りしか作れません) - パートの README のレッスン一覧が 18 で終わっている: レッスン 19 と 20 が載っていません
リンクとファイルの問題
- レッスン 13 と 17 の README などにある、Microsoft Learn の PyTorch 版の NLP モジュールへのリンクは、学習コンテンツの一覧ページに転送されるようになっています(モジュールが廃止された)。TensorFlow 版のモジュールはまだあります
- レッスン 15 の README の gensim へのリンクは、1 行上と同じ PyTorch のチュートリアルを指しています
- レッスン 16 の多層 LSTM の図の出典(towardsdatascience.com の記事)は 404 です
- レッスン 16 の README の LSTM の図には「Image source TBD」(出典未定)が残っています
- レッスン 16 の TensorFlow 版がデータをダウンロードする
mslearntensorflowlp.blob.core.windows.netは、ホスト名が引けなくなっています(tfds.loadが自分でダウンロードするので、実害はありません) - レッスン 17 の README の「Andrej Karpaty」は Karpathy の誤りです
- レッスン 19 のラボの README のコードは、
BertForTokenClassification.from_pretrained(model_name, classes)とクラス数を位置引数で渡していて、TypeErrorになります。num_labels=classesが正しい書き方です - レッスン 19 のラボの README の PubMedBERT へのリンクは、Markdown の参照形式(
[PubMedBERT][PubMedBERT])で書かれているのに参照先の定義がなく、リンクにならずに文字のまま表示されます - 日本語版のパートの README は、「感情分析」と「固有表現抽出」の箇条書きが崩れて、斜体の文として表示されます
レッスンの進め方
各レッスンに講義前・講義後のクイズが付いています。クイズは英語版のみです。
| レッスン | クイズ | ラボ・課題 |
|---|---|---|
| 13 テキストの表現 | 講義前 / 講義後 | 自分で選んだデータセット(例: UFO の目撃情報)でノートブックを動かし直す |
| 14 埋め込み | 講義前 / 講義後 | 別の種類の文章(例: ビートルズの歌詞)で同じことをする |
| 15 言語モデル | 講義前 / 講義後 | 好きな本(『不思議の国のアリス』など)で skip-gram の埋め込みを学習する |
| 16 RNN | 講義前 / 講義後 | 自分のデータセット(例: 天気に関するツイート)で分類する |
| 17 生成ネットワーク | 講義前 / 講義後 | 好きな本で、単語単位の文章生成器を作る |
| 18 Transformer | 講義前 / 講義後 | Hugging Face の学習用スクリプトで、自分のデータセットを使って試す |
| 19 固有表現抽出 | 講義前 / 講義後 | 医学論文のデータ(BC5CDR)から病名と薬品名を抽出する。LSTM の後に PubMedBERT で解く |
| 20 大規模言語モデル | 講義前 / 講義後 | なし |
レッスン 15 のラボは、前述のとおり、ノートブックの作り方のまま skip-gram に変えても、学習データが CBoW とまったく同じになります。2 つを本当に比べたいなら、CBoW を「周りの単語の埋め込みを平均して真ん中の単語を当てる」本来の形に書き直してから取り組むのがおすすめです。レッスン 19 のラボの BC5CDR は、ダウンロードに登録が必要です。筆者はラボを動かしていません。
まとめ
- テキストを数値にする方法は、出現回数を数える BoW / TF-IDF → 意味を持つ短いベクトルの埋め込み → 単語を予測する課題で埋め込みを学習する言語モデル、と進む。最後の考え方がそのまま LLM の出発点になる
- RNN と LSTM は語順を扱えるが、ニュースの分類では TF-IDF との差はわずか。RNN で次の文字の予測を繰り返すと文章を生成でき、温度でランダムさを調整する
- Transformer はアテンションで全単語を同時に見る。大量の文章で事前学習した BERT を追加学習するのは、画像の転移学習と同じ考え方
- NER は単語ごとに BIO 形式のタグを付ける分類で、評価には固有表現単位の F1 値を使う。単語単位の正解率はパディングと O タグで水増しされる
- ノートブックの GPT は GPT-1 で、プロンプトだけではタスクを解けない。教材の LLM の章は GPT-3 の時代で止まっている
- torchtext を使う PyTorch 版は開発終了のためどれもそのままでは動かず、TensorFlow 版は Keras 3 で多くのセルが止まる。さらに、埋め込みが書き込まれていない、2 行ずれている、学習率が上がらない、といった結果を変える誤りが多いので、「教材を読むときの補足」を手元に置いて進めるとよい
次のパート「VI. その他の AI 技術」では、ニューラルネットワーク以外の手法として、遺伝的アルゴリズム、深層強化学習、マルチエージェントシステムを扱います(解説: 遺伝的アルゴリズム・強化学習・マルチエージェントをやさしく解説 — Microsoft AI-For-Beginners レッスン 21〜23)。