Microsoft の無料カリキュラム AI-For-Beginners のパート「VI. その他の AI 技術」を解説します。レッスン 21「遺伝的アルゴリズム」、22「深層強化学習」、23「マルチエージェントシステム」の 3 本です。
シリーズのほかの記事は次のとおりです。
- 全体の構成: Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う
- レッスン 01: AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01
- レッスン 02: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02
- レッスン 03〜05: ニューラルネットワークの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 03〜05
- レッスン 06〜12: コンピュータビジョンの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 06〜12
- レッスン 13〜20: 自然言語処理の基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 13〜20
ここまでのパートは、正解ラベルの付いたデータ(またはラベルのない文章そのもの)から、勾配を使ってニューラルネットワークを学習するものでした。このパートでは、それとは違う 3 つのやり方を見ます。カリキュラム全体の README は、このパートを「あまり知られていない AI のアプローチ」と紹介しています。パート単位の README はなく、3 つのレッスンはそれぞれ独立しています。
- 勾配を使わずに、解の集団を進化させる(レッスン 21)。生物の進化をまねて、解の候補を「遺伝子」として表し、組み合わせ(交叉)とランダムな変化(突然変異)と選択を繰り返して、良い解を探します。微分できない組み合わせの問題にも使えます
- 正解の代わりに、報酬から学ぶ(レッスン 22)。どの行動が正しかったかは誰も教えてくれず、試した結果の「報酬」だけが手掛かりになる問題です。ゲームやロボットの制御がこれに当たり、ニューラルネットワークと組み合わせたものを深層強化学習と呼びます
- 単純なエージェントをたくさん動かす(レッスン 23)。1 つ 1 つは単純なルールで動くエージェントを大量に動かすと、鳥の群れのような全体の振る舞いが生まれます。シミュレーション用の環境 NetLogo を使います
このパートのノートブックは、レッスン 21 と 22 にあります(レッスン 23 は NetLogo を操作する読み物です)。この記事では、ノートブックを 2026 年 10 月時点のライブラリで動かした結果を載せます。レッスン 23 の NetLogo のモデルも、最新版で動かしました。レッスン 21 のノートブックはそのまま動きました。一方、レッスン 22 は開発が止まった OpenAI Gym(強化学習の環境を共通の形で扱えるライブラリ)を使っていて、そのままでは動きません。後継の Gymnasium に置き換えて 3 か所を書き換えると動きます。対処法は「ノートブックを今の環境で動かすときの注意」に、教材そのものの誤りは「教材を読むときの補足」にまとめています。
教材の場所は次のとおりです。
- 英語原文: lessons/6-Other/
- 日本語版: translations/ja/lessons/6-Other/
筆者の実行環境は、Apple M3 Ultra の Mac 上の Python 3.12.8 です。主なライブラリは NumPy 2.5.3、Matplotlib 3.11.2、PyTorch 2.14.0、TensorFlow 2.21.0、Keras 3.15.1、Gymnasium 1.3.0 です。NetLogo は 7.0.4 を使いました。遺伝的アルゴリズムも強化学習も結果が乱数で変わるので、乱数の種(シード)を変えて何回か動かし、結果は範囲で示します。
レッスン 21: 遺伝的アルゴリズム
遺伝的アルゴリズムとは — 進化をまねて解を探す
遺伝的アルゴリズム(GA)は、1975 年にジョン・ホランドが提案した、生物の進化をまねた探索の方法です。次の 5 つの考え方を組み合わせます。
- 遺伝子: 解の候補を表す数値の並び
- 適応度関数: 解の良し悪しを数値で測る
- 選択: 良い解ほど親に選ばれやすくする
- 交叉: 2 つの良い解を組み合わせて、新しい解を作る
- 突然変異: 解の一部をランダムに変えて、局所的な最適解(周りより良いが全体では最良でない解)から抜け出す
これらを使って、解の候補の集まり(集団)を少しずつ良くしていきます。集団をまとめて入れ替える 1 回分を 世代 と呼びます。勾配(微分)を使わないので、スケジュールの作成、箱詰め、材料の切り出しのような、組み合わせの問題にも使えます。
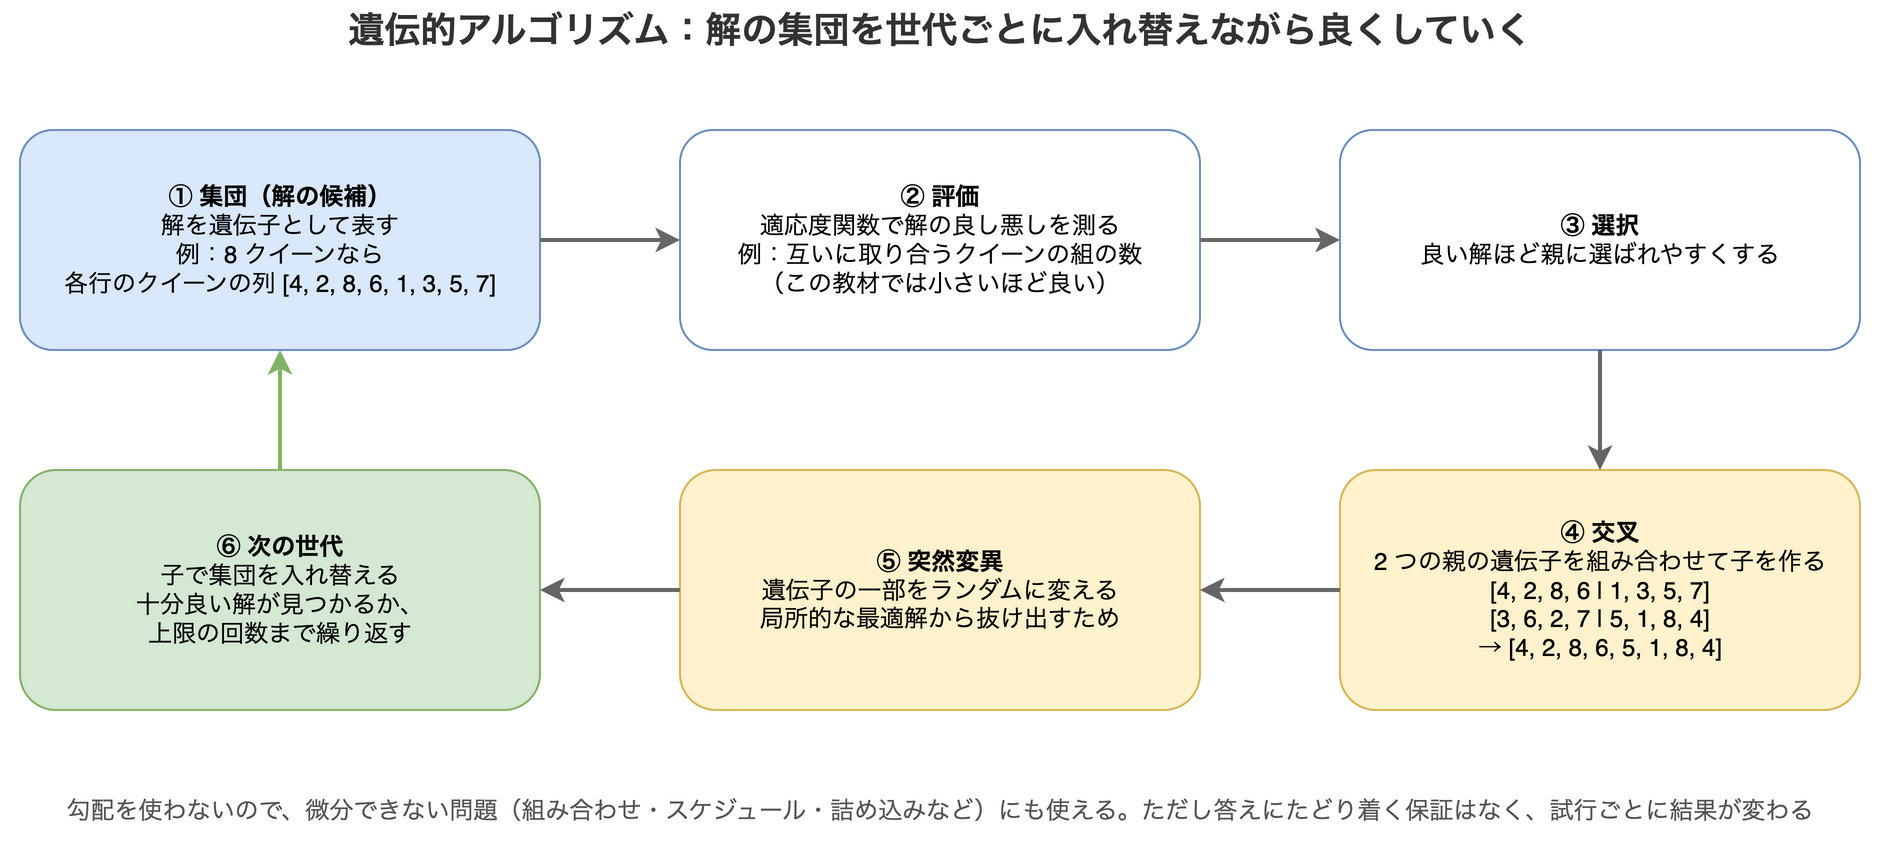
教材の適応度関数は「小さいほど良い」値(コスト)として定義されています。ふつうは「大きいほど良い」ものを適応度と呼ぶので、読むときに注意してください。
問題 1: 宝物を公平に分ける
最初の例は、価値が 1〜10,000 の宝物 200 個を、2 人の価値の合計がなるべく等しくなるように分ける問題です。
- 遺伝子は 0 と 1 が 200 個並んだもの(各宝物をどちらがもらうか)
- 適応度は、2 人の合計の差の絶対値
- 突然変異は 1 か所の値を、0 なら 1 に、1 なら 0 に変える。交叉は、ランダムに決めた位置ごとに、2 つの親のどちらかの値をもらう
30 個の解の集団で最大 2,000 回の更新を行います。この問題では、世代をまとめて入れ替えるのではなく、1 回の更新ごとに集団の 1 つの解だけを入れ替えます。筆者の実行結果は次のとおりです。
- 2 回の実行: 集団の中でいちばん良い解でも数百あった差が、それぞれ 17 と 21 まで小さくなった(ノートブックに残っている記録では 4)。宝物の合計は約 100 万なので、差は 0.002% ほど
- シード 20 通り: 最終的な差は 0〜95 で、ちょうど 0 になったのは 1 回だけ
- 改善の様子: 1 回目の実行では 250 回ほどの更新で差がほぼ止まったが、シードによっては 500 回を過ぎても改善が続いた
問題 2: N クイーン
2 つ目の例は、N×N のチェス盤に N 個のクイーンを、互いに取り合わないように置く N クイーン問題 です。ノートブックは、まず全部の置き方を順に試す バックトラッキング(行き詰まったら 1 つ前に戻ってやり直す全探索)で解き、次に遺伝的アルゴリズムで解きます。
- 遺伝子は、各行に置いたクイーンの列の番号を並べたもの
- 適応度は、互いに取り合うクイーンの組の数(0 なら正解)
- 交叉は、2 つの親を 1 か所で切ってつなぐ。突然変異は、1 か所の値をランダムに変える
- 世代ごとに、良い方から 3 分の 1 を残し、ランダムな解を 3 つ足して、そこから親を選んで同じ数(100 個)の子を作る
8 クイーンを 30 通りのシードで解くと、正解までにかかった世代数は 0〜462(中央値 29.5)でした。0 世代で解けた(最初にランダムに作った 100 個の中にすでに正解があった)ことも 30 回中 5 回ありました。8 クイーンの正解は、同じ列に 2 個置かない並べ方(8! = 40,320 通り)のうち 92 通りあるので、100 個も作れば正解が混じることは珍しくありません。
ただし、このノートブックの genetic() 関数には誤りがあり、正解ではない解を返すことがあります(30 回中 6 回)。詳しくは「教材を読むときの補足」で説明します。
遺伝的アルゴリズムは全探索より速いか
ノートブックは「ほとんどの場合、遺伝的アルゴリズムは全探索より速い」と書いています。しかし、ノートブックが比べているのは、バックトラッキングの N = 20 と遺伝的アルゴリズムの N = 10 で、問題の大きさがそろっていません。同じ大きさで比べた結果は次のとおりです。
| N | バックトラッキング | 遺伝的アルゴリズム |
|---|---|---|
| 10 | 0.23 ミリ秒 | 0〜19.4 秒(平均 4.3 秒、30 回) |
| 20 | 1.40 秒 | 7〜39 秒(3 回) |
N = 20 の遺伝的アルゴリズムは 1 回に数十秒かかるので、3 回だけ試しています。
N クイーンのように、効率のよい全探索の方法がある問題では、遺伝的アルゴリズムの出番はありません。遺伝的アルゴリズムが役に立つのは、全探索ができないほど組み合わせが多く、かつ「だいたい良い解」で十分な問題です。
課題: ディオファントス方程式
課題は、a + 2b + 3c + 4d = 30 を満たす整数 a・b・c・d を遺伝的アルゴリズムで見つけるものです。このように整数の解だけを探す方程式を、ディオファントス方程式と呼びます。Diophantine.ipynb は問題文と空のセルだけで、コードは自分で書きます。
筆者が問題 1 と同じ形(4 つの整数の遺伝子、適応度は |a + 2b + 3c + 4d − 30|、集団 20 個)で書いてみると、シード 100 通りすべてで解けました(8〜1,327 回の更新、中央値 131 回)。a〜d をそれぞれ 0〜30 とした場合の解は 297 通りあるので、難しい問題ではありません。
レッスン 22: 深層強化学習
強化学習とは — 報酬から学ぶ
強化学習 は、「やってみて学ぶ」方式の機械学習です。学習には 2 つのものが必要です。
- 環境: エージェント(学習する側)が行動でき、その結果を返してくれる場(シミュレーター)
- 報酬関数: 行動の結果がどれだけ良かったかを表す数値。多くの場合、ゲームが終わるまで分からない
正解ラベルがないので、エージェントは試行錯誤しながら、報酬が多くなる行動の選び方(方策)を学びます。そのとき、今までに分かった良い行動を選ぶ(活用、exploitation)か、まだ試していない行動を試す(探索、exploration)かのバランスが問題になります。この「探索」は、レッスン 21 の「解を探す」とは別の意味です。
CartPole
レッスンの題材は CartPole(台車の上に立てた棒を、台車を左右に動かして倒さないようにする問題)です。強化学習の環境を共通の形で扱えるライブラリ OpenAI Gym の、定番の環境です。
- 状態: 台車の位置、台車の速度、棒の角度、棒の角速度の 4 つの数値
- 行動: 台車を左に押すか、右に押すかの 2 つ
- 報酬: 棒が立っている 1 ステップごとに +1。CartPole-v1 では最大 500 ステップで終わる
ランダムに押すだけだと、棒は 10〜50 ステップほどで倒れました。
方策勾配法
方策勾配法 は、状態を入力すると各行動の確率を出力するネットワーク(方策ネットワーク)を、次の手順で学習します。
- 今の方策で 1 回のゲーム(エピソード)を最後まで行い、状態・行動・報酬を記録する
- 各ステップについて、そこから先に得られた報酬を、先のものほど小さく割り引いて(割引率 γ(ガンマ)= 0.99)足し合わせる(割引累積報酬)
- 割引累積報酬が大きかったステップの行動ほど、確率が高くなるようにネットワークを学習する
長く立っていられたエピソードの序盤の行動ほど、その後にたくさんの報酬が続くので、強く選ばれやすくなります。ネットワークの学習そのものは、レッスン 03〜05 で見た勾配降下法と同じです。
アクター・クリティック
方策勾配法は、1 回のエピソードの結果だけで行動の良し悪しを決めるので、たまたまの成功や失敗に引きずられ、学習のばらつきが大きくなりがちです。アクター・クリティック は、行動を選ぶ アクター(方策ネットワーク)と、その状態から先にどれだけ報酬が得られそうかを予測する クリティック の 2 つを一緒に学習します。実際の報酬がクリティックの予測より良かった行動を強め、悪かった行動を弱めます。
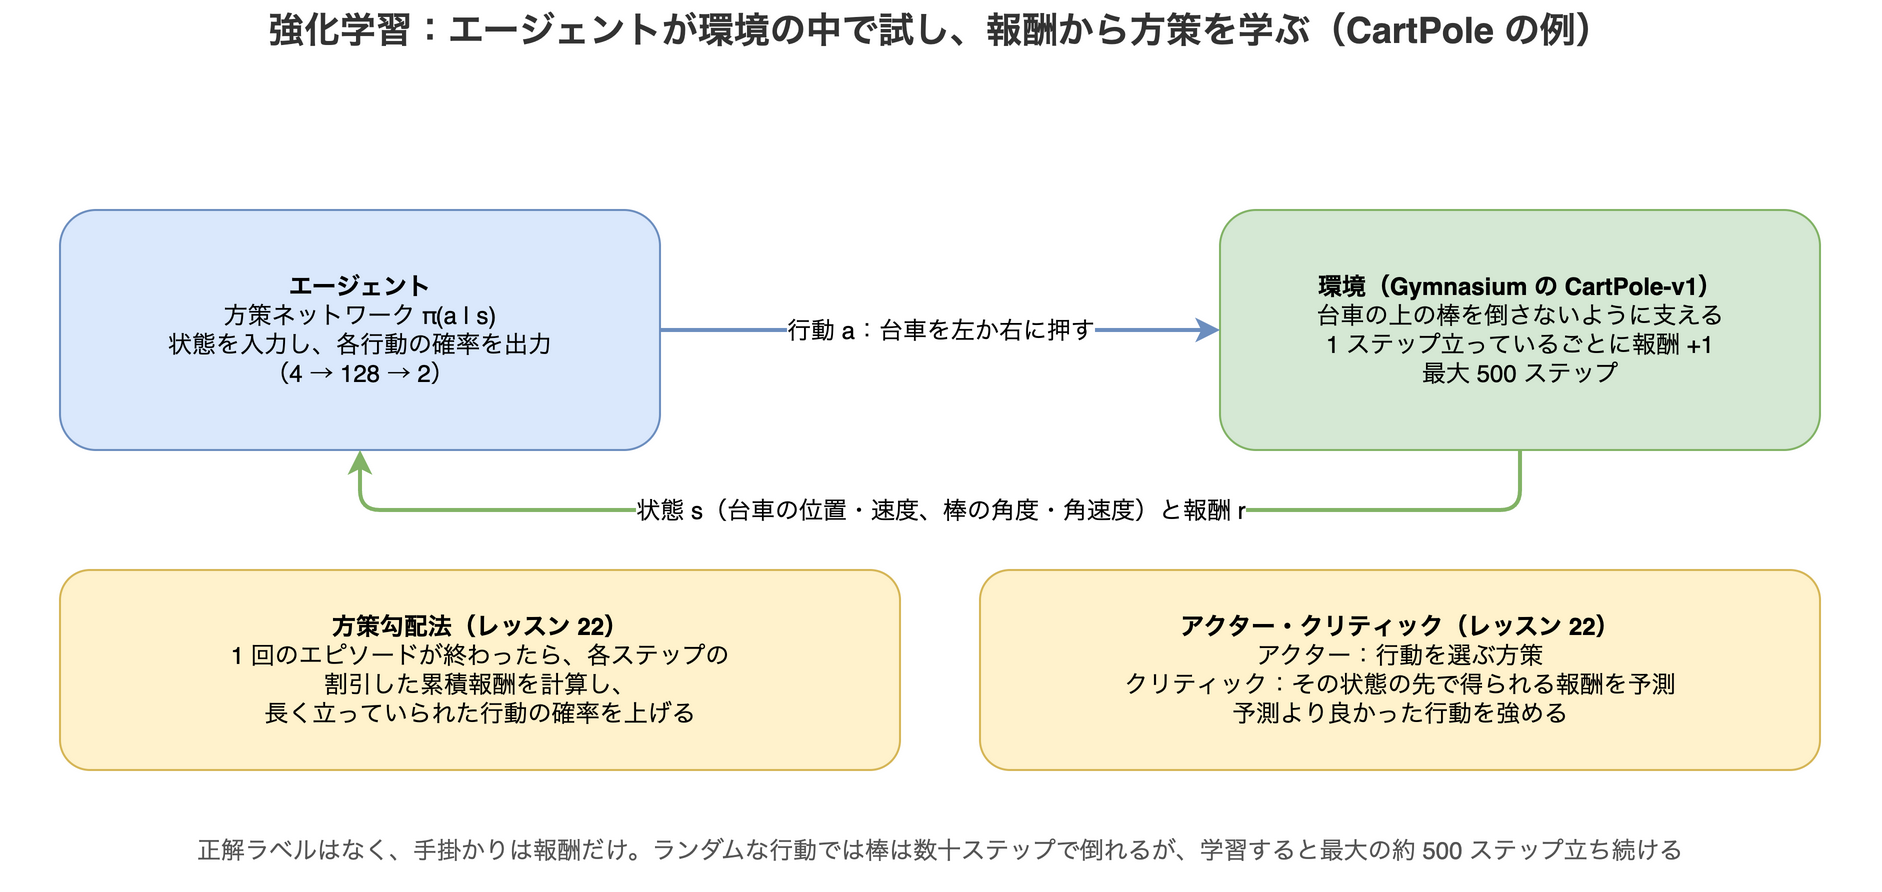
CartPole の学習結果
Gymnasium(「Gymnasium に置き換える」を参照)で動かした結果です。シードを 5 通り変えています。
| 方法 | ノートブック | 結果(シード 5 通り) |
|---|---|---|
| 方策勾配法(300 エピソード) | PyTorch 版 | 初めて最後まで立ち続けたのは 61〜94 エピソード目 |
| 方策勾配法(300 エピソード) | TensorFlow 版 | 初めて最後まで立ち続けたのは 80〜165 エピソード目 |
| アクター・クリティック(100 エピソード) | PyTorch 版 | 195 ステップに届いたのは 5 回中 2 回だけ |
| アクター・クリティック(1,000 エピソードに延長) | PyTorch 版 | 初めて最後まで立ち続けたのは 106〜164 エピソード目。直近 100 エピソードの平均が 475 を超えたのは約 315〜477 エピソード目 |
| アクター・クリティック(「解けた」まで) | TensorFlow 版 | ノートブックの「解けた」の条件を満たしたのは 87〜124 エピソード目(ノートブックに残っている記録では 114) |
「最後まで立ち続けた」は、ノートブックの記録方法で 499 ステップ(上限の 500 から 1 少なくなる数え方)に達したことを指します。TensorFlow 版の「解けた」の条件は平均 195 ステップで、これは古い CartPole-v0 の基準です。今の CartPole-v1 の基準は 475 です(「教材を読むときの補足」を参照)。
方策勾配法は、300 エピソードの学習全体が PyTorch 版で数秒、TensorFlow 版で 1 分ほどで終わり、数十〜百数十エピソードで棒を最後まで支えられるようになります。一方、PyTorch 版のアクター・クリティックは、ノートブックの 100 エピソードでは学習が足りません。筆者の実行で 1,000 エピソードに延ばすと(学習全体で約 100 秒)、5 つのシードすべてでほぼ最後まで立ち続けるようになりました。
ラボ: Mountain Car
ラボは Mountain Car(谷底の車を、左右に揺らして勢いをつけ、右の山の上の旗まで登らせる問題)です。ノートブックは環境を作ってランダムに動かすところまでで、残りは自分で書きます。教材は「Gym はどの環境も同じ形で扱えるので、同じアルゴリズムをそのまま使える」と書いています。
ところが、筆者が試すと話は簡単ではありませんでした。
- ランダムに動かすと、3 通りのシードで各 100 回、一度も旗に届かない
- レッスンの方策勾配法のコードを、入力と行動の数だけ変えて 1,000 エピソード学習させても、3 通りのシードで一度も届かない
Mountain Car は、旗に届かないあいだは毎ステップ −1 の報酬が続き、200 ステップで打ち切られます。届かないエピソードはどれも同じ長さ・同じ報酬になるので、「どの行動が良かったか」の手掛かりがまったくありません。報酬を工夫する(旗に近づいたら少し報酬を与えるなど)か、もっと探索を増やす方法が必要です。強化学習では、報酬の設計がいちばん難しいところだとよく分かる例です。
レッスン 23: マルチエージェントシステム
マルチエージェントシステムとは — 単純なエージェントの集まり
エージェント は、レッスン 22 の強化学習のエージェントと同じく、環境の中にいて、環境を感じ取り、行動する存在です。マルチエージェントシステム は、たくさんのエージェントを同時に動かし、その相互作用から全体の振る舞いを生み出します。1 つ 1 つは単純なルールでも、全体としては複雑な振る舞い(創発)が現れる、というのがこの考え方の要点です。今の LLM エージェントを使った社会シミュレーションも、同じ考え方の延長にあります(社会シミュレーション)。教材によれば、この分野はインターネットと分散システムが広がった 1990 年代に生まれました。
教材は、エージェントを次のように分類しています。
- 考え方: 刺激にすぐ反応する 反応型 と、計画を立てて行動する 熟考型
- 動く場所: 1 か所で動く 静的 なものと、ネットワーク上を移動する 移動型
使い道として、ゲームの NPC(プレイヤー以外のキャラクター)、群衆の描画、感染症の広がりや都市の交通のシミュレーション、業務の自動化が挙げられています。
NetLogo の Flocking モデルで鳥の群れを動かす
レッスンでは、マルチエージェントのシミュレーション環境 NetLogo を使います。NetLogo は、子ども向けの教育用に作られたプログラミング言語 Logo を元にした同じ名前の言語で、「タートル」と呼ぶエージェントに命令を出して動かします。README には次のような例があります。
; README の例(筆者が NetLogo 7.0.4 で動くことを確認)
create-turtles 10
ask turtles [ forward 10 ]
1 行目でタートルを 10 匹作り、2 行目で全員に 10 歩前へ進むよう命じます。
NetLogo の「モデルライブラリ」には多くのサンプルがあり、代表例が Flocking(鳥の群れ)です。各鳥は次の 3 つのルールだけで動きます。
- 整列: 近くの鳥と同じ向きに飛ぶ
- 結合: 少し離れた鳥には近づく
- 分離: 近すぎる鳥からは離れる
筆者が NetLogo 7.0.4 で 300 羽を 1,000 ステップ動かすと、最初はばらばらだった向きが、ほぼ全員同じ向きにそろいました。向きのそろい具合(全員の向きの単位ベクトルを平均したものの長さ。全員が同じ向きなら 1)は、最初の 0.01〜0.08 から 0.97〜0.99 になりました。
教材は「視野(スライダーの vision)を 0 にすると群れにならない」「分離の距離(minimum-separation)を 0 にすると一直線に並ぶ」と書いていて、どちらもそのとおりになりました。視野が 0 だと向きのそろい具合は最初の値のまま変わらず、分離の距離が 0 だと鳥が細い 1 本の線に集まりました。
熟考型エージェント
後半は、旅行の予約を代わりにしてくれるエージェントを例に、熟考型エージェントを説明します。複数のエージェントが協力するには、次のようなものが必要です。
- エージェント同士がやり取りするための共通の言語(KIF、KQML など)
- オークションの仕組みを元にした交渉の手順
- 用語の意味をそろえる共通のオントロジー(レッスン 02 で扱ったもの)
- ほかのエージェントが何をできるかを見つける仕組み
熟考型エージェントの代表的な設計が BDI です。Beliefs(エージェントが知っていること)、Desires(目標)、Intentions(目標のために実行すると決めた行動)の 3 つでエージェントの内部を表します。開発用のプラットフォームとして、Java でマルチエージェントシステムを作るためのフレームワーク JADE が紹介されています。
ノートブックを今の環境で動かすときの注意
レッスン 21 はそのまま動く
レッスン 21 のノートブックは Python と NumPy だけで書かれていて、2026 年 10 月時点のライブラリでもエラーなく最後まで動きました。全体で 1〜6 分ほどかかり、その大半は実行時間を測る %timeit のセルです。
Gym は使えない(レッスン 22)
レッスン 22 のノートブックは、OpenAI Gym を使っています。Gym は 2022 年を最後に開発が止まっていて、今 pip install gym で入る 0.26.2 は NumPy 2 に対応していません。読み込むと、Gym 自身が次のように警告します。
Gym has been unmaintained since 2022 and does not support NumPy 2.0 amongst other critical functionality. Please upgrade to Gymnasium, the maintained drop-in replacement of Gym実際、環境を 1 ステップ動かすと、NumPy 2 で削除された np.bool8 を使っているため、次のエラーで止まります。
AttributeError: module 'numpy' has no attribute 'bool8'さらに Gym 0.26 では、reset() と step() の戻り値の形が 0.25 以前から変わっていて、ノートブックのコードとは合いません。
Gymnasium に置き換える(reset と step の書き換え)
いちばん手早いのは、Gym の開発チームが引き継いだ後継の Gymnasium に置き換えることです。NumPy などを古い版に戻す必要はありません。
pip install gymnasiumノートブックの次の 3 か所を書き換えると、CartPole のセルはすべて動きました。
# ノートブックの該当箇所を書き換えたもの(抜粋)
import gymnasium as gym  # import gym から変更

# reset() は (状態, 情報) の組を返す
state, _ = env.reset()

# step() は 5 つの値を返す。棒が倒れた(terminated)か、上限に達した(truncated)かで終わる
nstate, reward, terminated, truncated, info = env.step(action)
done = terminated or truncated
アニメーションを表示するセルは、そのままだと警告が出るだけで何も描きません。Gymnasium では、環境を作るときに gym.make("CartPole-v1", render_mode="human") のように描画の方法を指定します。
古い Gym を使う方法もある
コードを書き換えたくなければ、Gym 0.25.2 と NumPy 1.26.4 の組み合わせで動かす方法もあります。ただし NumPy を古い版に戻すことになるので、ほかのレッスンとは別の環境を用意してください。
pip install gym==0.25.2 numpy==1.26.4- PyTorch 版: そのまま動きました。ただし毎ステップ画面を描くので、アクター・クリティックの 100 エピソードの学習全体が、Gymnasium での 1.3 秒から 92.5 秒に遅くなりました
- TensorFlow 版: 5 番目のセルで
env.close()を呼んでいるのに、後のセルで同じ環境を描こうとしてerror: display Surface quitで止まります(ノートブックの記録にも同じエラーが残っています)。このenv.close()を消すと動きました
使わなくてよいノートブック
レッスン 22 のフォルダには、notebook.ipynb と tmp.ipynb という、どこからもリンクされていないノートブックもあります。notebook.ipynb は、姉妹カリキュラム ML-For-Beginners の Q 学習(行動の価値を表に記録して学ぶ強化学習の方法)のノートブックのコピーで、tmp.ipynb は作業用の下書きです。どちらも今のライブラリでは動かず(np.int や Keras 3 の lr 引数のエラー)、レッスンを進めるのに必要ありません。
NetLogo は 7.0 で画面が変わった(レッスン 23)
NetLogo は今も開発が続いていて、2025 年 9 月に 7.0 が出ました。ファイル形式(.nlogox)と画面が新しくなり、Apple Silicon 用の版もあります。教材のスクリーンショットは 7.0 より前の画面なので、メニューや見た目が違います。インストールしたくなければ、ブラウザで動く NetLogo Web にも、レッスンで紹介されているモデルがすべてそろっています。
教材を読むときの補足
教材そのものの誤りをまとめます。日本語版は英語版の誤りもそのまま翻訳しているので、特に断りがなければ英語版・日本語版に共通です。
結果を変えてしまうコードの誤り
-
N クイーンの
genetic()が正解でない解を返す(レッスン 21): ループの中で、今の世代の最良の値mfを計算した直後に、集団を次の世代に入れ替えています。次の世代は前の世代の良い解を残さない作りなので、正解を含む世代を捨てて、別の世代の最良の解を返してしまいます。筆者が動かした 2 回目では(array([2, 8, 5, 7, 1, 3, 6, 8]), 1)(取り合う組が 1 つ残っている)が返りました。30 通りのシードでは、N = 8 で 6 回、N = 10 で 10 回が正解でない解でした。次の 2 行の順番を入れ替えると、試した範囲(N = 8 で 30 回、N = 10 で 10 回)では 0 回になりました# ノートブックの genetic() のループ(抜粋) while mf>0: n+=1 mf = min([x[1] for x in P]) # この行と P = nxgeneration(P) # この行を入れ替える -
突然変異の確率が説明と違う(レッスン 21): 説明は「30% の確率で突然変異、70% で交叉」ですが、コードの
random.randint(1,10)<3は 1 か 2 のときだけなので 20% です(100 万回試すと約 0.2) -
TensorFlow 版の「解けた」の基準が古い(レッスン 22): アクター・クリティックは、平均の報酬が 195 を超えたら「解けた」としていますが、195 は最大 200 ステップの CartPole-v0 の基準です。ノートブックが使う CartPole-v1(最大 500 ステップ)の基準は 475 です
-
alphaは学習率として働いていない(レッスン 22): 方策勾配法のノートブックは、alphaを「強化学習の学習率」と説明しています。しかし、このコードではalphaは勾配の大きさを一律に変えるだけです。最適化手法の Adam は、勾配をそれまでの勾配の大きさで割ってそろえてから使うので、勾配の大きさを一律に変えても更新の大きさはほとんど変わりません。筆者がalphaを 100 倍にして比べても、学習の速さに一貫した差はありませんでした -
PyTorch 版のアクター・クリティックの細かい誤り(レッスン 22):
lr = 0.0001と書いているのに使っておらず(Adam の既定の 0.001 になる)、エピソードの最初にenv.reset()を 2 回呼んでいるので、最初のステップで使う状態が環境の実際の状態と合っていません
記述の誤り
- 全探索との比較(レッスン 21): 前述のとおり、「遺伝的アルゴリズムの方が速い」という説明は、違う大きさの問題を比べたものです
- 選択の確率の説明(レッスン 21): 「適応度に比例した確率で親を選ぶ」と書いていますが、この教材の適応度は小さいほど良いので、実際には「最大値 − 適応度」(取り合わないクイーンの組の数)に比例した確率です
- 割引の説明が逆(レッスン 22): README とノートブックは「前の方の報酬に 0.99 を掛けて、前の方の報酬の役割を小さくする」と説明していますが、割り引かれるのは 先の方 の報酬です。コードもそのとおりに計算しています
- 「棒を支え続ける」アニメーションの出どころ(レッスン 22): README は、方策勾配法かアクター・クリティックを動かすと棒がこう支えられる、とアニメーションを載せています。しかし、この画像は、リンクされていない
notebook.ipynb(Q 学習)が作ったものでした(フレーム数がノートブックの保存処理と一致) - Gym は OpenAI が保守している(レッスン 22): 今は保守されておらず、後継は Farama Foundation の Gymnasium です
- NetLogo のコードの書き方(レッスン 23): README の
to go [ ... ]は文法の誤りで、NetLogo では読み込めません。手続きはto goで始めてendで終えます([ ]は引数の一覧を書く場所です) - 「全エージェントが並列に実行される」(レッスン 23): NetLogo の
askは、2007 年の NetLogo 4.0 から、エージェントが 1 匹ずつランダムな順に実行する方式です - Flocking のルール(レッスン 23): README は 3 つのルールを同時に使うように説明していますが、モデルのコードでは、近すぎる鳥がいるときは分離だけを行い、そうでないときに整列と結合を行います。モデル自身の説明にも「分離はほかの 2 つより優先される」とあります
- スクリーンショットのモデル(レッスン 23): 「草という限られた資源の中のオオカミとヒツジ」と説明している画面は、草のない版(Docked Hybrid)のモデルです。草のある版は Sample Models の Biology にある Wolf Sheep Predation です
- KIF と KQML(レッスン 23): どちらも「発話行為理論に基づく」と説明していますが、発話行為理論に基づくのは KQML の方で、KIF は論理式で知識を表す言語です。また、その後に作られた FIPA-ACL が、今はエージェント間通信の事実上の標準になっています
リンクとファイルの問題
- レッスン 21 の参考記事(habr.com)はロシア語の記事です
- レッスン 22 で使われている
www.gymlibrary.ml(ノートブックやラボの Mountain Car の説明へのリンクなど)は、ドメインが引けなくなっています。gym.openai.comは証明書のエラーになります。今の説明は Gymnasium のドキュメント にあります - レッスン 22 の Azure Bonsai(産業制御向けの強化学習サービス)へのリンクは 404 です
- レッスン 23 の、マルチエージェントの開発プラットフォームの論文へのリンク(arxiv.org/ftp/…)は 404 です。arxiv.org/abs/2007.08961 で読めます
- レッスン 23 の「Emergentism」と「Evolutionary Cybernetics」の 2 つのリンクは、どちらも Wikipedia の「Global brain」の記事を指しています
- レッスン 23 で紹介されている JADE は、最後の版が 2022 年 12 月の 4.6.0 で、それ以降は出ていません
レッスンの進め方
各レッスンに講義前・講義後のクイズが付いています。クイズは英語版のみです。
| レッスン | クイズ | ラボ・課題 |
|---|---|---|
| 21 遺伝的アルゴリズム | 講義前 / 講義後 | ディオファントス方程式 a + 2b + 3c + 4d = 30 を遺伝的アルゴリズムで解く |
| 22 深層強化学習 | 講義前 / 講義後 | Mountain Car の車を旗まで登らせる |
| 23 マルチエージェントシステム | 講義前 / 講義後 | NetLogo のモデルライブラリのモデル(例: 感染症の Virus モデル)を、現実の状況に合わせて書き換え、動画で紹介する |
レッスン 21 の課題は、問題 1 のコードを少し書き換えれば解けます。レッスン 22 のラボは、前述のとおり、レッスンの方法をそのまま持ち込んでも解けません。報酬の工夫が必要になるので、強化学習の難しさを体験するつもりで取り組むのがよいでしょう。レッスン 23 の課題の Virus モデルは、NetLogo の Sample Models の Biology にあり、NetLogo Web でも動きます。
日本語版の欠落
日本語版は、ノートブックのコードは英語版と同じですが、いくつか欠けている部分があります。
- レッスン 21 のノートブックは、親の選び方の確率を説明するセルが空になっている
- レッスン 22 のラボの README は、題名と「課題」の節(Mountain Car の説明)と図がなく、「環境」の節から始まっている
- レッスン 22 のラボのノートブックは、「ここから先は自分で書いてください」という指示のセルが空になっている
- レッスン 23 の README は、「チャレンジ」の途中で切れていて、講義後のクイズ、復習、課題へのリンクがない
ラボと課題は英語版で確認するのが確実です。
まとめ
- 遺伝的アルゴリズムは、解の候補を遺伝子として表し、交叉・突然変異・選択を繰り返して良い解を探す。微分できない組み合わせの問題にも使えるが、効率のよい全探索がある問題では全探索の方がずっと速い
- 強化学習は、正解の代わりに報酬から行動の選び方を学ぶ。CartPole なら方策勾配法で数十〜百数十エピソードで棒を支えられるようになるが、Mountain Car のように報酬の手掛かりがない問題ではそのままでは学習できない
- マルチエージェントシステムは、単純なルールのエージェントをたくさん動かして全体の振る舞いを生む。NetLogo は今も開発が続いていて、レッスンのモデルは最新版でもブラウザでも動く
- レッスン 21 のノートブックはそのまま動くが、
genetic()が正解でない解を返すことがある。レッスン 22 は Gym が使えないので、Gymnasium に置き換えて 3 か所を書き換える - 日本語版はラボや課題の説明が欠けている箇所があるので、英語版と突き合わせて進めるとよい
次のパート「VII. AI 倫理」は、カリキュラム本編の最後のレッスンで、責任ある AI の考え方を扱います(解説: AI 倫理と責任ある AI をやさしく解説 — Microsoft AI-For-Beginners レッスン 24)。