Microsoft の無料カリキュラム AI-For-Beginners のパート「VII. AI 倫理」を解説します。レッスン 24「倫理的で責任ある AI」の 1 本だけのパートで、カリキュラム本編の最後のレッスンです。
シリーズのほかの記事は次のとおりです。
- 全体の構成: Microsoft の AI-For-Beginners 日本語版 — LLM の「手前」を積み直す教材として使う
- レッスン 01: AI の歴史と基本をやさしく解説 — Microsoft AI-For-Beginners レッスン 01
- レッスン 02: 知識表現とエキスパートシステムをやさしく解説 — Microsoft AI-For-Beginners レッスン 02
- レッスン 03〜05: ニューラルネットワークの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 03〜05
- レッスン 06〜12: コンピュータビジョンの基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 06〜12
- レッスン 13〜20: 自然言語処理の基礎をやさしく解説 — Microsoft AI-For-Beginners レッスン 13〜20
- レッスン 21〜23: 遺伝的アルゴリズム・強化学習・マルチエージェントをやさしく解説 — Microsoft AI-For-Beginners レッスン 21〜23
このレッスンは README 1 つだけの短い読み物で、ノートブックはありません。内容は次の 3 つです。
- AI は道具であり、誤用されうる。これまでのレッスンで見てきたとおり、AI はデータから規則性を見つける数学的な手法の集まりです。SF のように AI が反乱を起こすことを心配するより、強力な道具が誤って、あるいは意図的に悪用されることを心配すべきだ、という立場です
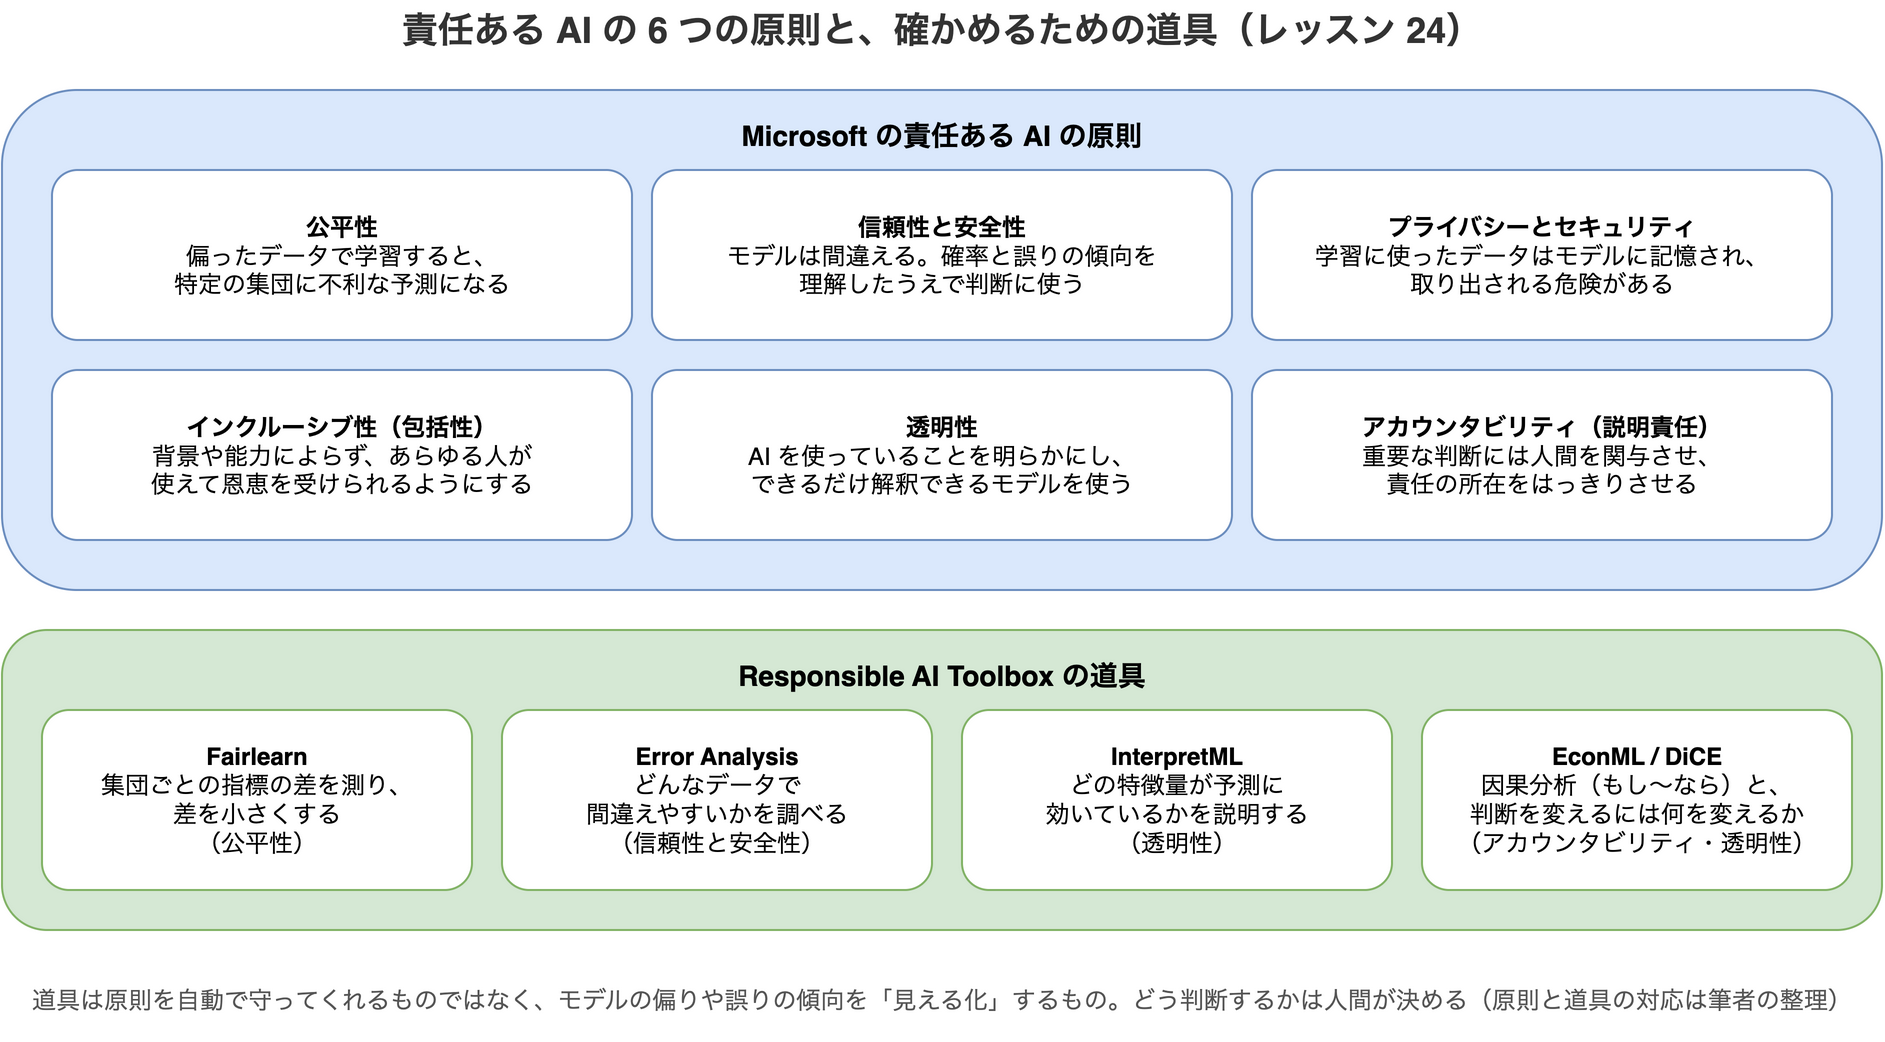
- 責任ある AI の 6 つの原則。Microsoft が掲げる、公平性・信頼性と安全性・プライバシーとセキュリティ・インクルーシブ性・透明性・アカウンタビリティの 6 つです
- 原則を確かめる道具。モデルの偏りや誤りの傾向を調べる、Microsoft の Responsible AI Toolbox などを紹介します
ノートブックがない代わりに、この記事では、教材の「採用予測のモデルが男性を優遇してしまう」という例を、公平性の道具 Fairlearn で実際に確かめてみます。また、README は 2022 年 9 月から更新されていません。そのためクイズのリンクは使えず、紹介されている道具の状況も変わっています。そうした点は「今の状況と教材の補足」にまとめました。シリーズの最終回なので、最後にシリーズ全体も振り返ります。
教材の場所は次のとおりです。
AI は道具であり、誤用されうる
README は、コースを振り返るところから始まります。README によれば、AI はいくつもの数学的な手法の集まりです。データの中の関係を見つけ、人間の振る舞いの一部をまねるようにモデルを学習させます。今の時点では、データからパターンを取り出し、それを新しい問題に当てはめる、とても強力な道具だと考えられています。
SF では、AI が感情を持って人間に反乱を起こす話がよく描かれます。しかし README は、このコースで学んだ AI は「大きな行列計算にすぎない」と言います。心配すべきは反乱ではありません。強力な道具はどれも、良い目的にも悪い目的にも使えます。AI も同じで、誤用 されうることこそ心配すべきだ、という立場です。
なお、「行列計算にすぎない」が当てはまるのは、ニューラルネットワークを扱ったレッスン 03〜20 です。このコースの エキスパートシステム(レッスン 02) や 遺伝的アルゴリズム・マルチエージェント(レッスン 21〜23) は、行列計算ではありません。
責任ある AI の 6 つの原則
AI の誤用を防ぐために、Microsoft は 責任ある AI の原則 を掲げています。README が挙げる 6 つは、Microsoft の公式ページの 6 原則と同じです。日本語の名前は、Microsoft の日本語ページの表記に合わせました(日本語版の README は、インクルーシブ性を「包括性」、アカウンタビリティを「説明責任」と訳しています)。
公平性
公平性(Fairness)は、モデルのバイアス(偏り)の問題です。偏ったデータで学習すると、モデルも偏ります。README の例は、ある人がソフトウェア開発者として採用される確率を予測するモデルです。過去の学習データが男性に偏っていれば、モデルは男性を優先しがちになります。学習データのバランスを取り、モデルを調べて偏りを避ける必要があります。
この例は、後で Fairlearn を使って実際に確かめます。AI で採用の書類選考をするときの偏りの問題は、AI エージェントで採用書類を事前スクリーニングする記事 でも扱っています。
信頼性と安全性
信頼性と安全性(Reliability and safety)は、AI モデルは本質的に間違えるものだ、という前提から出発します。分類のモデルの間違え方は、適合率と再現率で測ります。
- 適合率: 当てはまると判断した(たとえば「採用すべき」と予測した)もののうち、本当に当てはまった割合
- 再現率: 本当に当てはまるもののうち、当てはまると判断できた割合
これを理解したうえで、間違った助言による害を防ぐ必要があります。
README は「ニューラルネットワークは確率を返す」と書いていますが、ネットワークの出力は、必ずしも当たる確率そのものではありません。今のニューラルネットワークは、実際より自信の強い値を出しがちなことが知られています(Guo ら、2017 年「On Calibration of Modern Neural Networks」)。出力を実際の確率に合わせることを 較正(キャリブレーション)と呼びます。ネットワークの出力の仕組みは レッスン 03〜05 で扱いました。
プライバシーとセキュリティ
プライバシーとセキュリティ(Privacy and security)について、README は「学習に使ったデータは、ある意味でモデルに『統合』される」と書いています。これはそのとおりで、モデルは学習データの一部を覚えていることがあります。ただし README はそこから「一方では、セキュリティとプライバシーが高まる」と続けていて、これは誤りです(「教材の誤り」でも挙げています)。
実際には逆で、モデルが学習データを覚えていることが、プライバシーの危険になります。
- メンバーシップ推論攻撃: ある人のデータがモデルの学習に使われたかどうかを、モデルの出力から推測する(Shokri ら、2017 年「Membership Inference Attacks against Machine Learning Models」)
- 学習データの抽出: 大規模言語モデルから、学習に使われた文章(名前・電話番号・メールアドレスを含む)をそのまま引き出す(Carlini ら、2021 年「Extracting Training Data from Large Language Models」。GPT-2 で実証)
学習に使ったからといってデータが匿名になるわけではないので、どのデータで学習したかを記録しておくだけでなく、個人情報を学習に含めない工夫が必要です。
インクルーシブ性
インクルーシブ性(Inclusiveness)について、README は「人を置き換えるためではなく、人を補い、仕事をより創造的にするために AI を作ること」と説明しています。また、データの中に少ししか含まれない集団は偏って扱われやすいので、そうした集団も含めて正しく扱う必要がある、とも書いています。
Microsoft の公式の説明は少し違い、「背景によらず、あらゆる人に力を与え、関われるようにする」「あらゆる能力の人が使えるようにする」です。障がいのある人も含めて誰でも使えること(アクセシビリティ)に重心があります。
透明性
透明性(Transparency)は、AI を使っていることを常に明らかにすることと、できるだけ 解釈できる(なぜその判断になったかを人間が理解できる)AI を使うことです。レッスン 02 のエキスパートシステムは、判断の理由をルールとして示せるので、解釈できる AI の典型例です。
アカウンタビリティ
アカウンタビリティ(Accountability)は、AI が下した判断の責任が誰にあるかをはっきりさせることです。多くの場合、重要な判断には人間を関与させ、実際の人間が責任を負えるようにします。
原則を確かめる道具 — Responsible AI Toolbox
README は、Microsoft の Responsible AI Toolbox とその中の道具を紹介しています。
- InterpretML: モデルがどの特徴量を重視して判断しているかを説明する(解釈可能性)
- Fairlearn: 集団ごとの予測の差を測り、差を小さくする(公平性)
- Error Analysis: どんな種類のデータでモデルが間違えやすいかを調べる
- Responsible AI Dashboard: これらをまとめた画面。README は、EconML(「もし〜だったら」を調べる因果分析)と DiCE(判断を変えるには、どの特徴量をどう変えればよいかを示す反実仮想の分析)を含むと紹介しています
ここでの 特徴量 は、モデルに入力する個々の項目(次の例では、筆記試験の点数や経験年数)のことです。
道具の今の状況は「今の状況と教材の補足」で説明します。
Fairlearn で採用モデルの偏り(バイアス)を確かめる
実験の設定
README の採用予測の例を、Fairlearn で実際に確かめてみます。応募者 1 万人の合成データ(実在の人ではなく、乱数で作った架空のデータ)を作り、次のような状況にしました。
- 応募者の 7 割が男性
- 能力は男女で同じ分布
- 過去の採用の判断は、能力に加えて「男性なら有利」という偏りを含んでいる
- 経験年数は、能力だけでなく性別とも関係している(男性の方が長い)
このデータの半分で、採用を予測するモデルを学習します。モデルには、入力から採用される確率を計算し、それをもとに採用か不採用かを決める、シンプルな分類モデル(ロジスティック回帰)を使います。残りの半分(5,000 人)で、男女それぞれの 採用率(採用と予測した割合)を比べます。その差(採用率の差。Fairlearn では demographic parity difference と呼ぶ)が小さいほど、男女で同じ割合で採用していることになります。
コード
次のコードは教材にはなく、筆者が書いたものです。
"""採用モデルの公平性を Fairlearn で測って、緩和する(合成データ)。

- 能力 skill は性別によらず同じ分布
- 過去の採用結果 hired は、能力に加えて「男性なら有利」という偏りを含む
- 比較用の 0 以外のモデルには性別を入れないが、性別と相関する「経験年数」が代わりの手掛かりになる
"""
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from fairlearn.metrics import MetricFrame, selection_rate, demographic_parity_difference
from fairlearn.postprocessing import ThresholdOptimizer
from fairlearn.reductions import ExponentiatedGradient, DemographicParity

rng = np.random.default_rng(0)
n = 10_000
gender = pd.Series(np.where(rng.random(n) < 0.7, "男性", "女性"), name="性別")  # 応募者の 7 割が男性
male = (gender == "男性").astype(float)
skill = rng.normal(0, 1, n)                              # 能力は性別によらない
test_score = skill + rng.normal(0, 0.5, n)               # 筆記試験の点数
experience = 0.5 * skill + 1.0 * male + rng.normal(0, 1, n)  # 経験年数(性別と相関)
hired = (skill + 0.8 * male + rng.normal(0, 0.5, n) > 0.8).astype(int)  # 偏った過去の判断

X = pd.DataFrame({"test_score": test_score, "experience": experience})  # 性別は入れない
X_tr, X_te, y_tr, y_te, g_tr, g_te = train_test_split(
    X, hired, gender, test_size=0.5, random_state=0, stratify=gender)


def report(name, y_pred):
    mf = MetricFrame(metrics={"採用率": selection_rate, "正解率": accuracy_score},
                     y_true=y_te, y_pred=y_pred, sensitive_features=g_te)
    dpd = demographic_parity_difference(y_te, y_pred, sensitive_features=g_te)
    print(f"--- {name}")
    print(mf.by_group.round(3).to_string())
    print(f"全体の正解率 {accuracy_score(y_te, y_pred):.3f} / 採用率の差 {dpd:.3f}\n")


print("過去データの採用率:", pd.Series(hired).groupby(gender).mean().round(3).to_dict(), "\n")

X_g = X.assign(male=male)  # 比較用: 性別もそのまま入れた場合
model_g = LogisticRegression().fit(X_g.loc[X_tr.index], y_tr)
report("0. 性別も特徴量に入れたモデル", model_g.predict(X_g.loc[X_te.index]))

model = LogisticRegression().fit(X_tr, y_tr)
report("1. 性別を外して学習したモデル", model.predict(X_te))

to = ThresholdOptimizer(estimator=model, constraints="demographic_parity",
                        prefit=True, predict_method="predict_proba")
to.fit(X_tr, y_tr, sensitive_features=g_tr)
report("2. ThresholdOptimizer(グループごとにしきい値を変える)",
       to.predict(X_te, sensitive_features=g_te, random_state=0))

eg = ExponentiatedGradient(LogisticRegression(), constraints=DemographicParity())
eg.fit(X_tr, y_tr, sensitive_features=g_tr)
report("3. ExponentiatedGradient(制約付きで学習し直す)", eg.predict(X_te, random_state=0))
必要なライブラリは次のコマンドで入ります(scikit-learn・pandas・NumPy も一緒に入ります)。
pip install fairlearnApple M3 Ultra の Mac 上の Python 3.12.8、Fairlearn 0.14.0、scikit-learn 1.9.1、NumPy 2.5.3、pandas 3.0.6 で実行しました。3 回実行して、出力はまったく同じでした。
結果と読み取り
たとえば「1. 性別を外して学習したモデル」の出力は次のとおりです。
--- 1. 性別を外して学習したモデル
      採用率    正解率
性別
女性  0.330  0.809
男性  0.425  0.789
全体の正解率 0.795 / 採用率の差 0.095
すべての出力を、テスト用の 5,000 人で測った値として筆者がまとめると、次のとおりです。「過去のデータ」の行の採用率の差は、コードが表示する男女の採用率から計算した値(0.500 − 0.228)です。
| データ・モデル | 女性の採用率 | 男性の採用率 | 採用率の差 | 全体の正解率 |
|---|---|---|---|---|
| 過去のデータ | 0.228 | 0.500 | 0.272 | — |
| 0. 性別も特徴量に入れたモデル | 0.173 | 0.504 | 0.331 | 0.821 |
| 1. 性別を外して学習したモデル | 0.330 | 0.425 | 0.095 | 0.795 |
| 2. ThresholdOptimizer | 0.367 | 0.390 | 0.023 | 0.779 |
| 3. ExponentiatedGradient | 0.380 | 0.422 | 0.041 | 0.782 |
ここから 3 つのことが分かります。
- 偏ったデータで学習したモデルは、偏りをそのまま、あるいはより強く再現する。性別を特徴量に入れたモデルは、採用率の差が 0.331 と、過去のデータ(0.272)より大きくなりました。女性の採用率は 0.173 まで下がっています
- 性別を外しても、偏りは消えない。性別を特徴量から外しても、差は 0.095 残りました。性別と関係のある「経験年数」が、性別の代わりの手掛かり(代理変数、proxy)になっているためです。README は「データのバランスを取る」ことを勧めています。しかし、偏っているのが 正解ラベル(過去の採用の判断)そのものや、性別の代わりになる特徴量の場合は、それだけでは足りません
- 偏りを小さくする手法には、代償がある。Fairlearn の ThresholdOptimizer(男女で、採用の判断のしきい値(確率がいくつ以上なら採用とするかの境目)を変える)は差を 0.023 まで、ExponentiatedGradient(採用率の差に制約を付けて学習し直す)は 0.041 まで小さくしました。その代わり、正解率は、性別を外したモデル 1 の 0.795 から、0.779〜0.782 に下がっています
ただし、ここでの「正解率」は、偏りを含んだ過去の判断を正解として測ったものです。正解率が下がった分の一部は、「過去の偏った判断と違う判断をした」ことによるものです。公平さと正解率のどちらをどれだけ優先するかは、道具が決めてくれるものではなく、人間が判断することです。これが、アカウンタビリティの原則が「重要な判断には人間を関与させる」と言っている理由でもあります。
なお、ThresholdOptimizer は予測するときにも性別の情報が必要で、ExponentiatedGradient は必要ありません。予測のたびに性別を使うことが、法律や社内のルールで認められない場合もあるので、実際に使うときはこの違いも考える必要があります。
今の状況と教材の補足(2026 年 10 月時点)
原則のその後
Microsoft は、これらの原則を具体的な社内ルールにした「責任ある AI の標準(Responsible AI Standard)」の第 2 版を 2022 年 6 月に公開しています。また「責任ある AI の透明性レポート」も公開していて、2026 年版ではエージェントの記憶やプロンプトインジェクション(AI への入力に命令を紛れ込ませて、意図しない動作をさせる攻撃)への対策も扱っています。原則を並べるところから、それをどう運用するかに話の中心が移っています。
クイズのリンクが使えない
README の講義前・講義後のクイズのリンク(white-water-09ec41f0f.azurestaticapps.net/quiz/5/ と /6/)は、サイトごとなくなっていて 404 です。しかもこのリンクは、姉妹カリキュラム ML-For-Beginners の公平性のレッスンのクイズを指していたもので、このレッスンのクイズではありませんでした。ほかのレッスンのクイズのリンクは 2025 年 9 月に新しいサイトへ書き換えられましたが、このレッスンだけ取り残されています。
このレッスンのクイズは、新しいサイトの次のページにあります。
Microsoft Learn のリンクは別のページに転送される
README の「復習と自主学習」にある Microsoft Learn のモジュールへのリンクと、カリキュラム全体の README の表にある学習パスへのリンクは、どちらも転送を繰り返して、Learn の AI の総合ページに着きます。モジュールそのものはなくなったようです。今は「Embrace responsible AI principles and practices」というモジュールで、6 つの原則を学べます。
Responsible AI Toolbox は 2024 年から止まっている
Responsible AI Toolbox のリポジトリはアーカイブされてはいません。ただ、最後のリリースは 2024 年 7 月の 0.36.0 で、その後は CI やドキュメント、セキュリティの修正が中心です。ダッシュボードのパッケージ raiwidgets は、NumPy 1.26.2 以下・pandas 2 未満・Fairlearn 0.7.0 を要求しています。そのため Python 3.12 では依存するライブラリ(llvmlite 0.41.1)のビルドに失敗し、インストールできませんでした。
一方、個別の道具は今も開発が続いていて、Python 3.12・NumPy 2 で問題なく入りました。
| 道具 | バージョン(2026 年 10 月時点) | 状況 |
|---|---|---|
| Fairlearn | 0.14.0 | 2018 年に Microsoft Research で始まり、2021 年からはコミュニティ主導で開発。独自のダッシュボードは 0.7.0 で削除された |
| InterpretML | 0.7.8 | 開発が続いている |
| EconML | 0.17.0 | 今は PyWhy(因果推論のオープンソースの集まり)の下で開発 |
| DiCE | 0.12 | 2025 年 7 月以降の更新はない |
今から試すなら、ダッシュボードではなく、この記事の Fairlearn の例のように、個別のライブラリを直接使うのが現実的です。
教材の誤り
- プライバシーの説明: 学習データがモデルに取り込まれることは、プライバシーを高めるのではなく、危険を生みます(「プライバシーとセキュリティ」を参照)
- 「FairLearn」: 正しい表記は Fairlearn です。また README の「Fairness Dashboard(FairLearn)」は、Fairlearn 本体からは 0.7.0 で削除され、今は止まっている
raiwidgetsにだけ残っています - Responsible AI Dashboard の中身: README は EconML と DiCE を含むと書いていますが、実際には誤差分析・公平性・解釈可能性・反実仮想・因果分析・データのバランスの 6 つの部品からなります
- データのバランスだけでは足りない: README は偏りを避けるために学習データのバランスを取るよう勧めていますが、正解ラベル自体の偏りや代理変数による偏りは、それでは取り除けません(「結果と読み取り」を参照)
- インクルーシブ性の定義: README の「人を置き換えずに補う」は、Microsoft の公式の説明とは重心が違います(「インクルーシブ性」を参照)
- 原則と概念: README は 6 つを「原則を支える概念」と書いていますが、Microsoft のページではこの 6 つそのものが原則です
- 「Learn Path」: README は「学習パス」と書いていますが、リンク先は学習パスではなくモジュールでした
日本語版の誤訳
日本語版は、英語版の誤りをそのまま翻訳しているほか、次の点が違います。
- 「precision and recall」が「精度と再現率」と訳されています。precision は、ふつう 適合率 と訳します(精度は正解率の意味で使われることが多い言葉です)
- 「underrepresented communities」(データの中に少ししか含まれない集団)が「過小評価されているコミュニティ」と訳されています。過小評価は「実際より低く評価される」という意味なので、誤訳です
- インクルーシブ性の説明で、「それらの集団が 含まれ、正しく扱われるようにする」の「含まれ」が抜けています
- インクルーシブ性を「包括性」、アカウンタビリティを「説明責任」と訳していて、Microsoft の日本語の公式の表記と違います
レッスンの進め方
このレッスンにはラボも課題もありません。読み終えたら、次の 3 つに進むのがおすすめです。
- 新しいサイトの 講義前のクイズ と 講義後のクイズ を解く
- README が勧めている ML-For-Beginners の 公平性のレッスン(課題付き)で、もう少し詳しく学ぶ
- 上の Fairlearn のコードを、自分の関心のあるデータに置き換えて動かしてみる
まとめ
- このコースで学んだ AI は強力な道具で、心配すべきは SF のような反乱ではなく、誤用である
- Microsoft の責任ある AI の 6 原則は、公平性・信頼性と安全性・プライバシーとセキュリティ・インクルーシブ性・透明性・アカウンタビリティ。今はそれを具体的な標準や透明性レポートで運用する段階に進んでいる
- 学習データがモデルに取り込まれることは、プライバシーを高めるのではなく、危険を生む。README のこの説明は誤り
- Fairlearn で確かめると、偏ったデータで学習したモデルは偏りを再現し、性別を特徴量から外しても、性別と関係のある特徴量を通じて偏りが残った。偏りを小さくする手法には正解率の代償があり、どこで折り合うかは人間が決める
- README は 2022 年から更新されておらず、クイズと Learn のリンクは使えない。Responsible AI Toolbox のダッシュボードは今の Python では入らないが、Fairlearn などの個別の道具は今も使える
シリーズを終えて
これで AI-For-Beginners の本編 24 レッスンを、シリーズとしてひととおり解説しました。カリキュラムには、このほかに番外編としてレッスン 25「マルチモーダルネットワーク(CLIP と VQGAN)」があります。このシリーズでは扱わないので、興味があれば教材を直接読んでみてください。
全体を通して動かしてみると、どのパートにも、2022 年ごろのライブラリを前提にしたまま止まっている部分がありました。エラーにならずに、結果だけが静かに間違っている部分もありました。
それでも、知識表現からニューラルネットワーク、画像、言語、強化学習、そして責任ある AI までを、手を動かしながら一続きに学べる無料の教材は、ほかにあまりありません。全体の記事 と各パートの記事の補足を手元に置いて進めれば、LLM の「手前」を積み直す教材として、今でも十分に役立ちます。
シリーズを読み終えたら、次の教材に進むのがおすすめです。
- 古典的な機械学習(回帰や決定木など)を学ぶなら ML-For-Beginners
- 今の LLM の使い方を学ぶなら Generative AI for Beginners
- エージェントを作るなら AI Agents for Beginners